Развитие технологий локального запуска языковых моделей (LLM) побудило энтузиастов экспериментировать с самым разным оборудованием: от современных мощных GPU серии RTX до одноплатных компьютеров и старых игровых сборок. В то время как видеокарты Nvidia традиционно показывают себя лучше всего, автор решил проверить, способна ли устаревшая видеокарта Intel Arc A750 справиться с задачами инференса AI.

Настройка серверной среды и подготовка ПО
Для эксперимента был выбран сервер под управлением Proxmox, оснащенный двумя процессорами Xeon 2650 v4 и 64 ГБ оперативной памяти DDR4 ECC. В качестве программного окружения использовался контейнер LXC на базе Debian, так как автор счел Windows 11 слишком ресурсоемкой для данной задачи. Основным движком для запуска нейросетей стал llama.cpp с использованием API Vulkan.
Процесс подготовки включал следующие шаги:
- Обновление драйверов Vulkan на хосте с помощью команд apt install -y mesa-vulkan-drivers vulkan-tools libvulkan1.
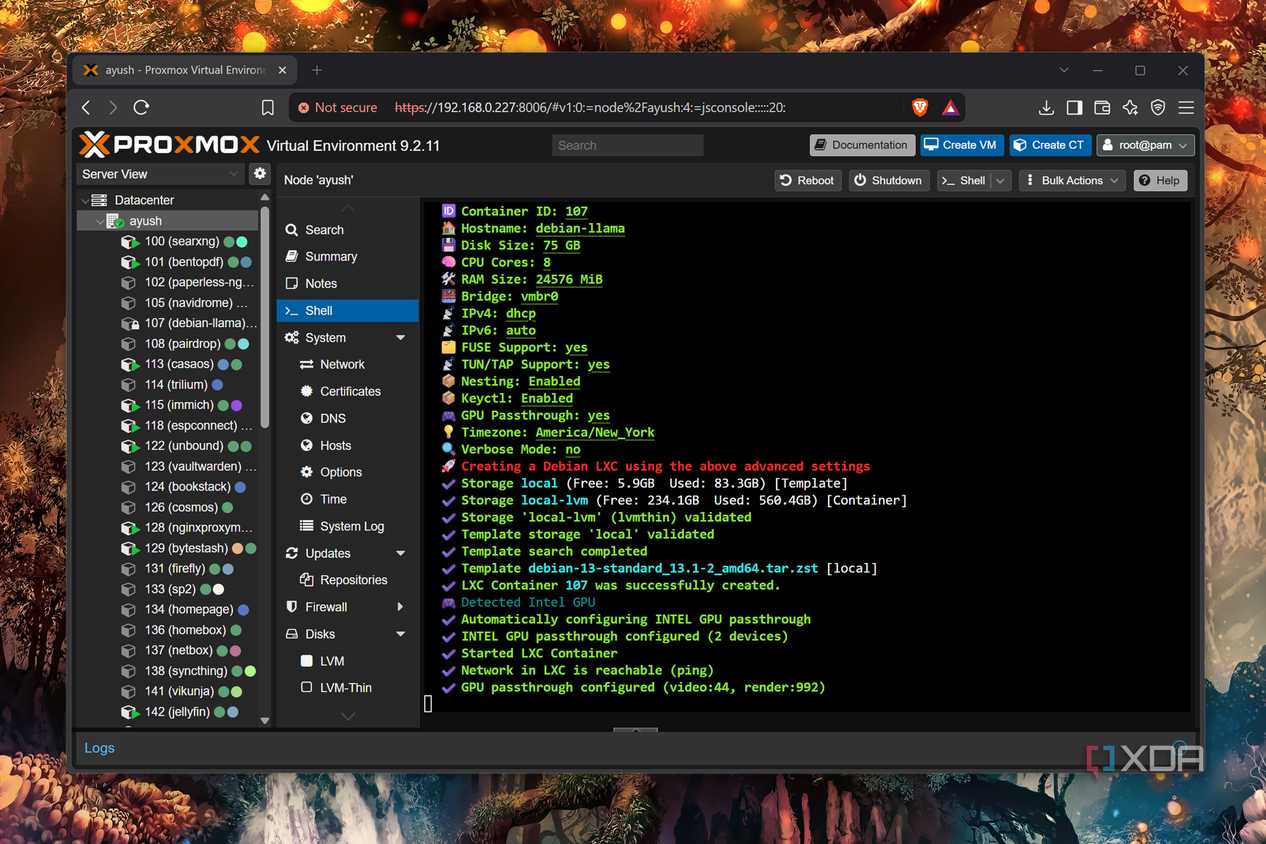
- Настройка проброса GPU в контейнер через скрипты автоматизации Proxmox.
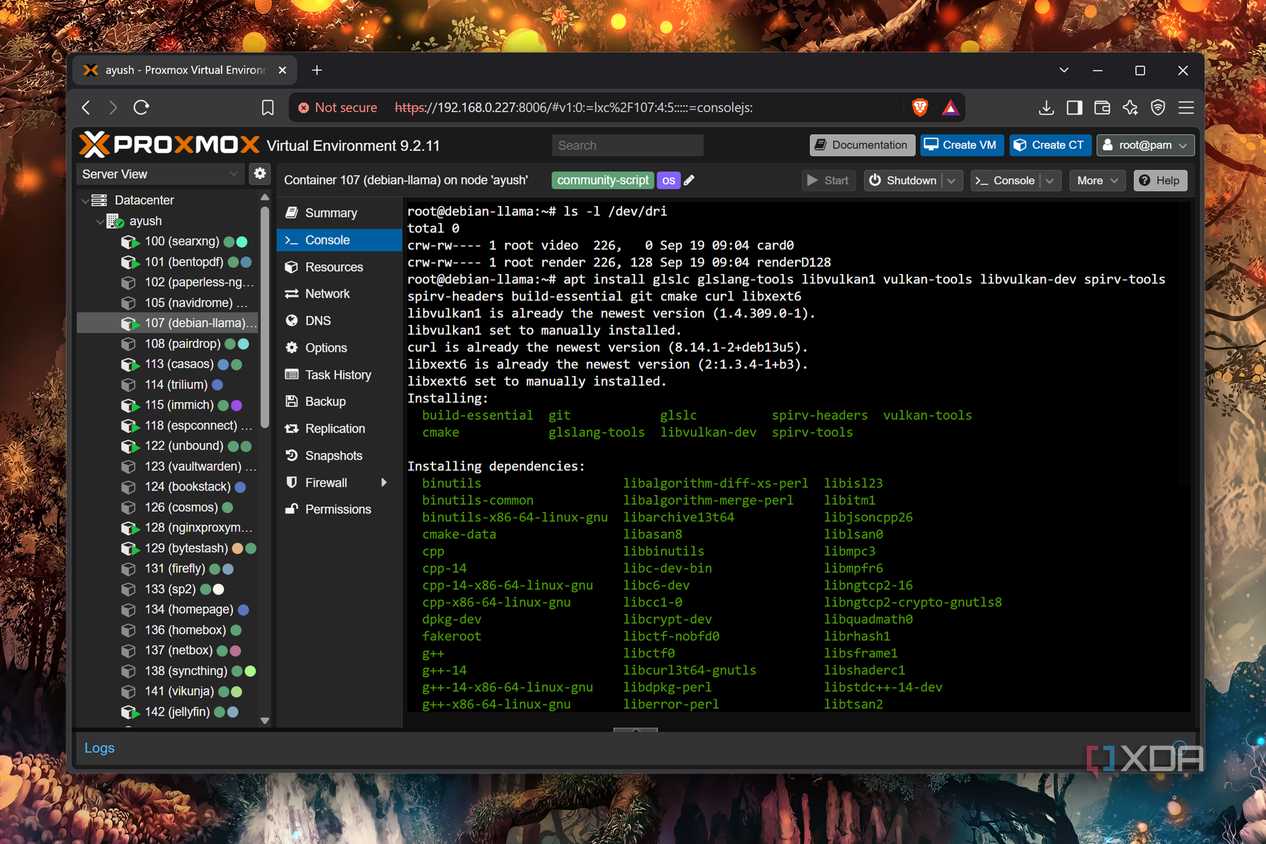
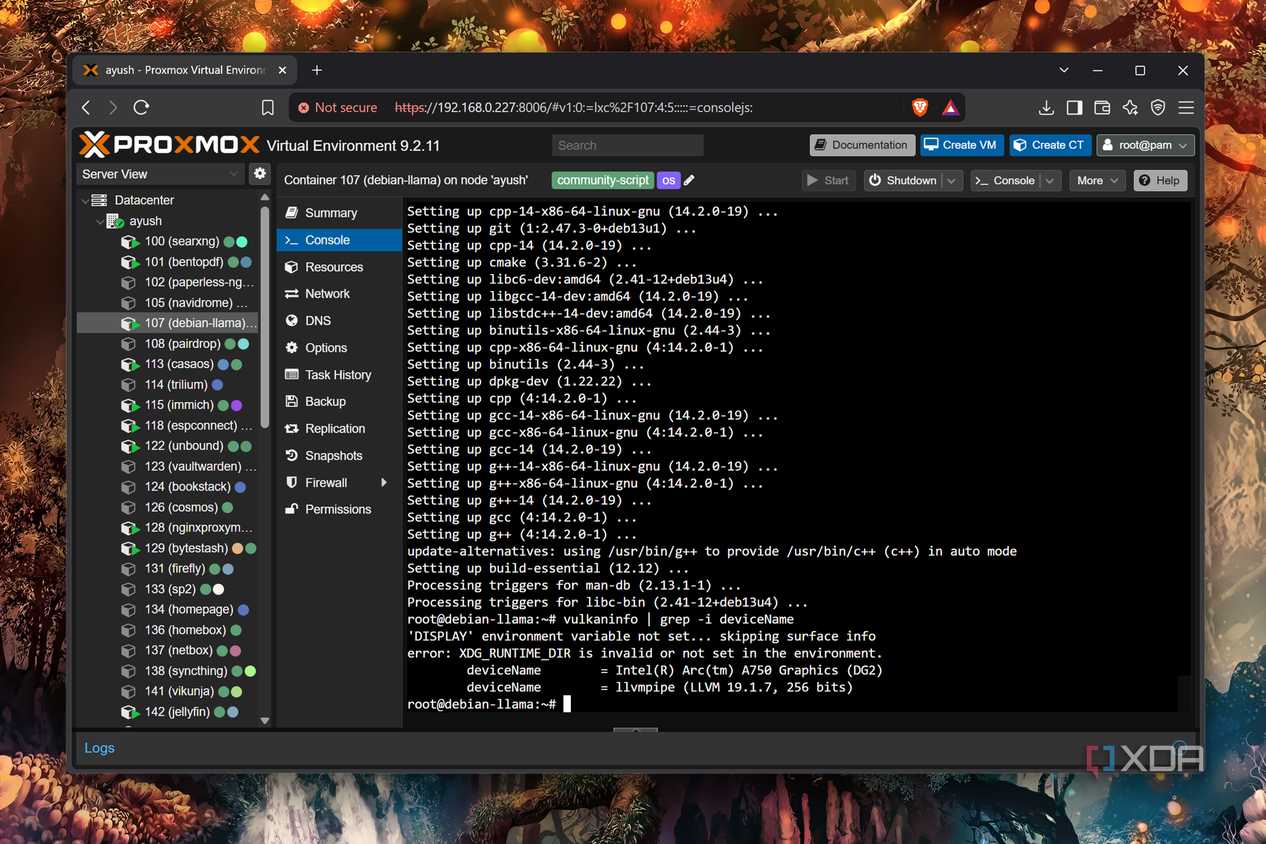
- Установка зависимостей внутри контейнера, включая glslc, glslang-tools и библиотеки для компиляции cmake.
- Проверка корректности проброса устройства командой vulkaninfo | grep -i deviceName, которая подтвердила распознавание Intel Arc A750.
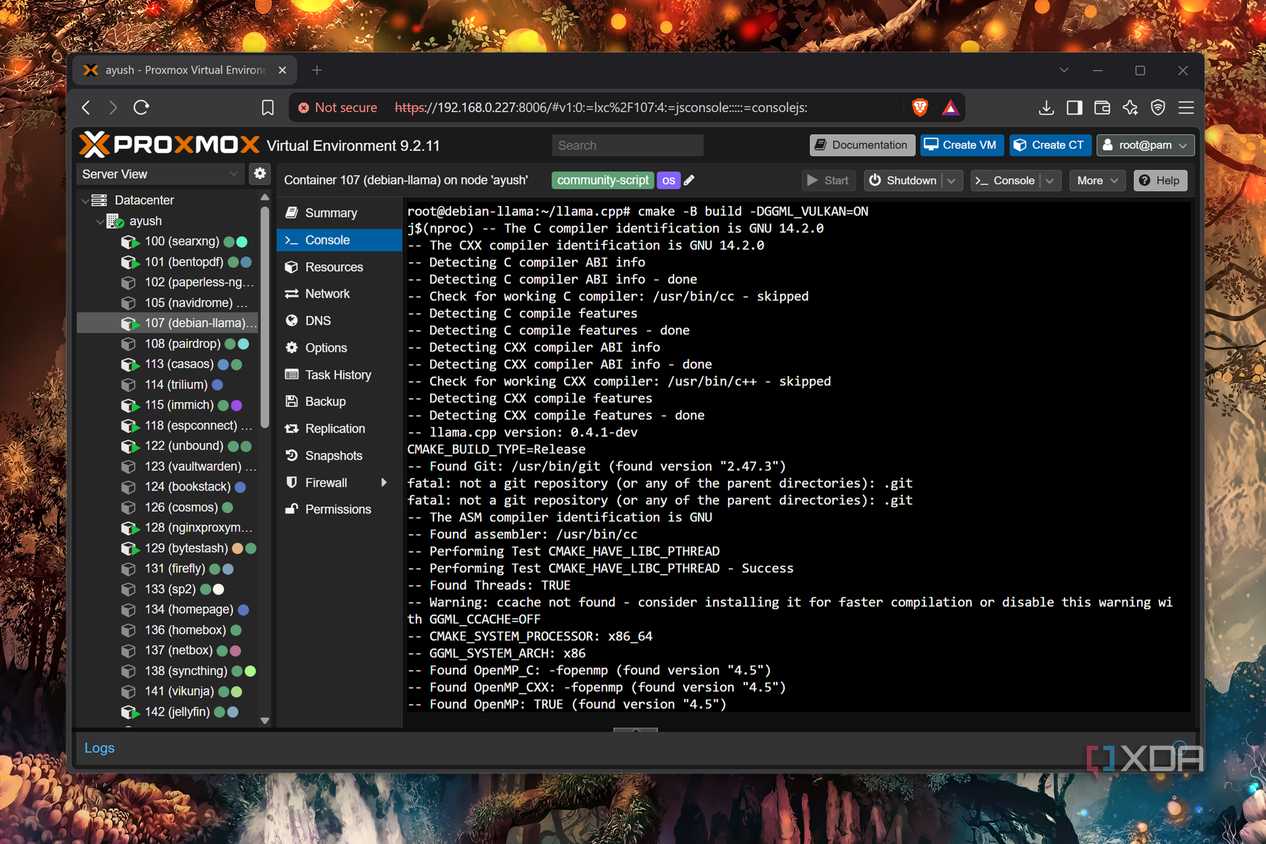
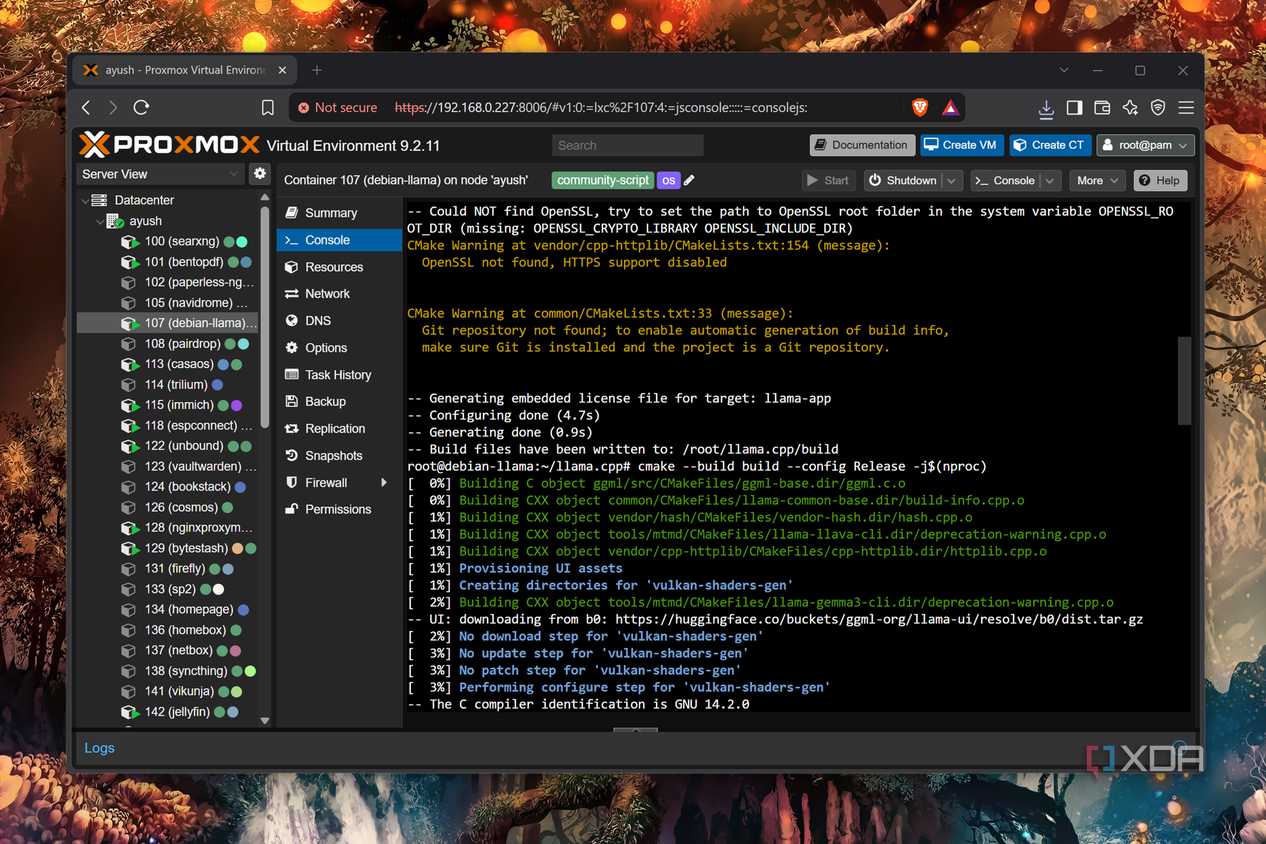
- Компиляция llama.cpp с поддержкой Vulkan через cmake -B build -DGGML_VULKAN=ON.
Производительность в задачах инференса
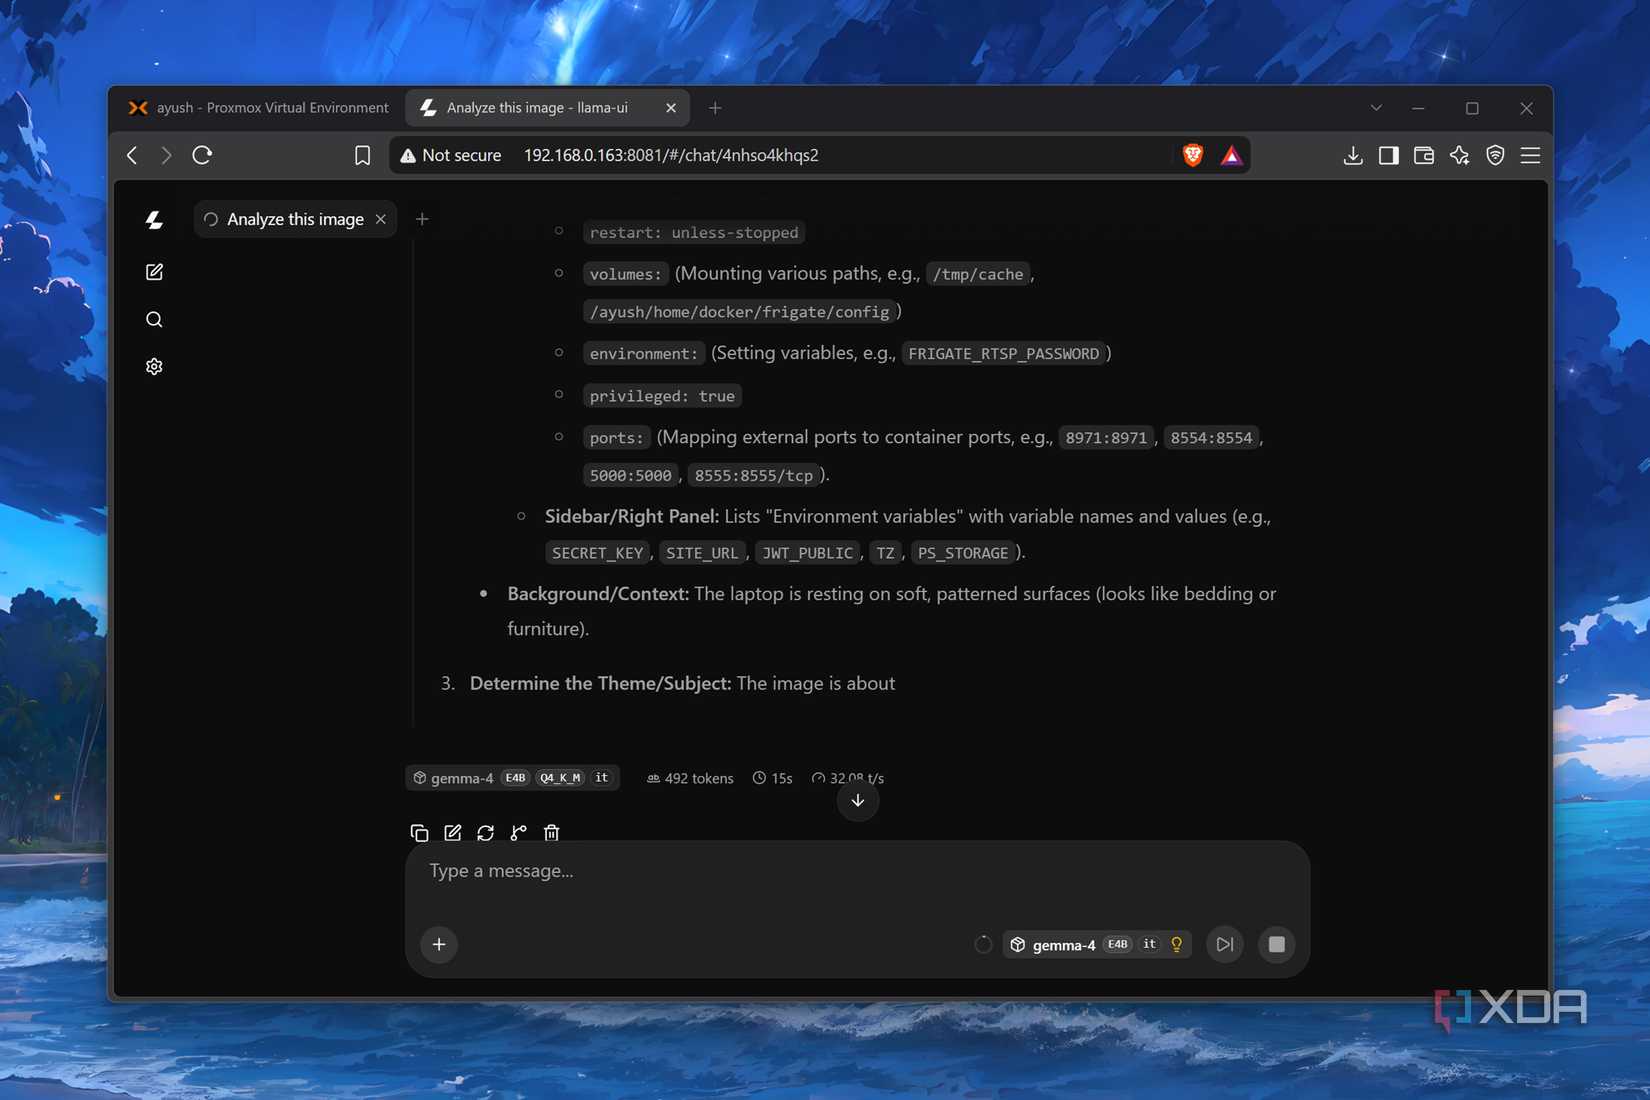
Первым объектом тестирования стала модель Gemma-4-E4B. Результаты превзошли ожидания: Intel Arc A750 обеспечила генерацию текста со скоростью около 33 токенов в секунду, лишь незначительно уступая карте GTX 1080 (разница составила 4–6 токенов в секунду). Система стабильно обрабатывала различные типы данных, включая изображения, аудиофайлы и объемные таблицы.
Ограничения моделей Mixture-of-Experts
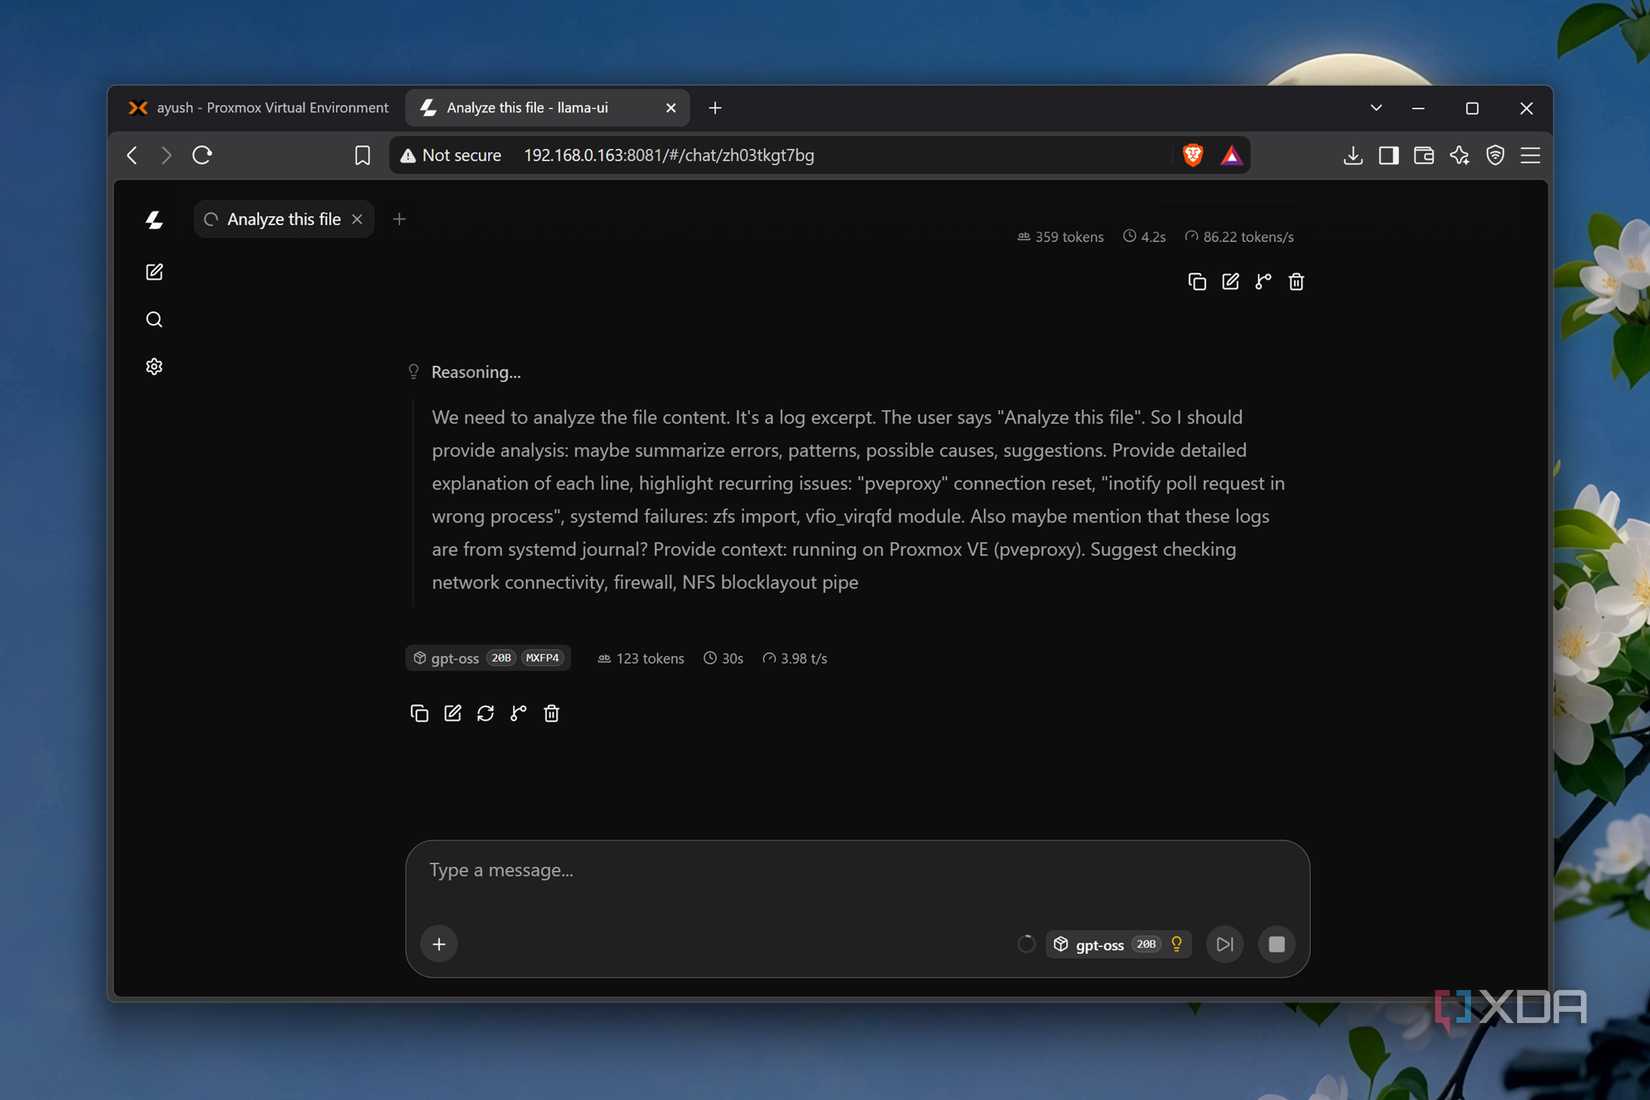
Ситуация значительно изменилась при работе с моделями Mixture-of-Experts (MoE). Хотя архитектура MoE позволяет выгружать часть слоев на CPU и системную память, видеокарта Arc A750 продемонстрировала низкую эффективность в этом сценарии. При запуске Gemma-4-26B-A4B с 30 слоями на CPU скорость генерации упала до 3,5 токенов в секунду. Дальнейшие попытки оптимизации, такие как уменьшение количества слоев или изменение окна контекста, приводили либо к тем же показателям, либо к аварийному завершению работы llama.cpp. Аналогичные результаты были получены при тестировании модели GPT-OSS-20B.
Вероятной причиной низкой производительности при использовании флагов MoE-выгрузки могут быть программные ошибки в llama.cpp, на что указывают профильные обсуждения в сообществе разработчиков. Несмотря на сложности с MoE, эксперимент признан успешным: Intel Arc A750 подтвердила свою состоятельность для запуска менее объемных локальных моделей в паре с более мощными GPU.
Опыт использования других GPU
Помимо Arc A750, в арсенале автора имеется GTX 1080, которая на текущий момент активно используется для рабочих задач в Docker. Эта карта, несмотря на возраст, демонстрирует отличную работу с современными архитектурами: на ней стабильно запускаются GPT-OSS-20B и Gemma-4-26B-A4B. Ключом к производительности в данном случае выступает грамотное использование MoE-offloading (разгрузки слоев смеси экспертов). Успешный опыт с GTX 1080 и послужил отправной точкой для идеи проверить, на что способна дискретная видеокарта Intel в аналогичных сценариях.
Тонкости настройки Proxmox и контейнеров
При настройке эксперимента автор отметил важную деталь: Proxmox автоматически распознал Intel Arc A750 сразу после установки в систему, что стало приятным сюрпризом на фоне опыта с Nvidia GTX 1080. Процесс проброса GPU был автоматизирован с помощью скрипта сообщества (Community Scripts), где на этапе настройки была выбрана опция GPU passthrough.
Для полноценной работы llama.cpp внутри контейнера Debian был выполнен развернутый список команд установки зависимостей:
- glslc
- glslang-tools
- libvulkan1
- vulkan-tools
- libvulkan-dev
- spirv-tools
- spirv-headers
- build-essential
- git
- cmake
- curl
- libxext6
Эти библиотеки необходимы для корректной работы Vulkan-бэкенда и успешной компиляции движка.
Нюансы тестирования Gemma-4-E4B
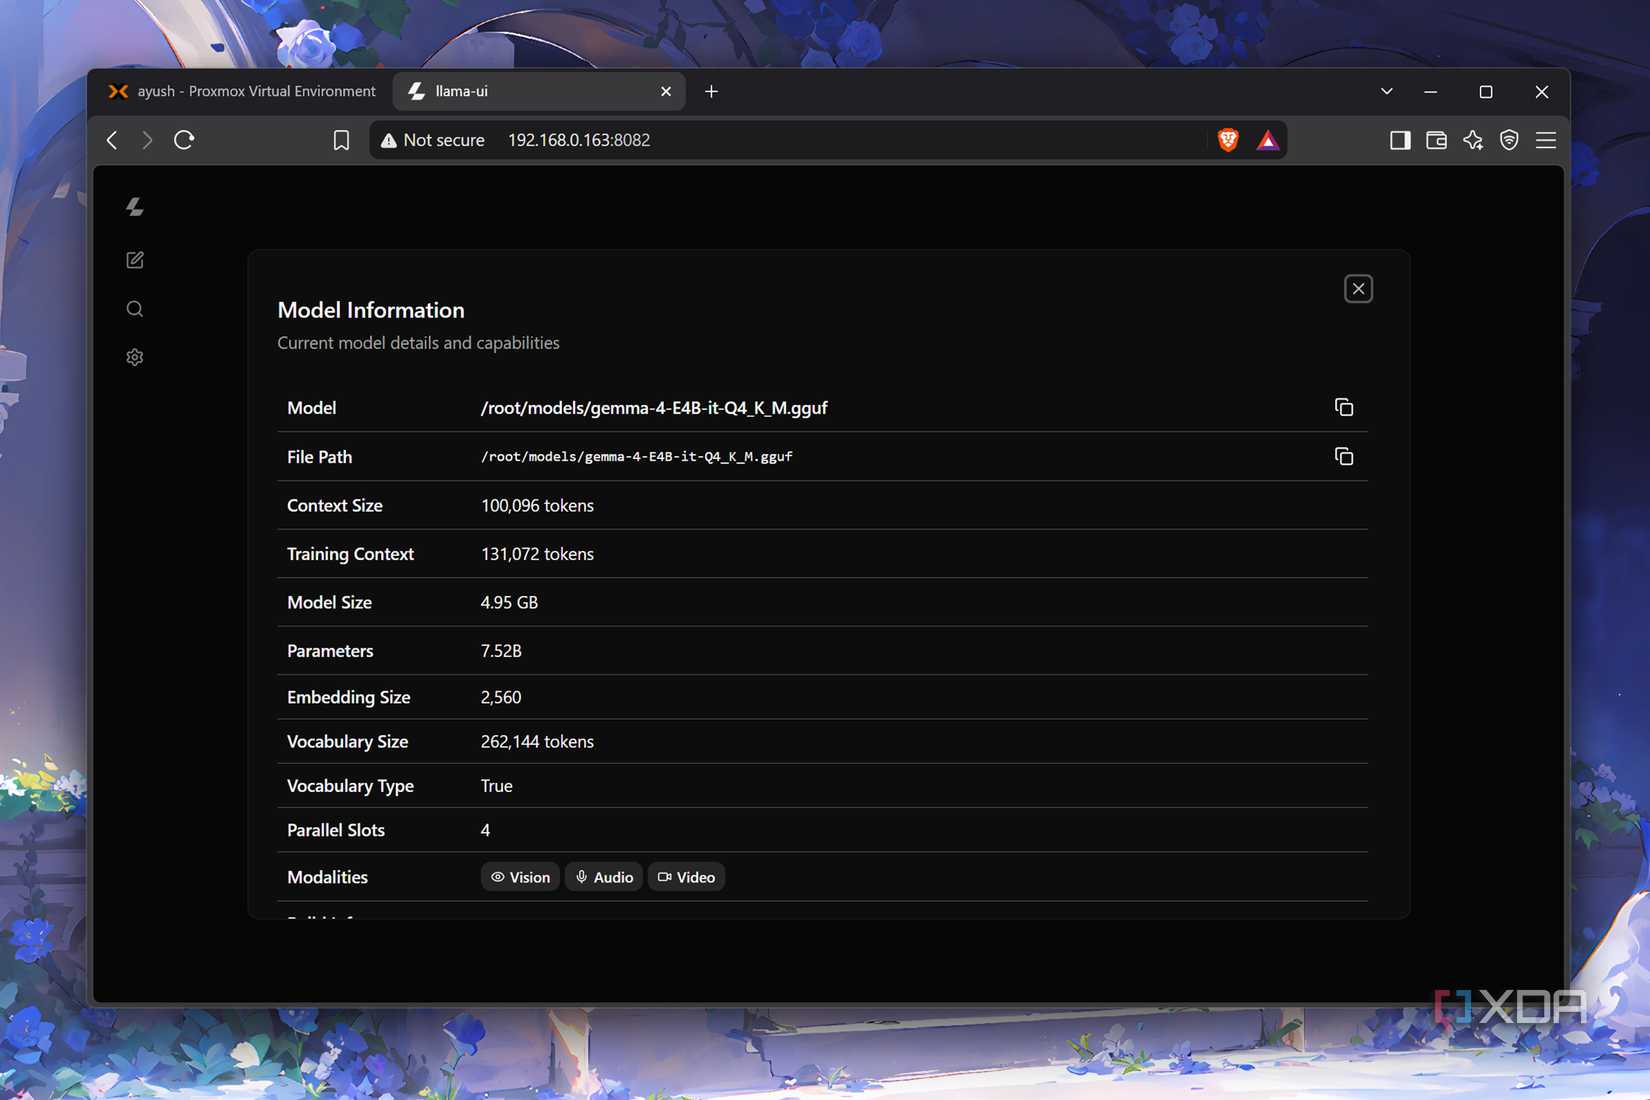
При запуске Gemma-4-E4B использовалась конфигурация с контекстным окном в 100 000 токенов, а файл модели и вспомогательный MMPROJ-файл были размещены в директории /root/models. Команда запуска включала параметры -ngl 999 для максимального использования графического ядра. В ходе тестов Arc A750 выдавала 33 токена в секунду, иногда просаживаясь до 28 токенов в секунду. Это стало неожиданностью, так как изначально от видеокарты первого поколения ожидалась производительность ниже 15 токенов в секунду. Карта успешно справилась не только с текстом, но и с мультимодальными задачами, включая обработку изображений и звуковых клипов.
Анализ проблем с MoE
Эксперименты с MoE-моделями выявили жесткие границы возможностей Arc A750. Для сравнения: GTX 1080 (имеющая всего 8 ГБ видеопамяти) справляется с Gemma-4-26B-A4B на скорости 14+ токенов в секунду благодаря эффективному распределению нагрузки. На Arc A750 попытки оптимизации привели к следующим результатам:
- Установка 20 слоев на CPU приводила к мгновенному крашу приложения.
- Установка 25 слоев при ограничении контекста до 10 000 токенов не дала прироста производительности, сохранив низкий показатель в 3,5 токена в секунду.
Вероятно, текущая реализация драйверов Intel в связке с конкретными флагами выгрузки llama.cpp пока не оптимизирована для MoE-архитектур, что подтверждается отчетами пользователей на GitHub. Тем не менее, автор планирует оставить Arc A750 в системе как вспомогательное решение для легких задач, чтобы разгрузить GTX 1080 для более тяжелых моделей.
В ходе эксперимента автор также отметил, что в его коллекции оборудования для локальных LLM побывали самые разнообразные устройства — от полноценных серверов на базе мощных RTX-карт до Raspberry Pi. Личный опыт показал, что видеокарты Nvidia остаются наиболее предпочтительным выбором для инференса, причем не только современные модели с тензорными ядрами, но и решения прошлых поколений. Например, старая GTX 1080 до сих пор успешно используется для повседневных задач в Docker, обеспечивая достойную скорость работы с такими моделями, как GPT-OSS-20B и Gemma-4-26B-A4B.
Особенности выбора ПО и платформы
Важным аспектом эксперимента стал выбор программной экосистемы. Автор сознательно отказался от популярных решений вроде Ollama в пользу llama.cpp, стремясь к минимальному вмешательству платформы хостинга в процесс работы нейросети. Использование Windows 11 было исключено на ранних этапах из-за «раздутости» системы, поэтому выбор пал на связку Proxmox и контейнеризацию через LXC. Примечательно, что в процессе настройки проброса графического ускорителя автор использовал автоматизированный скрипт с GitHub (community-scripts/ProxmoxVE), который позволил развернуть среду с поддержкой GPU всего за несколько минут.
Технические детали запуска
Для корректной компиляции llama.cpp с поддержкой Vulkan в Debian-контейнере была выполнена сборка с использованием следующих команд: cmake -B build -DGGML_VULKAN=ON и cmake —build build —config Release -j$(nproc). Что касается запуска Gemma-4-E4B, то команда выглядела следующим образом:
./llama-server -m «/root/models/gemma-4-E4B-it-Q4_K_M.gguf» —mmproj «/root/models/mmproj-gemma-4-E4B-it-BF16.gguf» -c 100000 —host 0.0.0.0 —port 8081 -ngl 999
Такой подход позволил достичь стабильной работы с большим контекстным окном в 100 000 токенов, при этом Intel Arc A750 показала себя как вполне жизнеспособное решение для задач, не требующих активного использования сложных MoE-архитектур.