Запуск локальных моделей искусственного интеллекта на домашнем оборудовании требует баланса между объемом памяти и вычислительной мощностью. Тестирование двух различных конфигураций — домашней лаборатории на базе процессора Intel Core i7-6700K с дискретной видеокартой NVIDIA RTX 3080 (10 ГБ VRAM) и неттопа Minisforum MS-03 с чипом Intel Core Ultra 9 386H — выявило ключевые различия в производительности и удобстве использования таких систем.
Особенности работы с MoE-моделями
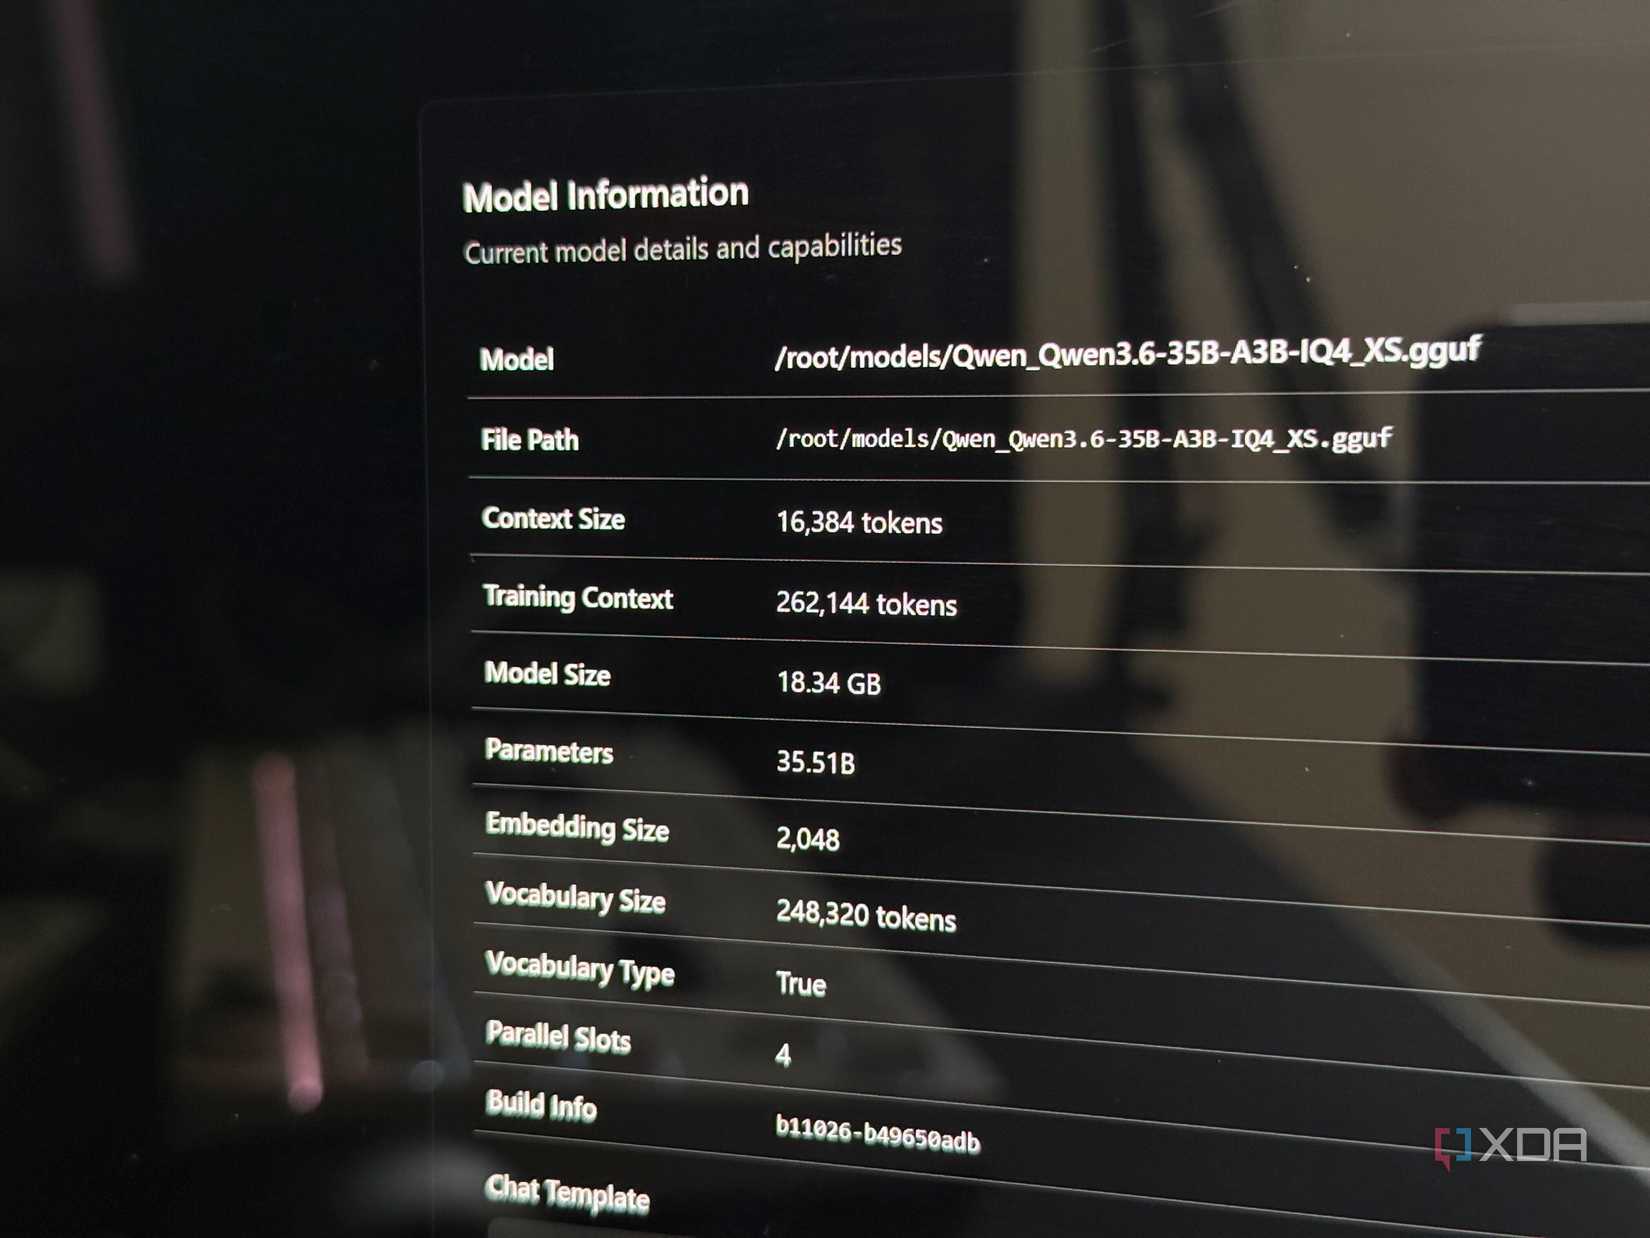
Современные большие языковые модели часто используют архитектуру «смеси экспертов» (MoE), что позволяет им не задействовать все параметры одновременно при генерации каждого токена. Например, модель Qwen3.6-35B-A3B имеет около 35 миллиардов параметров, но активирует лишь около трех миллиардов для обработки одного токена. Аналогичный принцип используется в Gemma 4 26B, где задействуются четыре миллиарда параметров из 25,23 миллиарда.
Применение квантования позволяет значительно уменьшить объем занимаемой памяти. Так, модель Qwen3.6-35B-A3B в формате Q4_K_M занимает 20,74 ГИБ, тогда как сборка IQ4_XS требует лишь 18,34 ГИБ. Однако I-quants более требовательны к вычислительным ресурсам при декодировании, где преимущество получают системы с мощным графическим процессором.
Производительность графического процессора и ограничения памяти
Видеокарта RTX 3080 обладает 10 ГБ видеопамяти, из которых после выделения ресурсов драйвером остается доступно около 9873 МиБ. Этого недостаточно для размещения весов даже 4-битных версий крупных моделей, таких как Qwen3.6-35B-A3B. В таких условиях мини-ПК Minisforum MS-03 оказывается более удобным решением, так как располагает 32 ГБ системной памяти, что позволяет запускать модели, превышающие объем видеопамяти дискретной карты.
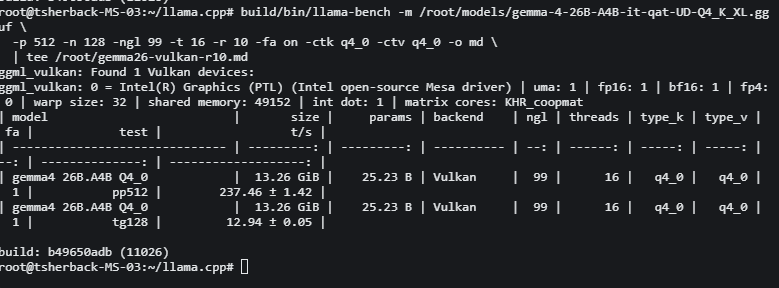
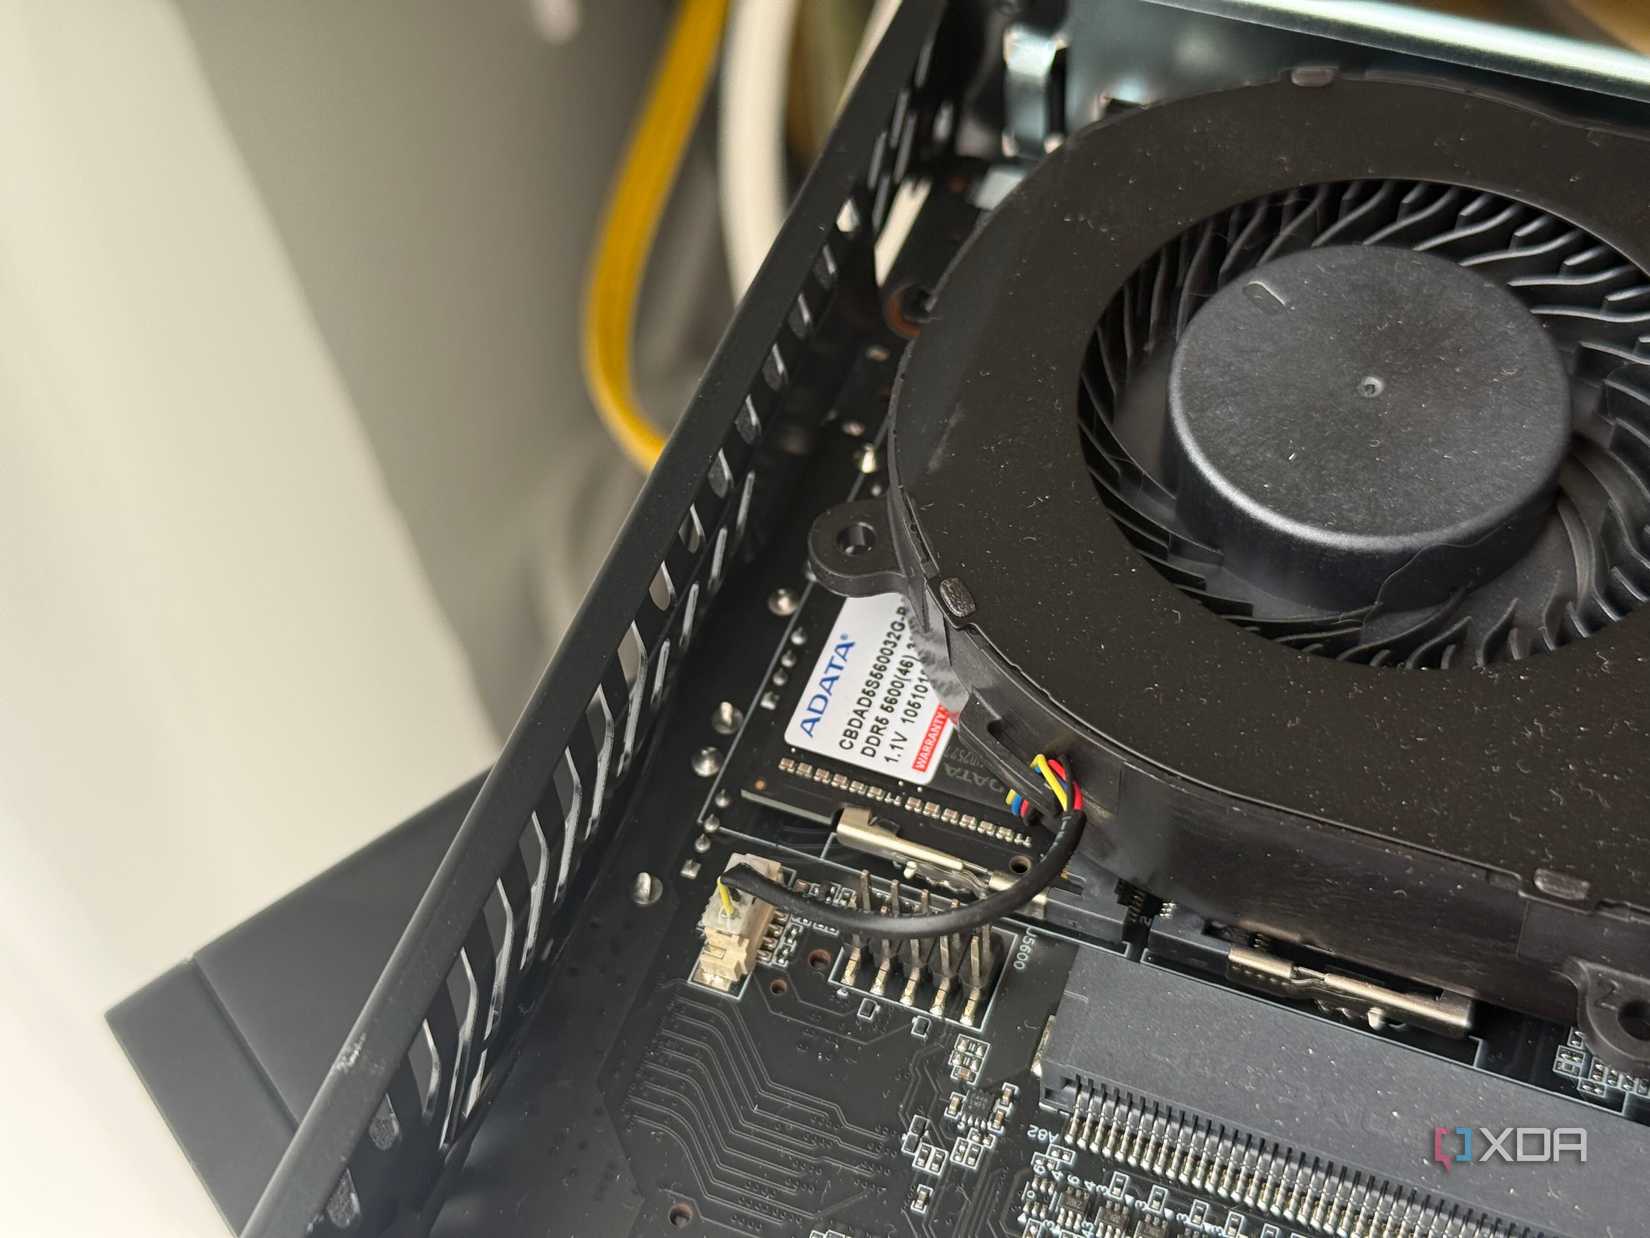
При тестировании на Minisforum MS-03 наиболее стабильные результаты показал API Vulkan. Скорость генерации (декодирования) для модели Gemma 4 26B составила от 9 до 13 токенов в секунду. Столь низкий показатель относительно заявленных производителем скоростей объясняется тем, что тестовый образец был оснащен лишь одним модулем оперативной памяти SODIMM, работающим в одноканальном режиме. Добавление второго модуля памяти теоретически могло бы удвоить производительность системы.
Оптимизация распределения весов
Для запуска тяжелых моделей на видеокарте с ограниченным объемом памяти в llama.cpp используется флаг —n-cpu-moe. Он позволяет выгружать часть экспертных слоев модели в системную оперативную память, оставляя критические веса в видеопамяти. Настройка этого баланса является ключевой для успешного запуска.
В ходе тестов на системе с RTX 3080 при ограничении контейнера до 10 ГБ ОЗУ, использование параметра -ncmoe 24 позволило добиться скорости генерации 45,02 токена в секунду для модели IQ4_XS. При этом важно учитывать, что при нехватке видеопамяти и активном обмене данными с системным накопителем через NVMe, скорость декодирования снижается на 25–37% по сравнению с оптимальным распределением.
Преимущества и характеристики Minisforum MS-03
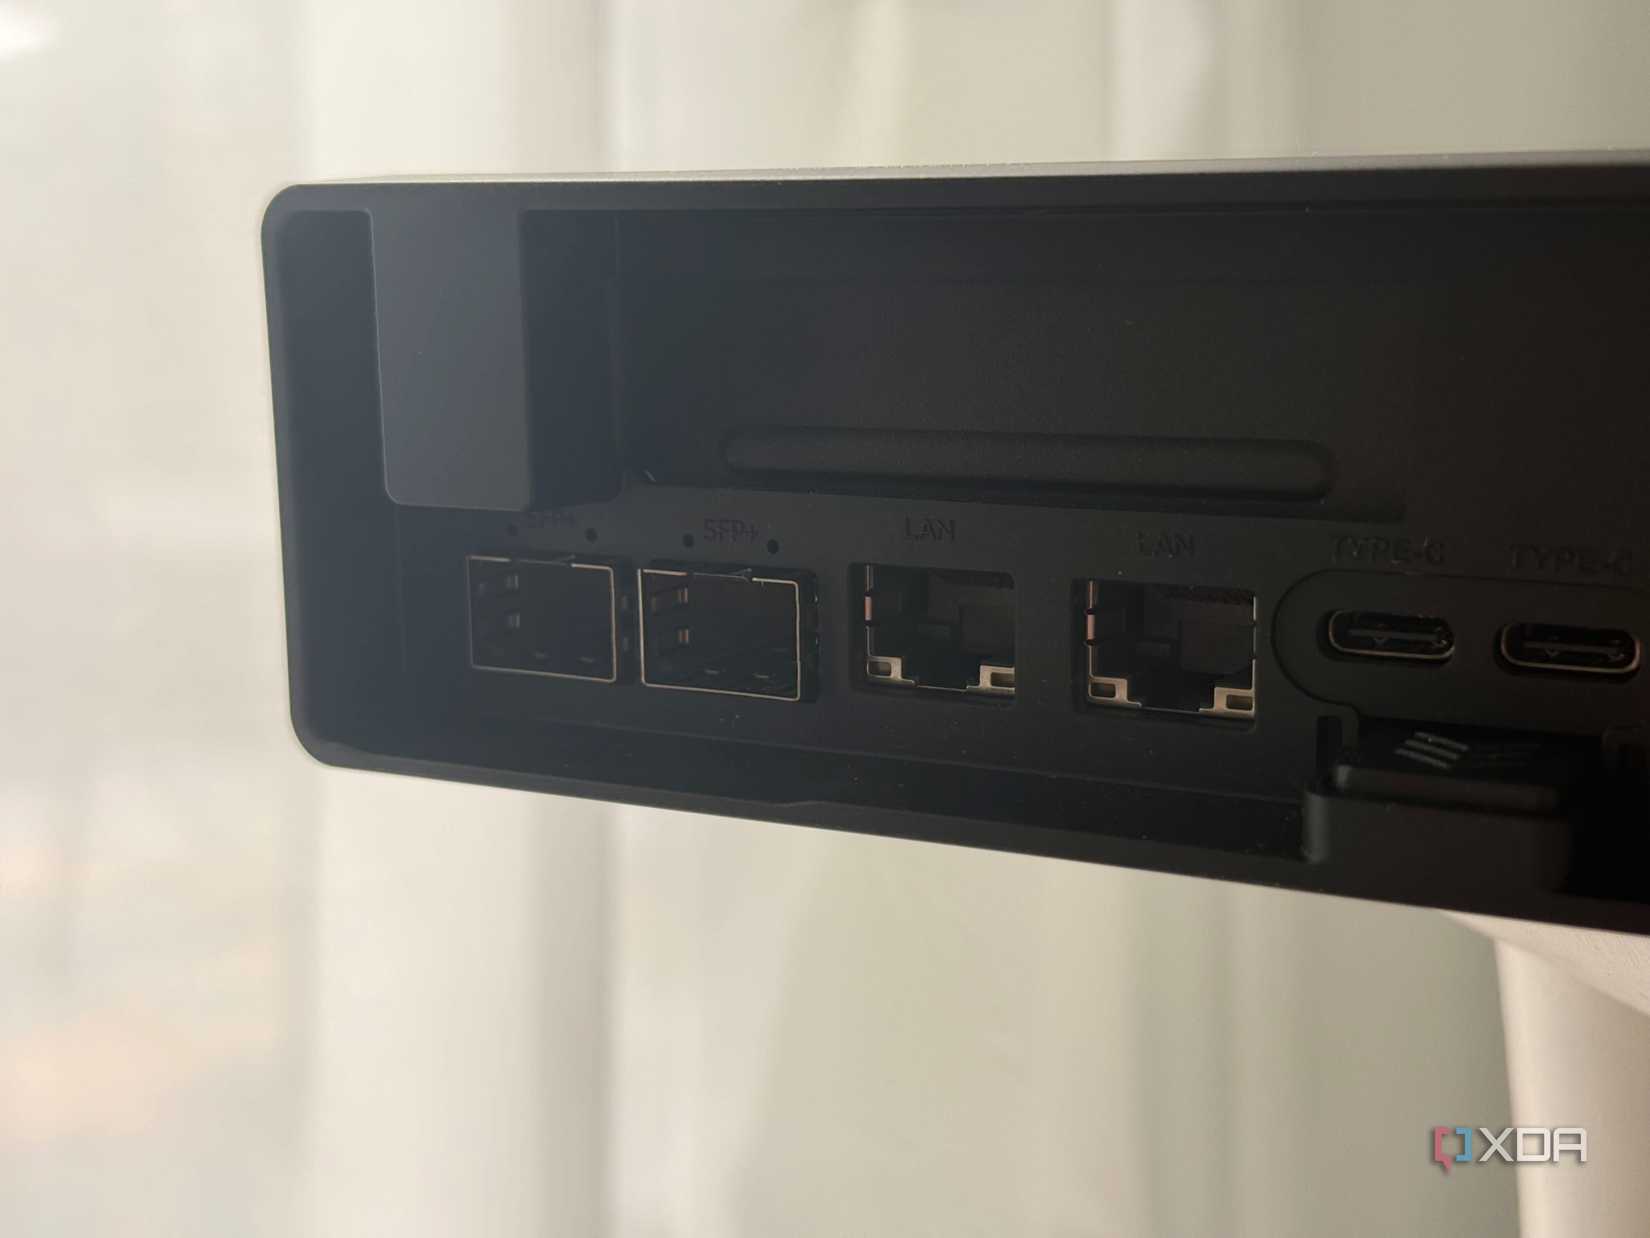
Мини-ПК Minisforum MS-03 выделяется высокой степенью готовности к работе и богатыми сетевыми возможностями, включая два порта 10GbE SFP+, один 10GbE RJ-45 и один 2.5GbE RJ-45. Система поддерживает до 128 ГБ оперативной памяти DDR5-5600 и установку до трех NVMe-накопителей PCIe 5.0 общим объемом до 8 ТБ. Несмотря на отсутствие дискретного GPU, наличие унифицированной памяти позволяет более предсказуемо оценивать совместимость с различными моделями ИИ, просто опираясь на спецификации оборудования.
Особенности работы с MoE-моделями и роль квантования
Важно уточнить механику работы MoE-архитектуры: пока роутер выбирает подмножество специализированных подсетей для обработки конкретного токена, слои внимания и общие веса (shared weights) всегда остаются активными и задействуются при каждом шаге. Это принципиальное отличие, которое позволяет «упаковать» огромные модели в доступные потребительские объемы памяти, не жертвуя их общими интеллектуальными возможностями.
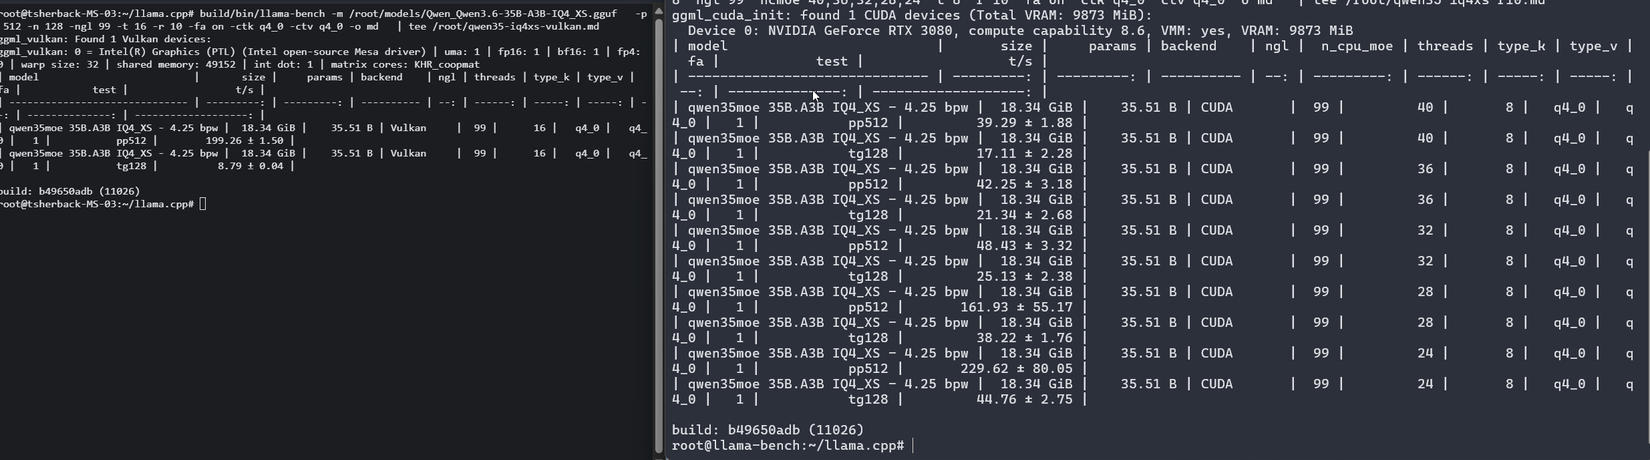
При использовании форматов сжатия (квантования) разница в несколько бит на параметр становится критической для производительности. Например, переход от версии Q4_K_M (5 бит на параметр) к IQ4_XS (4,25 бит на параметр) дает существенную экономию памяти — 2,4 ГИБ. Однако за это приходится платить ростом нагрузки на вычислительные блоки: I-quants требуют больше ресурсов для декодирования, что делает наличие мощного графического процессора весомым аргументом в пользу систем с дискретными видеокартами.
Ограничения системы с дискретной GPU и тонкая настройка
В моей домашней лаборатории RTX 3080 оказалась ограничена порогом в 9 873 МиБ доступной видеопамяти. Чтобы запустить модель Qwen3.6-35B-A3B, пришлось пойти на компромисс и использовать частичное выгружение весов экспертов. Флаг —n-cpu-moe в llama.cpp позволяет гибко управлять этим процессом. Модель состоит из 41 слоя, и при установке значения -ncmoe 40 почти все данные перемещаются в системную ОЗУ. По мере уменьшения этого числа, система «возвращает» слои обратно на видеокарту.
Поиск идеального баланса был критичен для производительности:
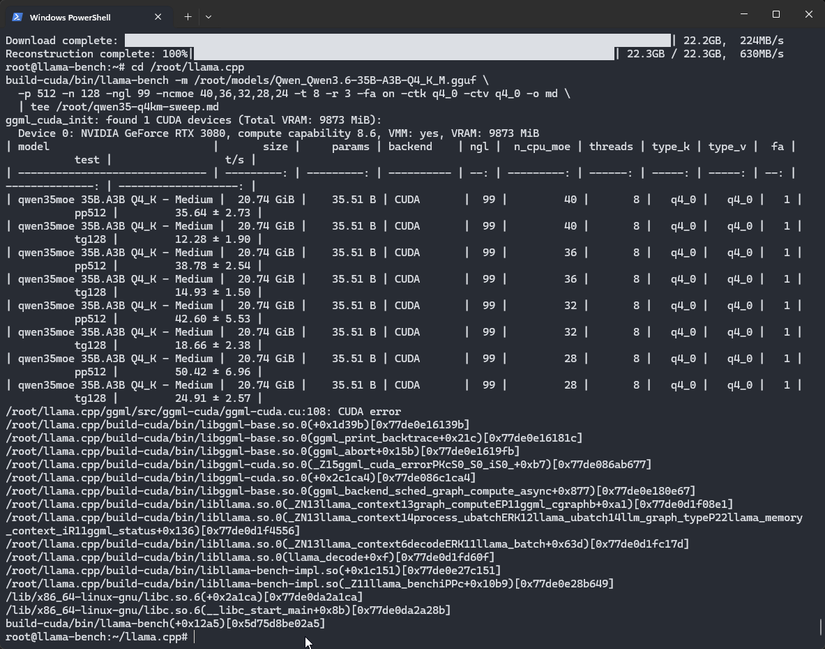
- При -ncmoe 40 (почти полная выгрузка в RAM): 16,45 ток/с.
- При -ncmoe 36: 19,72 ток/с.
- При -ncmoe 24: 45,02 ток/с (точка, где карта максимально нагружена без переполнения).
Ниже значения 24 система выдавала ошибку выделения памяти, что указывает на жесткий предел моей текущей конфигурации. Стоит отметить, что модель Q4_K_M (на 2,4 ГИБ «тяжелее» IQ4_XS) оказалась неспособна работать даже при значении 24, а предел ее скорости составил всего 24,91 ток/с на предыдущем шаге настройки.
Главная проблема такого подхода — постоянное обращение к NVMe. Поскольку контейнер LXC был ограничен 10 ГБ ОЗУ, данные, не уместившиеся в видеопамять, постоянно сбрасывались и считывались с накопителя. Это приводило к тому, что скорость декодирования падала на 25–37% по сравнению с вариантами, где все экспертные веса удавалось удержать в оперативной памяти.
Преимущества Minisforum MS-03
Мини-ПК MS-03 выигрывает за счет простоты: он готов к работе «из коробки», тогда как эксперименты с картой требуют ручного подбора параметров и лимитов. Хотя в моих тестах на Windows 11 запуск моделей был чуть более предсказуемым, я выбрал Linux для основного использования из соображений удобства. Работа через API SYCL и OpenVINO показала крайне нестабильные результаты, часто завершаясь вылетами, поэтому наиболее надежным инструментом оказался Vulkan. Несмотря на то, что полученные 9–13 ток/с заметно уступают заявленным производителем 22,05 ток/с, это не делает устройство бесполезным — оно отлично подходит для суммаризации длинных документов, особенно учитывая высокую скорость префилла.
Полная техническая спецификация Minisforum MS-03 для контекста:
- Процессор: Intel Core Ultra 9 386H.
- Память: 32GB DDR5-5600 (с возможностью расширения до 128 ГБ).
- Накопитель: 1 TB NVMe PCIe 5.0 (поддержка до 8 ТБ, 3 слота M.2).
- Графика: Intel Graphics.
- Сетевые модули: 1 x 10GbE RJ-45 (Realtek RTL8127), 1 x 2.5GbE RJ-45 (Intel i226-LM), 2 x 10G SFP+ (Intel X710).
Дисклеймер: Minisforum предоставила устройство для тестирования, однако компания не влияла на содержание данного материала и не знакомилась с ним до публикации.