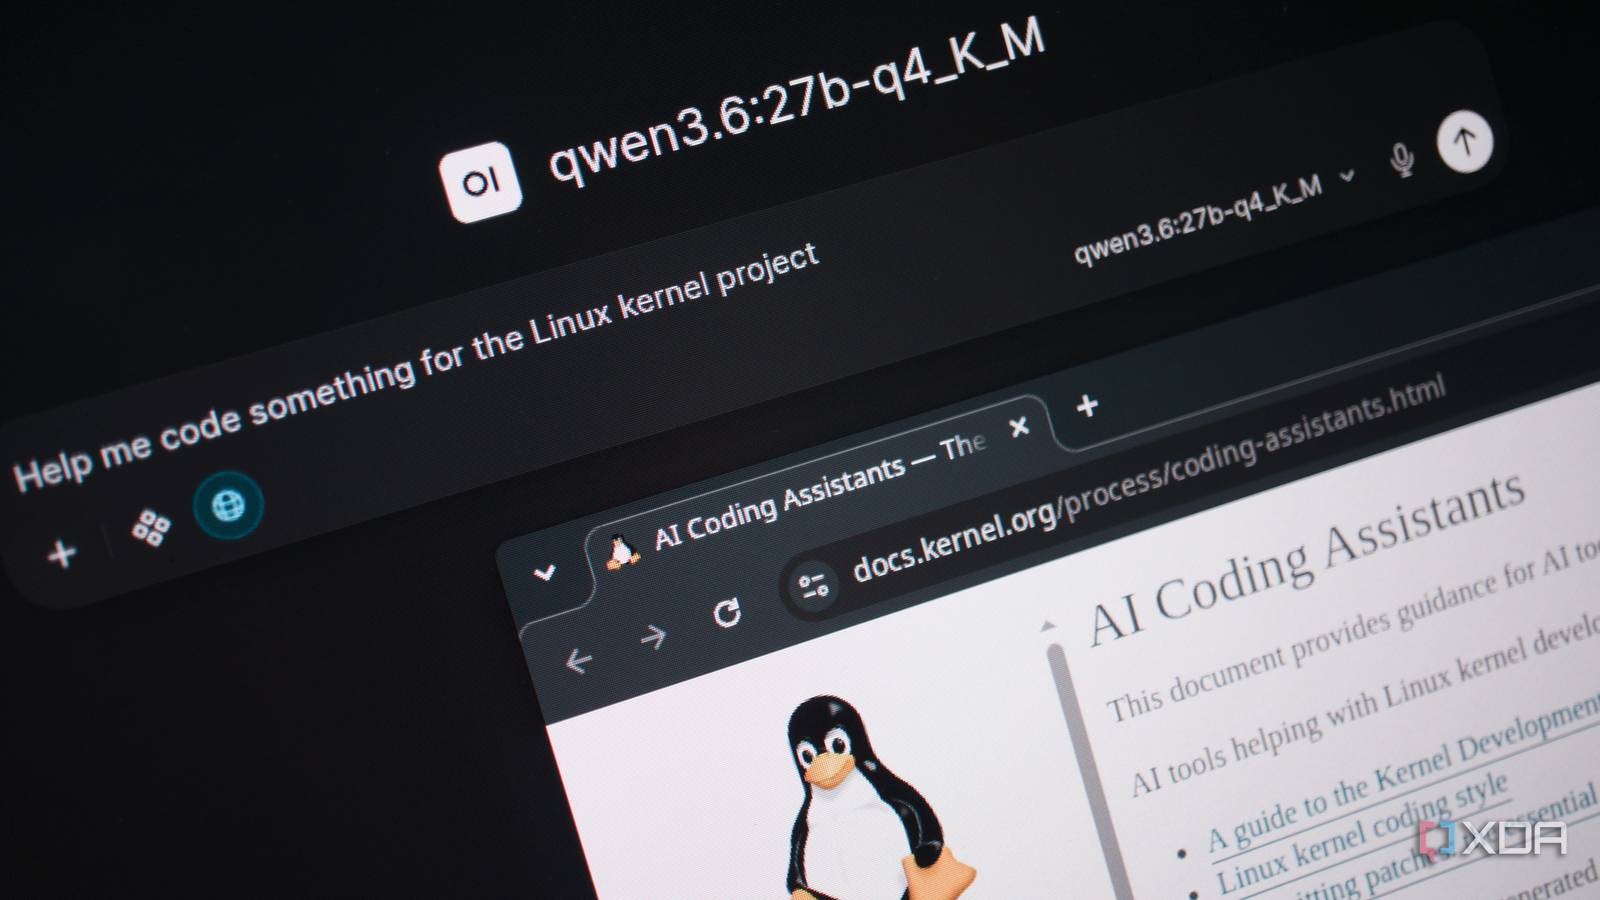
Популярность нейросетей, таких как Claude и ChatGPT, привела к росту объема кода, создаваемого с помощью больших языковых моделей (LLM). Это явление часто называют «информационным мусором» (slop), так как подобные правки требуют тщательной проверки людьми, чтобы понять, какой результат пытался получить ИИ. Для борьбы с этой проблемой авторы ядра Linux разработали официальные рекомендации, которые эксперты называют одним из лучших руководств для работы с ИИ-агентами.
Соблюдение процессов разработки при использовании ИИ
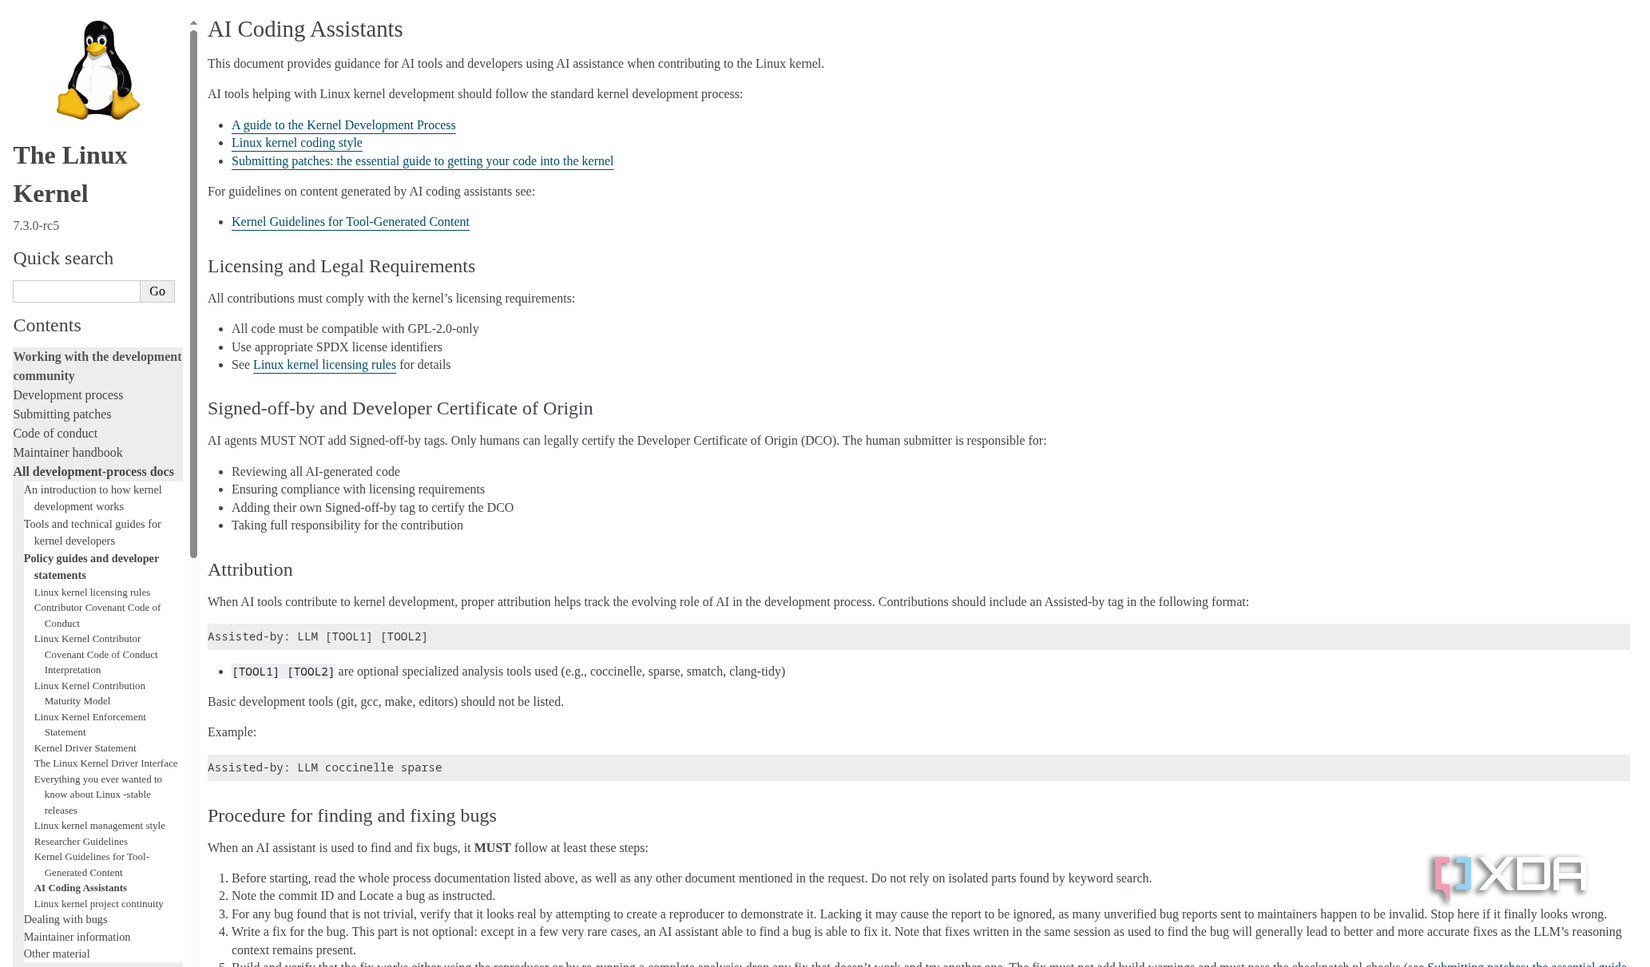
Основной акцент в руководстве сделан на интеграции ИИ в существующие процессы. Создать приложение с нуля — это одно, но внести правки или исправить ошибку в сложной системе, такой как ядро Linux, требует глубокого понимания контекста. ИИ-агент не должен ограничиваться поиском по ключевым словам; разработчики подчеркивают, что модель обязана «изучить» всю документацию проекта, включая архитектуру, правила тестирования, процедуры релиза и границы ответственности. Предоставление всех этих материалов в контекстное окно модели критически важно, так как без полного понимания проектной структуры LLM склонны генерировать правдоподобные, но не существующие решения или ошибочно определять причины багов.
Доказательная база и проверка гипотез
Согласно новым правилам, агенты должны предоставлять доказательства своих выводов, а не просто пересказывать причины найденных проблем. Важно, чтобы ИИ мог аргументированно подтвердить наличие ошибки, опираясь на фактические логи, а не на домыслы. Это минимизирует риски внесения некачественного кода, который в дальнейшем может привести к серьезным сбоям у конечных пользователей.
Автоматизация тестирования и ответственность за результат
Современные ИИ-инструменты способны не только генерировать код, но и наблюдать за его выполнением, внося необходимые корректировки. В руководстве отмечается, что процесс поиска ошибки, написания фикса и его тестирования должен происходить в локальном цикле до подачи в репозиторий. Подобный подход позволяет отсеивать нерабочие решения еще на этапе подготовки, не допуская их попадания к рецензентам.
Снижение нагрузки на мейнтейнеров
Человеческие ресурсы по проверке кода ограничены, и лавинообразный поток ИИ-генераций создает огромную нагрузку на добровольцев. Мейнтейнеры ядра Linux уже сейчас усиливают контроль за такими правками: они могут запрашивать дополнительное тестирование, более детальные объяснения изменений или подробный отчет о процессе работы агента. Требование к автору объяснить, что именно делает код, является индикатором того, насколько ответственно человек подошел к процессу.
Сертификация и происхождение кода
Документация также затрагивает вопрос происхождения (provenance). Разработчикам предлагается фиксировать, какие файлы были проанализированы агентом, какая задача была поставлена, какие документы использовались в качестве контекста и каковы результаты тестов. При этом решающим фактором остается человеческая подпись: любая сертификация должна выполняться человеком. Это заставляет submitter’а брать на себя полную ответственность за результат, даже если код был создан машиной, что гарантирует более высокое качество правок, попадающих в репозиторий.
Проблемы контекстного окна и верификации
Одной из ключевых сложностей, на которую указывает руководство ядра Linux, является риск «галлюцинаций» модели. ИИ может сгенерировать крайне убедительное объяснение проблемы, которое не имеет ничего общего с реальностью или текущим состоянием логов. Чтобы этого избежать, руководство настаивает на том, чтобы агент не просто занимался поиском по ключевым словам, а получал доступ ко всей документации проекта с самого начала. Это критически важно, так как репозиторий проекта — это не только набор исходных файлов, но и сложная экосистема, включающая в себя правила именования, архитектурные ограничения, границы владения кодом и жесткие протоколы релизных циклов.
Локальный цикл разработки как фильтр качества
Ранее ИИ-агенты зачастую останавливались на этапе генерации первого чернового варианта кода. Однако современные инструменты позволяют модели наблюдать за процессом исполнения кода и проводить итеративную доработку по запросу пользователя. В Linux kernel настоятельно рекомендуют проводить весь цикл: поиск ошибки, написание патча и его тестирование — исключительно в локальной среде. Такой подход необходим, чтобы ограничить влияние «мусорного» ИИ-кода на человеческие ресурсы. Это особенно актуально в свете того, что мы наблюдаем, например, в Open Home Foundation, где волонтеры буквально захлебываются в потоке низкокачественных правок, генерируемых автоматизированными средствами.
Процедура доказательства и ответственность за код
Разработчики ядра подчеркивают: сам факт того, что агент нашел ошибку и предложил решение, не освобождает человека от контроля. Тот, кто управляет промптами и отправляет патч, обязан лично проверить, действительно ли баг устранен и не вызывает ли новое решение регрессий в других частях системы. Если автор правки не может внятно объяснить, как именно работает его код или почему были приняты те или иные архитектурные решения, для мейнтейнеров это становится «красным флагом», указывающим на некомпетентность или поверхностный подход.
Прозрачность и происхождение (Provenance)
Документация ядра Linux идет еще дальше, вводя строгие требования к прозрачности процесса генерации. Авторы правок должны быть готовы предоставить отчет о «происхождении» кода:
- список файлов, которые были проанализированы ИИ-агентом;
- формулировку исходной задачи;
- перечень документации, загруженной в контекстное окно для принятия решений;
- полный лог пройденных и проваленных тестов в ходе локальной итерации.
«Все знаки одобрения (sign-off) должны быть получены исключительно от людей. Это фундаментальное требование, которое вынуждает автора брать на себя полную юридическую и техническую ответственность за код, даже если физическим автором алгоритма выступила нейросеть».
Такой строгий подход к сертификации направлен на то, чтобы повысить планку качества для всех входящих патчей. В условиях, когда ИИ сделал написание кода доступным для широких масс, именно человеческая ответственность становится главным предохранителем, защищающим ядро Linux от деградации из-за неконтролируемого притока сгенерированного «шума».