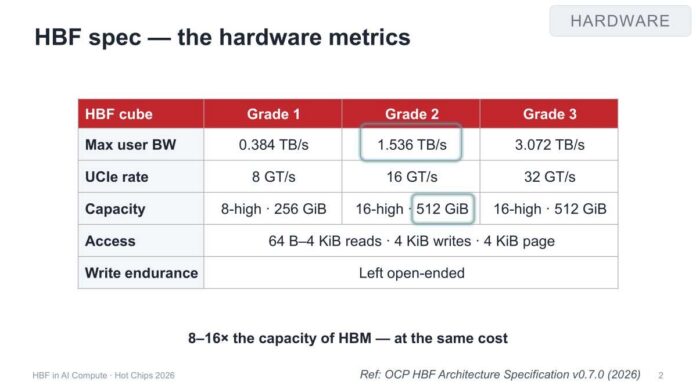
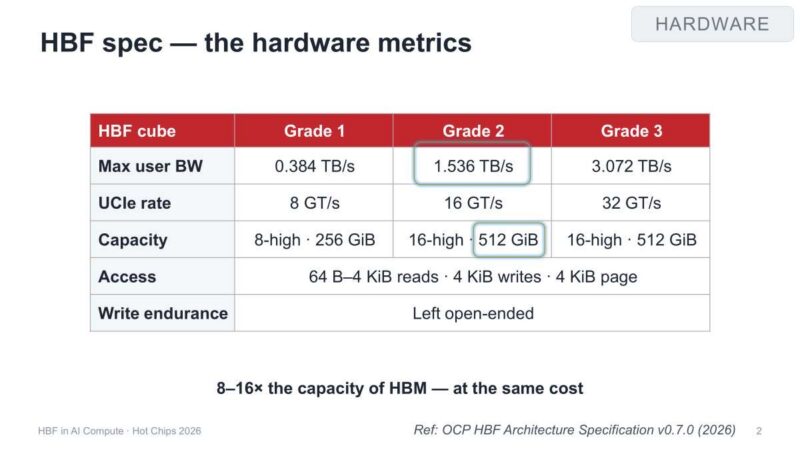
Компания Oxmiq Labs в рамках конференции Hot Chips 2026 представила доклад, посвященный использованию памяти high-bandwidth flash (HBF) в качестве емкостного уровня для инференса искусственного интеллекта. Данная тема вызвала активные обсуждения, поэтому разработчики уделили ей отдельное внимание. В начале выступления Oxmiq представила аппаратные спецификации HBF, разделенные на три категории. Максимальная пользовательская пропускная способность варьируется от 0,384 ТБ/с до 3,072 ТБ/с, скорость интерфейса UCIe составляет от 8 до 32 ГТ/с, а максимальный объем достигает 512 ГиБ на 16-слойную сборку. Главный аргумент создателей заключается в том, что HBF обеспечивает в 8–16 раз большую емкость по сравнению с HBM при аналогичной стоимости.
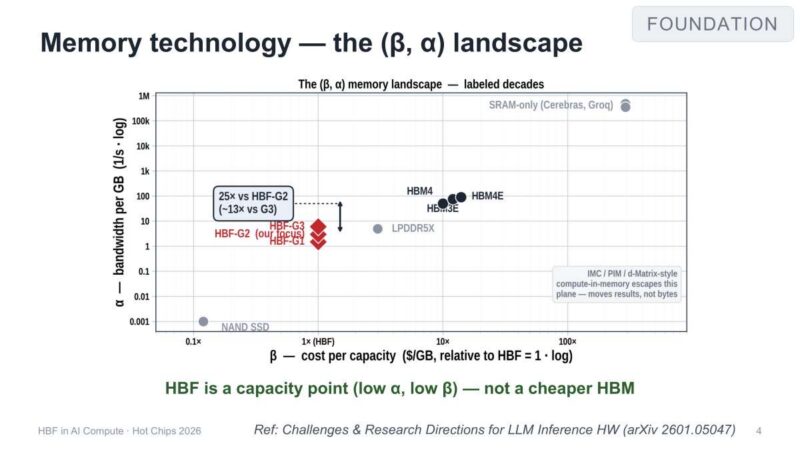
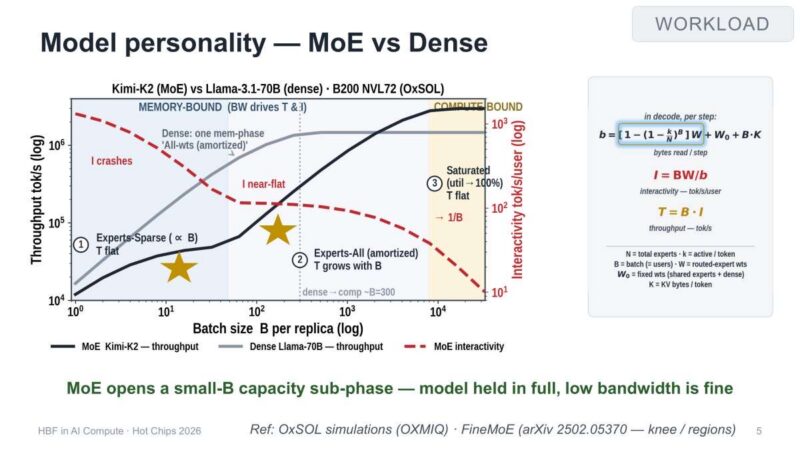
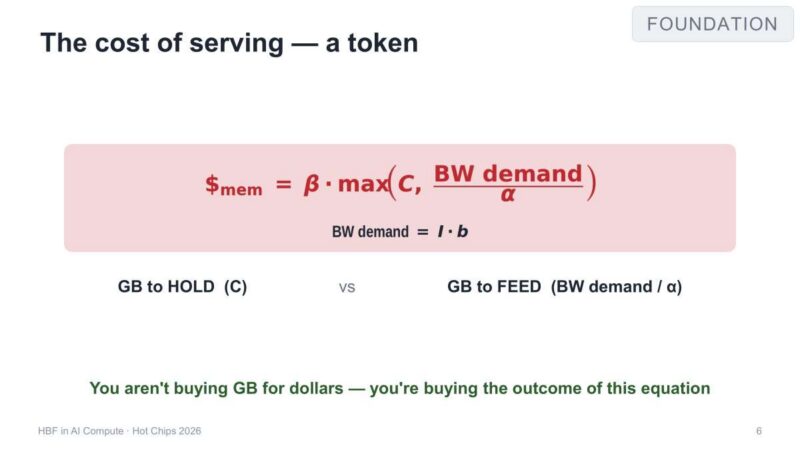
Компания позиционирует HBF на ландшафте памяти с помощью двух параметров: бета-фактора, отражающего стоимость, и альфа-фактора, отвечающего за пропускную способность. Подчеркивается, что HBF представляет собой отдельную точку по емкости, а не более дешевую альтернативу HBM. Далее рассматриваются особенности моделей, где крупные Mixture of Experts (MoE) сопоставляются с плотными моделями по размеру батча и количеству токенов в секунду. В архитектурах MoE появляется подэтап с малой емкостью батча, когда модель удерживается целиком и более низкая пропускная способность оказывается достаточной. Oxmiq анализирует стоимость обслуживания запросов в пересчете на токен, утверждая, что ключевой метрикой становится затрата ресурсов на удержание и подачу данных.
Варианты развертывания и конфигурации памяти
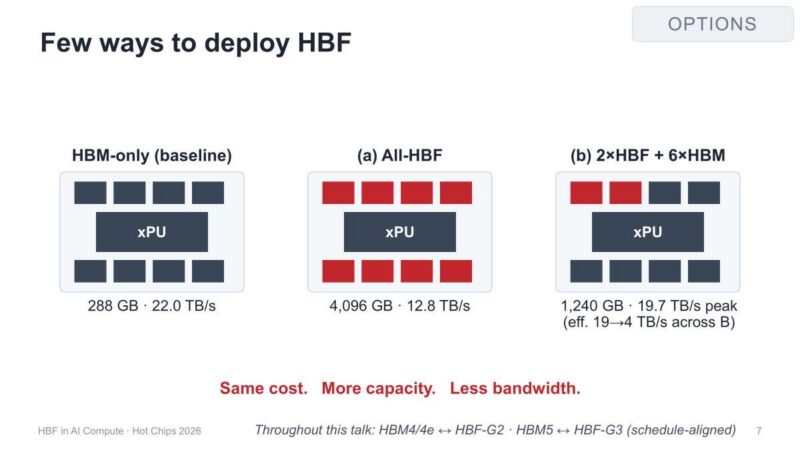
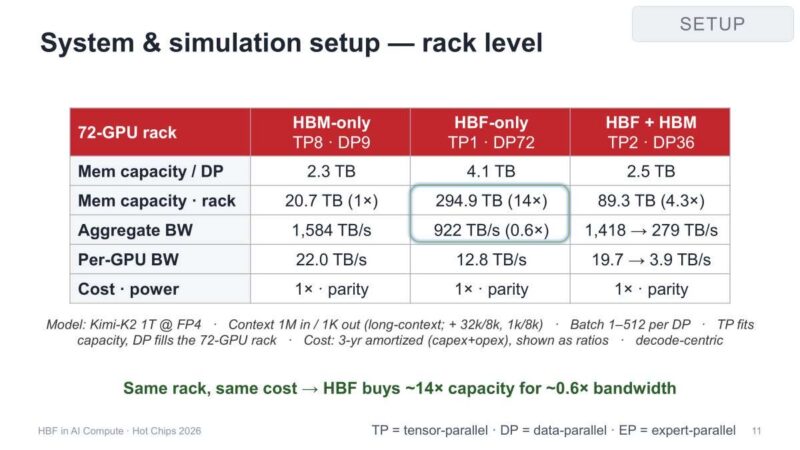
Разработчики предлагают несколько вариантов внедрения HBF, включая базовую конфигурацию только на базе HBM, полностью построенную на HBF систему и гибридную схему из двух модулей HBF и шести модулей HBM. Все три варианта укладываются в один бюджет стоимости, при этом конфигурации с HBF жертвуют пропускной способностью ради увеличения емкости. Пиковая пропускная способность снижается с 22 ТБ/с у базовой HBM-системы до 12,8 ТБ/с в полностью HBF-конфигурации, тогда как емкость возрастает с 288 ГБ до 4 ТБ.
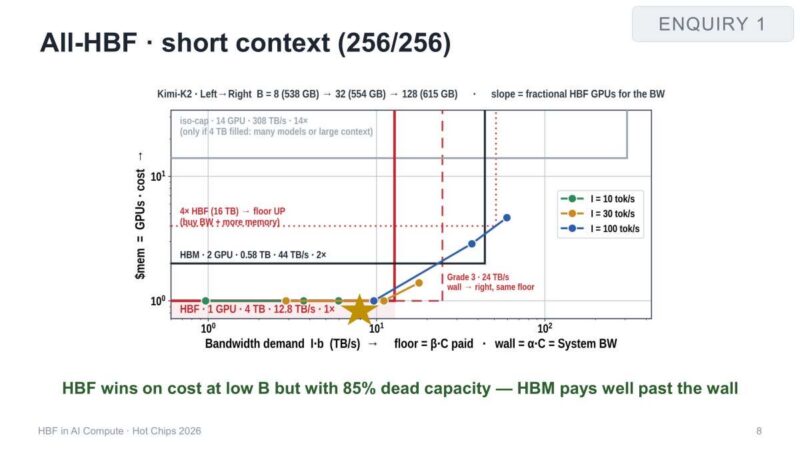
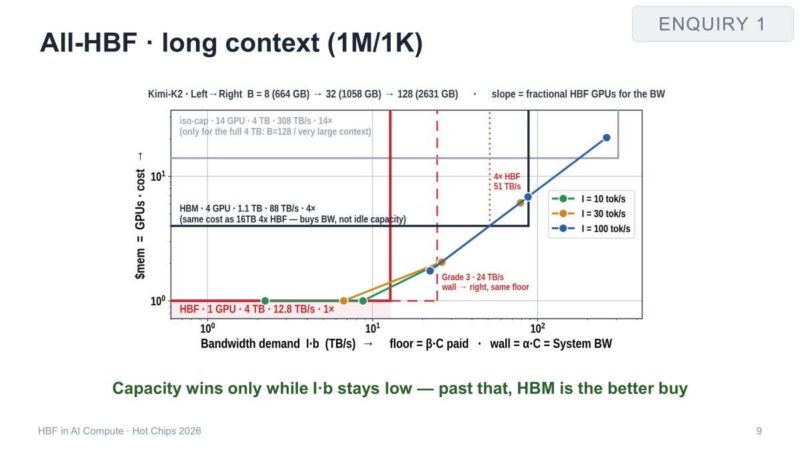
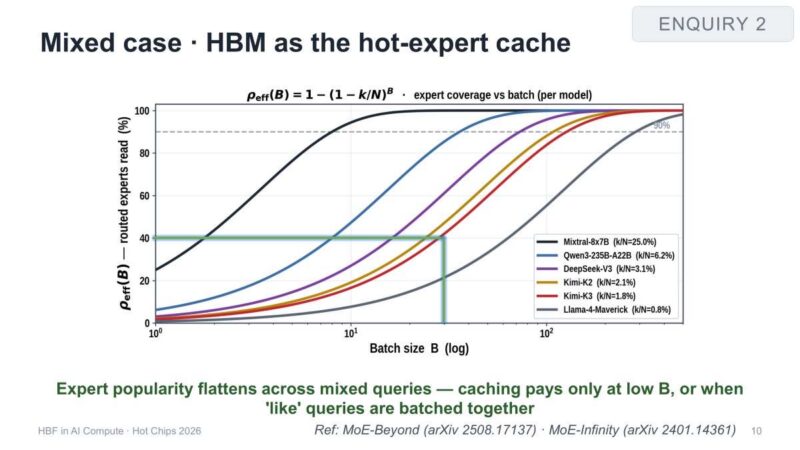
В тестах системы со всеми HBF при коротком контексте 256 на 256 HBF выигрывает по стоимости на малых батчах, но демонстрирует 85 процентов неиспользуемой емкости. При переходе к длинному контексту в 1 миллион входных и 1 тысячу выходных токенов ситуация меняется: преимущество по емкости сохраняется только до тех пор, пока требования к пропускной способности остаются низкими. В смешанном сценарии, где HBM используется в качестве горячего кеша экспертов, кеширование оказывается эффективным лишь при небольших размерах батча или объединении похожих запросов.
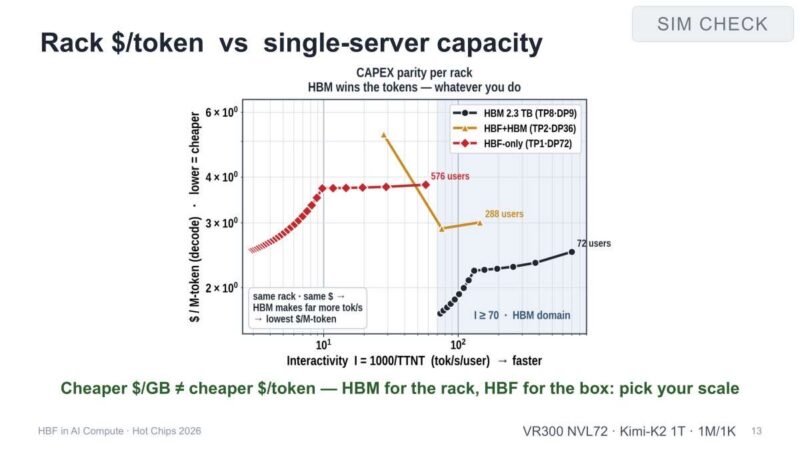
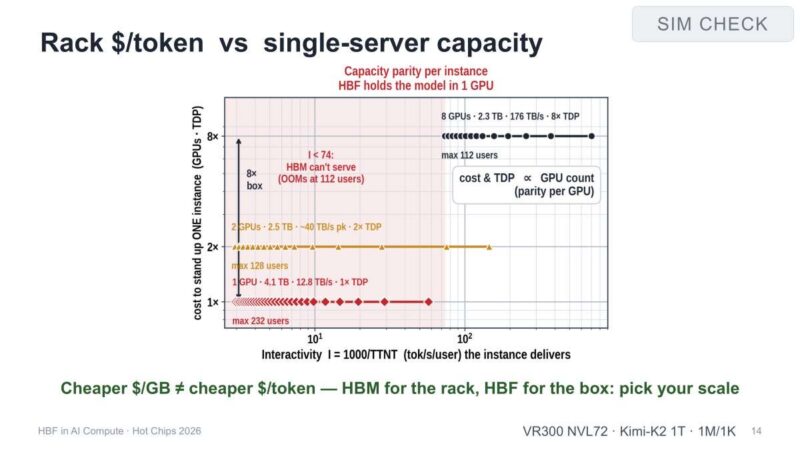
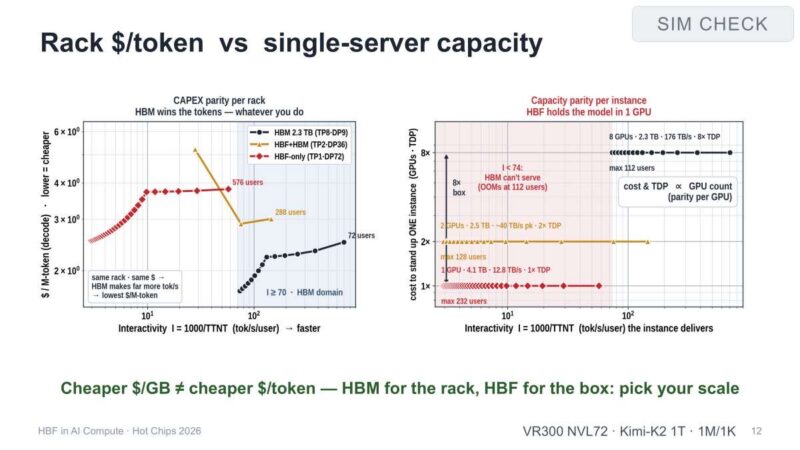
Моделирование на уровне стойки из 72 графических процессоров с использованием декоцентричной модели Kimi-K2 1T в формате FP4 показало, что при той же стоимости HBF обеспечивает примерно в 14 раз большую емкость при 0,6 от пропускной способности HBM. Соотношение затрат на токен и емкости отдельного сервера показывает, что меньшая стоимость гигабайта не всегда означает дешевизну обслуживания одного токена. Для покупателей, выбирающих масштаб развертывания, критически важно сопоставлять тип памяти с характером рабочей нагрузки.
Программные ограничения и интеграция в экосистему
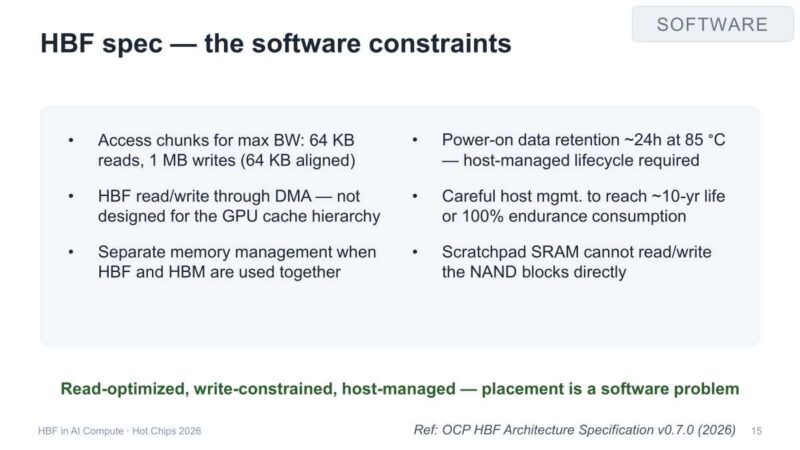
Программная реализация HBF требует доступа блоками по 64 КБ для достижения максимальной пропускной способности. Время хранения данных при температуре 85 градусов Цельсия составляет около 24 часов, а управление жизненным циклом возложено на хост. Поскольку память оптимизирована для чтения и ограничена по записи, размещение данных становится программной задачей.
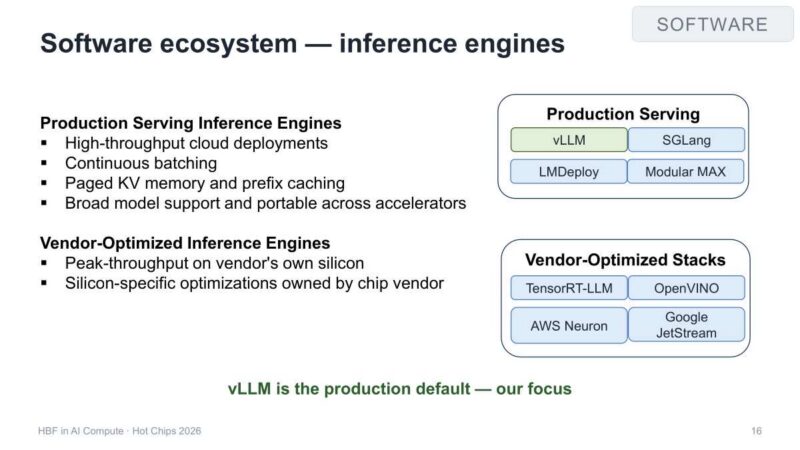
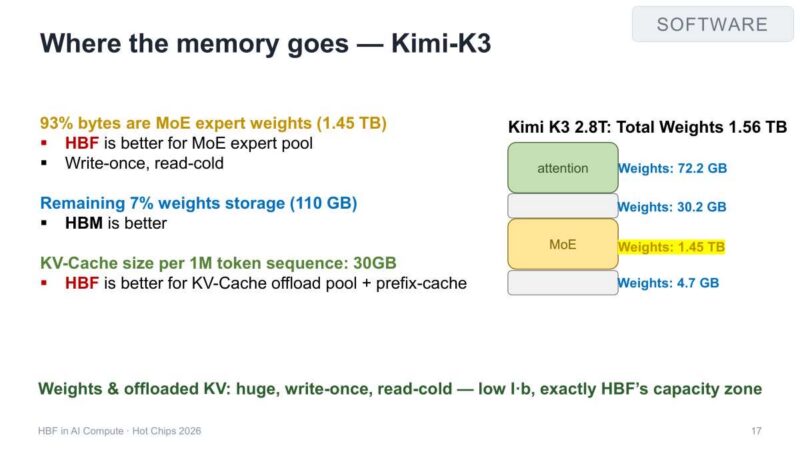
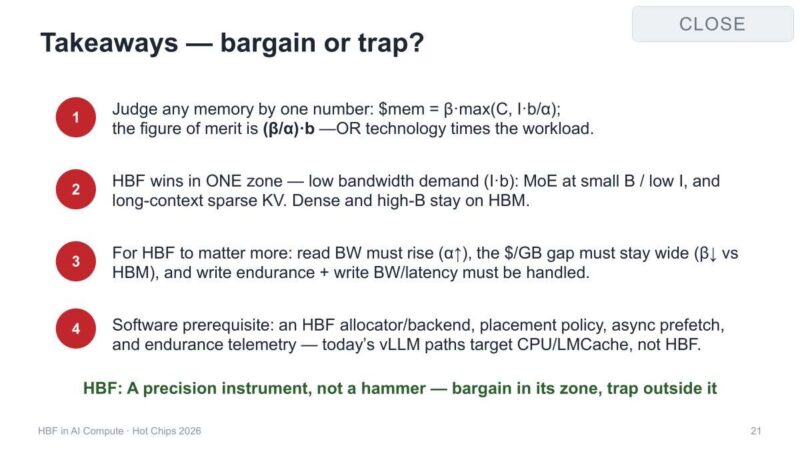
Oxmiq изучает экосистему движков инференса, включая производственные решения vLLM и SGLang, а также оптимизированные стеки TensorRT-LLM и AWS Neuron, выбирая vLLM в качестве базового продукта. Анализ распределения памяти в модели Kimi-K3 показывает, что около 93 процентов байтов приходится на веса экспертов MoE объемом 1,45 ТБ. В связи с этим HBF предлагается использовать для пула экспертов MoE и выгрузки KV-кеша, тогда как HBM обслуживает веса внимания и горячие данные.
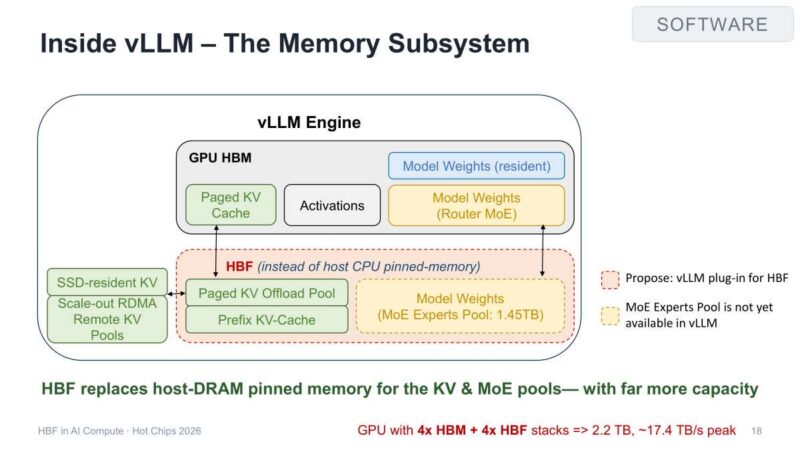
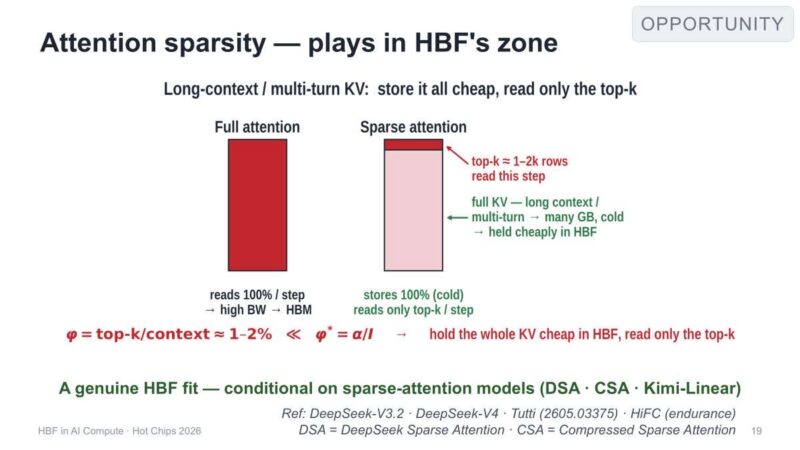
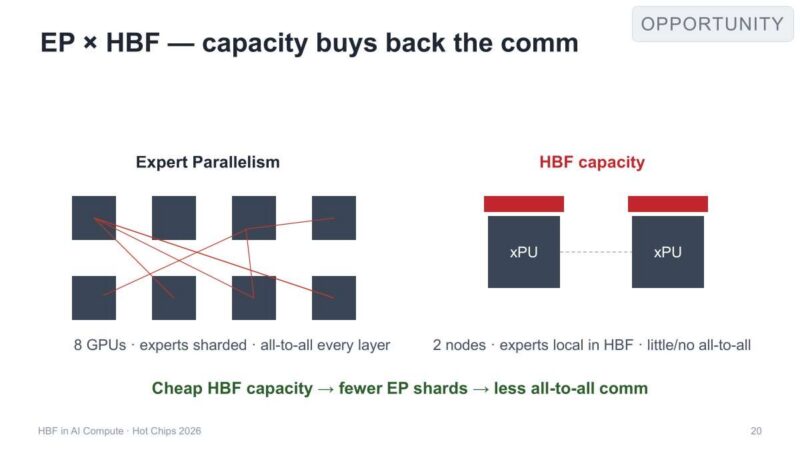
Внутри vLLM предлагается использовать плагин, заменяющий закрепленную память центрального процессора на HBF для KV-кеша и пулов экспертов MoE. Графический ускоритель с четырьмя стеками HBM и четырьмя стеками HBF может достичь емкости 2,2 ТБ при пиковой пропускной способности около 17,4 ТБ/с. Разреженность внимания, такая как в DeepSeek Sparse Attention и Compressed Sparse Attention, также подходит под зону низкой пропускной способности HBF. Использование экспертного параллелизма за счет дешевой емкости HBF сокращает число шардов EP и объем межсетевого трафика, позволяя двум узлам локально удерживать экспертов.
Аппаратные особенности и системное моделирование HBF
Oxmiq Labs отмечает, что память high-bandwidth flash позиционируется именно как отдельная точка емкости в технологическом ландшафте памяти, где бета-параметр отслеживает стоимость, а альфа-параметр отвечает за пропускную способность. Первоисточник подчеркивает, что данное решение не является просто удешевленной версией памяти HBM.
В рамках подробного моделирования на уровне стойки, включающей 72 графических процессора с использованием декоцентричной модели Kimi-K2 1T (формат FP4, контекст 1M токенов на входе и 1K на выходе), специалисты сопоставили долларовую стоимость токена с емкостью отдельного сервера. Полученные данные наглядно демонстрируют, что более дешевая стоимость гигабайта вовсе не гарантирует снижение затрат на обслуживание одного токена. Анализ графиков распределения нагрузки внутри одиночного сервера доказывает, что точное соответствие типа памяти конкретному масштабу развертывания имеет не меньшее значение, чем конечный ценник за гигабайт.
Программная интеграция, экосистема движков и параллелизм
С точки зрения программной реализации и жизненного цикла, память HBF обеспечивает удержание данных в течение примерно 24 часов при температуре 85 градусов Цельсия, а само управление процессами полностью возложено на хост. Поскольку архитектура оптимизирована для чтения и имеет ограничения по записи, распределение данных превращается в сложную программную задачу.
Рассматривая существующую экосистему инференса — от производственных движков vLLM и SGLang до специализированных стеков TensorRT-LLM и AWS Neuron, — разработчики из Oxmiq выбрали именно vLLM в качестве основного стандарта для внедрения. Предлагаемый плагин для vLLM заменяет стандартную закрепленную память хоста (CPU pinned memory) на HBF для обслуживания KV-кеша и пулов экспертов MoE.
Кроме того, недорогая емкость HBF позволяет кардинально оптимизировать экспертный параллелизм (EP). Сокращение числа шардов EP и уменьшение объемов трафика all-to-all дает возможность двум вычислительным узлам локально удерживать экспертов прямо в HBF, избавляя систему от необходимости постоянного шардинга данных между восемью графическими процессорами на каждом отдельном слое.