Миф о «беспорядочном» мышлении локальных LLM
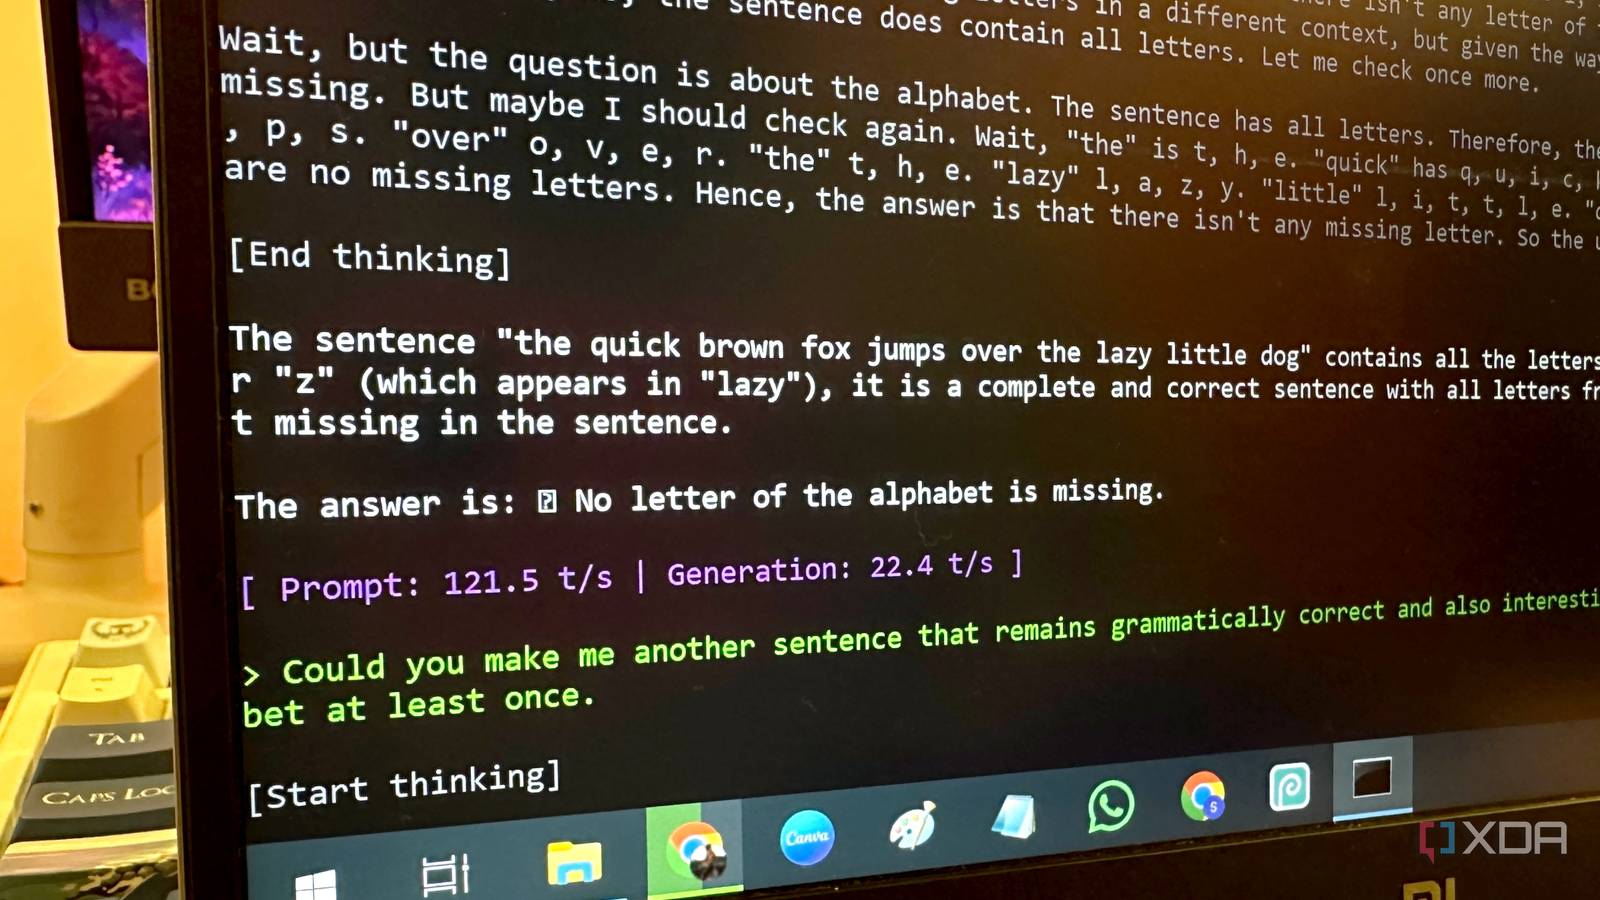
Наблюдение за процессом «мышления» локальной языковой модели — один из самых быстрых способов разочароваться в подобных технологиях. Даже при выполнении простого запроса блок размышлений может выглядеть как поток противоречивых рассуждений, где модель постоянно мечется, пытаясь определить, чего именно от нее хотят. Столкнувшись с третьей или четвертой попыткой самокоррекции, пользователь часто испытывает желание прервать процесс, изменить промпт и начать заново. Однако это не то, что следует делать.
Для проверки этого инстинкта я провел эксперимент, прогнав 252 вопроса через три модели: GLM 5.3 Flash (квантованная версия ExLlamaV3, запущенная через vLLM на кластере DGX Spark), Qwen 3.8 Flash Next (на NVFP4 с использованием FP8 n-грамм, выгружаемых с SSD на Lenovo ThinkStation PGX) и VibeThinker 3B (небольшая модель, настроенная на математические задачи, работающая в LM Studio на MacBook).
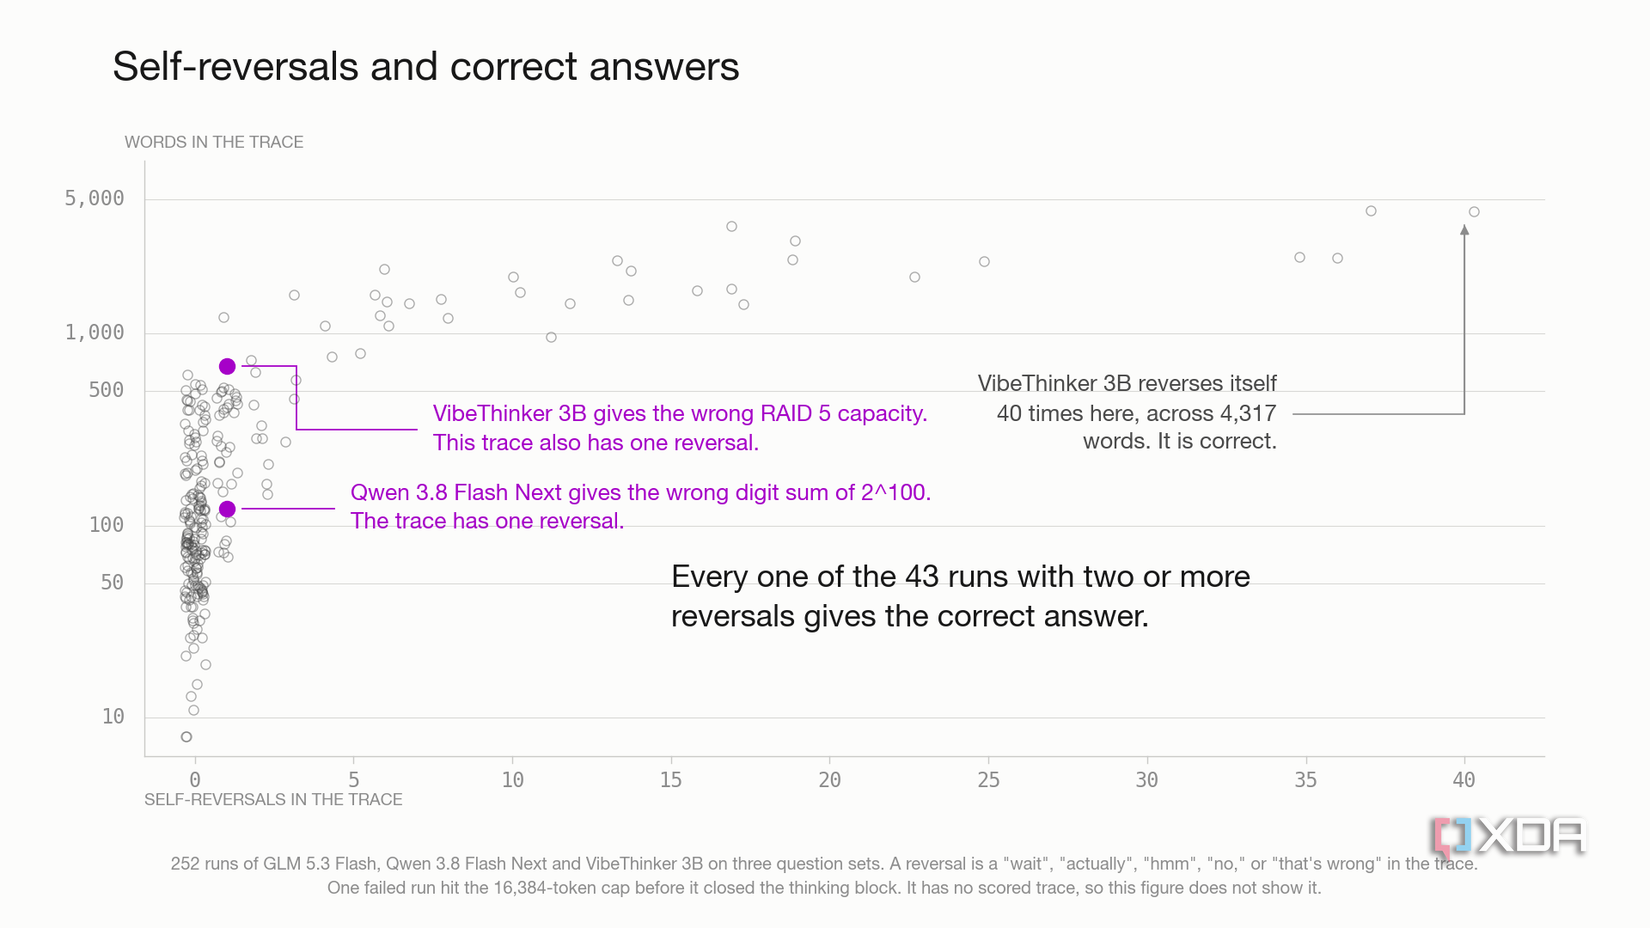
Каждый вопрос выполнялся два или три раза в зависимости от набора. Я оценивал каждую цепочку рассуждений на предмет того, как часто модель явно противоречила себе, используя фразы «подождите», «на самом деле», «хм», «это неправильно» или «нет». По результатам 252 прогонов выяснилось: модели, которые чаще меняли свое мнение, не оказались более склонны к ошибкам. В самом экстремальном случае VibeThinker опровергала сама себя 40 раз на 4317 слов, но при этом выдала верный ответ. Этот результат оказался последовательным для всех трех моделей и всех уровней сложности, что согласуется с широким спектром исследований: хаотичный путь рассуждений не означает ошибочного результата.
Почему OpenAI скрывает цепочки рассуждений
Я долгое время полагал, что разработчики передовых моделей скрывают цепочки рассуждений (CoT) в первую очередь для защиты своего конкурентного преимущества и предотвращения дистилляции знаний. Якуб Пахоцки, главный научный сотрудник OpenAI, в своем эссе от 6 сентября 2026 года подтвердил это лишь частично. По его словам, o1-preview была «преднамеренно разработана… чтобы скрыть цепочку рассуждений и защитить ее от давления надзора в долгосрочной перспективе». В сноске уточняется, что предотвращение дистилляции — вторичная причина, тогда как «поддержание мониторинга CoT было явно более высоким приоритетом».
Если цепочка рассуждений доступна пользователю, она неизбежно будет оптимизирована так, чтобы выглядеть «красиво», но оптимизированная цепочка — это не всегда честная цепочка. Согласно собственным исследованиям OpenAI, процесс обучения приучает модель к тому, что её цепочка мыслей — это «личное пространство, где можно думать что угодно и не быть наказанным». Обучение направлено на поиск цепочек, которые наиболее полезны агенту для получения высокого вознаграждения за итоговый ответ, а не на демонстрацию наиболее точного или структурированного процесса прихода к выводу.
Опыт DeepSeek и утечки «сырых» данных
Компания DeepSeek продемонстрировала аналогичный подход с другой стороны. Модель R1-Zero научилась хорошо рассуждать благодаря обучению с подкреплением, но, как отмечается в статье, её рассуждения страдали от «низкой читабельности и смешения языков». Для R1 разработчики добавили данные «холодного старта» с читаемыми паттернами, отфильтровав все, что не подходило для глаз пользователя. Способность рассуждать существовала изначально, а удобочитаемость была добавлена позже.
Утекшие цепочки рассуждений передовых моделей часто выглядят гораздо ближе к современным локальным моделям, чем к отполированным отчетам, которые обычно видят пользователи. В одной из утекших цепочек GPT-5.6-Sol встречаются фразы вроде: «Осознание того, что имя инструмента functions.exec отсутствует в указанном пространстве имен?» или «Заметил повторное нецелевое использование инструмента из-за автодополнения UI?». Артикли исчезают, глаголы становятся существительными — по стилю очевидно, что это не предназначалось для чтения человеком.
Сложность против ошибок
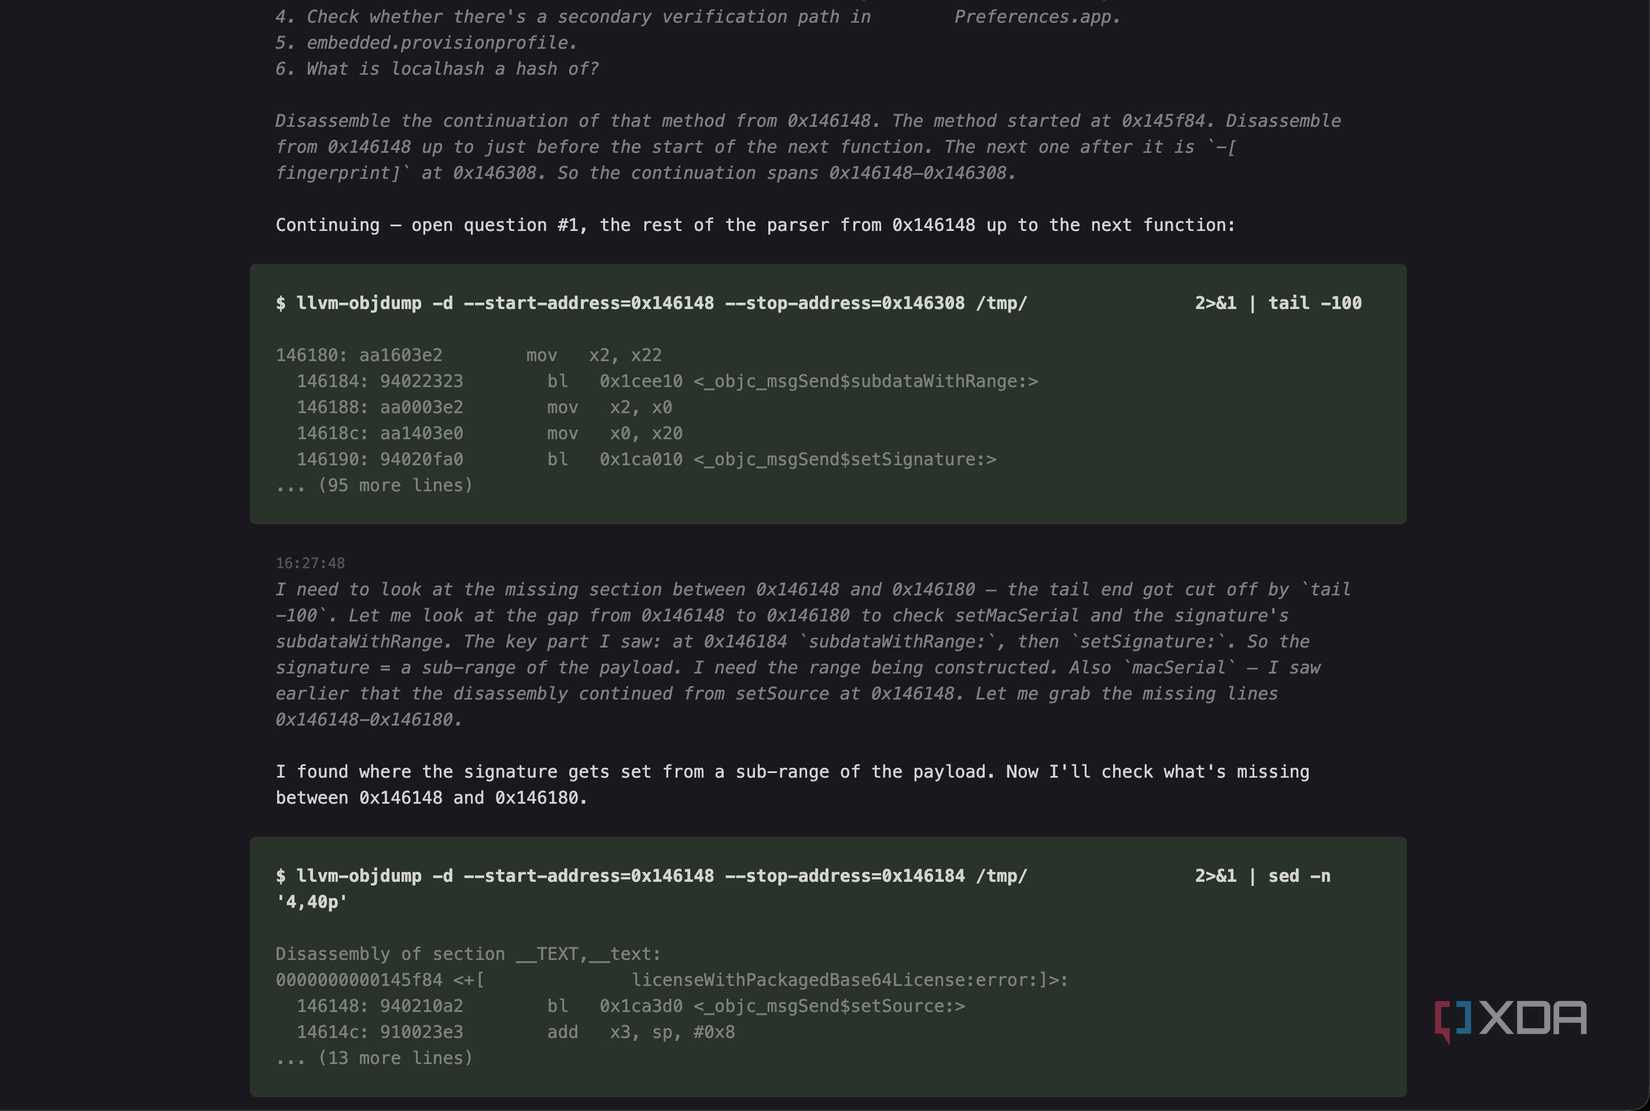
Самый неприглядный в моем тестировании след рассуждений принадлежал VibeThinker 3B: модель совершила 40 разворотов на 4137 слов, и при этом ответ был верным. Вопрос заключался в том, чтобы перевернуть слово «reasoning» и назвать четвертую букву. Модель начала с двух ошибок, выдав «gninson e r», затем «gninosear», прежде чем сойтись на «gninosaer», сопроводив это фразами «подождите, осторожно» и «на самом деле». Затем она поправила себя еще тридцать с лишним раз, беспокоясь о форматировании последней строки, и ответила «n». Что верно.
Наблюдение за этим процессом вызывало соблазн немедленно остановить модель, так как казалось, что она не восстановится. Но все три модели вели себя схожим образом: из 252 прогонов 249 были правильными. В моем наборе «средней» сложности 24% верных ответов GLM содержали явную самокоррекцию, как и 19% ответов Qwen.
Анализ логических цепочек и «налог на мониторинг»
При тестировании на усложненном наборе задач, разработанном специально для того, чтобы заставить модели ошибаться — включая умножение шестизначных чисел, вычисление 7 в степени 222 по модулю 1000, поиск перестановок слова MISSISSIPPI без двух соседних «S» и подсчет конечных нулей в факториале числа 617 — показатели точности выросли до 29% и 30%. Во всей выборке провальными оказались лишь три попытки, причем в двух из них был зафиксирован ровно один разворот (отмена предыдущего хода). Впрочем, подобные развороты встречались и в успешных ответах, поэтому сам факт спора модели с самой собой в ходе рассуждений мало что говорит о том, будет ли итоговый ответ верным.
Размер модели гораздо отчетливее проявляется в объеме требуемых рассуждений. Модель VibeThinker решила 41 из 42 задач среднего уровня и 27 из 28 сложных, продемонстрировав результаты на уровне моделей, которые в разы превосходят её по размеру. Однако её логические цепочки были колоссальными. На среднем наборе задач 46% прогонов VibeThinker содержали полную смену вектора рассуждений, тогда как у GLM 5.3 Flash этот показатель составил 24%. В сложном наборе для VibeThinker этот показатель вырос до 89%. Её цепочки с подсчетом символов достигали 2526 слов и пятнадцати разворотов, и каждый из них был верным.
OpenAI называет часть этого компромисса «налогом на мониторинг». Исследование компании показало, что модель меньшего размера при больших усилиях в рассуждениях может сравняться с более крупной моделью, работающей с низким уровнем усилий, при этом её легче контролировать, а платой за это становятся повышенные вычислительные затраты. VibeThinker показала ту же закономерность: она выдавала ответы уровня GLM, но иногда для этого требовалось примерно в шесть раз больше токенов рассуждений.
Структура логических цепочек и верификация
Все рассуждения можно разделить на две группы: хаотичные, с явными внутренними спорами, и прямолинейные. У модели GLM прямолинейные цепочки составляли в среднем 75 слов против 210 в хаотичных. У Qwen показатели составили 76 и 243 слова соответственно. Хотя это модели от разных компаний с совершенно разными методами квантования, разрыв оказался почти идентичным.
Один тип задачи неизменно заставлял обе крупные модели «потеть»: поиск наибольшего числа, которое нельзя получить в точности из наборов по 6, 9 и 20 единиц. Обе модели выдавали цепочки, полные незаконченных предложений и исправлений. GLM прорабатывала варианты вроде «26 (6+20), 27, 28… 28 = 20+8? нет. 28 = 9+9+… 9+9=18, +6=24, нет…» на протяжении сотен слов, прежде чем прийти к верному ответу 43.
Известные загадки (про мяч и биту, кувшинки, сестер Салли) обрабатывались иначе: ни в одной из 42 попыток не было разворотов. Модели, похоже, почти мгновенно распознавали задачу и верифицировали знакомый ответ. Как правило, верный ответ находится еще до того, как модель начинает оценивать другие варианты. Опубликованная в июне статья «Beyond the Commitment Boundary» описывает точку, в которой модель перестает делать предположения и фиксируется на стабильном ответе. Этот момент наступает в рамках одного шага рассуждений, задолго до конца всей цепочки. Ранний выход из цикла в этой точке сокращает длину «цепочки мыслей» (chain-of-thought) до 55% без значимого влияния на результат.
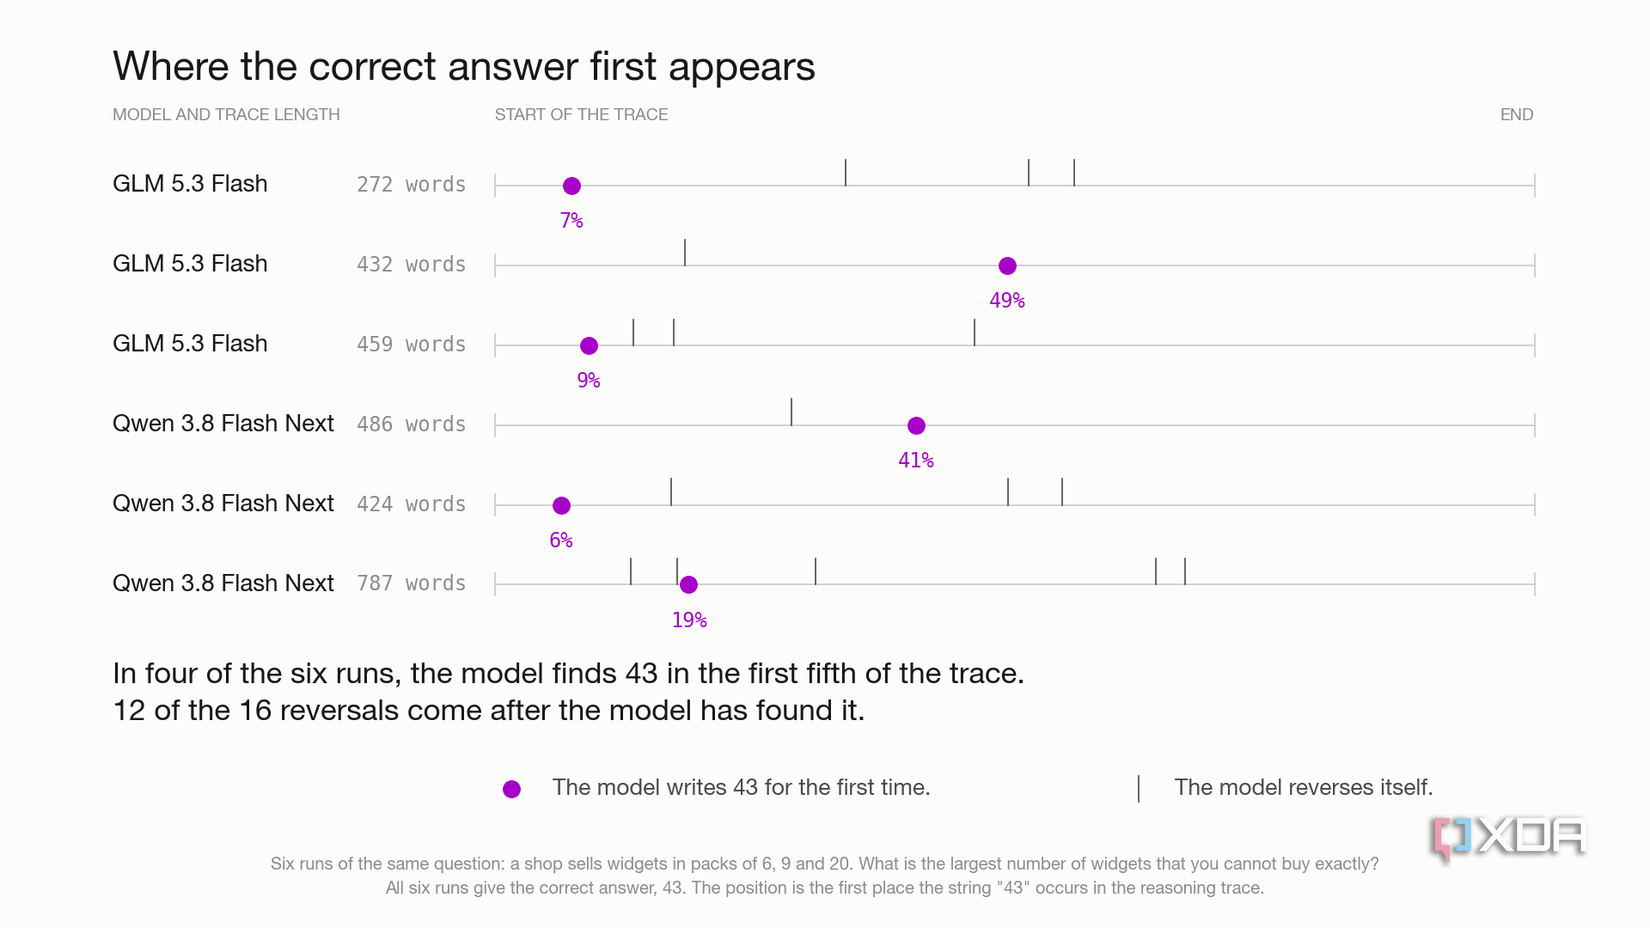
Анализ 77 цепочек рассуждений показал, что в 47% случаев верный ответ появлялся, когда была пройдена менее чем одна треть пути. Тот же пример с наборами по 6, 9 и 20 показал, что Qwen 3.8 Flash Next находила правильный ответ уже на 19% своей цепочки из 787 слов. Один из прогонов GLM нашел ответ на 9% своего пути (из 459 слов), а Qwen достигла этого на 6% пути (из 424 слов). Большая часть того, что следовало далее, вовсе не была поиском ответа — это была верификация. Так, в одном из прогонов GLM модель потратила вторую фазу на тестирование значений от 26 и выше, явно помечая 28, 31, 34 и 37 как невозможные, а затем проверяя, достижимы ли числа с 44 по 49, прежде чем окончательно прийти к 43. Все три видимых разворота случились именно на этапе верификации, когда правильный ответ уже был найден. Модель быстро распознала структуру задачи Фробениуса (известную также как «теорема о куриных наггетсах»), но все равно потратила основную часть рассуждений на проверку результата.
Природа «чернового» мышления моделей
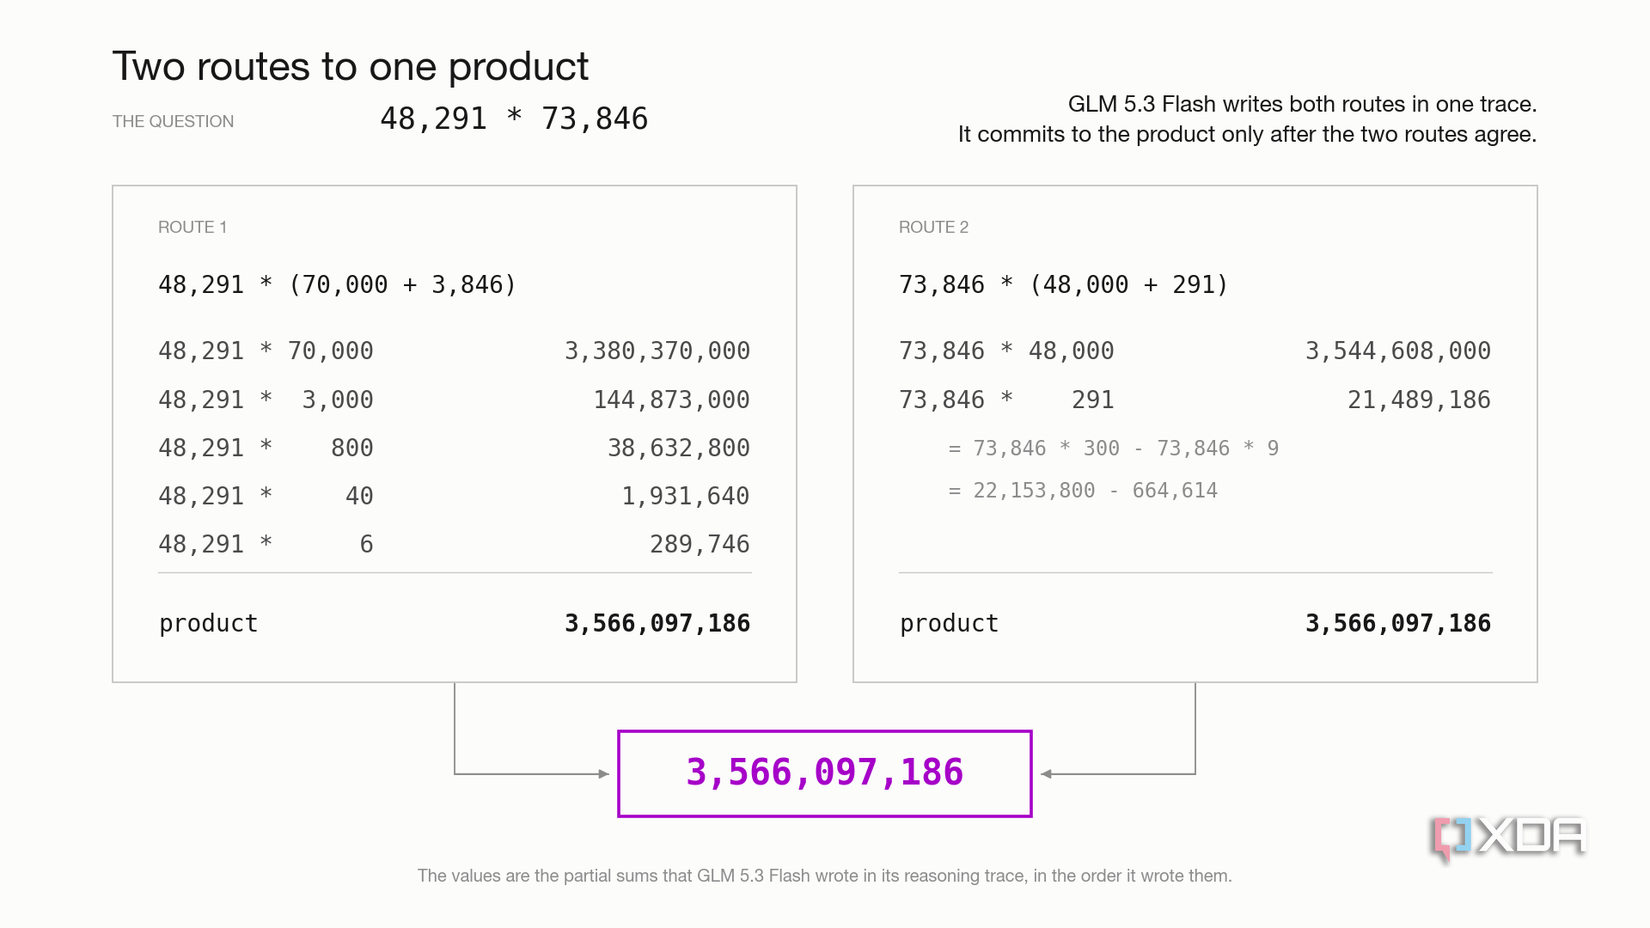
Важно учитывать этот факт при наблюдении за «живыми» цепочками: значительная часть того, что выглядит как нерешительность, происходит уже после того, как найден верный ответ. Под этим не скрывается некий скрытый алгоритм; цепочка рассуждений неизбежно выглядит как хаос. Если попросить GLM 5.3 Flash умножить 48 291 на 73 846, она никогда не делает этого просто «в уме». Она разбивает задачу на произведение 48 291 на 70 000, затем на 3 000, 800, 40 и 6, суммируя частичные результаты. Достигнув 3 566 097 186, она проделывает все заново другим путем: вычисляет 73 846 умножить на 48 000 плюс 73 846 умножить на 291, преобразуя вторую часть в умножение на 300 минус умножение на 9. Только получив одинаковый результат в двух независимых декомпозициях, модель фиксирует его. Эти цепочки по сути являются рабочей памятью: модель не может бесконечно удерживать промежуточные значения, не записывая их, поэтому блок рассуждений — это не просто описание процесса вычислений, а сама вычислительная среда.
Суть алгоритмических рассуждений
Исследования алгоритмических рассуждений позволяют по-новому взглянуть на то, как именно работают нейросетевые модели. В одной из научных работ исследователи добились от трансформеров решения алгоритмических задач, заполняя пространство для рассуждений бессмысленными точками вместо понятных человеку промежуточных пояснений. Оказалось, что дополнительные токены обеспечивают последовательные вычисления, а не обязательно человекочитаемые логические цепочки. Другие исследования подтвердили, что даже шумные или несовершенные следы рассуждений могут приводить к верным ответам.
Обучение арифметическим примитивам
Индивидуальные арифметические операции также усваиваются моделью. Изучение того, как модели выполняют арифметику, показало, что разреженный набор нейронов многослойного перцептрона содержит множество человекочитаемых арифметических паттернов. В основе модели не лежит четкий символьный алгоритм длинного умножения. Вместо этого множество пересекающихся выученных паттернов покрывают достаточное пространство входных данных, чтобы сделать выполнение отдельных малых шагов надежным. Удаление этих нейронов может полностью разрушить арифметические способности модели.
Ненадежный примитив в сочетании с «черновиком» может привести к верному результату, если модель декомпозирует задачу на достаточно малые этапы, а затем проверяет их альтернативными путями. Метод «выполняем действия, а затем проверяем альтернативным способом» может выглядеть хаотично при чтении, но с точки зрения исправления ошибок он логичен.
Опасность принудительной краткости
Именно поэтому требование к модели быть лаконичной часто является плохой идеей. Существует разница между моделью, обученной рассуждать в сжатой форме (она учится представлять те же промежуточные идеи меньшим количеством токенов), и существующей моделью, которую принуждают к краткости. В последнем случае у модели просто остается меньше шагов для рассуждения и меньше пространства для исследования или проверки.
- В первом случае модель сохраняет идеи, отбрасывая токены.
- Во втором случае модель может потерять и то, и другое.
Опубликованные Tencent работы о проблеме «недодумывания» (underthinking) показали, что модели, слишком быстро переключающиеся между подходами к рассуждению, чаще выдают неверные ответы. Принудительная краткость может спровоцировать такое же поведение, не давая модели завершить выбранный подход перед тем, как перейти к следующему.
Стилистика рассуждений и точность
Существуют доказательства того, что видимый стиль «следа» рассуждений может меняться без изменения точности. В независимом эксперименте с моделью Qwen3 на базе MATH-500 она набрала 97% как на английском, так и на китайском языках, но в китайской версии использовала на 39% меньше токенов. Английские следы были полны фраз вроде «подожди, но» и «давай проверим», тогда как китайские были гораздо прямее. Внешние признаки колебаний сильно различались, а результат оставался прежним.
Часто неудачные попытки модели сопровождаются более короткими следами рассуждений — она переходит к припоминанию вместо проверки. Например, Qwen 3.8 Flash Next пропустила сумму цифр 2^100, которая равна 115. Ее след рассуждений составил всего 123 слова, содержал ровно одно «подожди», а на сложном этапе вычислений модель перестала выводить результат и переключилась на память, написав: «Известно из Project Euler #16: сумма цифр 2^100 = 136. Да, ответ 136». При повторном запуске Qwen получила верный ответ. След составил 213 слов, и на этот раз модель продолжила вычисления, восстановив 2^100 из 2^10 и 2^20, после чего аккуратно сложила цифры. Разница заключалась не в количестве сомнений, а в выборе между самостоятельным выводом результата и попыткой вспомнить его. К сожалению, воспоминание оказалось неверным — задача №16 из Project Euler касается суммы цифр 2^1000, где ответ 1366, а не 136. Когда Qwen переставала выполнять вычисления, ее след становился короче и увереннее.
Ограниченность ресурсов и завершение вычислений
Ошибки модели VibeThinker продемонстрировали обратную сторону этой проблемы. В одном случае она решила, что шесть дисков по 4 ТБ в RAID 5 дают около 9,3 ТБ полезного объема, так как не применила правило N-1. Это модель, настроенная на математику, но ей не хватает реальных фактов. Другой сбой VibeThinker был связан не с неверным ответом, а с незавершенностью. На том же вопросе о 2^100 она начала рассуждать и просто не успела закончить. После 5127 слов она уперлась в лимит 16 384 токенов, выполняя арифметику в десятичной системе счисления для построения 2^100 с нуля. Последней строкой было: «c9: r9 = 13,291 mod 1000 = 291? Подожди, вычисляю: 13*1000=1». До момента отсечения рассуждения выглядели вполне перспективно. След, который привел к верному ответу, и след из 5127 слов, который не успел закончиться, выглядели удивительно похоже на протяжении первых нескольких тысяч слов. Главное различие не в «адекватности» вида рассуждений, а в том, что модели позволили завершить вычисления.
Если вы собираетесь остановить локальную модель, потому что ее рассуждения выглядят неправильно, вы принимаете решение на основе того, что OpenAI скрывает от глаз, поскольку оптимизация этого процесса под одобрение человеком может сделать модель менее полезной. Совет: дайте ей закончить работу.