Недавние обновления ROCm позволили AMD внедрить официальную поддержку PyTorch и HIP SDK в Windows для потребительских видеокарт серий Radeon RX 7000 и RX 9000. Несмотря на развитие нативной поддержки, запуск проприетарного программного обеспечения, старых репозиториев или специализированных ИИ-инструментов, жестко привязанных к архитектуре NVIDIA CUDA, остается сложной задачей. Решением может стать новый проект независимого разработчика под названием CUDA-for-AMD-Windows, доказывающий возможность работы таких нагрузок в ОС Windows без необходимости прибегать к виртуализации или двойной загрузке.
Принцип работы и возможности инструмента
Проект представляет собой набор автоматизированных скриптов PowerShell, выступающих в роли связующего звена между трансляционным слоем ZLUDA и официальным SDK AMD HIP/ROCm для Windows. Инструмент автоматически определяет архитектуру GPU пользователя, загружает конкретную версию ZLUDA (v6-preview.69) и сопоставляет её с математическими библиотеками ROCm, установленными в системе.
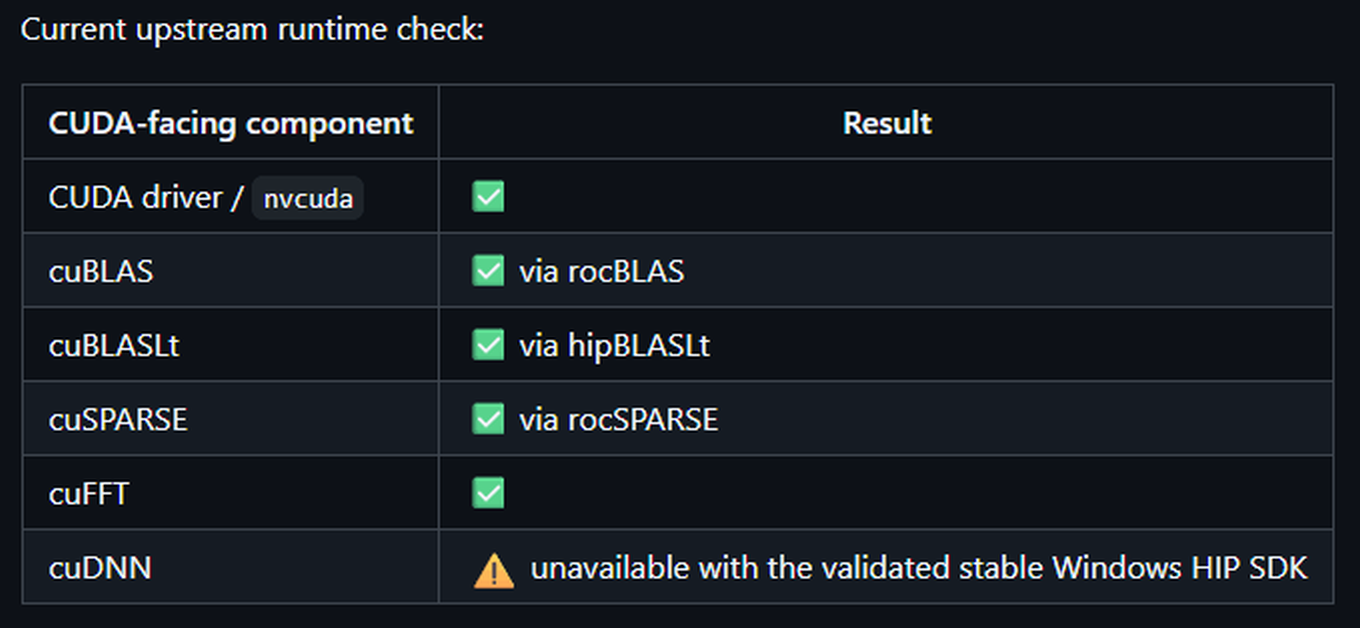
В ходе разработки автору удалось перехватить и транслировать API драйверов CUDA, а также библиотеки cuBLAS, cuSPARSE и cuFFT в их аналоги для оборудования AMD. В качестве подтверждения концепции была проведена тренировка нейронной сети PPO с 2,2 миллионами параметров на видеокарте AMD Radeon RX 9060 XT, которая на данный момент является единственной официально поддерживаемой моделью в рамках данного решения.
Результаты тестирования и производительность
Автор проекта провел сравнительные испытания в среде обучения с подкреплением на базе 2,2-миллионной модели. При использовании официальных релизов ZLUDA и стандартного HIP SDK 6.4 средняя пропускная способность составила 13 278 шагов в секунду (SPS). Альтернативный вариант с использованием восстановленных библиотек legacy ZLUDA показал результат 12 876 SPS, что примерно на 3% медленнее. Эти данные свидетельствуют о наличии определенных потерь производительности при использовании стека трансляторов, однако сама возможность запуска CUDA-кода без модификации исходных библиотек является значимым техническим достижением.
Ограничения и перспективы развития
Несмотря на успех проекта, необходимо учитывать его текущие ограничения. Это любительская open-source разработка, а не коммерческий продукт корпоративного уровня. Автор подчеркивает, что такие критически важные библиотеки для машинного обучения, как cuDNN, TensorRT и NCCL, на текущий момент не поддерживаются. Если конкретный ИИ-инструмент критически зависит от cuDNN, запуск через данный инструментарий завершится неудачей.
Кроме того, судьба самого ZLUDA, который сейчас развивается как «хобби-проект выходного дня» после потери коммерческого финансирования, накладывает определенные риски на стабильность решения в долгосрочной перспективе. Тем не менее, CUDA-for-AMD-Windows наглядно демонстрирует, что ограничение на запуск CUDA-эксклюзивного ПО на видеокартах AMD является не аппаратной несовместимостью, а задачей по созданию подходящих инструментов трансляции. Благодаря открытому исходному коду проект имеет потенциал для расширения поддержки оборудования и доработки механизмов взаимодействия с библиотеками CUDA силами сообщества.
Технические подробности реализации и «ад зависимостей»
Основная проблема, которую призван решить данный инструментарий, заключается в борьбе с так называемым «адом зависимостей» (dependency hell). Разработчики, активно экспериментирующие с GitHub-репозиториями или специализированными ИИ-проектами, часто сталкиваются с тем, что код жестко прописан под NVIDIA CUDA. До появления подобных решений альтернативой было использование WSL2 с его сложностями при пробросе оборудования или ожидание, пока авторы ПО самостоятельно напишут порт на HIP.
Проект Speedstu фактически выступает в роли «хакерского адаптера» для программного обеспечения, которое упорно отказывается распознавать что-либо, кроме видеокарт NVIDIA. Использование этого стека трансляторов позволяет избежать необходимости полной переработки проекта, предоставляя среду, где CUDA-вызовы прозрачно подменяются нативные вызовы библиотек AMD.
Нюансы производительности и архитектурные выводы
В документации к проекту представлены результаты замеров, проливающие свет на эффективность такой трансляции. Стоит отметить интересное наблюдение автора: при дальнейшем рефакторинге, в ходе которого удалось удалить LibTorch/ZLUDA из процесса обучения PPO, итоговая пропускная способность значительно возросла. Этот факт указывает на то, что текущий «слоеный пирог» из трансляторов вносит существенные накладные расходы, которые, однако, поддаются оптимизации при упрощении программного стека.
Будущее проекта: почему это важно
Важно сохранять реалистичные ожидания относительно «CUDA-for-AMD-Windows». В отличие от корпоративных решений, здесь нет долгосрочных гарантий поддержки или масштабируемости. Сам ZLUDA пережил две волны потери коммерческого финансирования и на текущем этапе поддерживается энтузиастом как «хобби-проект выходного дня». Это делает использование связки в рабочих процессах (production-level) неоправданным риском, превращая проект в инструмент исключительно для «мейкеров» и энтузиастов-исследователей.
Тем не менее, ценность проекта заключается в доказательстве того, что барьер между «железом» AMD и экосистемой CUDA не является непреодолимым аппаратным изъяном. Поскольку проект полностью открыт, он обладает значительным потенциалом для развития силами сообщества. Ожидается, что при должной поддержке разработчиков-добровольцев можно реализовать более совершенные механизмы аппаратного детектирования и патчи, которые позволят «заставить» работать даже те компоненты CUDA, которые на текущий момент остаются неразрешимыми для транслятора.
На сегодняшний день работа проекта — это не стратегия корпоративного развертывания IT-инфраструктуры, а способ обойти текущие программные ограничения, расширяя границы использования потребительских видеокарт Radeon в задачах, где ранее доминирование NVIDIA считалось абсолютным.