Обновление MLPerf Inference v6.1 и новые тесты
Организация MLCommons опубликовала пакет тестов MLPerf Inference v6.1, который установил рекорд по количеству участников: свои заявки подали 30 организаций, предоставивших в общей сложности 486 результатов для датацентров и периферийных устройств.
В набор тестов вошли два новых сценария: комплексный конвейер End-to-End RAG для датацентров и бенчмарк Edge Agentic Inference для устройств с одним пользователем. Кроме того, в результатах впервые представлены прошедшие экспертную оценку показатели для NVIDIA Vera Rubin NVL72, AMD Instinct MI350P, Intel Arc Pro B70 и AMD Ryzen AI Max+ 395.
Что касается темпов роста производительности, по данным MLCommons, лучший результат для акселератора в задаче DeepSeek-R1 в серверном сценарии оказался в 5,7 раза выше, чем в версии v5.1 год назад, а лучший результат для моделей VLM увеличился в 2,99 раза всего за шесть месяцев, прошедших с момента выхода v6.0.
Два новых теста: End-to-End RAG и Edge Agentic Inference
Бенчмарк End-to-End RAG измеряет производительность полного конвейера ответов на вопросы, в котором совместно работают несколько моделей и векторная база данных.
Эталонная реализация задействует четыре модели одновременно: gpt-oss-120B отвечает за декомпозицию запросов, проверку достаточности и генерацию ответов; gpt-oss-20B оценивает извлеченные документы; e5-base-v2 создает эмбеддинги; а ColBERTv2 выполняет ранжирование фрагментов текста (ререйтинг).
Корпус данных состоит из 107 484 фрагментов текста, полученных путем разбиения 2,515 HTML-файлов. Вопросы представляют собой 824 многошаговые задачи из набора данных FRAMES от Google, причем каждая задача может проходить до 5 раундов извлечения данных, пока конвейер не решит, что у него достаточно доказательств.
В ходе тестирования фиксируются две метрики: количество документов в секунду при построении векторной базы данных FAISS HNSW и количество задач в секунду при ответе на вопросы с ее использованием.
Судья на базе модели Llama 3.1-8B оценивает итоговые ответы на соответствие целевому уровню точности в 97%, причем время работы самого судьи не учитывается при замере.
Бенчмарк Edge Agentic Inference ориентирован на сценарий использования ИИ в качестве помощника по программированию на рабочих станциях и настольных ПК.
В качестве эталона используется модель Qwen3.6-27B с отключенным режимом размышлений (thinking), которая запускается в формате Q4_K_M GGUF через движок llama.cpp с контекстным окном в 32K на каждый диалоговый шаг.
Рабочая нагрузка представляет собой записанное воспроизведение 20 агентских траекторий программирования из набора SWE-bench Verified, общей сложностью 1 007 шагов. Тест запускается в виде единого потока с одним активным запросом — точно так же, как разработчик запускает ИИ-агент на ноутбуке.
Отчетная метрика представляет собой среднюю задержку на один шаг (turn) в сочетании с распределениями времени до получения первого токена (time-to-first-token) и времени на генерацию одного выходного токена. Точность отдельно контролируется фреймворком BFCL v4 на уровне 97% от эталонного показателя.
MLCommons адаптировала этот фреймворк из своего готовящегося датацентрового бенчмарка MLPerf Agentic. «Мы добавили тест End-to-end RAG, потому что очевидно: ответы на запросы эволюционировали и вышли за рамки простой LLM, обученной на определенном массиве данных. Заинтересованным сторонам необходимо понимать реальную производительность многоэтапных и многокомпонентных конвейеров, которые строятся сегодня», — заявил Миро Ходак (Miro Hodak), сопредседатель рабочей группы MLPerf Inference. «Аналогичным образом мы добавили тест Edge Agentic Inference, поскольку сложные системы инференса с агентскими свойствами все чаще развертываются на периферийных вычислительных устройствах, создавая новый круг задач и проблем для наших клиентов сегодня».
В новом раунде также расширена поддержка спекулятивного декодирования (раньше она была ограничена только DeepSeek-R1) на бенчмарк GPT-OSS в интерактивном сценарии, а для VLM-теста определен новый интерактивный сценарий, в котором время ответа должно составлять около 1,5 секунды.
Новые кремниевые решения: от настольных ПК до стоек в датацентрах
Ускоритель NVIDIA Vera Rubin NVL72 дебютирует в MLPerf в категории предварительных версий (preview), заявки на тестирование были поданы компаниями NVIDIA и Nebius для системы VR200 NVL72.
NVIDIA заявляет о повышении пропускной способности токенов до 2,5 раза по сравнению с системой GB300 NVL72 на задаче DeepSeek-R1 в офлайн-, серверном и интерактивном сценариях при использовании TensorRT-LLM, а также до 3,7 раза на мультиязычной визуальной модели Qwen3 при использовании vLLM с NVIDIA Dynamo.
Эти данные основаны на сравнении NVIDIA с собственным предыдущим поколением, а статус preview означает, что платформа должна поступить в коммерческую продажу к следующему раунду тестирования.
Компания AMD расширила свои заявки в MLPerf Inference 6.1 до шести семейств моделей, охватывающих задачи обработки естественного языка, логического рассуждения, генерации текста в видео и рекомендательных систем. Были задействованы ускорители Instinct MI355X, MI350X и новая PCIe-карта MI350P.
Кластер Crusoe на 512 графических процессорах, построенный на базе MI355X, рассматривается далее вместе с собственным анализом этого раунда от компании AMD.
Ускоритель Intel Arc Pro B70 появляется в составе узла с четырьмя графическими процессорами и 128 ГБ суммарной видеопамяти. Intel использовала эту конфигурацию для запуска Llama 3.1-8B, Llama 2-70B, gpt-oss-120B, Whisper и нового теста E2E-RAG. По данным Intel, производительность gpt-oss-120B выросла на 36% в серверном и на 27% в офлайн-режиме по сравнению с версией v6.0 на том же «железе».
Что касается процессорного направления (CPU), Intel сообщает, что пропускная способность сервера на базе Xeon 6980P для модели Llama 3.1-8B выросла в 2,4 раза по сравнению с v6.0 на идентичном кремнии исключительно за счет программных оптимизаций.
Процессор Ryzen AI Max+ 395 представлен компанией Atlas Inference — новым участником тестирования, который запустил новую периферийную агентскую рабочую нагрузку (Edge Agentic) как на NVIDIA DGX Spark, так и на настольной системе AMD Strix Halo, используя при этом одинаковые движки и методы квантования.
Atlas сообщает о показателе 20,1 токена в секунду на системе DGX Spark (все 1 007 шагов были выполнены менее чем за 64 минуты) и 19,63 токена в секунду на платформе Strix Halo.
Масштабирование кластеров и новые аппаратные решения в MLPerf
Разрыв в производительности между двумя платформами с готовыми средами выполнения оказался меньше, чем был зафиксирован в обзорах Ryzen AI Halo и DGX Spark. Именно для выявления подобных результатов и создан новый бенчмарк.
В этом раунде зафиксирован рекорд по количеству крупномасштабных, более разнообразных и распределенных многоузловых заявок (в версии v4.0 таковые отсутствовали вовсе), среди которых выделяются три ключевые работы.
Компания Crusoe, впервые участвующая в тестировании, совместно с AMD развернула крупнейшую систему в истории MLPerf Inference. Конфигурация включила 512 графических процессоров Instinct MI355X, объединенных в 64 узла на базе стандартной сетевой фабрики RoCE Ethernet, с подачей заявок для моделей gpt-oss-120b и DeepSeek-R1.
По данным AMD, этот кластер продемонстрировал пропускную способность 5,75 миллиона токенов в секунду в офлайн-сценарии и 5,39 миллиона в серверном сценарии для gpt-oss-120b. Для DeepSeek-R1 показатели составили 2,90 миллиона в офлайн-режиме и 2,41 миллиона в серверном. В AMD называют это значение рекордной совокупной пропускной способностью токенов в истории MLPerf, причем масштабирование производительности происходило практически линейно при переходе от 1 до 64 узлов.
Запуск модели gpt-oss-120b осуществлялся как 512 независимых однопроцессорных реплик в нативном формате MXFP4. Для DeepSeek-R1 применялся фреймворк SGLang с одной восьмичиповой репликой на узел.
Дополнительно AMD сообщает о результатах тестирования конфигурации из 72 графических процессоров GPT-OSS-120B с эффективностью масштабирования 95% и скоростью 1 миллион токенов в секунду — ровно с такими же ключевыми показателями, которые были достигнуты на базе чипов MI355X еще в версии v6.0.
Компания Cisco представила первую в рамках бенчмарка гетерогенную систему от разных производителей, объединив восемь ускорителей NVIDIA H200 и восемь AMD Instinct MI350X в единый пул инференса через сетевую фабрику Cisco Silicon One G200. Это тот же подход с использованием смешанных ускорителей, который вендор коммерчески реализует в рамках решения Secure AI Factory.
Географически распределенная заявка была подготовлена компаниями MangoBoost и Dell. Тестирование охватило четыре площадки на двух континентах при хостинге от MangoBoost, Dell, TensorWave и Microsoft Azure. Система протянулась через Тихий океан и функционировала как единая конечная точка, продемонстрировав, по данным MangoBoost, эффективность масштабирования на уровне 97%.
Кроме того, MangoBoost заявляет о первом получении результатов с разделением этапов префилла и генерации (prefill/decode-disaggregated) на графических процессорах AMD Instinct.
Среди прочих результатов компания CoreWeave зафиксировала совокупную производительность на уровне 1,16 миллиона токенов в секунду на системе GB300 NVL72, где офлайн-пропускная способность в расчете на один GPU выросла на 17% по сравнению с версией v6.0. Компания HPE сообщает о показателе 8500 токенов в секунду на один GPU для модели DeepSeek-R1 на двух серверах Compute XD690 с чипами Blackwell Ultra. Корпорация Google сосредоточила свою заявку на модели DeepSeek-R1, отметив общеотраслевой переход на крупные модели со смешанной экспертной структурой (Mixture-of-Experts). При этом модель gpt-oss-120b собрала 112 заявок — больше, чем любая другая рабочая нагрузка в MLPerf.
Два форм-фактора ускорителей CDNA 4: OAM и PCIe со слотом двойной ширины
Архитектура CDNA 4 от AMD выпускается в двух физических форм-факторах для удовлетворения жестких требований центров обработки данных к энергопотреблению и охлаждению.
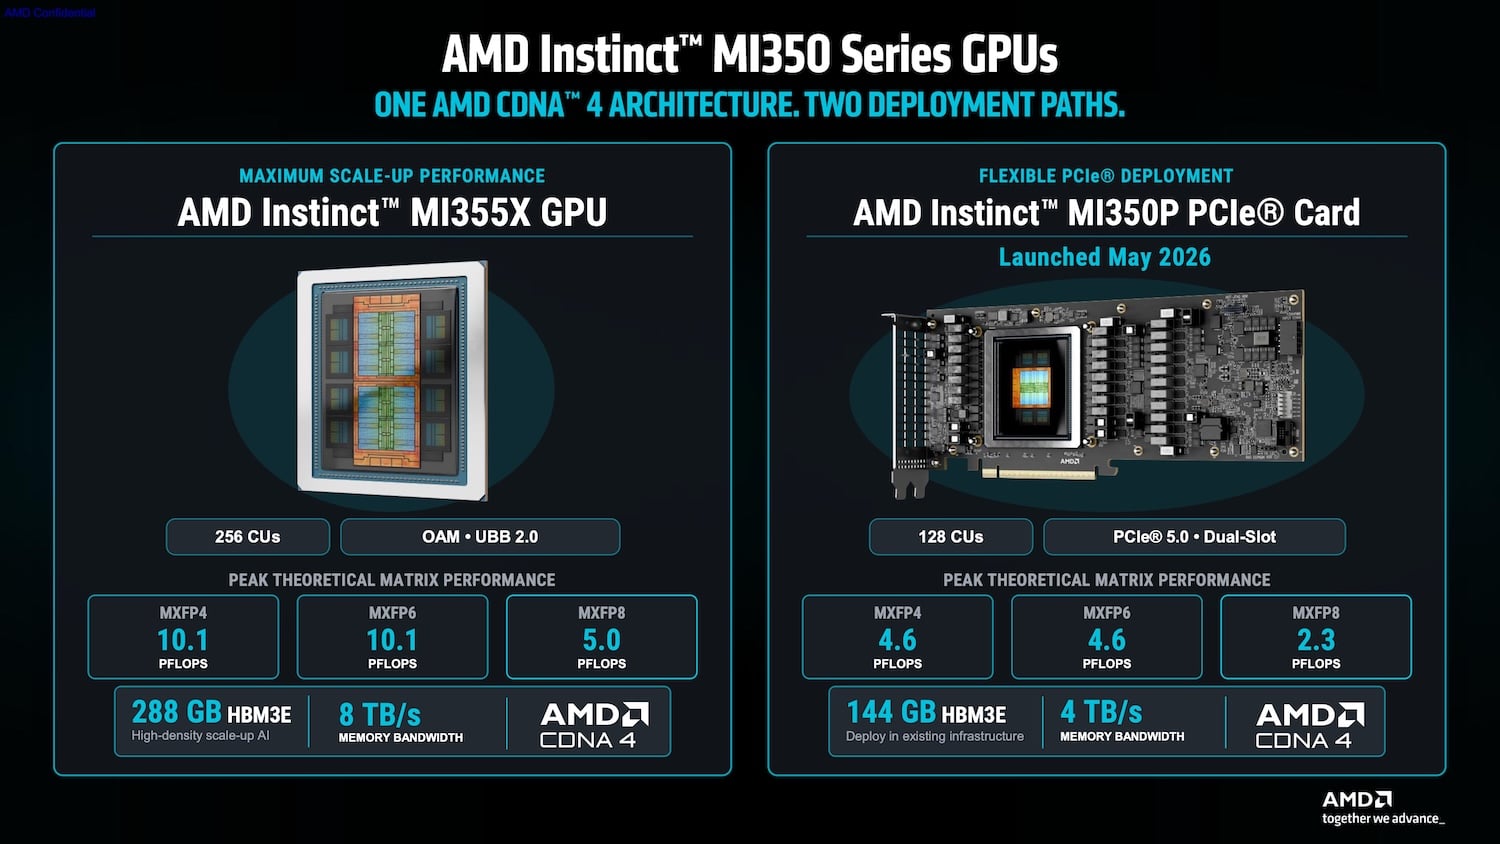
Флагманский ускоритель Instinct MI355X ориентирован на высокоплотные вычислительные узлы и выполнен в форм-факторе OAM на платформе OCP Universal Baseboard (UBB 2.0). Он оснащен 256 вычислительными блоками, 288 ГБ памяти HBM3E и обеспечивает совокупную пропускную способность памяти на уровне 8 ТБ/с.
Данное решение обеспечивает до 10,1 Пфлопс пиковой теоретической производительности матричных вычислений в форматах MXFP4 и MXFP6.
Впервые представленный ускоритель Instinct MI350P адаптирует ту же кремниевую архитектуру CDNA 4 в виде платы расширения PCIe 5.0 с двойным слотом для стандартных серверных корпусов корпоративного класса. Устройство содержит 128 вычислительных блоков, 144 ГБ памяти HBM3E, пропускную способность 4 ТБ/с и обеспечивает до 4,6 Пфлопс пиковой теоретической матричной производительности в форматах MXFP4 и MXFP6.
Повышение производительности благодаря софту на идентичном «железе»
Программные оптимизации в среде AMD ROCm v7 привели к измеримому приросту пропускной способности на неизменном «железе» MI355X в рамках одного цикла тестов MLPerf.
Тестирование на узле с восемью GPU MI355X показало, что пропускная способность для модели GPT-OSS-120B увеличилась на 28% в офлайн-сценарии и на 38% в серверном сценарии, в то время как производительность в задаче Wan-2.2 SingleStream выросла на 70%.
На уровне кластера 72 ускорителя MI355X в бенчмарке MLPerf 6.1 продемонстрировали более высокую совокупную пропускную способность для модели GPT-OSS-120B, чем конфигурация из 94 GPU, заявленная в раунде 6.0.
Согласно сравнительным данным, опубликованным самой AMD, конфигурация на базе восьми GPU MI355X опередила представленные результаты решений NVIDIA B200 и B300 при работе с GPT-OSS-120b, а кластер из 72 ускорителей превзошел заявку NVIDIA на базе системы GB200.
В своем дебютном раунде MLPerf ускоритель MI350P с двойным слотом участвовал в пяти закрытых нагрузках (Closed workloads), продемонстрировав лидирующие результаты по сравнению с отдельными заявками систем NVIDIA RTX PRO 6000 Server Edition и H200 NVL.
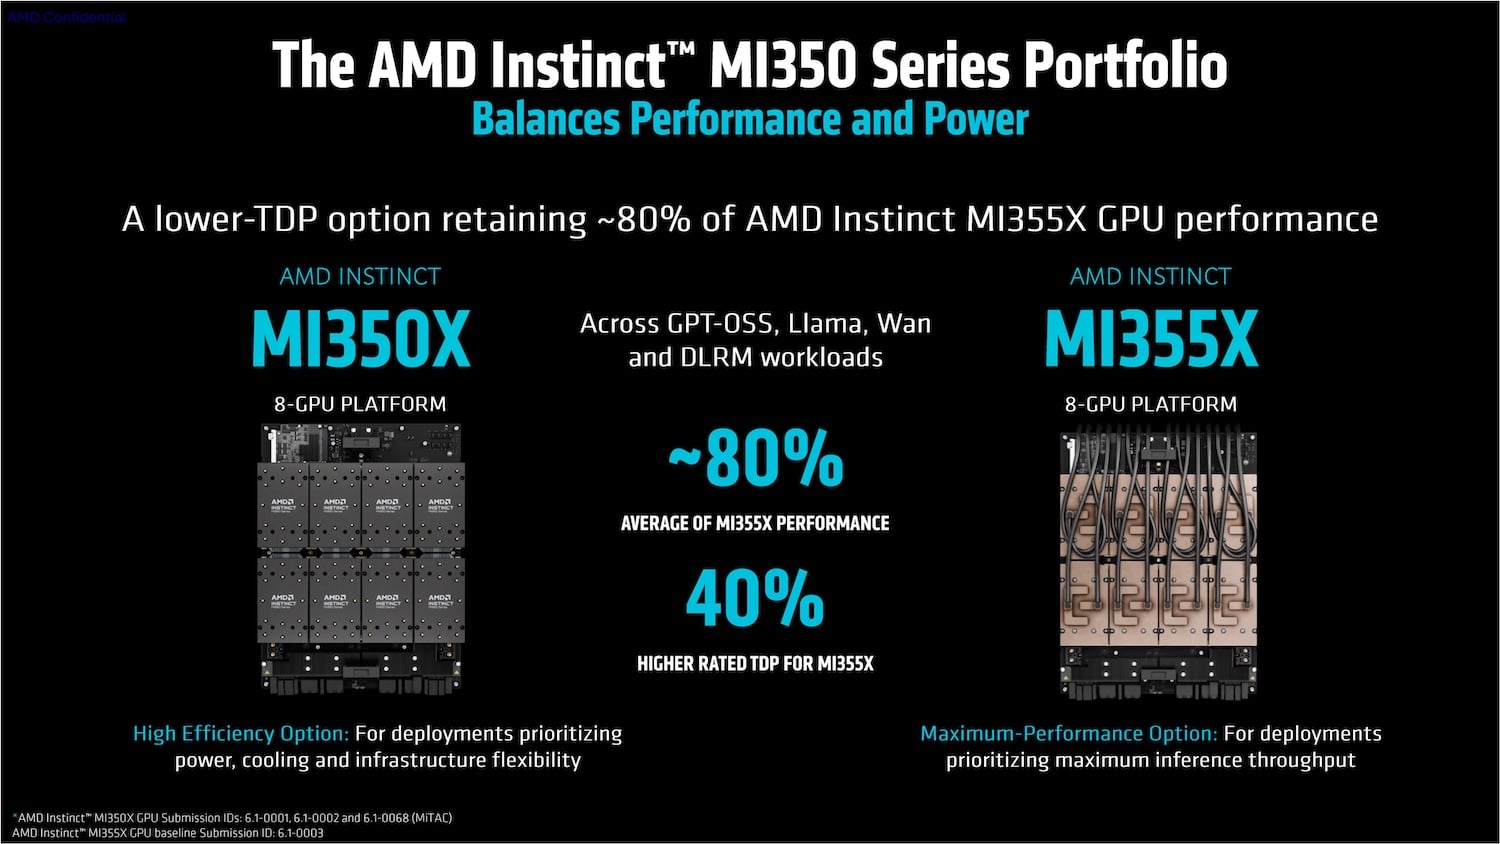
Для инфраструктур, чувствительных к ограничениям по энергопотреблению и охлаждению, восьмипроцессорная система на базе MI350X сохранила примерно 80% производительности платформы MI355X в бенчмарках для нагрузок GPT-OSS, Llama, Wan и DLRM, притом что модель MI355X обладает на 40% более высоким номинальным показателем тепловыделения (TDP).
Независимое исследование, проведенное компанией Signal65 по заказу AMD, показало, что эти показатели пропускной способности трансформируются в более низкие эксплуатационные расходы на один документ и увеличенный выход токенов на доллар в рамках фиксированных ограничений по задержке.
Результаты партнеров AMD и межконтинентальный кластер
По заявлению AMD, аналогичные результаты тестирования ускорителей MI355X от семи партнеров — Dell Technologies, Oracle, Hewlett Packard Enterprise, Supermicro, MangoBoost, Crusoe и MiTAC — отклонялись в среднем не более чем на 4% от показателей эталонной системы вендора, а некоторые прогоны соответствовали им или даже немного превосходили их.
Гетерогенные конфигурации и будущее бенчмарков в дата-центрах
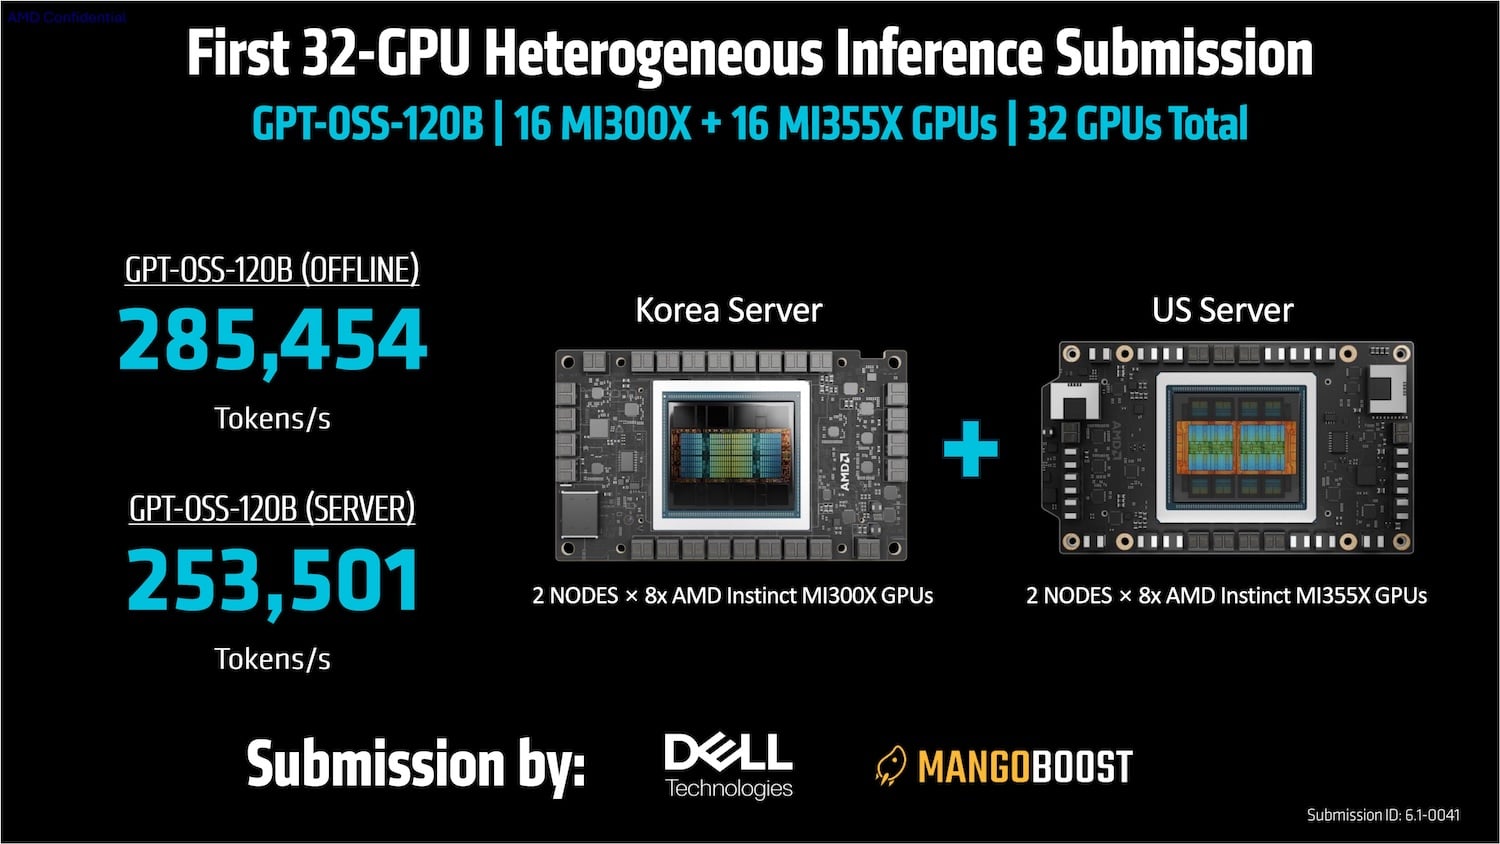
Упомянутая ранее совместная заявка MangoBoost и Dell представляет собой первую в истории бенчмарка гетерогенную конфигурацию обслуживания на 32 графических процессорах, которая объединяет 16 графических процессоров Instinct MI300X предыдущего поколения в Корее с 16 графическими процессорами Instinct MI355X в Соединенных Штатах в единую конечную точку GPT-OSS-120B.
Конфигурация с разделенным кластером продемонстрировала производительность в 285 454 офлайн-токена в секунду и 253 501 серверный токен в секунду.
Заявки выполнялись на программной платформе ROCm 7, при этом компания AMD указывает на релиз ROCm 10 в сочетании с vLLM, SGLang и инструментами профилирования ROCm.AI как на дальнейший путь развития перед появлением серии MI400 на базе памяти HBM4 и следующего за ней поколения MI500.
Инструментальная обвязка, заменяющая MLPerf Inference в дата-центрах
Шестнадцать из 30 участников в этот раз использовали ориентированную на API обвязку MLPerf, тогда как в версии 6.0 был всего один участник в открытом дивизионе.
Данная обвязка запускает полноценную клиент-серверную установку по стандартным API против размещенной конечной точки, что соответствует тому, как развертывается инференс в дата-центрах, и она уже поддерживает новые тесты Edge Agentic, VLM-Interactive, gpt-oss, DeepSeek-R1, Llama 3.1-8B, а также генерацию текста в видео.
Она выступает основой для MLPerf Endpoints, которая открывает прием динамических заявок по требованию в октябре 2026 года и полностью заменит MLPerf Inference в качестве бенчмарка для дата-центров в 2027 году, причем для версии Endpoints v1.0 запланированы нормированные результаты и расширенные рабочие нагрузки агентного типа. «Двигаясь вперед, MLPerf Endpoints заменит Inference в нашем семействе бенчмарков для дата-центра, а быстрое принятие нашей ориентированной на API обвязки внесет вклад в то, чтобы сделать этот переход плавным», — заявил Дэвид Кантер, глава MLPerf.
Шестью новыми участниками в этом раунде стали компании Atlas Inference, Crusoe, Orrick Industries, ScitiX, VibeHPC, а также независимый участник Наим Хошневис из Института Кемпнера при Гарвардском университете, который представил результат для одной карты H200 с моделью Llama 3.1-8B.
Данный раунд тестов инференса следует за результатами MLPerf Storage v3.0, опубликованными двумя неделями ранее, а полные таблицы для дата-центров и периферийных систем вместе с дополнительными материалами от участников доступны на страницах результатов MLCommons.