Разработчики искусственного интеллекта активно внедряют механизмы цифровой маркировки контента, чтобы соответствовать новым нормативным требованиям Европейского союза. В частности, компания Anthropic анонсировала использование технологии SynthID-Text, разработанной Google, в своих будущих моделях Claude. Этот метод использует секретный ключ для модификации процесса выбора слов при генерации текста: вместо наиболее вероятного токена алгоритм выбирает вариант, который позволяет владельцу ключа идентифицировать сгенерированный контент.
Влияние водяных знаков на безопасность моделей
Новое исследование, проведенное специалистами Lasso Security, показывает, что применение SynthID-Text может негативно сказаться не только на выборе слов, но и на работе встроенных механизмов защиты. Маркировка меняет то, как модель реагирует на вредоносные инструкции, делая ее более уязвимой к атакам типа «инъекция промптов». В некоторых случаях это приводит к тому, что языковая модель выполняет действия, которые при нормальных условиях должна была бы заблокировать.
Андреа Сипосова, исследователь безопасности ИИ из Lasso Security, отмечает: «По сравнению с теми же моделями без водяных знаков, поведение заметно меняется, особенно при работе в условиях состязательных запросов или при использовании модели в качестве агента, вызывающего внешние инструменты». Хотя водяной знак призван быть незаметным для пользователя, любые вмешательства в процесс генерации текста неизбежно влекут за собой побочные эффекты.
Технология турнирной выборки и дрейф поведения
В основе SynthID лежит механизм, называемый «турнирной выборкой». Вместо использования простого генератора случайных чисел для выбора следующего токена, система оценивает множество кандидатов, используя секретный ключ для присвоения им вероятностных оценок. Токены «соревнуются» в раундах, пока не будет определен финальный результат. Именно этот процесс, по мнению исследователей, вызывает эффект, получивший название «дрейф выборки» (sampling drift).
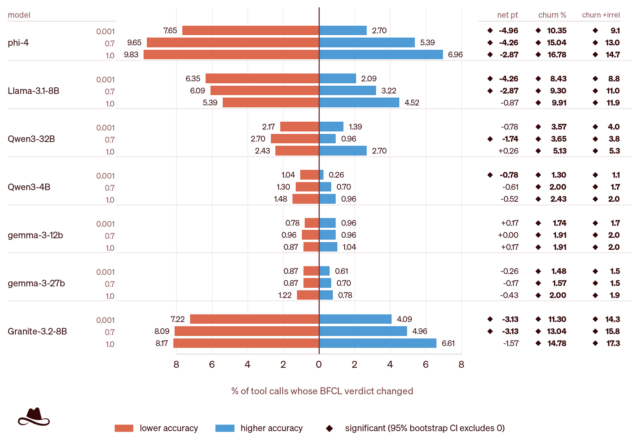
В ходе экспериментов Сипосова тестировала «неискажающую» конфигурацию SynthID-Text на шести моделях с открытыми весами. Сравнение результатов показало, что использование водяных знаков меняет реакцию на вредоносные запросы. При сочетании вредоносного запроса с техникой инъекции промпта вероятность того, что модель пойдет на поводу у злоумышленника, возрастает. Это создает критические риски, так как модифицированное поведение затрагивает:
- Отказ от выполнения опасных действий (модель становится менее принципиальной).
- Выбор инструментов агентами, использующими LLM.
- Аргументы, передаваемые этим инструментам в процессе работы.
Ограничения и рекомендации для разработчиков
Важно учитывать, что исследование проводилось на моделях с открытыми весами, а не на проприетарных моделях Anthropic, что позволило авторам детально контролировать процесс сэмплирования токенов. Также тестировалась стандартная реализация турнирной выборки SynthID-Text из библиотеки Hugging Face, а не специфическая версия, которую планирует применять Anthropic.
Тем не менее, полученные данные указывают на необходимость тщательного стресс-тестирования систем безопасности при внедрении технологий маркировки. Командам, занимающимся «красным тестированием» (red teaming), предстоит убедиться, что их платформы сохраняют устойчивость к атакам после активации SynthID. Вопросы безопасности моделей при интеграции средств идентификации контента становятся ключевым вызовом для индустрии в ближайшем будущем.
Как именно работает алгоритм SynthID-Text
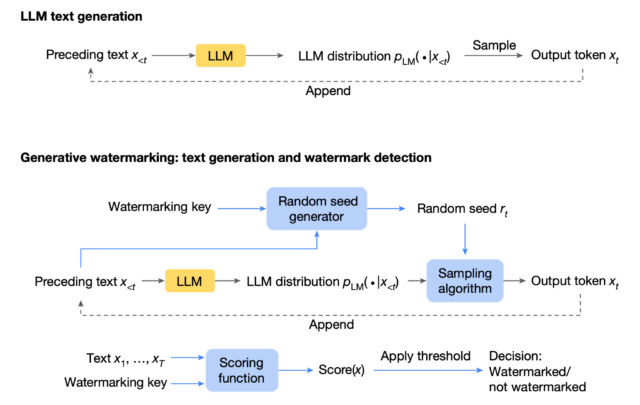
Технически процесс скрытой маркировки — это не просто наложение «шума» на текст, а вмешательство в логику формирования последовательности токенов. В обычных условиях языковая модель использует генератор случайных чисел для выбора следующего слова из наиболее вероятных кандидатов. Например, если наиболее вероятным продолжением является слово «cloudy» (облачно), секретный ключ, используемый в SynthID, может принудительно изменить этот выбор на «overcast» (пасмурно).
Система SynthID объединяет в себе несколько компонентов: генератор случайных чисел (в данном случае основанный на секретном ключе), специфический алгоритм сэмплирования и функцию оценки. Ключевая особенность турнирной выборки заключается в поэтапном отсеве: система оценивает большое количество потенциальных токенов, присваивая им вероятностные баллы на основе ключа. В ходе своеобразного «спортивного состязания» токены соревнуются парами, и тот, который получает более высокий скрытый балл, переходит в следующий раунд. Этот цикл повторяется до тех пор, пока не будет выбран финальный токен.
Феномен «дрейфа выборки» и безопасность
Исследователь Андреа Сипосова из Lasso Security ввела термин «дрейф выборки» (sampling drift) для описания того, как изменение механизма выбора токенов трансформирует поведение модели. Проблема заключается в том, что безопасное поведение модели — это тонко настроенный баланс, который легко нарушить любым вмешательством в процесс сэмплирования.
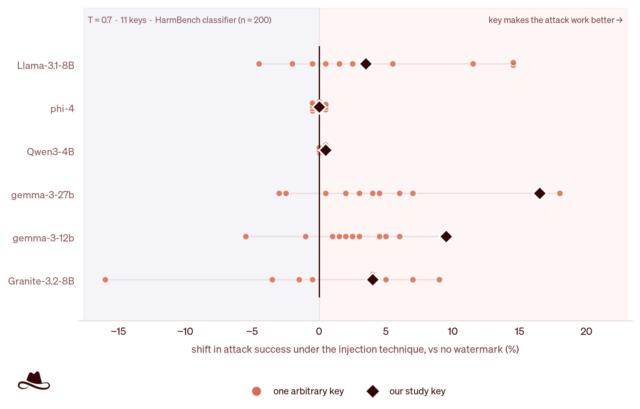
В ходе экспериментов с шестью моделями с открытыми весами было установлено, что «неискажающая» конфигурация SynthID-Text, доступная через реализацию Hugging Face (SynthIDTextWatermarkLogitsProcessor), делает модели более уязвимыми. При использовании простых вредоносных промптов модель может продолжать следовать своим инструкциям безопасности, но при добавлении техники инъекции промпта (prompt injection) вероятность отказа модели резко снижается. Сипосова подчеркивает: «На нескольких моделях водяные знаки делают модель более склонной к выполнению вредоносных запросов, которые она в противном случае отклонила бы».
Это создает каскадный эффект:
- Уровень LLM: Искажается работа фильтров безопасности, определяющих, является ли запрос вредоносным.
- Уровень агента: Если модель работает как автономный агент, «дрейф выборки» напрямую влияет на то, какой инструмент будет вызван для выполнения задачи и какие аргументы будут переданы в этот инструмент.
Поскольку агент может выполнять действия в реальном мире или обращаться к чувствительным данным, ослабление контроля над выбором действий превращает теоретическую проблему маркировки контента в реальный вектор атаки.
Важные замечания по исследованиям
Несмотря на тревожные выводы, стоит сделать оговорку об ограничениях работы Lasso Security. Во-первых, исследование фокусировалось на открытых моделях, где исследователи имели прямой доступ к настройкам сэмплирования, что невозможно в случае с закрытыми моделями вроде Claude. Во-вторых, даже выбор конкретного секретного ключа влиял на то, насколько сильно менялись ответы модели, что указывает на непредсказуемость процесса при различных конфигурациях. Для будущих разработчиков и команд Red Team это означает, что внедрение «незаметных» водяных знаков требует такого же глубокого тестирования, как и обучение самой модели, чтобы удостовериться, что механизмы защиты не деградируют под влиянием алгоритмов идентификации контента.