Разработчики Ubuntu столкнулись с беспрецедентным объемом отчетов о найденных уязвимостях (CVE). Чтобы справиться с потоком информации, компания Canonical объявила о переходе на новый унифицированный двухнедельный цикл выпуска обновлений. Ранее процесс был разделен на ежемесячные обновления и двухнедельные патчи безопасности, однако автоматизация поиска ошибок сделала прежний график неактуальным.

Почему количество отчетов об ошибках резко возросло
Основной причиной резкого роста числа зарегистрированных уязвимостей стало массовое внедрение искусственного интеллекта. Большие языковые модели (LLM) и специализированные ИИ-агенты превратили процесс поиска багов из трудоемкой ручной работы в высокоавтоматизированный конвейер. Это привело к ситуации, когда разработчики вынуждены обрабатывать больше CVE-отчетов, чем когда-либо прежде.
Дополнительный вклад внесло решение сообщества разработчиков ядра Linux стать самостоятельным органом по нумерации уязвимостей (CNA). Теперь тысячи ошибок, которые ранее могли не классифицироваться как критические, получают официальные идентификаторы CVE, так как практически любой сбой в работе ядра теоретически может быть использован как уязвимость. В совокупности эти факторы вынудили Canonical оптимизировать внутренние процессы доставки патчей пользователям.
Адаптация к «новой норме» в разработке ядра Linux
Проблема, с которой столкнулась Ubuntu, характерна для всей экосистемы Linux. Разработчики самого ядра также вынуждены адаптироваться к потоку сообщений об ошибках, который, по мнению экспертов, не снизится в ближайшее время. Первые признаки изменений стали заметны еще при подготовке релиза Linux 7.0, когда Линус Торвальдс отметил аномальное увеличение числа отчетов, сопровождающих кандидаты в релизы.
Ситуация стала более показательной при подготовке Linux 7.1. Торвальдс подтвердил, что рост объема документации не был случайностью. Более того, многие отчеты начали дублировать друг друга или предлагать изменения для второстепенных задач, что делает процесс сопровождения ядра практически неуправляемым. Торвальдс охарактеризовал текущую ситуацию как «новую норму», признав, что массовое использование ИИ-помощников для автоматического обнаружения, сообщения и исправления ошибок навсегда изменило структуру changelist-файлов, сделав их значительно объемнее, чем раньше.
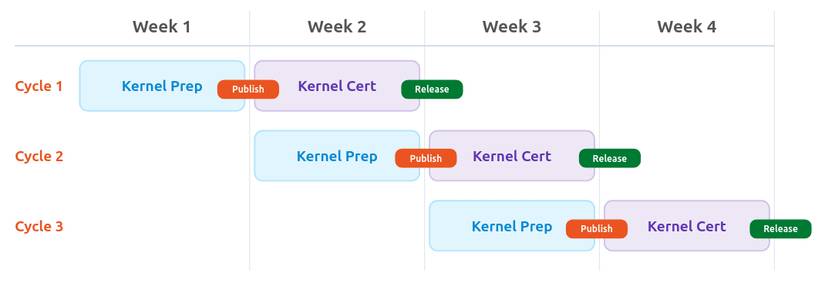
Дискуссии о месте нейросетей в open-source проектах продолжаются. Часть сообществ FOSS полностью запретила использование ИИ, тогда как другие интегрировали новые технологии в свои процессы, вынужденно перестраивая методы работы. Canonical, внедряя жесткий двухнедельный график патчей, фактически пытается подстроиться под реалии этой новой технологической эпохи.
Почему рост отчетов не привел к задержкам в ядре Linux
Интересно, что, несмотря на резкий всплеск активности и увеличение размеров кандидатов в релизы (release candidates), Линус Торвальдс не счел найденные нейросетями ошибки критически важными. В случае с Linux 7.0 многие из обнаруженных багов не представляли серьезной угрозы, что позволило не откладывать выход релиза и выпустить его точно в срок. Это подчеркивает фундаментальное различие между количеством отчетов и их реальной значимостью для стабильности системы.
Проблемы качества поступающих данных
Ситуация достигла пика во время разработки Linux 7.1, когда стало очевидно, что поток сообщений стал практически неуправляемым. Основная сложность для мейнтейнеров заключается не только в объеме, но и в качестве обратной связи: ИИ-агенты нередко дублируют уже существующие отчеты или используют защищенные каналы связи для отправки предложений по внесению тривиальных, маловажных изменений. Такой «шум» в системе отчетности заставляет разработчиков тратить значительные ресурсы на фильтрацию полезных данных от второстепенных сообщений.
Реакция сообщества FOSS
Использование LLM в открытых проектах остается предметом острых дискуссий. Внутри FOSS-сообщества (Free and Open Source Software) нет единого мнения:
- Некоторые проекты выбрали путь радикальных запретов на использование ИИ-инструментов в разработке.
- Другие сообщества приняли технологию, но столкнулись с необходимостью полностью адаптировать свои внутренние процессы к новым способам ведения разработки и обработки правок.
Canonical в данном случае выступает примером того, как крупная организация вынуждена менять десятилетиями отлаженные графики релизов, чтобы справиться с последствиями автоматизированного поиска уязвимостей.