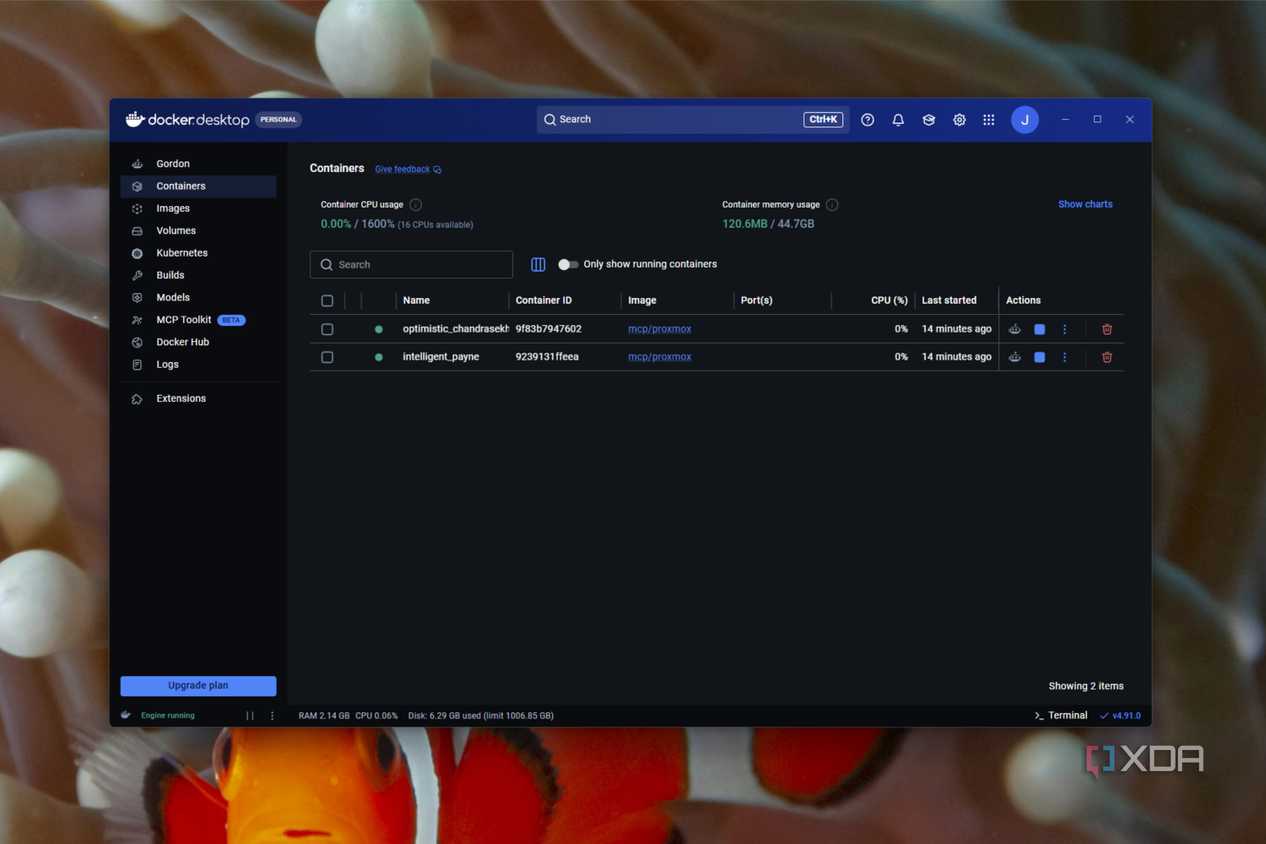
Во время аудита домашней лаборатории перед установкой системы мониторинга в Docker Desktop был обнаружен контейнер, который находился в состоянии «Exited (0)» последние два месяца. Изначально казалось, что причина неисправности найдена, однако ситуация оказалась сложнее: этот контейнер был лишь следом от неудачной попытки запуска, а настоящая проблема скрывалась в инструментах автоматизации, которые не отслеживались стандартными средствами.
Почему стандартный мониторинг не увидел ошибку
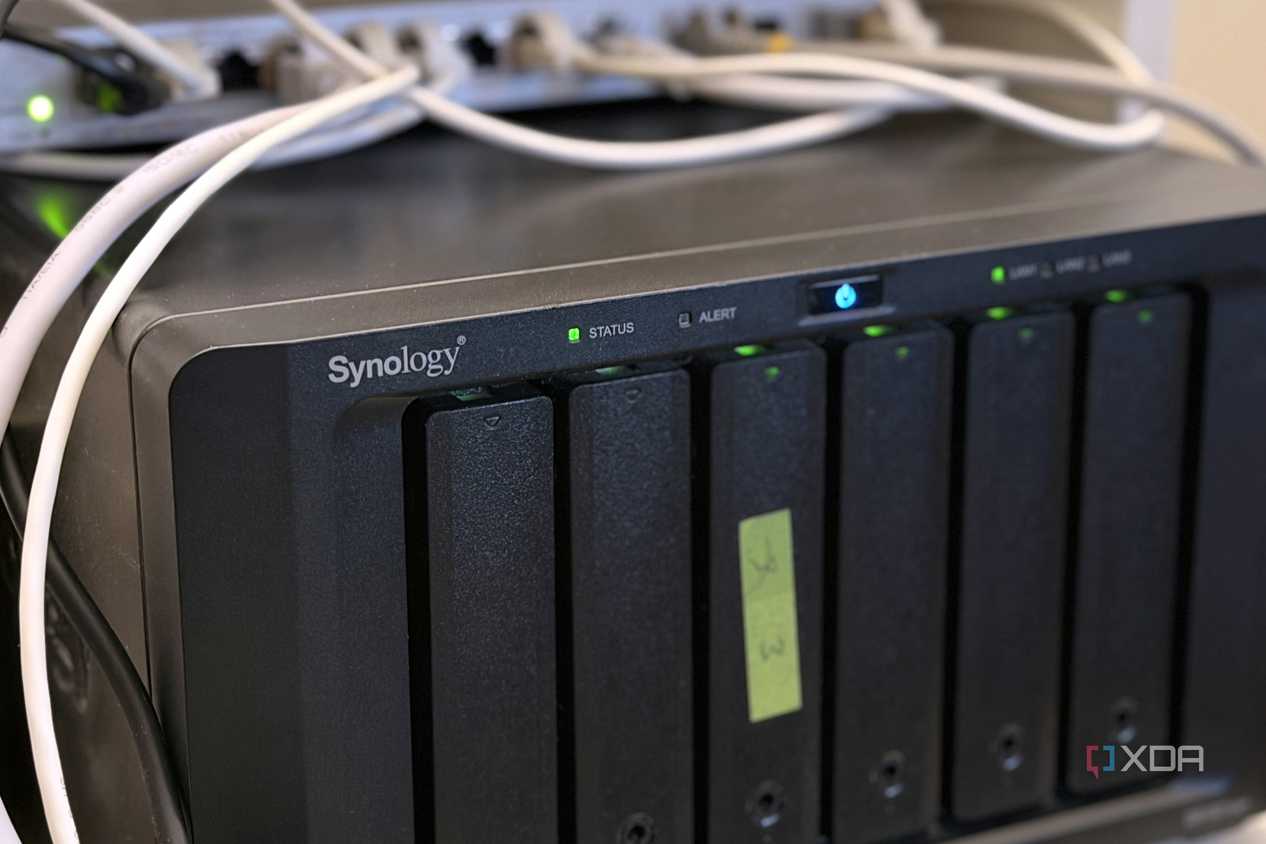
Обнаруженный контейнер относился к серверу Synology MCP, обеспечивающему взаимодействие Claude с NAS-хранилищем DS1621xs+. Когда сервис работает, Claude может напрямую читать и записывать заметки в лаборатории; в противном случае модель переключается на локальную копию. Четыре недели подряд в отчетах о работе системы появлялась строка о переходе на локальную копию, но на это никто не обращал внимания.
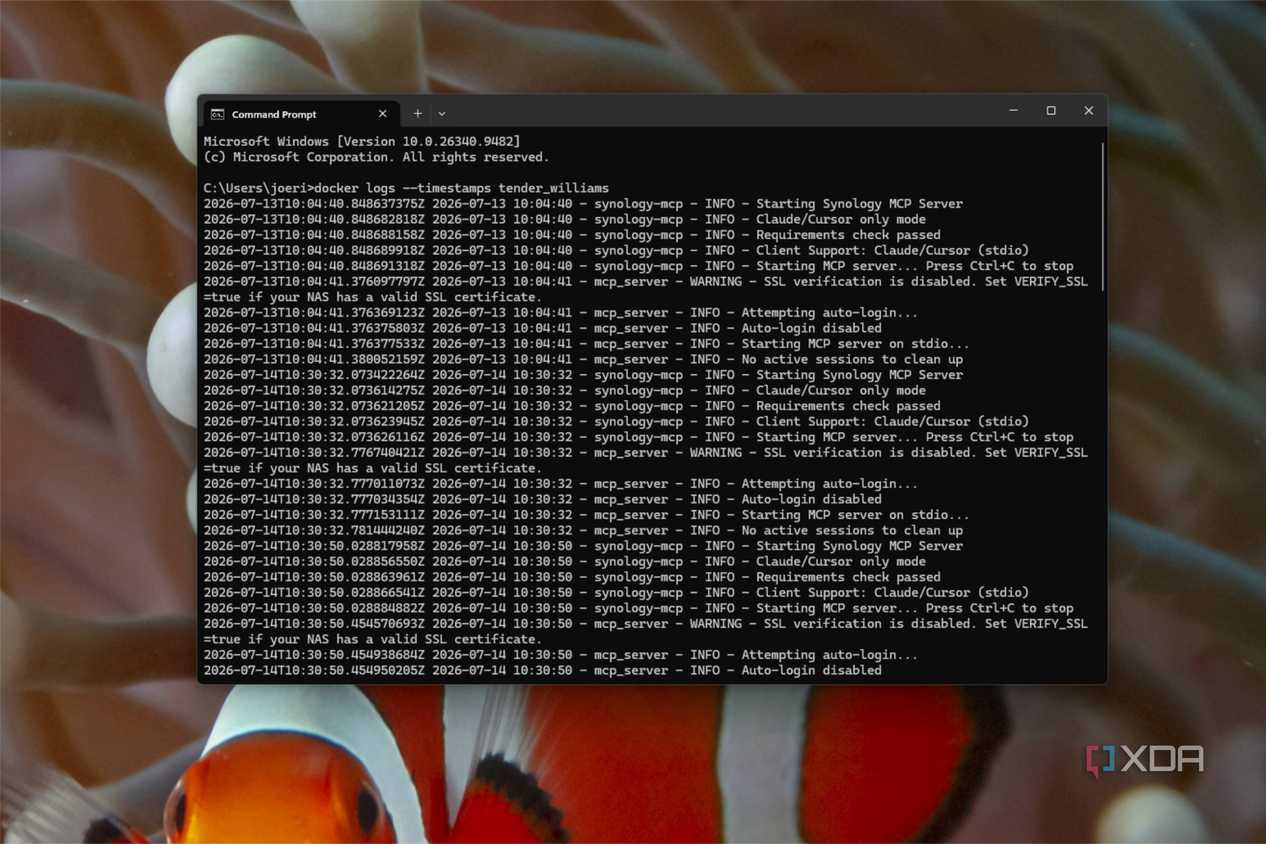
При детальном анализе логов выяснилось, что этот контейнер был запущен десять раз еще в июле и каждый раз завершал работу в течение секунды из-за отсутствия интерактивного потока ввода. Docker присвоил ему код выхода 0, что означает «все в порядке», хотя сервис так и не выполнил ни одной задачи.
Ошибка в конфигурации и обновление библиотек
Истинная причина неработоспособности сервиса крылась в процессе запуска через Claude Desktop, который использует инструмент uv для работы с окружением Python. В файле требований к проекту было указано ограничение версии mcp>=1.28.0 без верхнего предела. 28 июля вышла версия 2.0.0 библиотеки mcp, в которой разработчики удалили API, необходимое для работы сервера. С того момента каждая попытка запуска приводила к загрузке несовместимой версии, и сервис прекращал работу до обращения к NAS.
Ситуацию усугубило отсутствие обновления проекта и удаление учетной записи DSM, под которой сервер должен был проходить авторизацию. После того как автор восстановил аккаунт и зафиксировал версию библиотеки ниже 2.0, работоспособность была восстановлена.
Недостатки текущей системы оповещения
Параллельно выяснились другие проблемы в обслуживании лаборатории Proxmox. Оказалось, что на узле отсутствовало полноценное резервное копирование — вместо него были лишь ZFS-снимки нескольких контейнеров. Кроме того, ежедневная проверка обновлений не работала 11 дней, так как истекла подписка Proxmox, а корпоративные репозитории перестали обслуживать узел. Все ошибки отправлялись на почту root, которую никто не проверял.
Новый стек мониторинга для автоматизации
Для решения проблем была внедрена небольшая группа сервисов на базе LXC-контейнеров из скриптов сообщества Proxmox VE:
- Uptime Kuma проверяет доступность сервисов по портам.
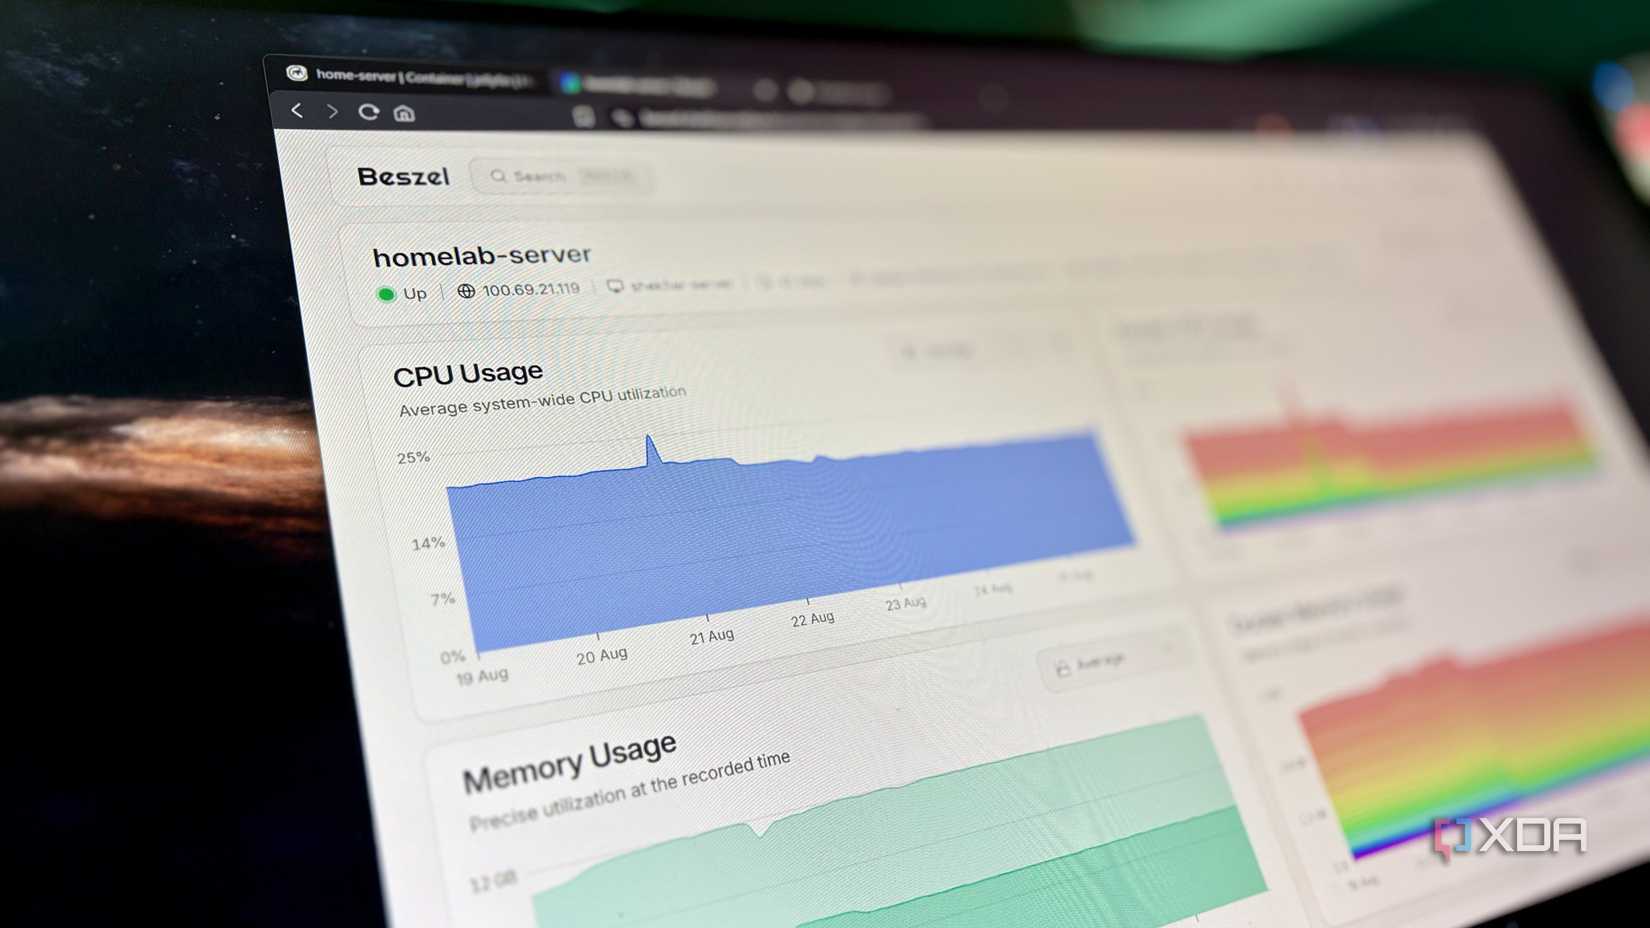
- Beszel мониторит состояние оборудования.
- ntfy отправляет уведомления на смартфон.
Однако ни один из этих инструментов не мог обнаружить сбой запуска, так как MCP-сервер не использует порты, а сервис, завершающийся за секунду, не успевает попасть в мониторинг. Для контроля был написан небольшой Python-скрипт. Он эмулирует запуск каждого MCP-сервера, выполняет «рукопожатие», запрашивает список инструментов и сообщает результат в Uptime Kuma. Если скрипт перестает передавать данные, срабатывает тревога.
Опыт показал, что информация о сбоях в системе была доступна (через логи и отчеты), но отсутствовал механизм перевода этой информации в реальные уведомления. В таких конфигурациях важно не только полагаться на стандартные инструменты, но и проводить аудит цепочек запуска для сервисов с открытыми диапазонами версий.
Почему стандартный мониторинг не справился с задачей
Важно понимать, что многие инструменты мониторинга, на которые полагается большинство владельцев домашних лабораторий, имеют «слепые зоны». В данном случае даже внедрение популярных решений не гарантировало бы обнаружение проблемы с Synology MCP. Uptime Kuma ориентирована на проверку сервисов, которые «слушают» определенный сетевой порт, однако сервер MCP, работающий через стандартный поток ввода/вывода (stdin), не открывает порты, оставаясь невидимым для классических проверок доступности. В свою очередь, система Beszel графически отображает только те процессы, которые успели запуститься и закрепиться в системе. Сервер, который аварийно завершается в первую же секунду после старта, просто не успевает попасть в поле зрения мониторинга ресурсов.
Автор подчеркивает, что мониторинг эффективен только тогда, когда у «тишины» системы есть четкое определение. В случае с лабораторией информация о проблемах была доступна в избытке: логи запускателя содержали сообщения об ошибках, система Proxmox ежедневно уведомляла о проблемах с репозиториями, а отчеты о содержимом заметок прямо указывали на сбой в интеграции. Однако эти данные оставались бесполезными, так как не был настроен канал их передачи (buzz on my phone). Письма, отправляемые на адрес root, попадали в почтовый ящик, который никто не проверял, что превращало систему оповещений в фикцию.
Детали исправления и подход к автоматизации
Чтобы исключить повторение подобных ситуаций, был реализован кастомный Python-скрипт. Его логика работы принципиально отличается от обычного сканирования портов: он берет команды запуска всех MCP-серверов из конфигурации Claude Desktop и исполняет их в точности так, как это делает клиент. Скрипт не просто проверяет факт запуска, он выполняет полноценное «рукопожатие» (handshake) и запрашивает у сервера перечень доступных инструментов. Этот процесс позволяет убедиться, что сервер не только работает, но и пригоден к использованию.
Для интеграции с существующей экосистемой скрипт отправляет результат проверки в push-монитор Uptime Kuma. Таким образом, если сам скрипт по какой-то причине перестает выполняться, система сразу сообщает о «молчании», которое является тревожным сигналом. В ходе утреннего запуска системы скрипт подтвердил корректную работу всех узлов:
- technitium-primary: 1.7 сек, 39 инструментов;
- technitium-secondary: 0.2 сек, 39 инструментов;
- Home Assistant: 21.0 сек, 77 инструментов;
- proxmox-iac: 2.8 сек, 32 инструмента;
- proxmox-full: 1.6 сек, 3 инструмента;
- synology: 1.9 сек, 77 инструментов.
До исправления строка с Synology выполнялась менее чем за две секунды и завершалась ошибкой, которую теперь система отслеживает каждые 30 минут. Это позволило бы обнаружить поломку еще в день обновления библиотеки, а не спустя недели случайных наблюдений.
Уроки домашнего администрирования
История с нерабочим сервером Synology стала наглядным напоминанием об опасности использования открытых диапазонов версий (например, mcp>=1.28.0 без верхнего порога). Обновление библиотеки, повлекшее удаление критически важного API, стало «тихим убийцей» сервиса, который оставался неактивным из-за отсутствия жесткой привязки версий (pinning). Автор рекомендует всем владельцам хомяков (homelabbers) пересмотреть свои конфигурации и зафиксировать версии зависимостей, чтобы избежать неожиданных поломок при апдейтах вверх по цепочке поставок.
Этот инцидент также подчеркнул разницу между ментальным представлением о надежности и реальностью. Наличие ZFS-снимков ошибочно воспринималось как полноценный бэкап, а регулярные ошибки Proxmox игнорировались из-за неверно настроенных уведомлений. Основной вывод для энтузиастов звучит так: прежде чем устанавливать новые инструменты мониторинга, необходимо провести полный аудит текущих процессов, так как самая очевидная «мертвая точка» (как тот самый контейнер в Docker Desktop) может оказаться лишь ложным следом, указывающим на более глубокую проблему в логике работы системы.