Современные голосовые помощники, такие как Amazon Alexa, Google Assistant и Apple Siri, в процессе работы постоянно отправляют записи голоса пользователя на облачные серверы для обработки. Такая зависимость от интернета означает, что при обрыве соединения управление умным домом перестает функционировать. Кроме того, облачные решения часто страдают от заметных задержек, а также могут сопровождаться нежелательными рекламными рекомендациями. Альтернативой является создание системы локального голосового управления, где весь процесс — от распознавания речи до парсинга намерений и генерации ответов — выполняется на мини-ПК, установленном непосредственно в доме. Это обеспечивает высокую скорость работы, полную конфиденциальность и независимость от внешних API.
Инструменты для создания локальной экосистемы
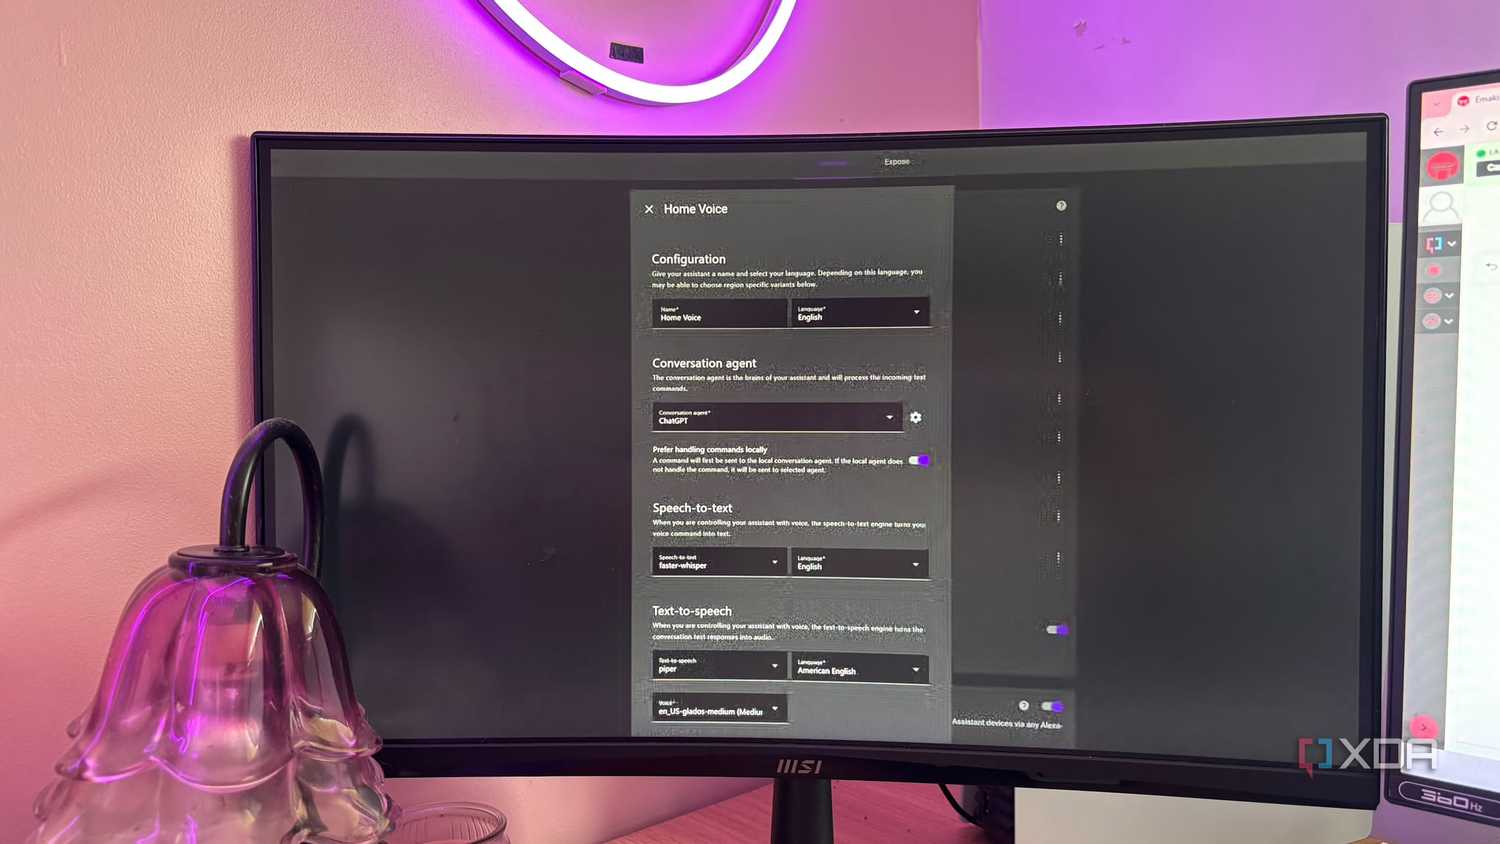
Чтобы заменить корпоративные облака, необходимо развернуть набор open-source инструментов. Первый критически важный компонент — система перевода речи в текст (speech-to-text). Популярная модель OpenAI Whisper способна работать локально, используя ресурсы центрального процессора или встроенной графики для транскрипции аудио с высокой точностью. После получения текста в дело вступает движок Home Assistant Assist, который анализирует команды на естественном языке, преобразуя фразы вроде «включи свет в кабинете и установи термостат на 72 градуса» в конкретные состояния устройств.
Для синтеза речи используется движок Piper, который генерирует реалистичные голоса. Он оптимизирован для эффективной работы даже на скромном аппаратном обеспечении. Для интеграции аудиооборудования и минимизации нагрузки при передаче данных через сеть рекомендуется применять протокол Wyoming, который связывает периферийные микрофоны с мини-ПК, выполняющим все основные вычисления.
Аппаратные требования и возможности мини-ПК
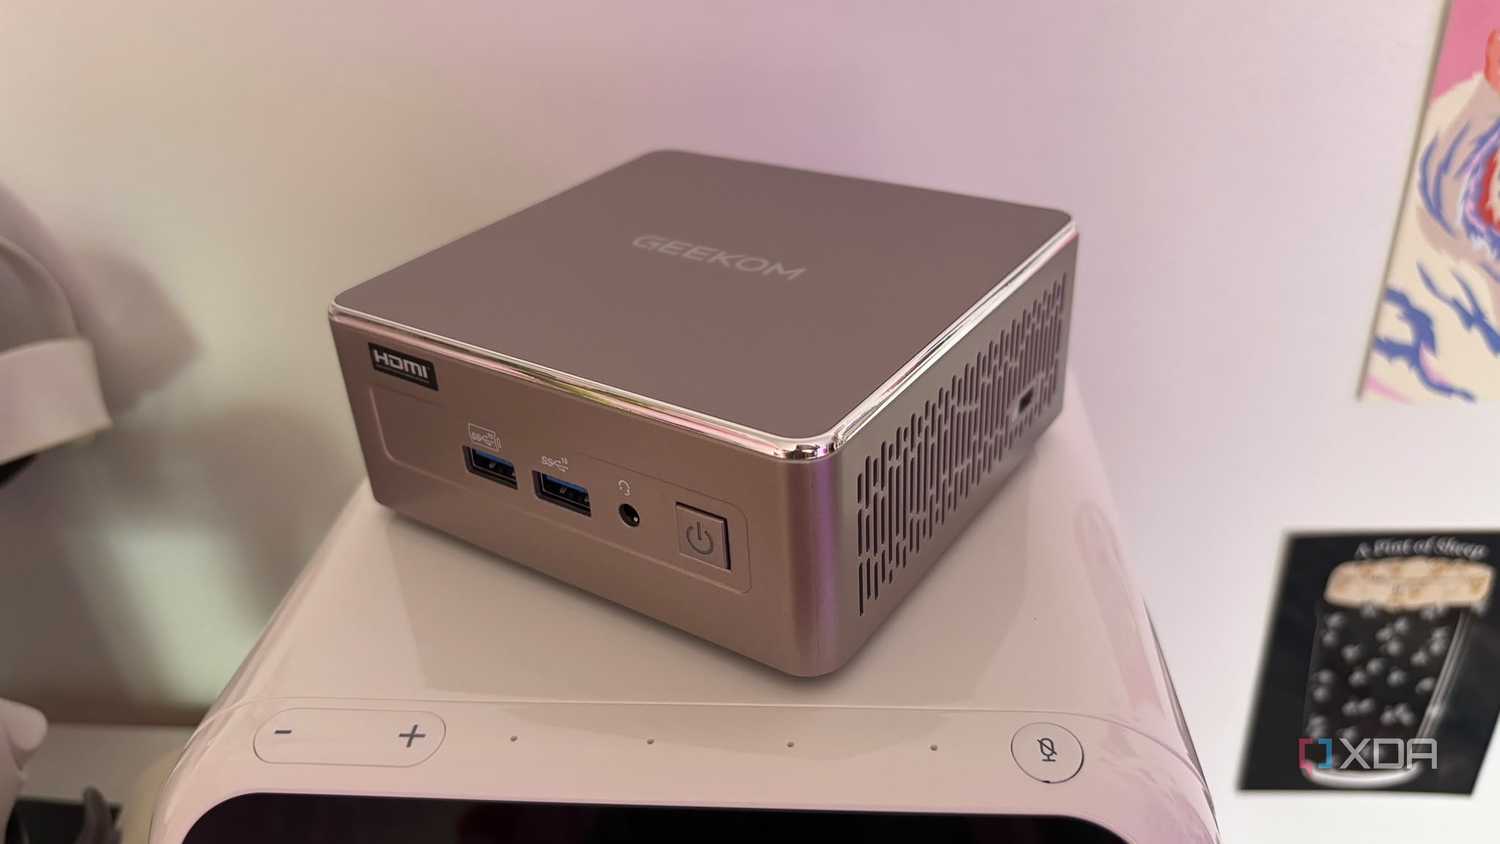
Для стабильной работы локального ИИ без перегрева важно выбрать производительное устройство. Удачным примером является Geekom A5 2027, оснащенный процессором на архитектуре Zen 3. Эффективность SIMD-инструкций и наличие AVX2 позволяют процессору Ryzen 5 7430U быстро выполнять матричное умножение, необходимое для моделей Whisper и Piper. Важным преимуществом такого решения является низкое энергопотребление в режиме ожидания (15–25 Вт), что делает возможным круглосуточную работу системы без существенного влияния на счета за электричество.
Кроме того, такие системы обладают запасом оперативной памяти (поддерживается до 64 ГБ DDR4), что позволяет интегрировать Ollama для запуска легких локальных языковых моделей, например, Llama 3 8B. Это дает возможность превратить обычный голосовой помощник в собеседника, понимающего контекст.
Настройка системы и использование голосовых спутников
Одной из практических проблем является захват звука. Если разместить мини-ПК за телевизором, он может не расслышать команды из других помещений. Для решения этой задачи рекомендуется использовать распределенные микрофоны, такие как M5Stack Atom Echo на базе ESP32 с прошивкой ESP Home Voice Assistant. Они позволяют улавливать голос в разных комнатах и передавать аудиопоток по Wi-Fi.
Процесс настройки включает следующие шаги:
- Развертывание серверных контейнеров: установка Proxmox VE или Docker для обеспечения прямого доступа Home Assistant OS к ресурсам системы.
- Установка надстроек Wyoming: активация Whisper и Piper в Home Assistant для формирования локальных речевых движков.
- Прошивка и подключение голосовых спутников через дашборд Home Assistant.
- Конфигурация намерений: создание файлов sentences.yaml для управления освещением, воспроизведением медиа и климатическими сценариями.
Оптимизация производительности достигается путем подбора подходящего размера модели Whisper, чтобы сбалансировать точность транскрипции и скорость обработки токенов процессором Ryzen 5 7430U.
Преимущества независимости от облака
Использование связки из специализированного ПО и эффективного «железа» вроде Geekom A5 2027 позволяет пользователям больше не выбирать между удобством технологий и конфиденциальностью данных. Отказ от «облачных оков» означает, что в жилом помещении больше не будет устройств, ведущих неконтролируемую запись для внешних серверов. Локальный контур управления дает полный контроль над тем, как именно умный дом слушает и отвечает на запросы пользователя.
Почему локальный ИИ — это путь к приватности
Основная проблема популярных голосовых помощников заключается в архитектуре их работы. Каждый раз, когда вы отдаете команду Amazon Alexa, Google Assistant или Apple Siri, ваша запись сжимается, упаковывается и отправляется на корпоративный облачный сервер для обработки. Это не просто вопрос задержки в несколько секунд — это прямая зависимость от качества вашего интернет-соединения. Если сеть дает сбой, ваш умный дом превращается в набор разрозненных устройств, неспособных реагировать на ваш голос.
Более того, облачная модель обработки открывает дверь для навязчивого маркетинга. Коммерческие смарт-колонки нередко страдают от «инфекции» в виде нежелательных торговых предложений или рекламных ответов, которые пользователь не запрашивал. Переход на локальное управление позволяет полностью исключить стороннее вмешательство: весь конвейер ИИ, от транскрипции до генерации естественного языка, работает на энергоэффективном мини-ПК, надежно спрятанном за вашей медиасистемой. Это превращает ваш умный дом в молниеносно быструю систему, работающую на 100% офлайн.
Детали программного стека
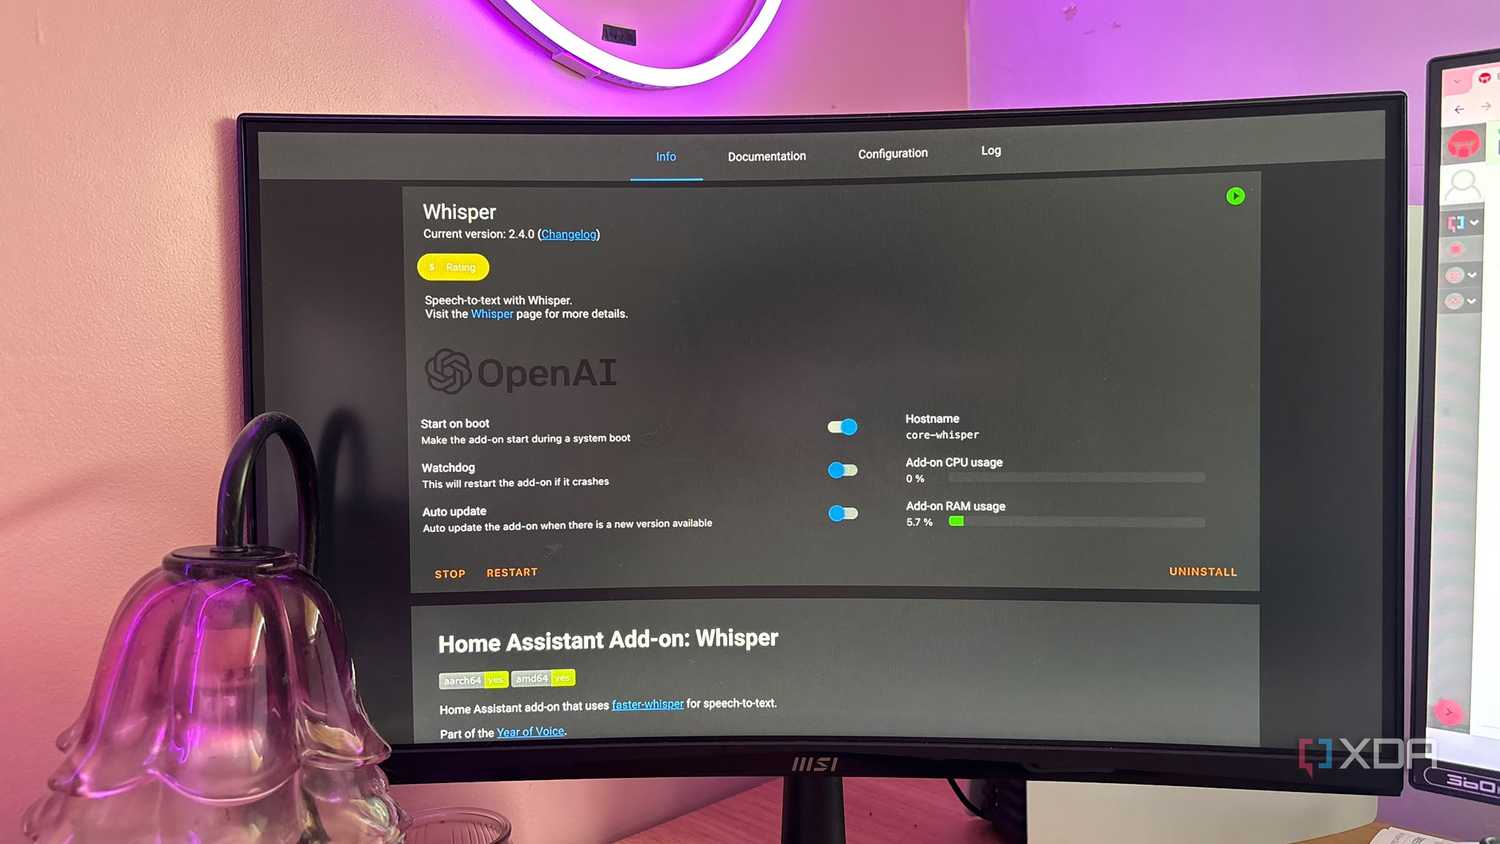
Для создания полноценной замены облачным серверам критически важно правильно настроить взаимодействие между компонентами. В частности, работа с OpenAI Whisper требует понимания того, что модель переводит сырые аудиоволновые данные в чистый текст без обращения к внешним API, что делает её идеальным выбором для локальных систем.
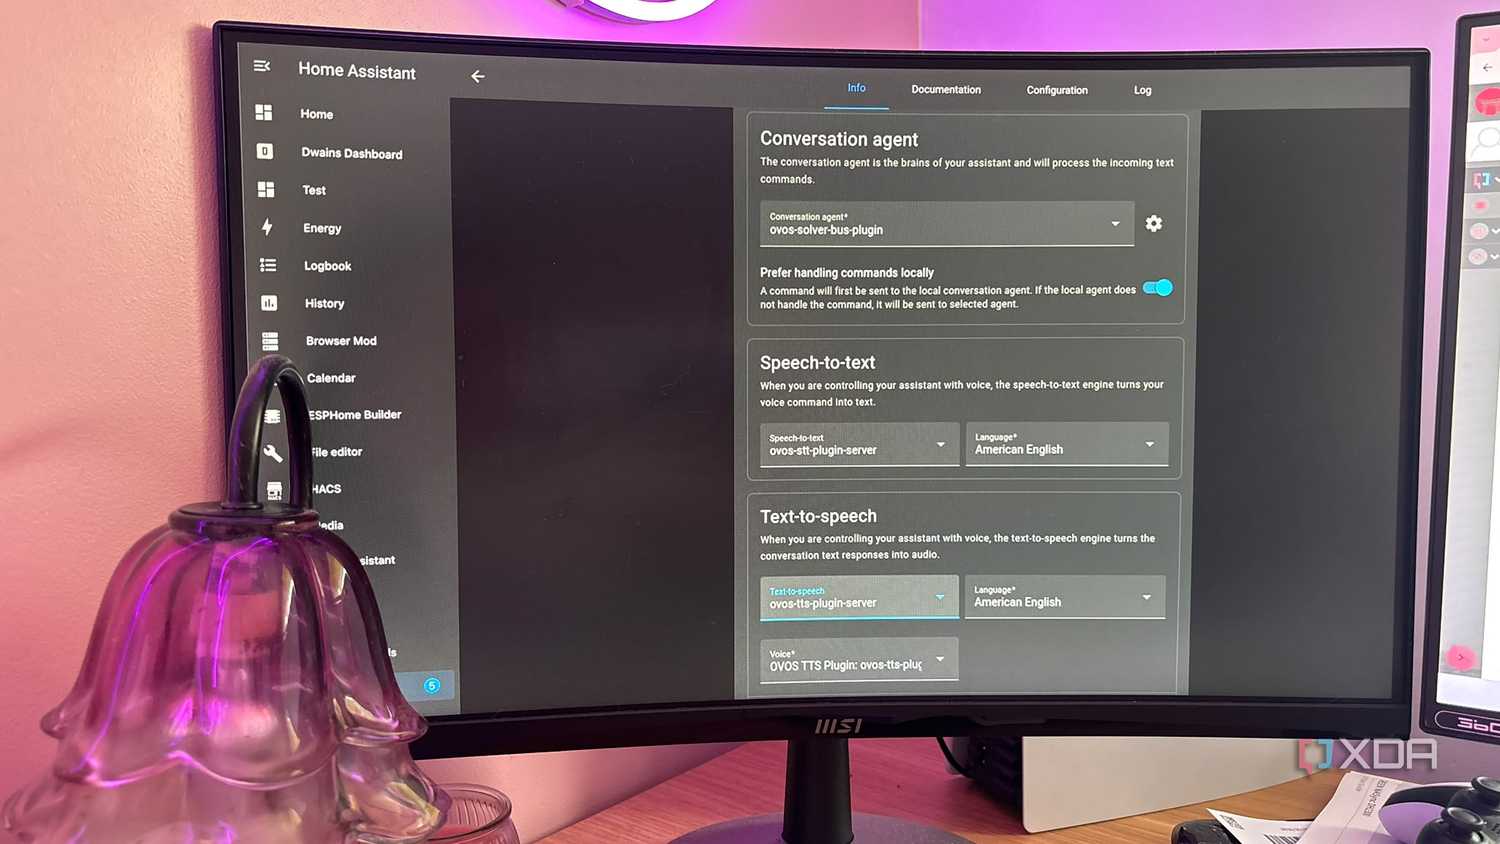
Home Assistant Assist выступает связующим звеном: он не просто переводит голос в текст, но и отображает человеческие фразы в конкретные состояния сущностей (entity states). Это значит, что система способна связывать несколько действий в одну комплексную команду. Например, фраза «включи свет в кабинете и установи термостат на 72°F» будет корректно интерпретирована встроенным движком намерений без дополнительных инструкций.
Использование протокола Wyoming играет ключевую роль в архитектуре. Он позволяет отделить «железо» захвата аудио (например, микрофоны Atom Echo) от «тяжелой» работы по стримингу аудиопотока по локальной сети. Это позволяет оптимизировать нагрузку на мини-ПК, концентрируя вычислительные мощности на обработке, а не на передаче данных.
Аппаратные нюансы и энергоэффективность
При выборе мини-ПК, такого как Geekom A5 2027, важно учитывать не только процессорную мощность, но и специфические требования к аппаратному обеспечению. Современные системы для голосового управления требуют высокой готовности: устройство должно «слушать» постоянно, оставаясь готовым к мгновенной обработке входящих потоков. Низкий уровень энергопотребления в режиме ожидания (те самые 15–25 Вт) гарантирует, что система не приведет к резкому скачку счетов за электричество при круглосуточной работе.
Также стоит отметить важность объема оперативной памяти. Поддержка до 64 ГБ DDR4 не является избыточной, если вы планируете масштабировать систему. Наличие такой памяти позволяет использовать Ollama для интеграции локальных больших языковых моделей (LLM), что превращает ваш дом из системы «команда–ответ» в пространство с контекстно-зависимым ИИ, обладающим собственной «личностью».
Практические советы по внедрению
Перед началом установки важно учесть «узкие места» размещения оборудования. Если мини-ПК спрятан в глубине стойки за телевизором, его встроенные микрофоны будут практически бесполезны для распознавания голоса из соседних комнат. Использование ESP32-based устройств, таких как M5Stack Atom Echo, является стандартом де-факто для создания распределенной сети микрофонов. Они легко интегрируются в Home Assistant через прошивку ESPHome, позволяя собирать аудиоданные в ключевых точках вашего жилища.
При настройке системы баланс между точностью и скоростью достигается путем настройки размеров модели Whisper. Выбор конкретной итерации модели напрямую влияет на скорость обработки токенов — чем легче модель, тем быстрее отклик. Долгосрочная цель такой настройки — добиться производительности, при которой время между окончанием вашей фразы и выполнением действия стремится к нулю, без необходимости подтверждать каждый шаг через облачные API.