Разработчики всё чаще используют локально размещенные большие языковые модели (LLM) для решения прикладных задач. Одним из таких экспериментов стала попытка создания подробной технической документации для проектов, где описание отсутствовало изначально, исключительно на базе имеющихся файлов с исходным кодом. В качестве инструмента была выбрана модель Qwen 3.6:27b-q4_K_M, запущенная локально с использованием графического процессора AMD Radeon RX 7900 XT, обладающего 20 ГБ видеопамяти.
Автоматизация описания для плагина MyBB
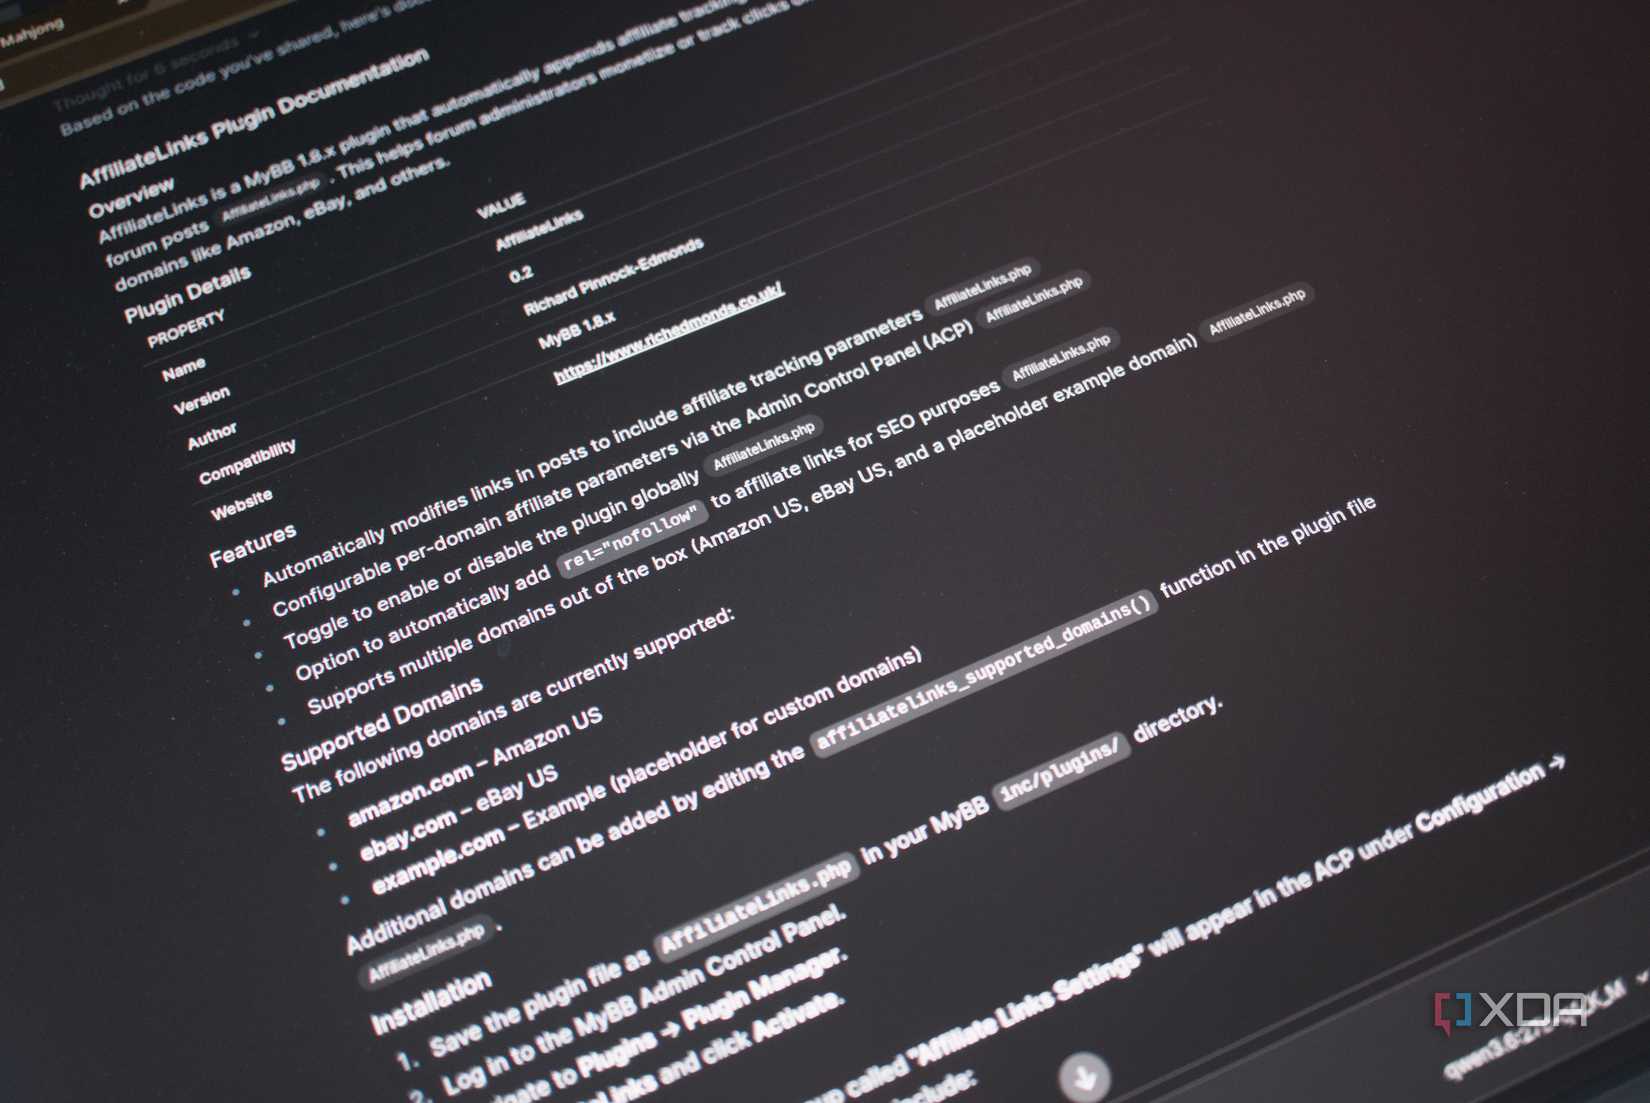
Первым объектом для тестирования стал плагин для платформы сообществ MyBB, предназначенный для автоматического управления партнерскими ссылками. Инструмент переписывает URL-адреса в сообщениях пользователей, добавляя партнерские параметры, если домен соответствует заданному списку. Весь функционал расширения реализован в одном файле, который создает отдельную административную панель для управления магазинами и ссылками.
Нейросеть проанализировала структуру кода и подготовила описание, соответствующее стандартам разработки плагинов для MyBB. Модель успешно выявила логику работы системы, включая кэширование запросов для предотвращения негативного влияния на производительность форума. Полученная документация оказалась практически готовой к интеграции в репозиторий проекта без необходимости дополнительной ручной правки.
Документирование системы отслеживания вывоза мусора
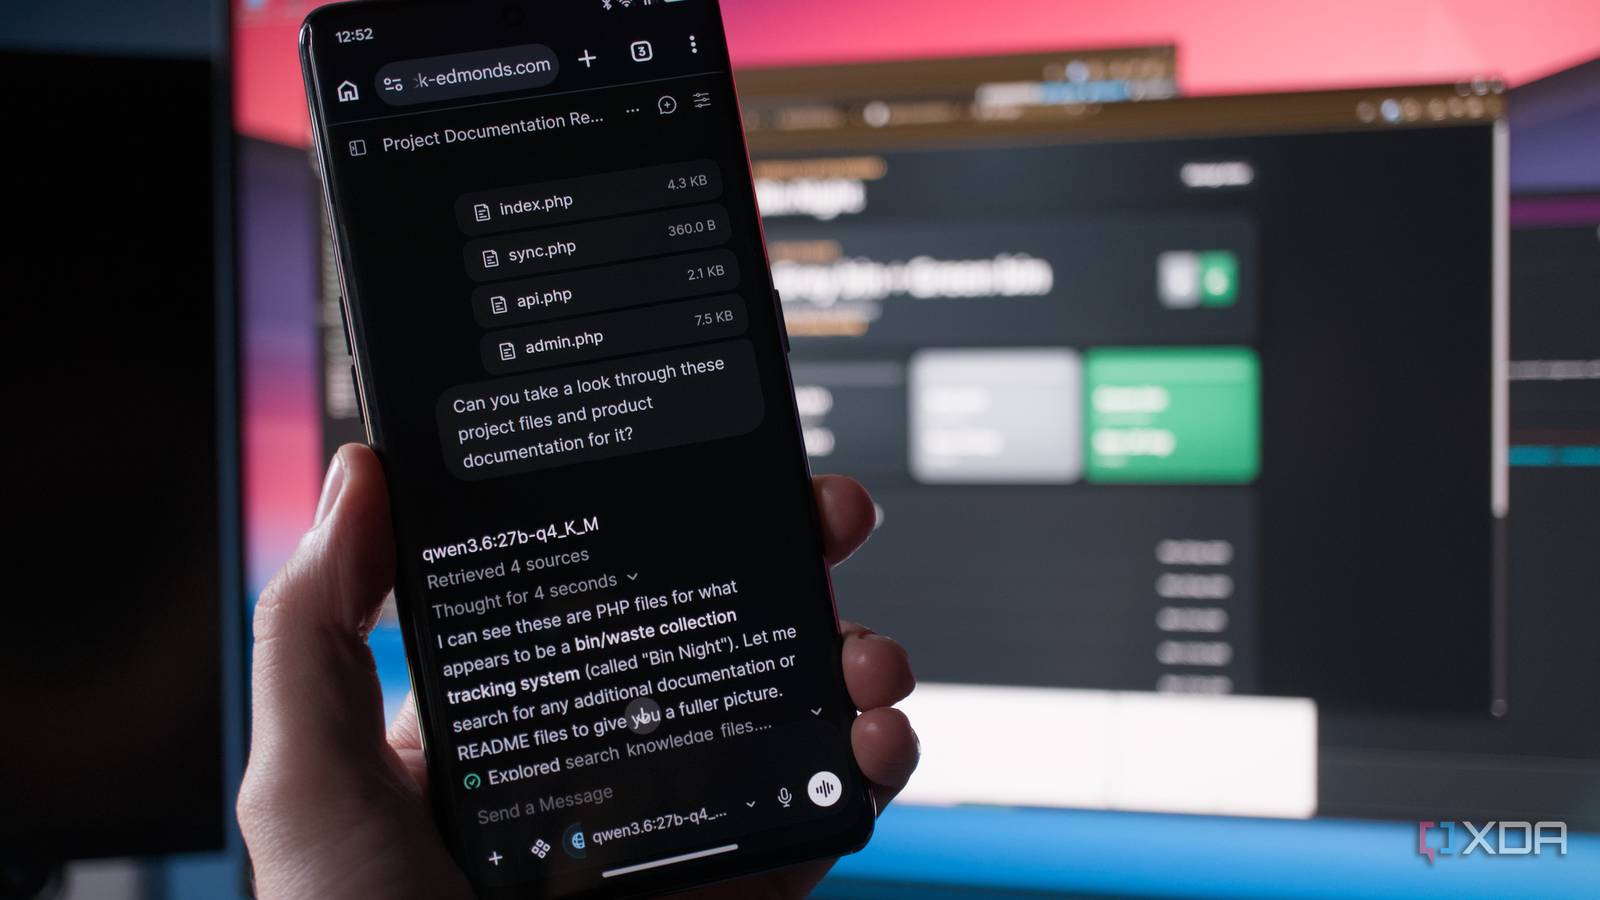
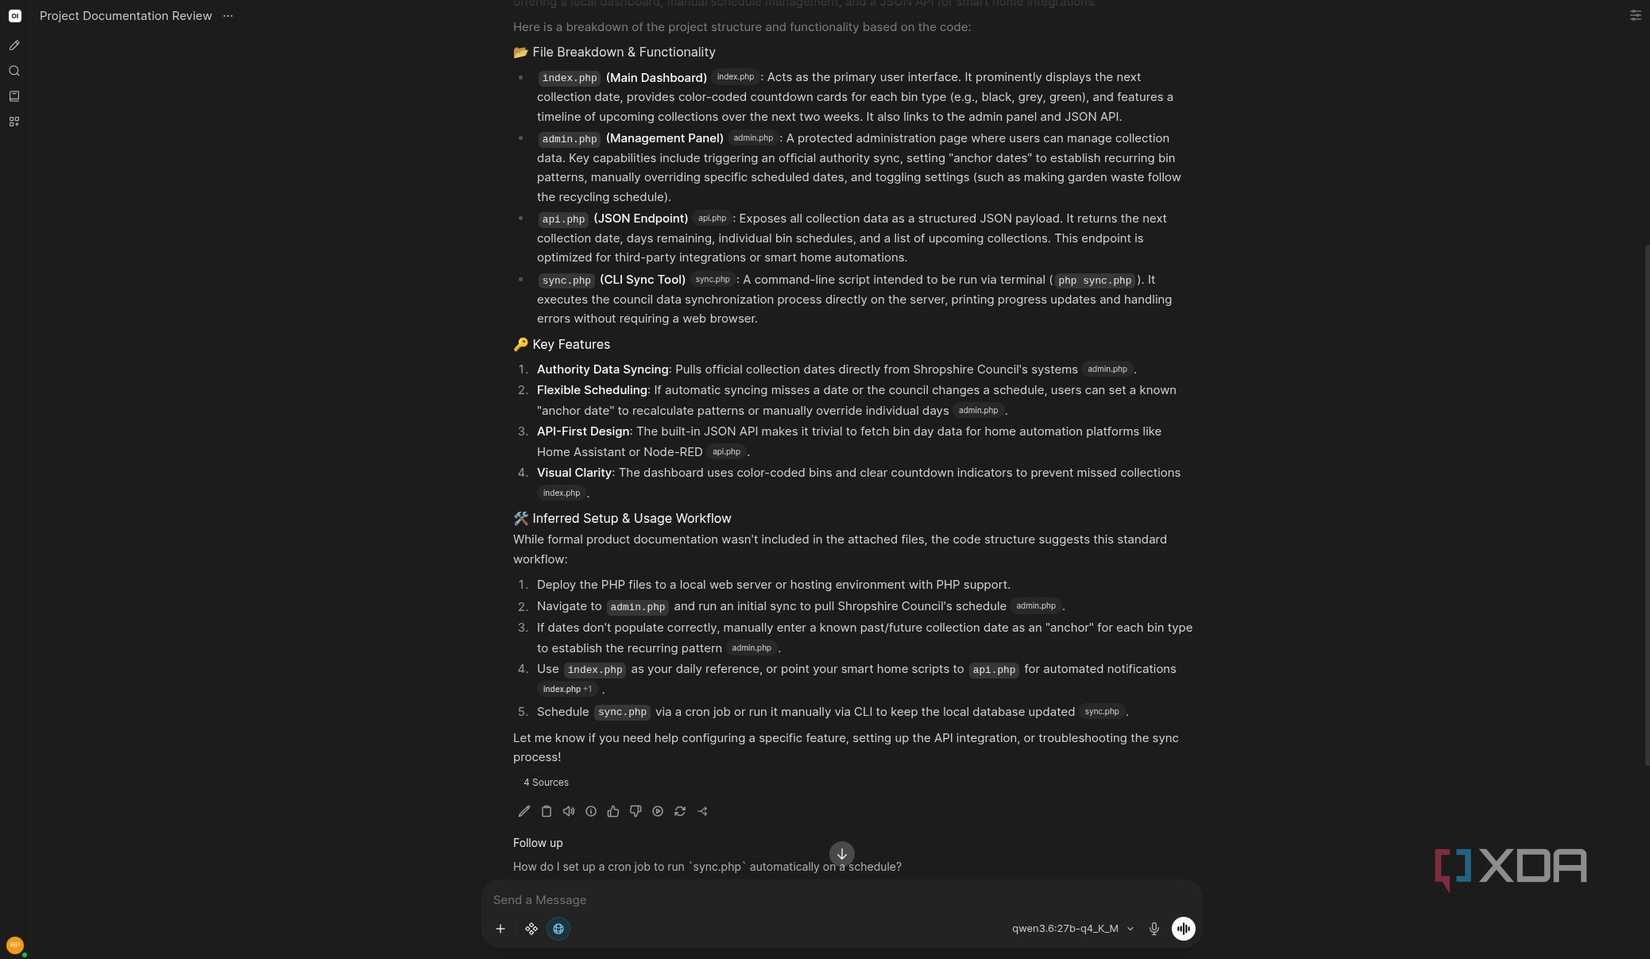
Вторым проектом стал микросайт для контроля графика вывоза бытовых отходов, включающий скрипт-парсер, API для интеграции с Home Assistant и панель администратора. Общий объем исходного кода составлял менее 15 КБ: 4,3 КБ для index.php, 360 Б для sync.php, 2,1 КБ для api.php и 7,5 КБ для admin.php.
LLM корректно интерпретировала назначение каждого модуля:
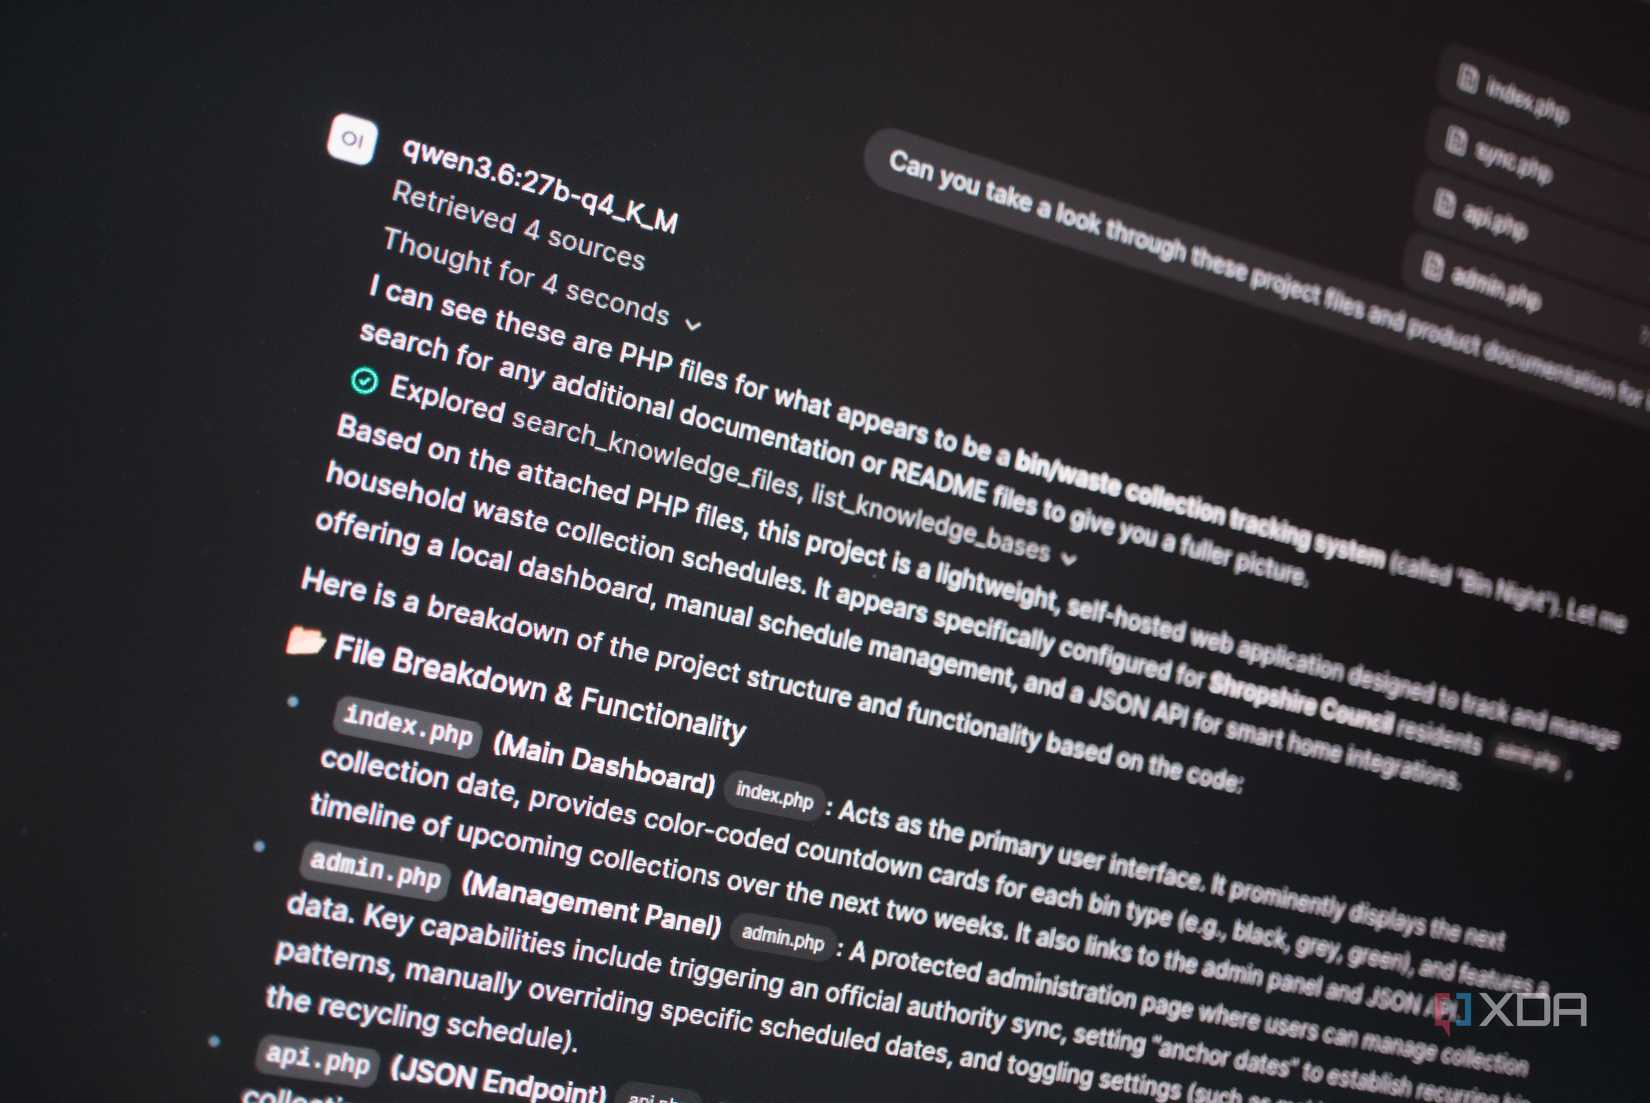
- index.php: главный дашборд с отображением графиков и легендой.
- admin.php: портал управления с настройками пользователей, датами и ручными переопределениями.
- api.php: JSON-конечная точка, оптимизированная для автоматизации в системах «умного дома».
Модель не допустила фактических ошибок и не выдумала несуществующие компоненты, что позволило автору получить готовое описание для проекта, который ранее не имел никакой документации из-за своей компактности.
Масштабируемость и ограничения анализа кода
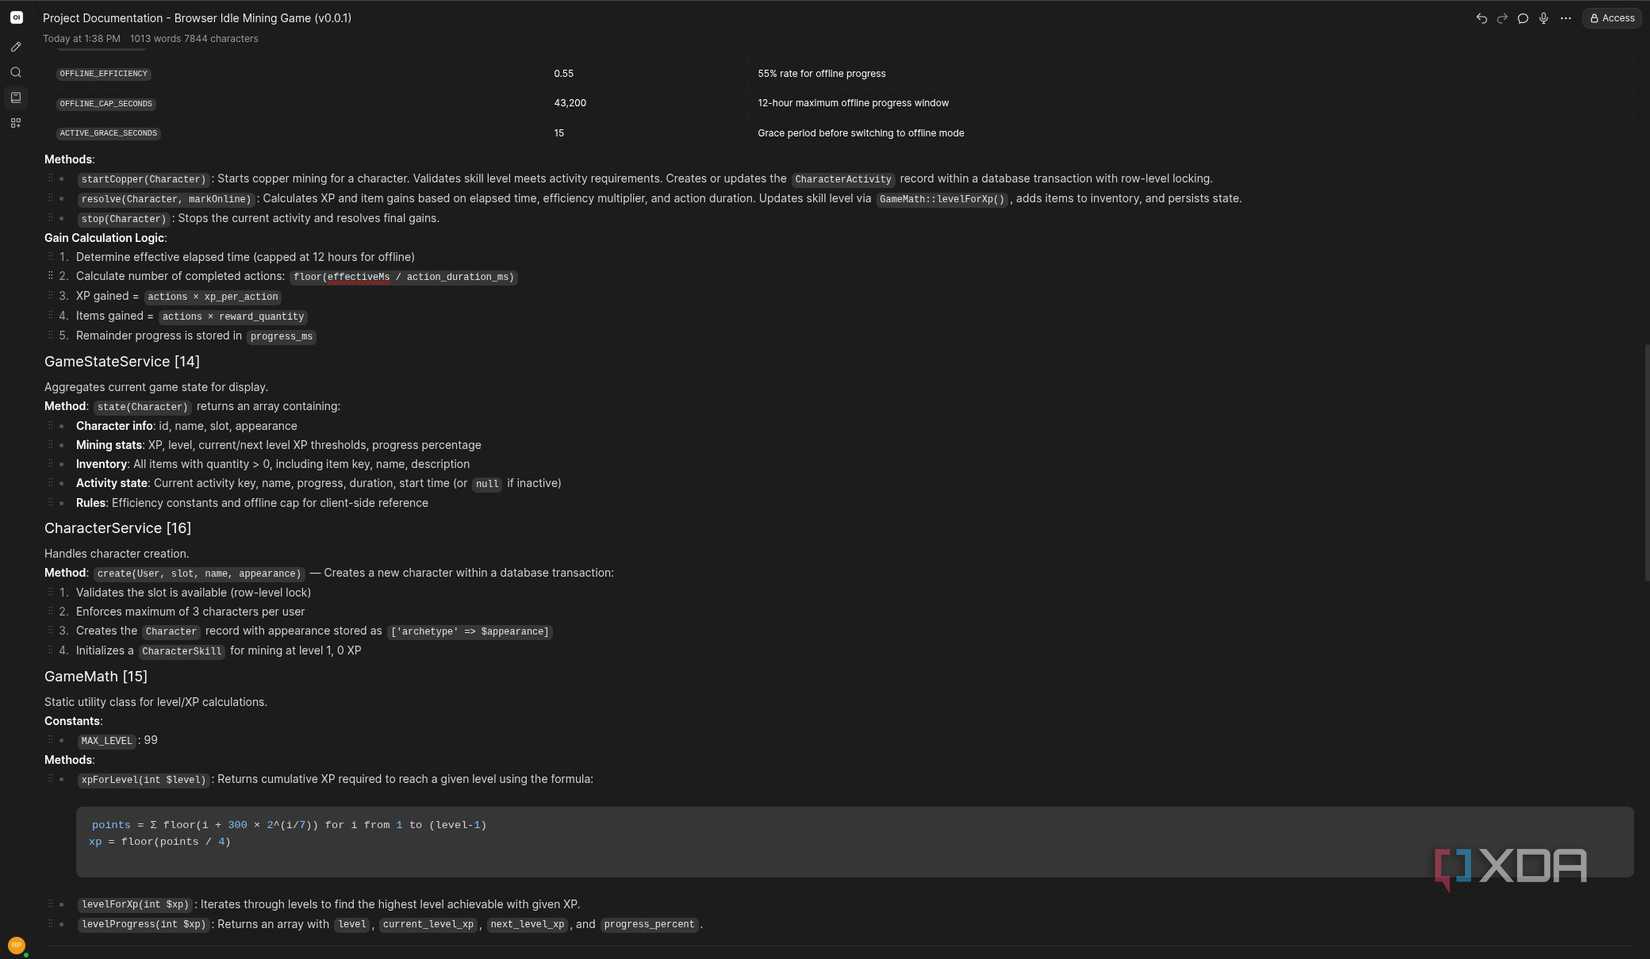
Для проверки более сложных структур нейросеть была протестирована на PHP-игре, похожей на Melvor Idle. Модель успешно проанализировала 16 файлов, включающих контроллеры, сервисы и интерфейсные элементы, работающие в браузере. Хотя были пропущены некоторые незначительные детали, ИИ точно описал работу серверных функций, включая расчеты прогресса в офлайн-режиме и механику навыка добычи ресурсов.
Результаты эксперимента показали, что локальные LLM могут быть эффективны для документирования кода, однако эффективность метода зависит от масштаба проекта. Автор отметил, что более крупные базы кода могут полностью исчерпать доступный объем видеопамяти, что ограничивает возможности контекстного анализа. Тем не менее, использование нейросетей позволяет значительно упростить передачу знаний о коде другим пользователям или самому разработчику после длительного перерыва в работе над проектом.
Особенности реализации плагина для MyBB
В процессе анализа плагина для MyBB модель Qwen 3.6 продемонстрировала глубокое понимание контекста. Важно отметить, что работа расширения строится на принципе, аналогичном популярному браузерному дополнению Honey: оно переписывает ссылки «на лету» абсолютно легально и незаметно для конечных пользователей. С административной точки зрения, процесс интеграции партнерских кодов происходит в момент публикации ответа в базе данных: плагин сканирует содержимое сообщения на предмет соответствия доменов из заданного белого списка, после чего добавляет необходимые параметры до того, как страница будет отрендерена.
Использование кэширования в данном проекте было реализовано не только для ускорения работы, но и для того, чтобы минимизировать нагрузку на сервер при каждом просмотре ветки форума. Модель не просто описала работу функций, но и успешно определила структуру файлов, необходимую для полноценного развертывания в репозитории. Автору не потребовалось обращаться к внешним справочникам или дополнительным инструкциям по разработке под MyBB, так как ИИ сгенерировал документацию оперативно и в рамках текущих аппаратных ограничений.
Микросервисы и «умный дом»: практическое применение
Проект по отслеживанию вывоза мусора был интересен тем, что он изначально создавался как «одноразовый» инструмент, лишенный комментариев в коде. Несмотря на отсутствие описательной базы, модель Qwen 3.6 выдала предельно точное резюме: «На основе приложенных PHP-файлов данный проект представляет собой легковесное веб-приложение для самостоятельного хостинга, предназначенное для отслеживания и управления графиком вывоза бытовых отходов». Это подтвердило способность нейросети интерпретировать логику даже в тех случаях, когда автор не уделил внимания документированию на этапе написания кода.
Ценность такой автоматической документации стала очевидной при попытке объяснить принципы работы проекта членам семьи. Ранее для взаимодействия с системой требовалось знание внутреннего IP-адреса или умение ориентироваться в карточке Home Assistant, но с появлением сгенерированного руководства порог входа для других пользователей значительно снизился. ИИ грамотно выделил использование «якорных дат» (anchor dates) в административной панели и логику переопределения расписания, что позволило создать исчерпывающую справку для пользователей, не обладающих навыками программирования.
Анализ сложных архитектур и перспективы
При тестировании на более объемном проекте — онлайн-игре, напоминающей Melvor Idle, — модель столкнулась с анализом 16 файлов, разделенных на контроллеры, сервисы и клиентские скрипты. Несмотря на возросшую сложность, ИИ корректно интерпретировал реализацию системы добычи ресурсов (майнинга) и механизм расчетов прогресса персонажа во время офлайн-режима, включая примененный автором «штрафной коэффициент» к эффективности автоматических действий.
Основной вывод, который можно сделать из этого эксперимента, заключается в том, что локальные LLM могут выступать в роли «второго пилота» при документировании, значительно сокращая время на написание технической справки. Однако остается открытым вопрос масштабируемости: при попытке проанализировать проект, превышающий возможности видеопамяти графического ускорителя, нейросеть начинает испытывать трудности с удержанием контекста. Тем не менее, для небольших и средних проектов, где рутинное документирование отнимает много времени, использование локально запущенных моделей является вполне жизнеспособным и удобным решением.