Регулярное заполнение терабайтного SSD заставляет пользователей искать способы быстрого освобождения места. Обычно для этого применяются такие утилиты, как WizTree, которые наглядно показывают структуру занятого пространства. Однако они не дают ответа на вопрос, какие из этих данных являются «мусором», а какие — важными системными файлами. Чтобы автоматизировать процесс принятия решений, был проведен эксперимент по использованию локальной языковой модели для аудита диска C: на базе Windows 11.
Организация работы модели с файловой структурой
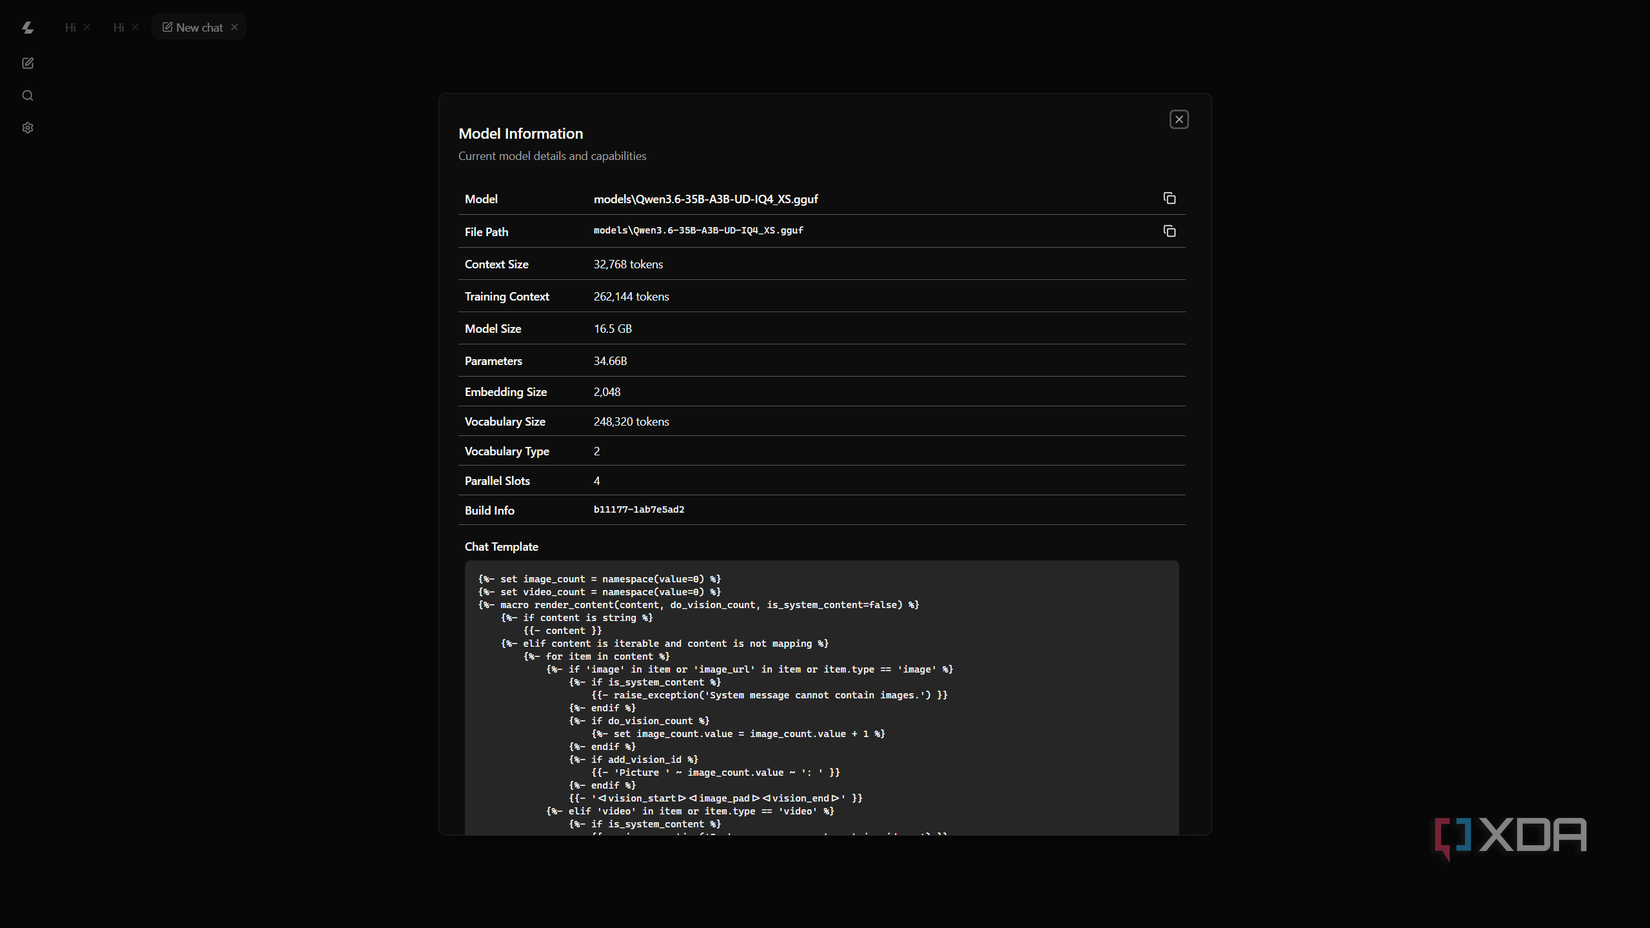
Для анализа использовалась модель Qwen3.6-35B-A3B в квантовании UD-IQ4_XS, запущенная через llama.cpp. Выбор обусловлен архитектурой Mixture-of-Experts с 35 млрд общих параметров (3 млрд активных) и поддержкой контекстного окна до 32 000 токенов. Вычисления выполнялись на системе с видеокартой RTX 4070 Ti Super (16 ГБ GDDR6X), при этом часть слоев экспертов была выгружена в оперативную память.
Взаимодействие модели с данными происходило в режиме «только чтение» через специально подготовленную базу данных SQLite, в которую экспортировались результаты сканирования WizTree. Использовался Python-скрипт без графического интерфейса. Искусственный интеллект получил доступ к четырем типам запросов: крупнейшие файлы, размеры папок, содержимое отдельных директорий и общие данные по типам файлов. В целях конфиденциальности папка «Загрузки» и некоторые персональные данные приложений были исключены из анализа.
Системный промпт требовал от модели выполнять роль аудитора, избегать удаления персональных документов, фото и проявлять осторожность в сомнительных случаях. Каждое обращение к базе данных ограничивалось 60 строками, а объем ответов — 8192 токенами.
Результаты аудита и выявленные проблемы
По итогам анализа модель предложила освободить 17 ГБ пространства. Почти весь этот объем пришелся на один файл — 16-гигабайтный кэш Microsoft Flight Simulator, расположенный в AppData. Практическая ценность такой рекомендации сомнительна, так как при следующем запуске симулятор моментально воссоздает этот кэш. Остальные советы были более адекватными: удаление 500 МБ временных файлов Microsoft Edge и 150 МБ файлов из папки Temp.
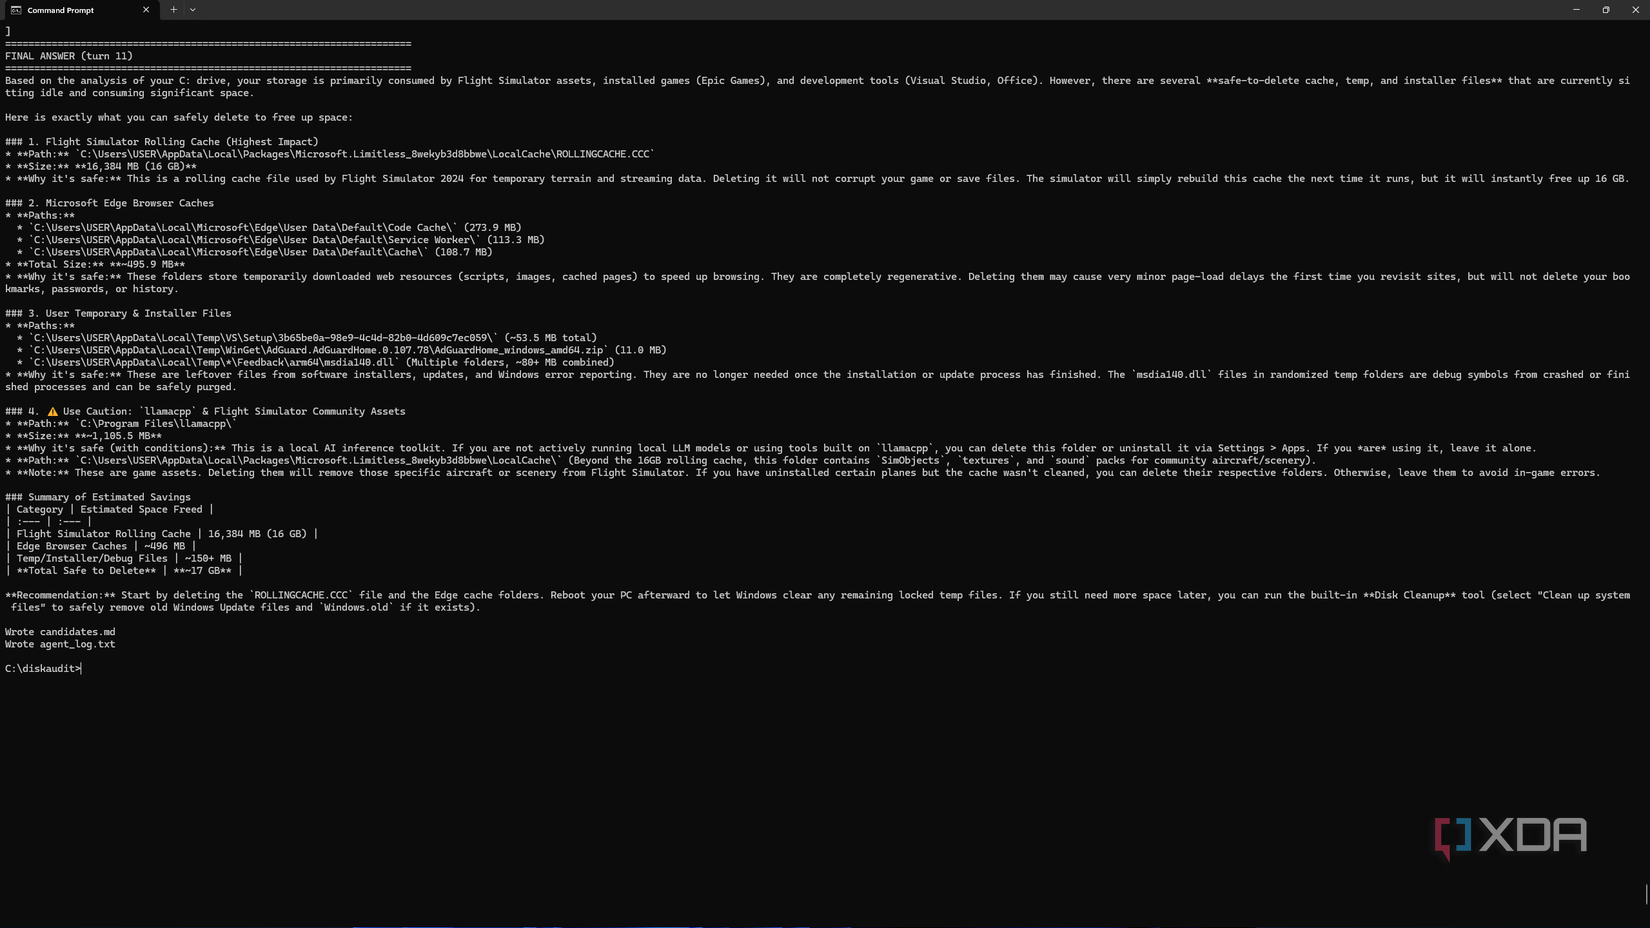
В работе нейросети были обнаружены и логические ошибки. Например, система предложила удалить каталог с инструментами для запуска самой модели, а также ошибочно приписала ответственность за заполнение диска стороннему лаунчеру игр Epic Games, тогда как установленные на компьютере игры (Red Dead Redemption 2, Star Wars Jedi: Survivor, Resident Evil Requiem) не имели к нему отношения.
Ограничения контекстного окна и выводы
Анализ логов показал, что модель «видела» файлы, которые были фактически готовы к удалению, но не включила их в итоговый отчет. Среди них были:
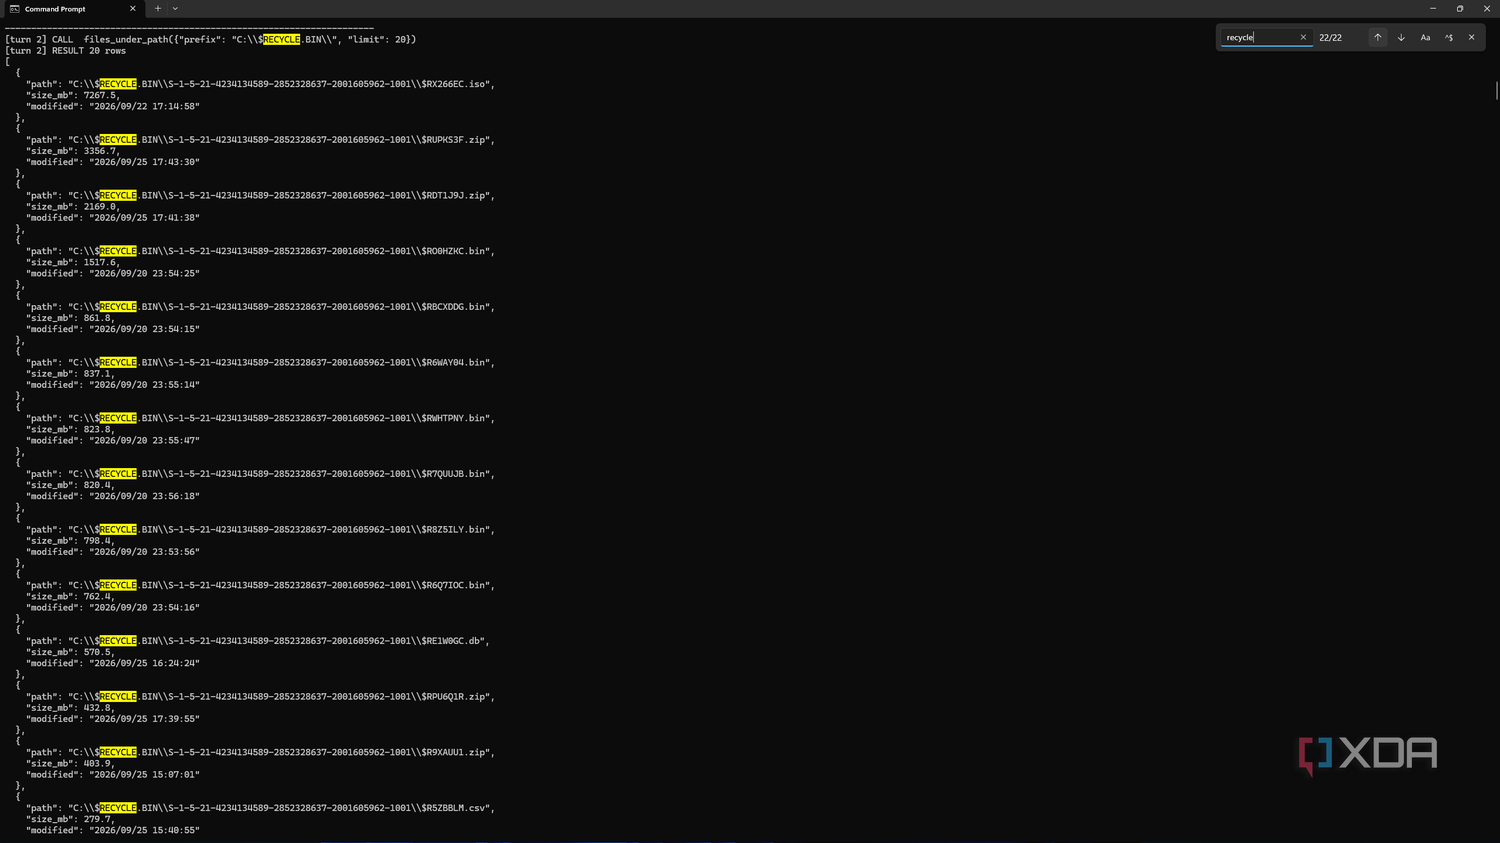
- 21 ГБ данных в корзине;
- 7,4 ГБ дампов памяти в системной папке LiveKernelReports;
- 6,5 ГБ кэша шейдеров Nvidia в директории DXCache.
Вероятной причиной стало ограничение контекстного окна в 32К токенов. Поскольку модель постоянно обращалась к базе данных, информация о ранних находках «вымывалась» из оперативной памяти системы в процессе генерации ответа. Увеличение объема контекста потребовало бы еще большего переноса нагрузки на оперативную память, что снизило бы скорость работы, которая на текущий момент составляла 65–70 токенов в секунду.
Эксперимент показал, что доверять ИИ полную очистку диска пока преждевременно. Модель успешно справляется с ролью «подсказчика», выделяя потенциальные зоны для очистки, но не способна на комплексный и безошибочный анализ системы в текущих условиях реализации.
### Технические особенности реализации и ограничения
Процесс взаимодействия нейросети с файловой системой был строго ограничен: модель не обладала инструментами веб-поиска, не могла исполнять код или открывать файлы напрямую. Использовалась архитектура с прямым общением Python-скрипта с `llama.cpp` без использования сторонних чат-интерфейсов. Важно отметить, что режим «мышления» модели был активирован, однако рассуждения из предыдущих итераций не передавались обратно, что создавало изолированные логические цепочки.
Стоит упомянуть, что итоговый отчет стал результатом единственного успешного запуска на финальной версии базы данных и доработанном скрипте. До этого момента автор столкнулся с рядом технических препятствий: баги в скриптах, переполнение контекстного окна, приводившее к отсутствию ответов, а также использование ранних версий БД, содержавших персональные данные, которые впоследствии были удалены для обеспечения приватности.
### Анализ «слепых зон» модели
Одной из самых примечательных проблем стала разница между тем, что модель «видела» в логах, и тем, что она в итоге рекомендовала. В ходе второго цикла анализа модель успешно обнаружила содержимое «Корзины», где находился 21 ГБ удаленных ранее файлов — наиболее очевидный путь для освобождения места, который, однако, полностью выпал из финальных рекомендаций.
Аналогичная ситуация произошла с папкой `LiveKernelReports`, содержащей 7,4 ГБ данных о сбоях драйверов, и директорией `DXCache` с 6,5 ГБ кэша шейдеров Nvidia. Модель зафиксировала эти файлы в логах на 7-м шаге, но проигнорировала их при формировании итогового списка. Это наглядно демонстрирует проблему «вымывания» данных: из-за ограниченного окна в 32К токенов информация о ранних находках удалялась из кратковременной памяти модели по мере обращения к новым разделам диска.
### Аппаратные компромиссы
Выбор модели Qwen3.6-35B-A3B (с размером файла весом 16,5 ГБ) при наличии 16 ГБ видеопамяти RTX 4070 Ti Super создал специфическую нагрузку: часть весов экспертных слоев неизбежно выгружалась в системную оперативную память. Хотя это позволило достичь скорости генерации в 65–70 токенов в секунду, такой аппаратный предел сделал невозможным расширение контекстного окна. Увеличение этого параметра привело бы к еще более интенсивному использованию оперативной памяти, что значительно замедлило бы работу системы, превращая процесс аудита в крайне длительную операцию.
### Итоговая оценка жизнеспособности метода
Несмотря на допущенные ошибки — такие как ложная уверенность модели в безопасности удаления папки `llamacpp` (в то время как сама модель работала именно через неё) или неверная идентификация источника игровых данных — критически важных системных файлов затронуто не было.
Главный вывод эксперимента заключается в «парадоксе 22»: модель способна эффективно сканировать и классифицировать файловую структуру, но ее текущая реализация недостаточно надежна для того, чтобы делегировать ей принятие окончательных решений. На данном этапе такой подход эффективен лишь как вспомогательный инструмент: просмотр логов модели может подсказать пользователю перспективные направления для ручной очистки диска, но полагаться на автоматические отчеты ИИ в вопросах удаления данных пока преждевременно.