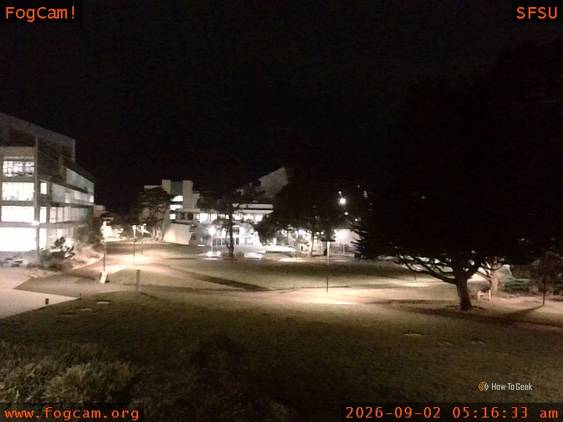
FogCam — проект Университета штата Сан-Франциско, стартовавший в 1994 году, считается старейшей в мире постоянно работающей веб-камерой. Несмотря на десятилетия функционирования, проект не создавал визуальный архив: в отличие от систем видеонаблюдения или фотохостингов, FogCam транслировала только актуальное изображение, перезаписывая предыдущий файл при каждом обновлении. В результате все кадры, кроме текущего, считались утраченными, если их не сохранял кто-то из пользователей.
Роль Wayback Machine в восстановлении визуальной хроники
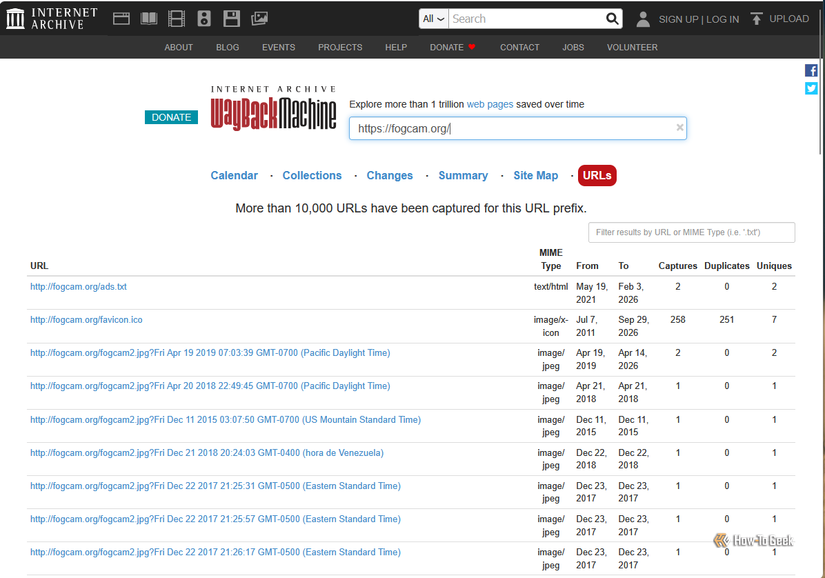
Сервис Internet Archive, известный как Wayback Machine, периодически сканирует веб-страницы и сохраняет снимки контента, с которым сталкиваются его роботы-индексаторы. FogCam не стала исключением, и за годы работы архиваторы неоднократно фиксировали изображение, которое транслировала камера в момент визита «паука». Хотя эти файлы не были собраны в единую галерею и были разбросаны по календарю Wayback Machine, они продолжали существовать независимо от работы официального сайта.
Использование CDX-индекса для поиска данных
Основой Wayback Machine является индекс CDX, который хранит метаданные о каждой зафиксированной странице или файле, включая URL, время захвата, тип контента и цифровой отпечаток (дайджест). Вместо того чтобы просматривать архивы через интерфейс Wayback Machine, можно обратиться напрямую к CDX-индексу для поиска конкретного файла. Пользователь Reddit применил этот метод для поиска всех версий изображения под именем fogcam2.jpg. Полученные результаты представляли собой необработанные данные, позволяющие напрямую открывать заархивированные JPEG-файлы за разные периоды.
Восстановление 85 уникальных снимков за 21 год
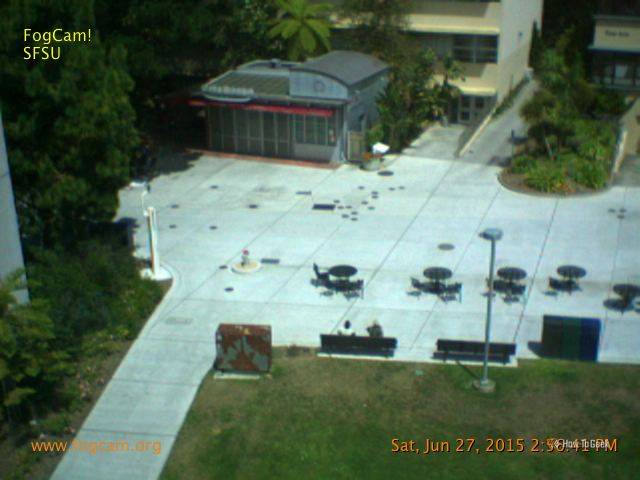
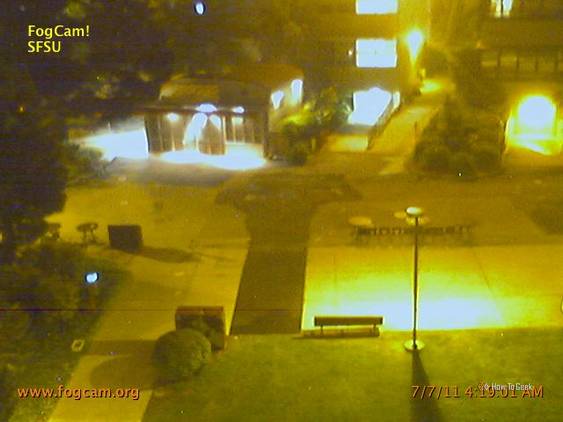
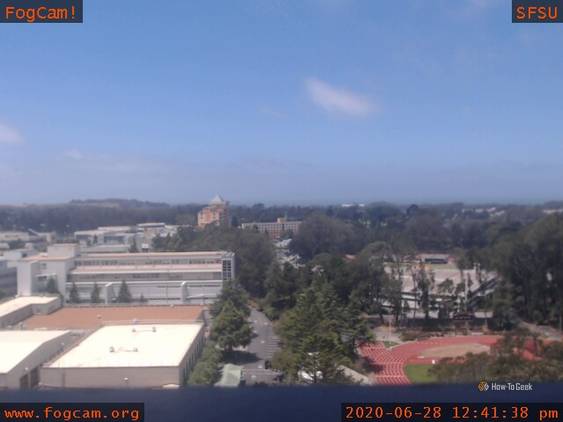
После удаления дубликатов энтузиаст получил коллекцию из 85 уникальных снимков. Эти кадры охватывают период с октября 2005 года по июнь 2026 года, что позволяет проследить изменения, происходившие на территории кампуса Университета штата Сан-Франциско на протяжении почти 21 года. Хотя хроника не является полной и некоторые временные отрезки представлены лишь парой снимков, коллекция демонстрирует эволюцию проекта. Поскольку камеру периодически перемещали в разные части кампуса, изображения показывают не статичный вид, а меняющиеся ракурсы университетской жизни, создавая своеобразный визуальный дневник, который многие считали безвозвратно утерянным.
Метод поиска для других исчезающих файлов
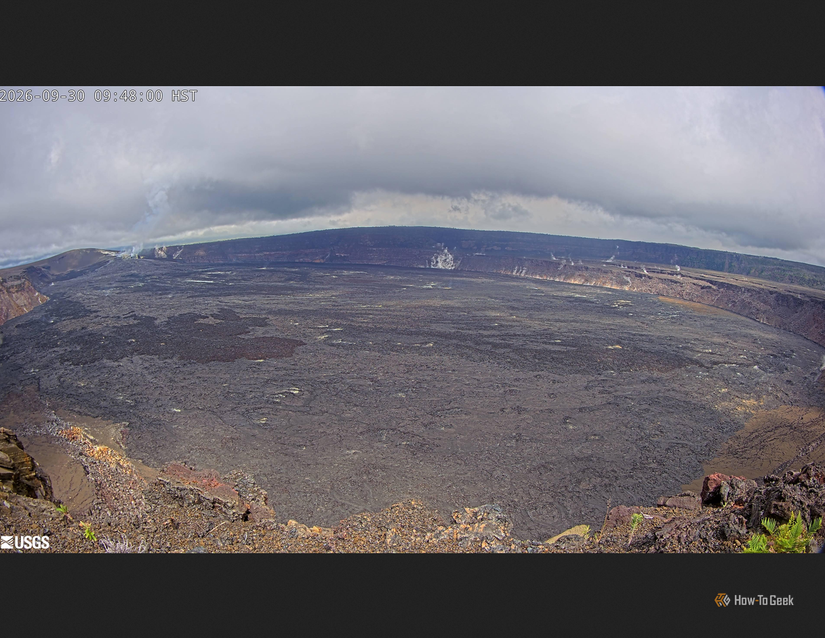
Технология поиска по CDX-индексу применима не только к FogCam. Многие веб-ресурсы используют один и тот же URL для трансляции обновляемого контента — например, веб-камера вулкана Шишалдин (USGS) передает текущее изображение через файл current.jpg. При каждом обновлении старая версия файла перезаписывается. Однако, если роботы Wayback Machine сканировали этот URL в разные моменты времени, старые версии могут храниться в архиве. Этот метод эффективен для поиска не только изображений, но и PDF-документов или файлов для скачивания, которые регулярно заменяются новыми версиями по тому же адресу. Кейс FogCam доказывает, что в архиве может скрываться гораздо больше информации, чем доступно через стандартный интерфейс просмотра сайтов, и многие файлы, кажущиеся исчезнувшими, все еще ожидают своего открытия.
Особенности индексации и роль роботов
Важно понимать, почему визуальная история не была сформирована автоматически. Алгоритмы Internet Archive работают по принципу периодического сканирования: робот «обходит» заданные ресурсы и сохраняет текущее состояние страницы или конкретного файла. FogCam не была исключением, однако процесс сохранения был фрагментарным. Это означает, что далеко не каждое изображение, когда-либо показанное камерой, попало в хранилище. Более того, случалось так, что роботы индексировали сайт несколько раз подряд, когда изображение на нем еще не обновлялось — в таких случаях в архиве появлялись дубликаты. Однако даже эти избыточные данные оказались полезными, так как каждое событие обращения к серверу фиксировалось в CDX-индексе.
Техническая сторона работы с CDX
CDX-индекс — это не просто список ссылок, это структурированная база данных, которая содержит технические параметры каждой «замороженной» копии: от статуса HTTP-ответа (например, кода 200 OK) до уникального цифрового дайджеста файла. Когда энтузиаст с Reddit занялся восстановлением истории FogCam, он не занимался ручным перебором дат в календаре Wayback Machine, что было бы крайне неэффективно. Вместо этого он совершил прямой запрос к CDX-индексу по конкретному пути — fogcam2.jpg. Система выдала «сырую» выборку всех состояний файла, которые когда-либо были захвачены индексатором. Имея на руках список временных меток (timestamps) и прямые ссылки на JPEG-файлы, исследователь смог восстановить последовательность кадров, которые не были связаны между собой никаким иным способом, кроме общего имени файла.
Визуальное наследие как «коробка старых снимков»
Полученная в результате выборка из 85 уникальных кадров — это не хронологически выверенный таймлапс, а скорее случайный срез событий. Это напоминает поиск старой коробки с фотографиями на чердаке: некоторые годы представлены лишь парой случайных моментов, тогда как в другие периоды роботы архива были более активны, что обеспечило высокую плотность снимков. Смена ракурсов, обусловленная периодическими перемещениями камеры по территории кампуса, превращает этот набор данных в уникальный исторический документ. Мы видим не монотонный поток одного и того же статичного вида, а живую эволюцию университетской среды: меняющиеся постройки, ландшафт и атмосферу Сан-Франциско на протяжении более чем двух десятилетий.
Глобальный потенциал метода
Метод, примененный к FogCam, открывает возможности для поиска данных, которые «скрываются» за фасадом современных сайтов. Принцип постоянного обновления одного и того же файла (будь то current.jpg, PDF-отчет или свежая версия драйвера) — стандарт для веб-разработки. Инструменты Wayback Machine позволяют «пробить» эту стену из актуального контента. Стоит помнить, что если поисковые роботы когда-либо посещали страницу, все исторические итерации файла, скорее всего, остались в архиве. Таким образом, CDX-индекс превращается из технического лога в инструмент археологии данных. Подобный подход доказывает: интернет забывает гораздо меньше, чем кажется на первый взгляд, — файлы, которые мы считаем безвозвратно удаленными при очередном обновлении сайта, зачастую все еще ожидают своего открытия в недрах хранилища, достаточно лишь знать правильный способ обращения к их индексам.