Независимо от вашего личного отношения к генеративному искусственному интеллекту, многие энтузиасты активно используют чат-боты, такие как ChatGPT и Claude, при разработке решений для умного дома. С каждым днем вероятность того, что часть кода, функционирующего в вашей системе, была создана или дополнена нейросетями, становится всё выше.
Почему Home Assistant стал идеальной средой для использования ИИ
В отличие от закрытых экосистем вроде Alexa, где установка стороннего кода пользователями затруднена, открытые системы, такие как Home Assistant, предоставляют гораздо больше свободы. Эта платформа отлично подходит для так называемого «vibe coding», поскольку многие компоненты здесь представляют собой небольшие автономные конфигурационные файлы, а не полноценные приложения, требующие написания с нуля.
В интернете доступно огромное количество примеров кода, документации и проектов на GitHub, что позволяет искусственному интеллекту успешно генерировать рабочие решения. Будь то простая автоматизация для включения света при входе в комнату или сложный аддон, например Music Assistant, инструменты на базе ИИ способны эффективно помогать в достижении поставленных задач.
Сложности идентификации ИИ-контента
На текущий момент не существует гарантированного способа определить, был ли конкретный интеграционный модуль или кастомный компонент написан с помощью алгоритмов. Вы можете изучить исходный код самостоятельно, однако далеко не всегда очевидно, кем он создан: человеком, человеком при поддержке ИИ или полностью нейросетью. Некоторые разработчики открыто сообщают об использовании нейросетей, однако это скорее исключение, чем правило.
Более того, зачастую существует стимул скрывать факт участия ИИ. В обсуждениях на профильных ресурсах, например на Reddit, отмечались случаи, когда два почти идентичных проекта получали разную реакцию сообщества в зависимости от прозрачности автора. Тот проект, где факт использования ИИ был скрыт в репозитории GitHub, вызывал больше доверия, чем тот, автор которого честно признался в применении инструментов автоматизации.
Официальная позиция Open Home Foundation
Сам проект Home Assistant не запрещает использование ИИ для создания кода. В июле 2026 года Open Home Foundation опубликовала официальную политику в отношении ИИ, согласно которой ответственность за итоговый результат полностью лежит на человеке-разработчике. Вкладчики обязаны изучить и полностью понять предоставляемый код перед его отправкой в репозиторий.
Таким образом, использование ИИ не является препятствием для участия в разработке, если автор провел ревью и готов обосновать внесенные изменения. Вывод алгоритмов без предварительной проверки приниматься не будет, но сама технология не исключается из процесса. Такой подход считается наиболее прагматичным: полностью запретить ИИ-код практически невозможно, и если разработчик создает рабочий продукт с помощью нейросетей, это не несет вреда экосистеме.

Как относиться к коду, созданному нейросетями
Если вы рассчитываете использовать исключительно написанный человеком код, реализовать это на практике становится всё труднее. Даже при обновлении стандартных интеграций в них могут появляться фрагменты, сгенерированные ИИ. Важно понимать, что наличие алгоритмической помощи не всегда делает код плохим.
Существует немало примеров некачественного кода, написанного людьми без должной квалификации, который может уступать результатам работы современных ИИ-инструментов. Лучший подход — оценивать проект по его содержанию и авторитетности разработчика. Если решение активно развивается экспертом, который понимает структуру своей работы, использование ИИ в процессе не должно быть поводом для автоматического отказа. Доверять стоит тем проектам, авторы которых имеют подтвержденный опыт и хорошую репутацию.
В конечном итоге, ИИ-инструменты стали неотъемлемой частью разработки, позволяя быстрее и проще создавать сложные продукты. Выбор того, какому коду доверять, остается за конечным пользователем, независимо от инструментов, которые применялись при его создании.
Почему Home Assistant — это идеальная площадка для «vibe coding»
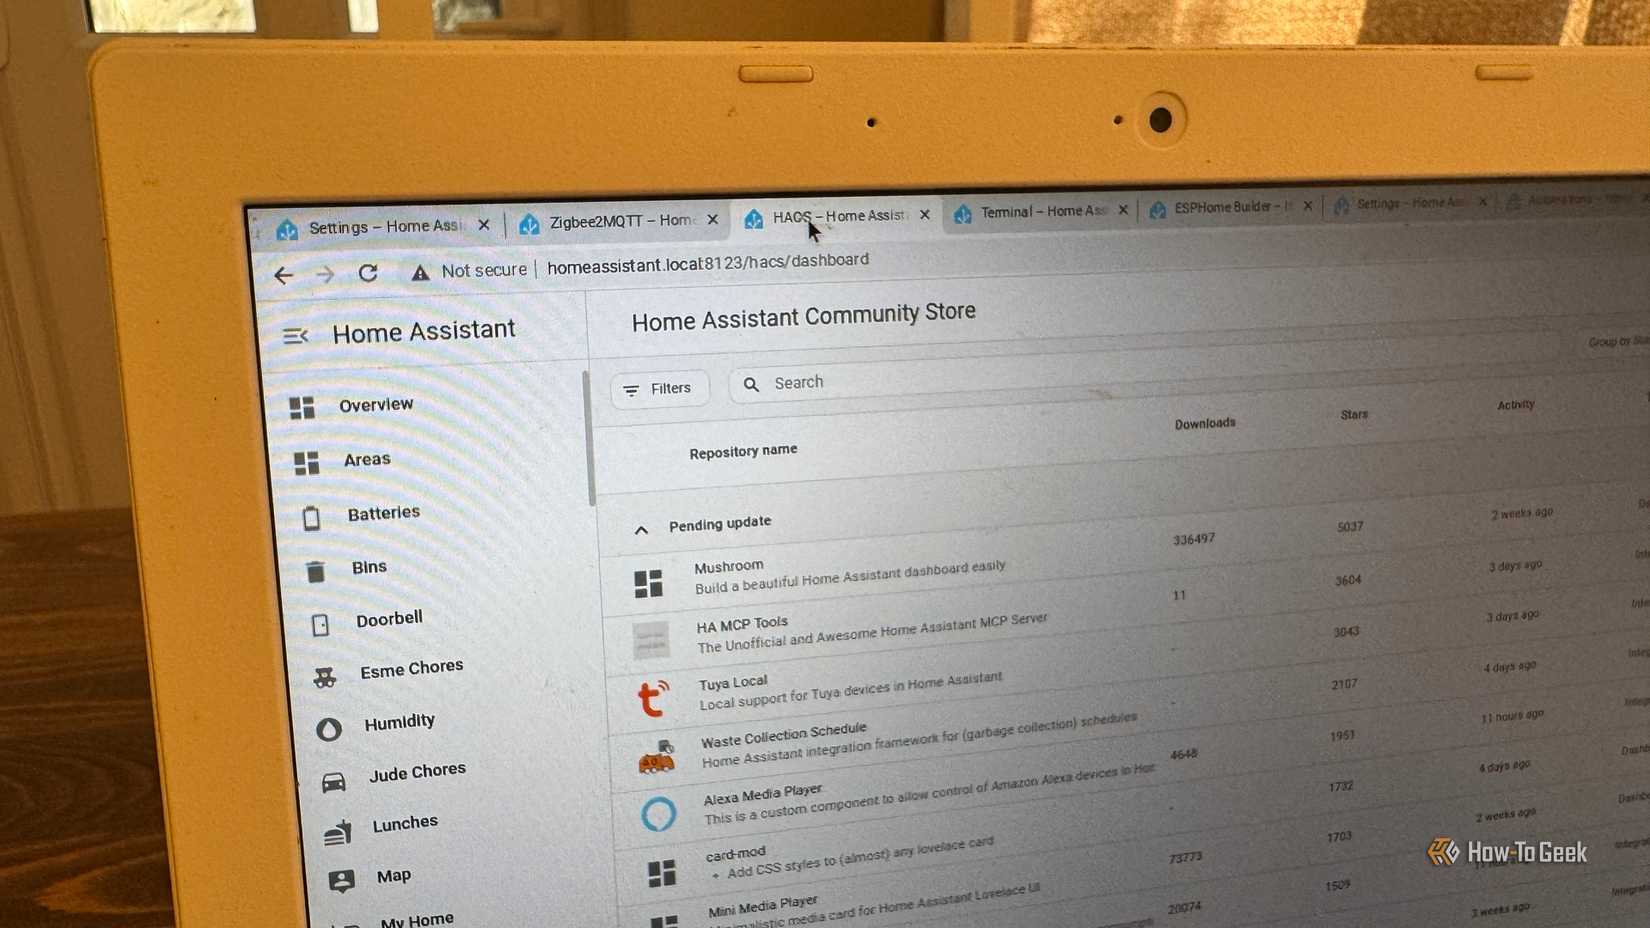
Термин «vibe coding» (программирование «по настроению» или «по ощущениям») как нельзя лучше описывает процесс создания автоматизаций в Home Assistant с помощью нейросетей. Поскольку архитектура платформы опирается не на монолитные приложения, а на набор дискретных, самодостаточных конфигурационных файлов, ИИ проще оперировать ими, не вникая в структуру всей кодовой базы целиком. Благодаря доступности огромных массивов обучающих данных на GitHub, документации и примеров, накопленных сообществом, модели типа Claude или ChatGPT способны генерировать работающие скрипты «на лету». Это избавляет пользователя от необходимости глубокого погружения в синтаксис YAML или Python, позволяя сосредоточиться на реализации конкретной идеи — от простейшего сценария включения света при детекции присутствия до создания более амбициозных надстроек (аддонов), таких как Music Assistant.
Проблема «стимула к сокрытию»
Ситуация с раскрытием использования ИИ в разработке имеет неожиданный социальный подтекст. На тематическом сабреддите Home Assistant был поднят важный вопрос: почему авторы стали скрывать применение нейросетей? Анализ двух практически идентичных проектов показал, что отношение сообщества напрямую зависит от честности автора. Разработчик, открыто заявивший о помощи ИИ, столкнулся с волной скепсиса, в то время как аналогичный проект, где использование нейросетей было «запрятано» внутри репозитория, получил значительно более теплый прием. Этот парадокс создает негласный стимул для разработчиков маскировать ИИ-код под «ручную работу», опасаясь предвзятого отношения со стороны пользователей, которые по умолчанию считают нейросетевой контент менее надежным.
Прагматизм против «ИИ-мусора»
В вопросе доверия к коду важно разделять технологию и результат. Существует расхожее мнение, что всё, созданное ИИ, — это «мусор». Однако стоит признать: в мире open-source огромное количество «мусора» создается и самими людьми — зачастую новичками, которые не обладают достаточной компетенцией. В этом контексте код, сгенерированный нейросетью под контролем опытного разработчика, может быть качественнее и безопаснее, чем «самописные» скрипты начинающего энтузиаста, написанные без понимания принципов чистого программирования.
Ключевой критерий безопасности — репутация. Если проект поддерживается разработчиком с подтвержденным трек-рекордом, его использование (даже при условии участия ИИ) гораздо оправданнее, чем слепое доверие к «чисто человеческому», но технически неграмотному коду.
Использование ИИ в разработке для систем умного дома — это уже свершившийся факт, «джинн выпущен из бутылки». Попытки полностью запретить участие нейросетей в написании интеграций были бы контрпродуктивными. Сейчас количество энтузиастов, которые выдают ответы чат-ботов за свои собственные «гениальные решения», растет в пугающей прогрессии. В умелых руках нейросети становятся мощным рычагом, ускоряющим создание сложных систем, но окончательное решение о внедрении того или иного компонента всегда остается за конечным пользователем. Ваша задача — оценивать не инструмент, а итоговое качество, стабильность и прозрачность разработки.