OpenAI представила Jalapeño: собственный ASIC для инференса
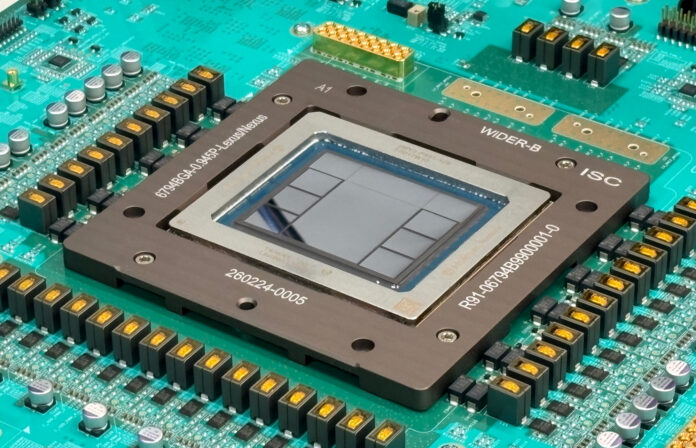
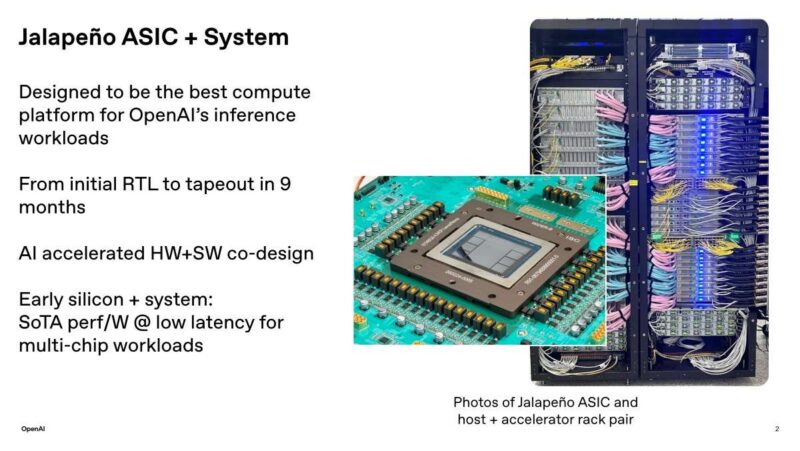
На второй день конференции Hot Chips 2026 компания OpenAI официально представила Jalapeño — специализированный ASIC и системное решение для инференса, разработанное совместно с Broadcom. Проект стал ответом на потребность OpenAI в вычислительной платформе, максимально адаптированной под собственные рабочие нагрузки. Ричард Хо, Рави Нараянасвами и Крис Лири из OpenAI подробно описали путь создания чипа, который занял всего девять месяцев — от формирования RTL-кода до получения готовых кристаллов.
Философия проектирования и метрики эффективности
OpenAI позиционирует Jalapeño не как «сырой» ускоритель, а как комплексную платформу для инференса, состоящую из кремниевой части, хоста и серверной стойки. Целью разработки стало достижение передовой производительности на ватт при минимальных задержках для многочиповых задач, что было реализовано через совместное проектирование аппаратного и программного обеспечения. Архитектура чипа базируется на использовании памяти HBM4 и пространственной модели программирования.
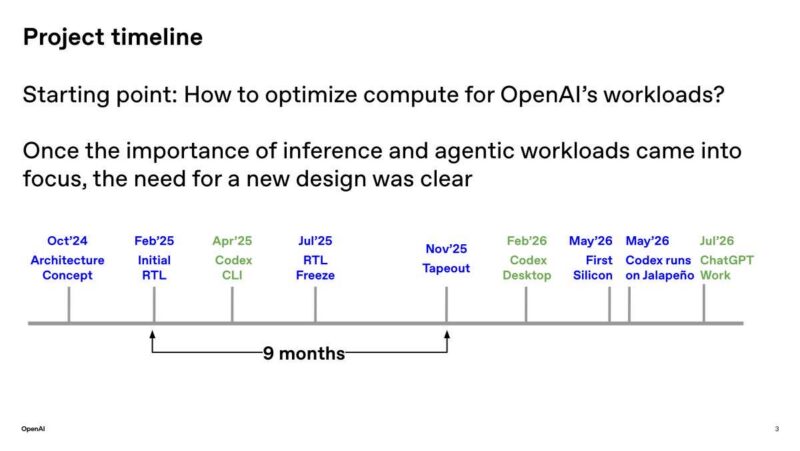
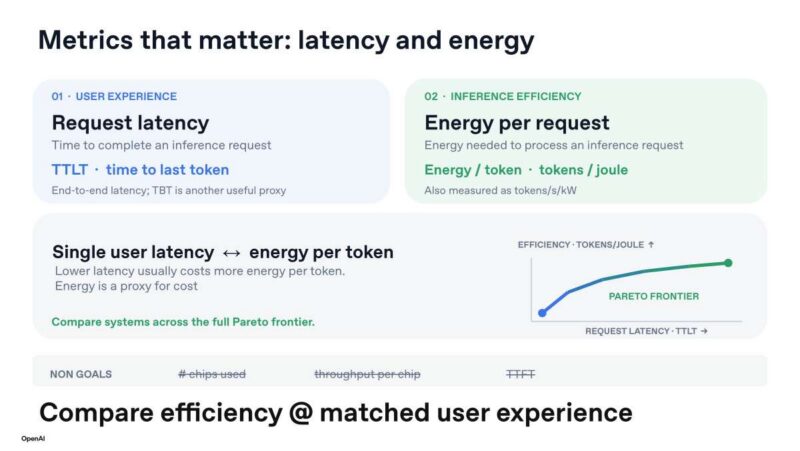
Проект развивался стремительно: концепт архитектуры появился в конце 2024 года, заморозка RTL состоялась в 2025 году, tapeout прошел в конце 2025-го, а уже в начале 2026 года на чипе заработал Codex, за которым вскоре последовал ChatGPT. OpenAI оценивает успех проекта по двум ключевым показателям: времени до генерации последнего токена для улучшения пользовательского опыта и количеству токенов на джоуль для повышения энергоэффективности инференса.
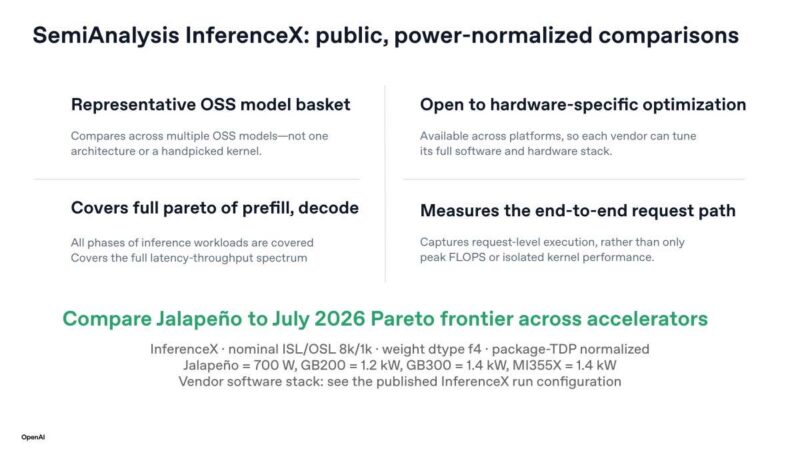
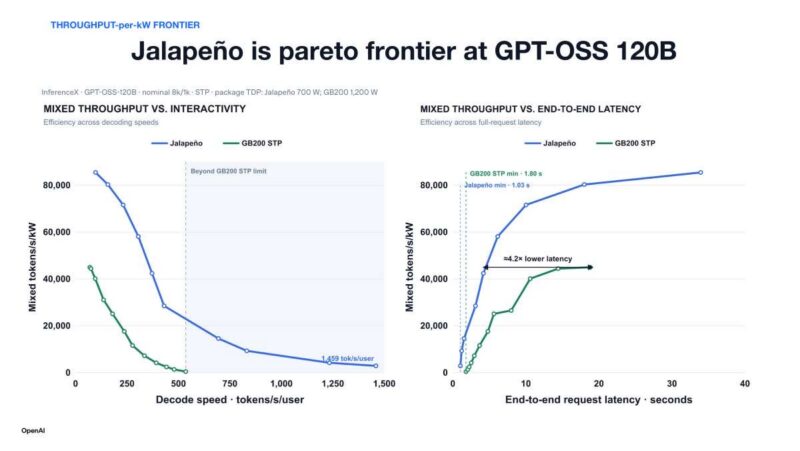
Вместо погони за общим количеством чипов или пропускной способностью, компания сосредоточилась на «границе Парето», сопоставляя задержку запроса и энергию на токен. Для сравнения использовался бенчмарк InferenceX — публичный инструмент с нормализованным энергопотреблением, охватывающий спектр моделей от префилла до декодирования. Энергопотребление (TDP) Jalapeño составляет 700 Вт, тогда как аналоги сравнивались при 1,2 кВт (GB200) и 1,4 кВт (GB300 и MI355X).
Сравнительный анализ производительности
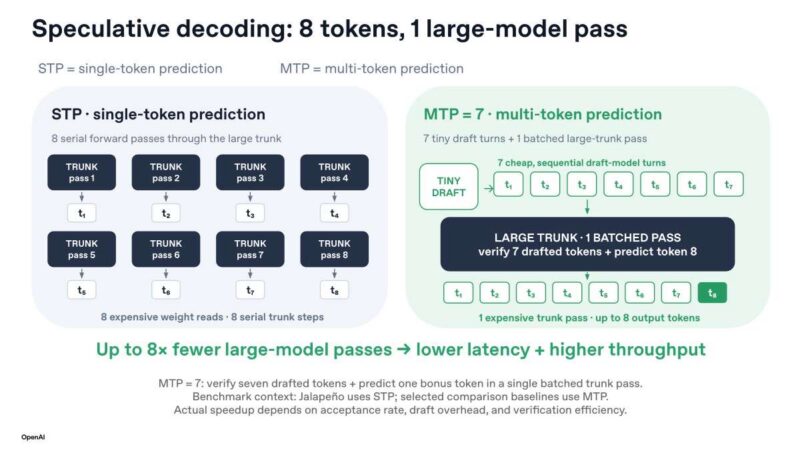
Ключевое различие заключается в подходе к генерации: Jalapeño использует предсказание одного токена, в то время как сравниваемые решения NVIDIA применяют многотокеновое предсказание (MTP). Технология MTP позволяет за счет семи проходов «черновой» модели и одного прохода основной модели генерировать до восьми выходных токенов, что снижает потребность в дорогостоящих вычислениях основной модели до 8 раз.
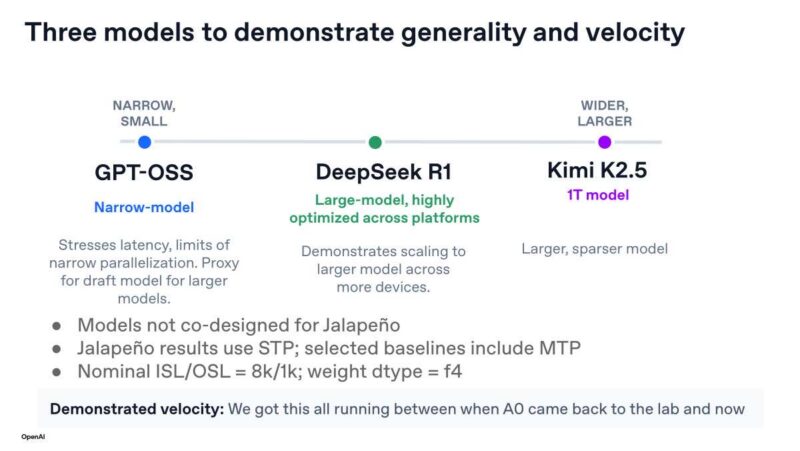
В ходе тестов OpenAI использовала модели GPT-OSS (для оценки предельных задержек), DeepSeek R1 (как пример эффективной «черновой» модели) и Kimi K2.5 (1 триллион параметров) для оценки масштабируемости. Ни одна из этих моделей не проектировалась специально под Jalapeño, однако все они были запущены на чипе в кратчайшие сроки после получения образцов A0.
Результаты для GPT-OSS 120B
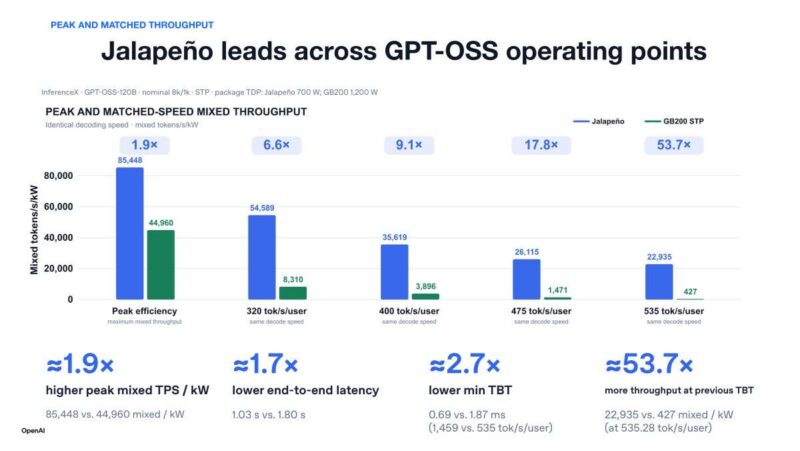
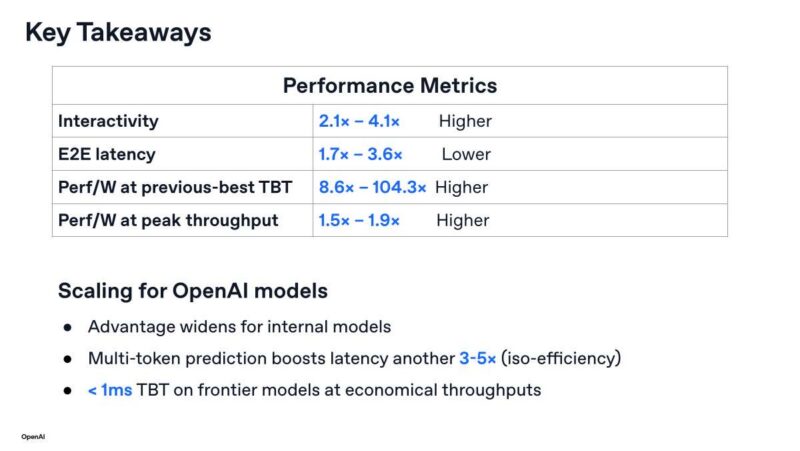
При энергопотреблении 700 Вт чип Jalapeño демонстрирует преимущество в полезной пропускной способности на киловатт по сравнению с GB200 (1200 Вт). На равных операционных точках Jalapeño показывает примерно в 1,9 раза более высокую пиковую производительность (смешанные токены в секунду на киловатт) и примерно в 1,7 раза меньшую сквозную задержку. При сравнении по показателю времени между токенами (TBT) преимущество достигает 53,7-кратного прироста пропускной способности.
Результаты для DeepSeek R1 670B (MXFP4)
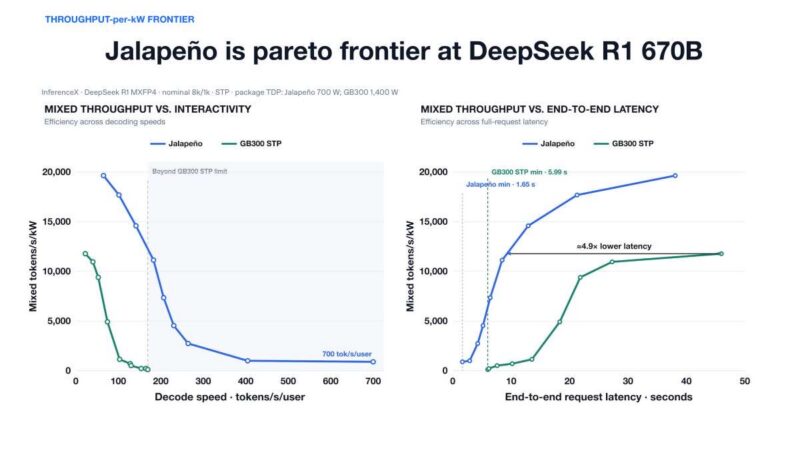
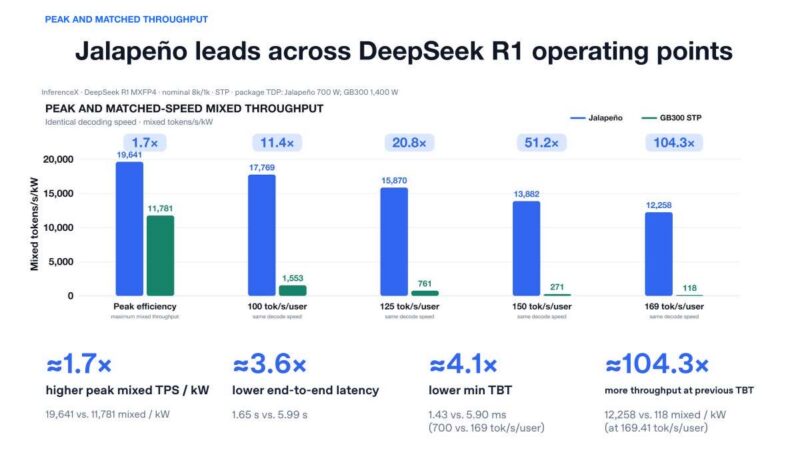
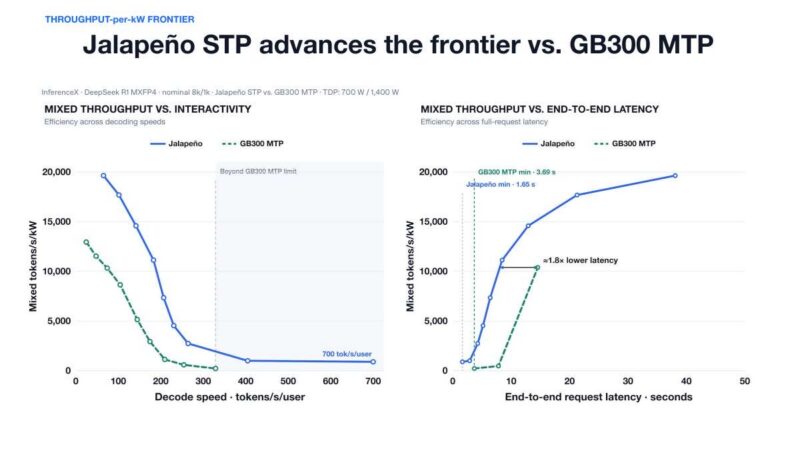
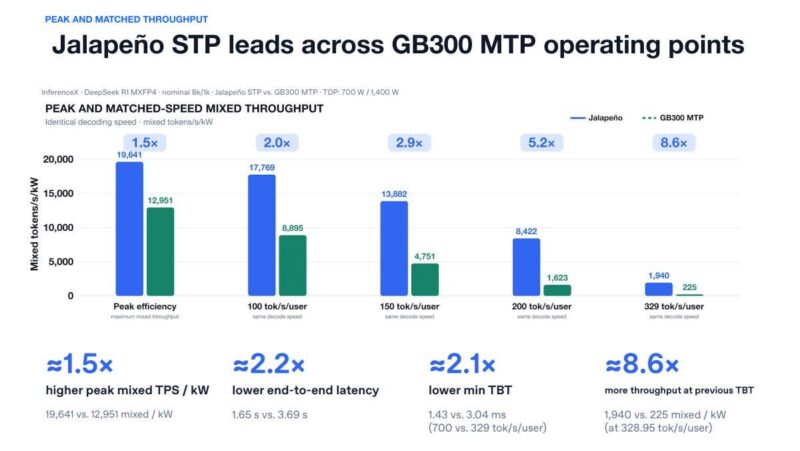
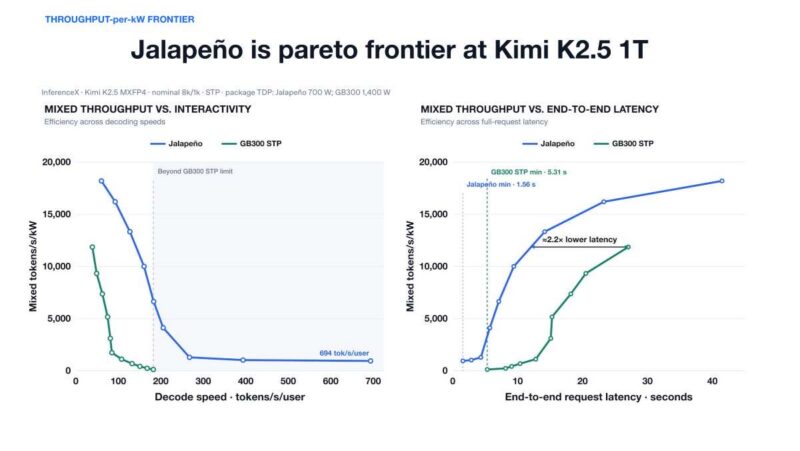
В этом сценарии Jalapeño (700 Вт) противопоставляется GB300 (1400 Вт). Чип OpenAI обеспечивает примерно в 1,7 раза более высокую пиковую производительность и в 3,6 раза меньшую задержку. При сравнении по лучшему времени между токенами (TBT) пропускная способность возрастает в 104,3 раза. Даже при прямом сравнении, где Jalapeño работает в однотокеновом режиме против многотокенового режима GB300 (без учета преимущества спекулятивного декодирования), чип OpenAI опережает конкурента: выше пиковая производительность в 1,5 раза и ниже задержка в 2,2 раза.
Результаты для Kimi K2.5 (1 трлн параметров)
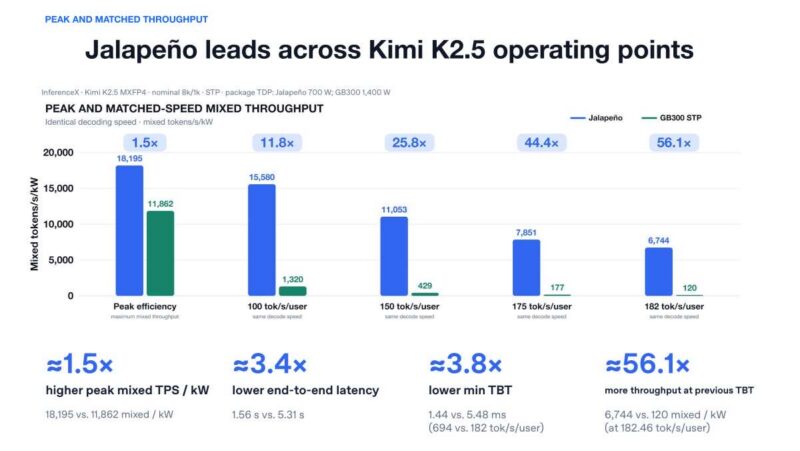
В этом тесте масштабируемости Jalapeño также сохраняет лидерство: пиковая производительность в 1,5 раза выше, сквозная задержка — в 3,4 раза ниже, а пропускная способность по показателю TBT — в 56,1 раза выше, чем у предыдущих решений. OpenAI заявляет о достижении субмиллисекундной задержки между токенами на передовых моделях при сохранении экономической эффективности, отмечая, что внедрение многотокенового предсказания могло бы улучшить показатели задержки еще в 3–5 раз.
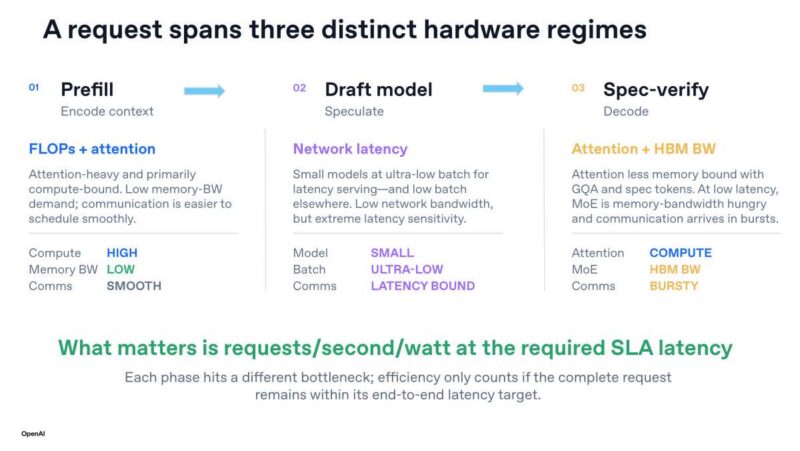
Архитектура Jalapeño разработана с учетом того, что один запрос проходит три аппаратных стадии: вычислительно-интенсивный префилл, использование малой модели для спекуляций с низкой задержкой и стадия декодирования с проверкой спекуляций, лимитированная пропускной способностью памяти при интенсивных коммуникациях MoE.
Архитектура и производительность чипа Jalapeño
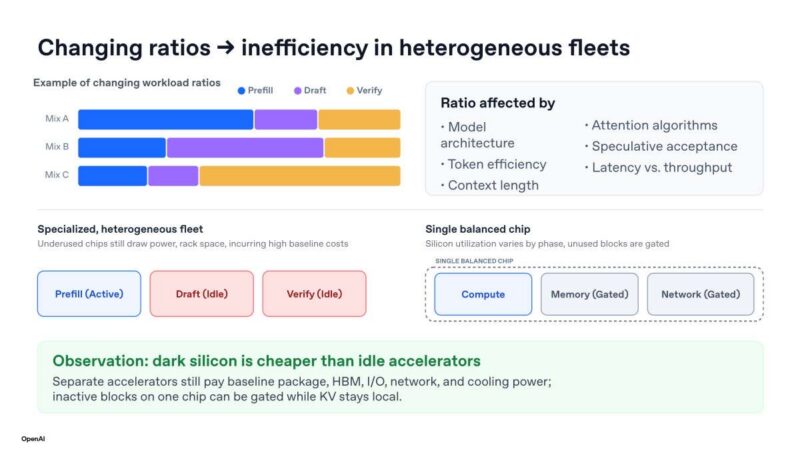
Каждый этап обработки запроса сталкивается с собственным «узким местом», поэтому эффективность системы имеет значение только в том случае, если общий запрос укладывается в целевой показатель сквозной задержки. В OpenAI утверждают, что смешанные рабочие нагрузки нарушают баланс между фазами предварительного заполнения (prefill), генерации черновика (draft) и проверки (verify). Это делает специализированные гетерогенные парки оборудования неэффективными, так как простаивающие ускорители продолжают потреблять базовую энергию.
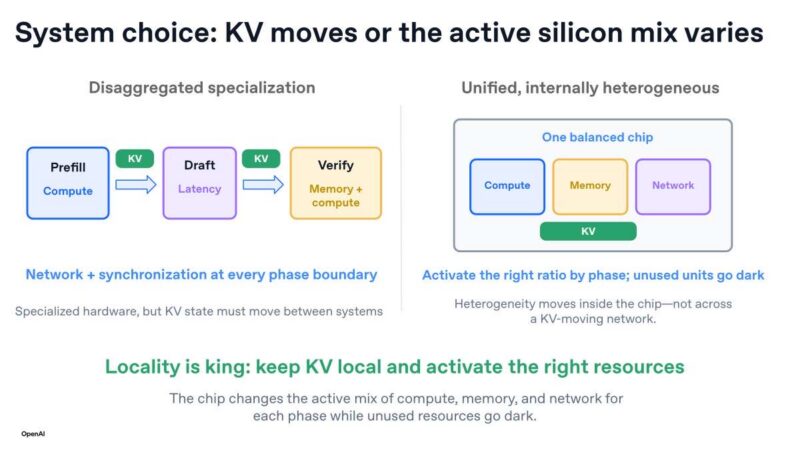
Чип Jalapeño предлагает решение в виде единого сбалансированного устройства, где блоки, неактивные на определенной фазе, отключаются. Это избавляет от необходимости оплачивать базовую комплектацию, память HBM, ввод-вывод и энергопотребление сети отдельного специализированного ускорителя. Ключевое проектное решение системы заключается в выборе: перемещать состояние KV-кэша между специализированными системами или менять сочетание активных компонентов внутри одного чипа. OpenAI сохраняет KV-кэш локально на Jalapeño, варьируя активное соотношение вычислений, памяти и сети для каждой фазы, при этом неиспользуемые блоки уходят в «спящий» режим, что предотвращает необходимость передачи KV-данных через сеть на каждой границе фаз.
Показатели пропускной способности и сетевая инфраструктура
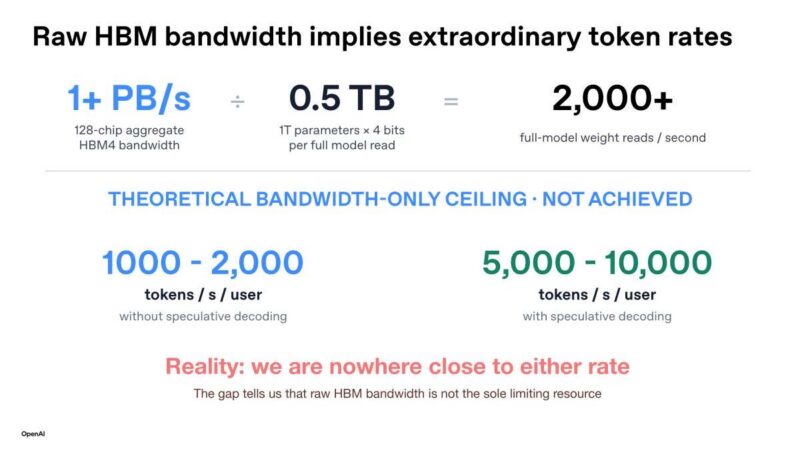
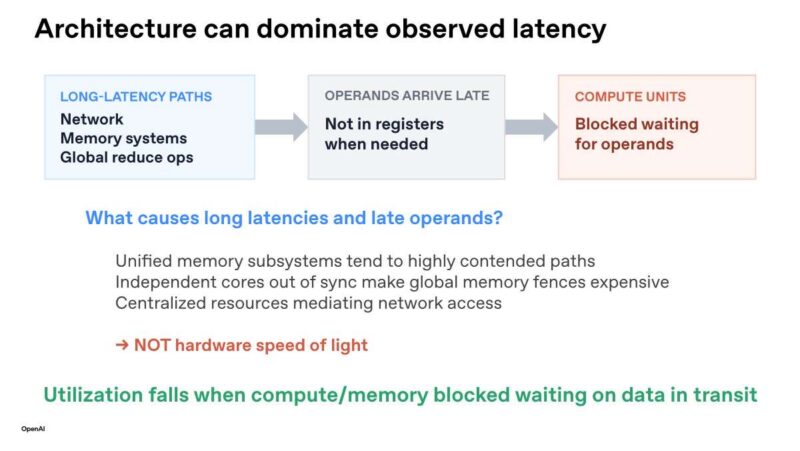
На бумаге показатели пропускной способности HBM4 у Jalapeño впечатляют. При совокупной пропускной способности 128 чипов более одного петабайта в секунду, теоретический предел составляет 1000–2000 токенов в секунду на пользователя без спекулятивной декодировки и 5000–10000 с её использованием. Тем не менее, OpenAI признает, что реальная производительность системы значительно ниже, что указывает на то, что «чистая» пропускная способность — не единственный ограничивающий ресурс. Длинные пути с высокой задержкой, перегруженные подсистемы унифицированной памяти и дорогостоящие глобальные барьеры памяти заставляют вычислительные блоки простаивать в ожидании данных, что снижает уровень их утилизации.
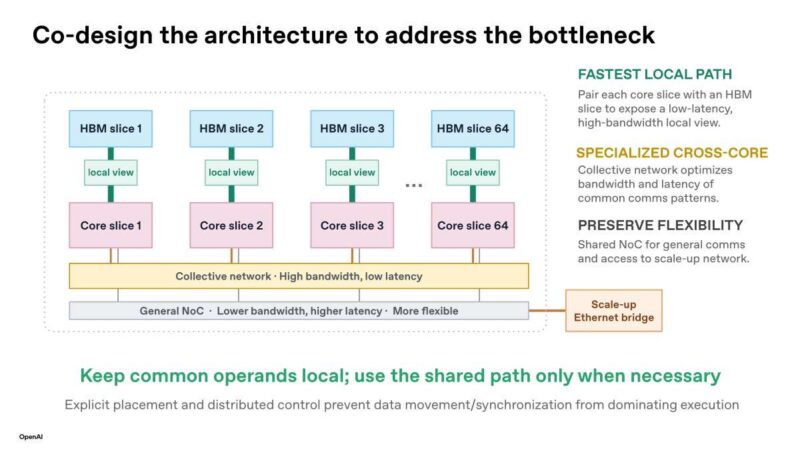
Архитектура Jalapeño решает эту проблему путем соединения каждого вычислительного сегмента с сегментом HBM для обеспечения быстрого локального доступа и добавления специализированной сети с низкой задержкой для типовых межъядерных взаимодействий. Для трафика, не требующего быстрого пути, используется более гибкая сеть на кристалле (NoC), что позволяет удерживать общие операнды локально и предотвращает доминирование передачи данных над процессом выполнения.
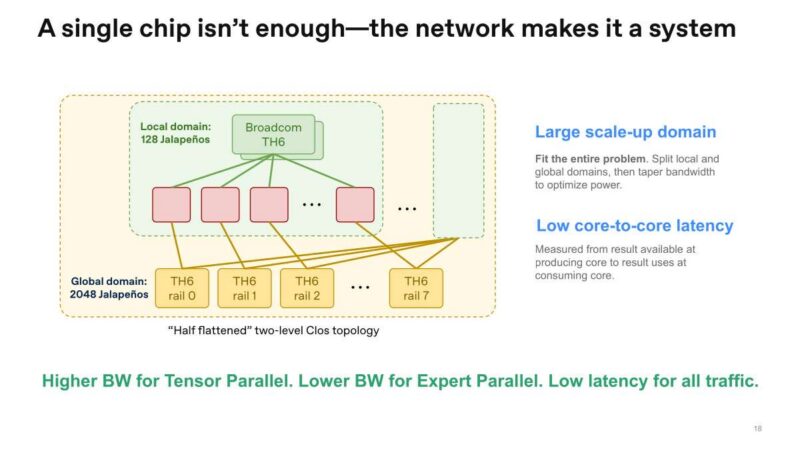
Локальный домен Jalapeño объединяет 128 ASIC с низкой задержкой между ядрами. Глобальный домен из 2048 чипов строится на основе двухуровневой топологии типа «складчатый» Clos с использованием коммутаторов Broadcom Tomahawk6. При этом предусмотрена более высокая пропускная способность для тензорного параллелизма и более низкая — для параллелизма экспертов.
Проектирование и программная модель
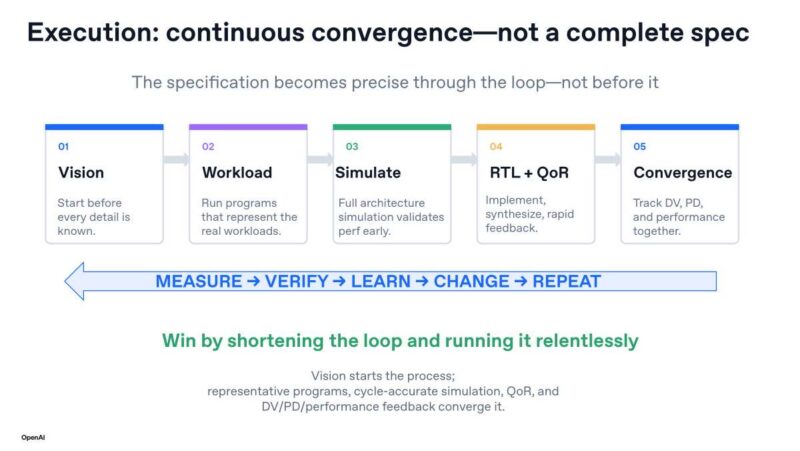
OpenAI отмечает, что спецификация Jalapeño формировалась в процессе проектирования, а не была полностью определена заранее. Процесс строился на цикле «измерение, проверка, обучение, изменение», что позволило сократить обратную связь между симуляцией рабочей нагрузки, RTL, анализом качества результатов, а также физическим проектированием. Для ускорения процесса OpenAI использовала собственную ИИ-модель и язык описания оборудования XLS. Значительные изменения вносились вплоть до дня «заморозки» RTL, а зафиксированные показатели PPA (мощность, производительность, площадь) превзошли человеческий базовый уровень: например, 56-процентное улучшение при умножении BF16 и уменьшение площади матричного блока на 10 процентов.
Программная модель Jalapeño создана простой для людей и удобной для программирования передовыми ИИ. Оборудование открывает доступ к локальным тензорам, быстрым локальным путям и явным коммуникациям, позволяя ИИ самостоятельно выполнять задачи по распределению, размещению, планированию и конвейеризации, которые были бы слишком обременительными для человека. Jalapeño использует пространственную архитектуру, где фреймворк Gluon программирует каждую группу физических ядер как блок потоков. Тензорные, SIMD и скалярные движки каждой группы организованы вокруг быстрого локального представления памяти, а специализированные коллективные операции координируют работу ядер.
Технические характеристики и перспективы
Используя внутреннюю ИИ-систему для реализации, оптимизированные ядра внимания и экспертные (MoE) ядра работают в 1,5–1,8 раза быстрее, чем существующие реализации, написанные вручную, что подтверждено сквозными тестами на чипе.
- Производительность одного чипа: 13,4 ПФЛОПС (mxfp4 по mxfp4), пропускная способность HBM4 15,4 ТБ/с (216 ГИБ), энергопотребление 700 Вт.
- Масштабирование до 2048 чипов: 27 ЭФЛОПС, 432 ТИБ совокупной памяти.
- Сеть: 600 ГБ/с для локального домена из 128 ASIC и 200 ГБ/с для глобального домена из 2048 ASIC.
OpenAI рассматривает Jalapeño как первое поколение (Gen 1) многолетней дорожной карты. Второе поколение (Gen 2) нацелено на повышение производительности на ватт, а третье (Gen 3) — на экономичное обслуживание с низкой задержкой, поскольку архитектура ориентирована на раскрытие совокупной пропускной способности HBM, а не простое увеличение «сырой» мощности. Компании также выразили благодарность Broadcom и Celestica за сотрудничество.
Создание собственного ASIC за 9 месяцев — это впечатляющий результат, который наглядно демонстрирует, как ИИ трансформирует индустрии. Интерес к программному стеку Jalapeño продиктован тем, что OpenAI проектирует его для программирования силами ИИ. Возможно, наиболее важным аспектом этого проекта является доказательство эффективности такого подхода для других компаний, занимающихся проектированием оборудования.