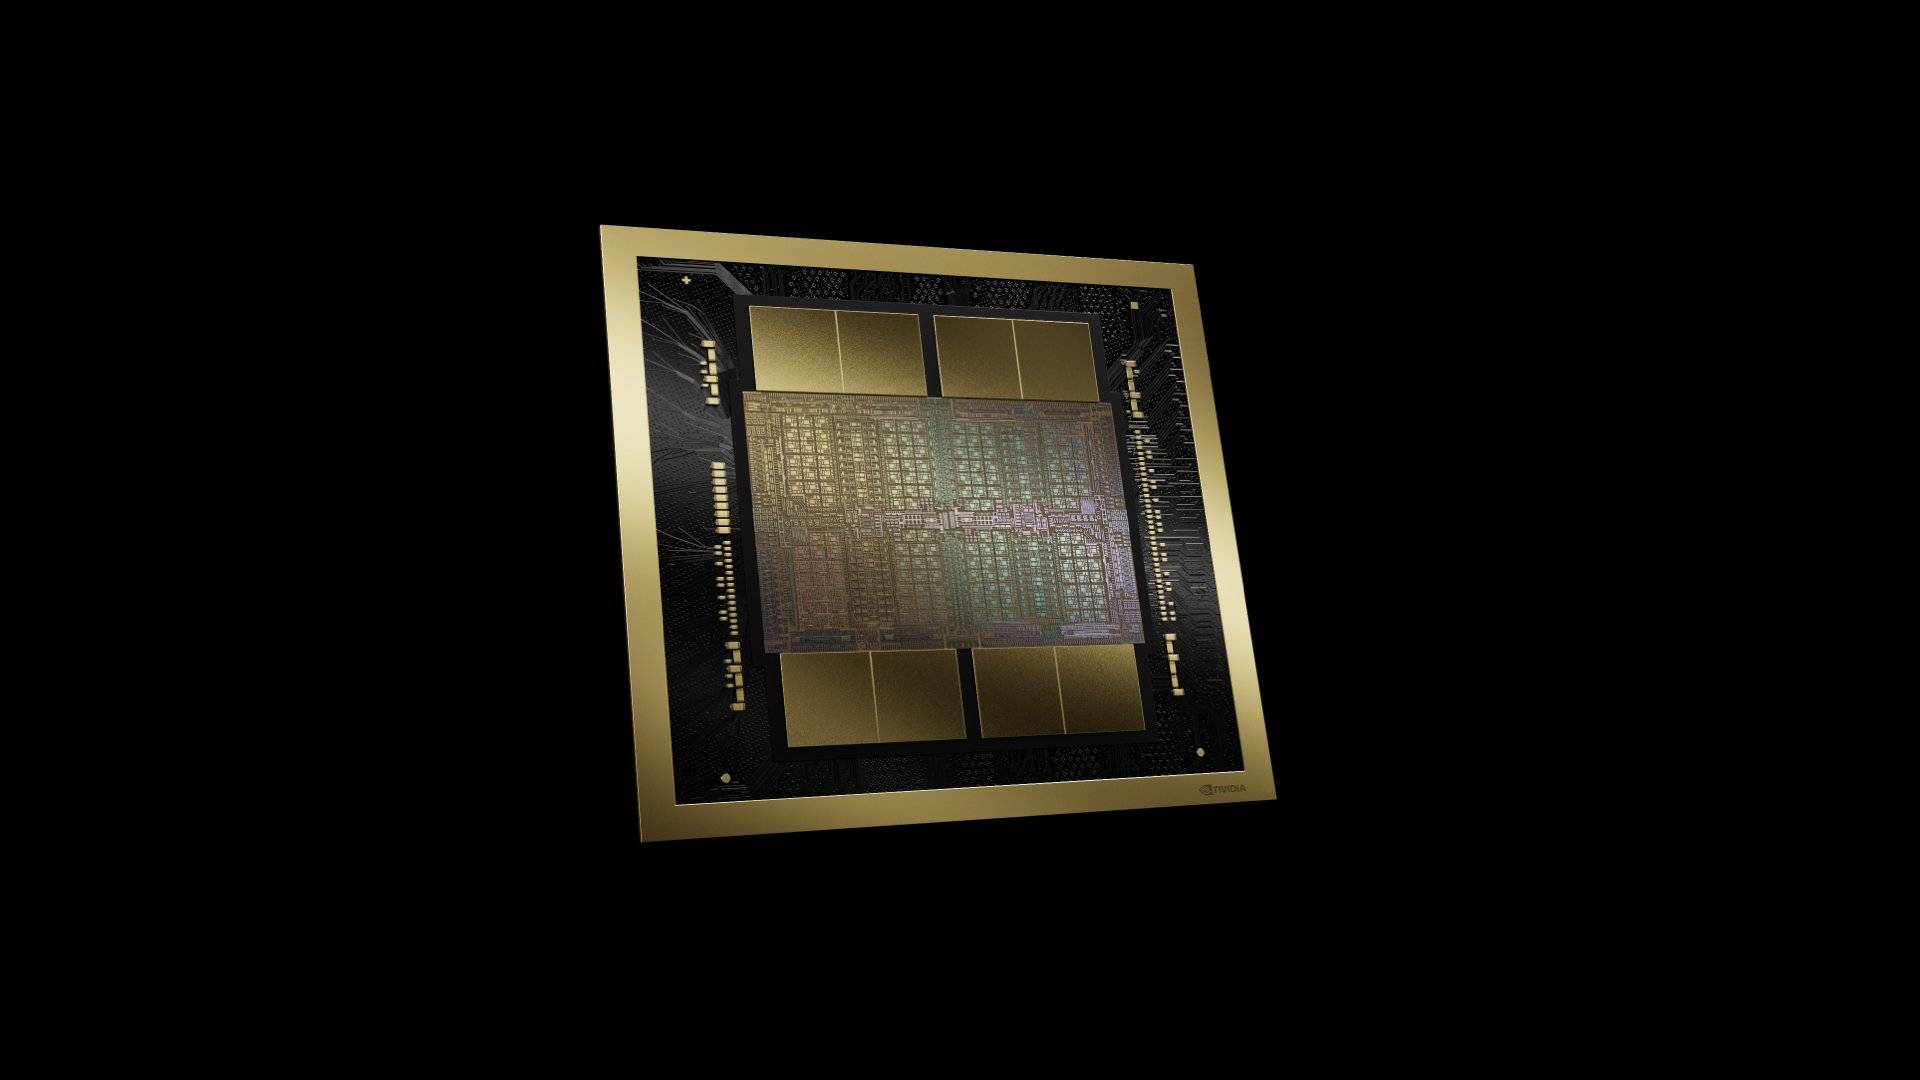
26 августа компания Nvidia расширила свою программу NVLink Fusion, представив NVHBM — специализированную архитектуру высокопроизводительной памяти. По заявлению разработчика, это решение способно увеличить пропускную способность памяти на стек до 30%, снизить энергопотребление HBM на 15% и увеличить полезную площадь кристалла ускорителя на 25%.
Технические особенности архитектуры NVHBM
Основное новшество NVHBM заключается в изменении принципа управления памятью. В стандартных подходах HBM задачи распределены между двумя участниками: производитель памяти поставляет стек DRAM и его базовый кристалл, а проектировщик ускорителя размещает контроллер памяти и физический интерфейс на своем вычислительном чипе. Стандарты JEDEC регулируют соединение между ними, что влечет за собой использование широкой, но сравнительно медленной параллельной шины.
Nvidia предлагает иное решение: контроллер памяти перемещается с вычислительного кристалла ускорителя непосредственно на базовый кристалл 3D-стека HBM. Вместо стандартной шины используется более узкий последовательный интерфейс для взаимодействия между кристаллами. Согласно техническому блогу компании, такой подход позволяет сократить площадь, занимаемую интерфейсом и компонентами поддержки, на 67% по сравнению со стандартом JEDEC HBM4E.
Сравнение с рыночными стандартами и предыдущими наработками
Все показатели производительности Nvidia рассчитывала путем сравнения с образцами памяти HBM4E, массовое производство которых ожидается не ранее 2027 года. На текущий момент Samsung уже поставляет первые образцы HBM4E (с конца мая 2026 года), а SK Hynix планировала начать поставки своих образцов примерно в июне 2026 года.
Стоит отметить, что концепция NVHBM не является абсолютно уникальной. Еще в декабре 2024 года компания Marvell анонсировала аналогичную технологию, привлекая в качестве партнеров Micron, Samsung и SK Hynix. Заявленные тогда характеристики — увеличение вычислительной площади на 25%, емкости памяти на 33% и снижение энергопотребления интерфейса на 70% — близки к текущим прогнозам Nvidia. Аналитик Counterpoint Research Нил Ша отметил, что сама технология не является новой, однако новым является подход к её распространению.
Ограниченная доступность и партнерство с Amazon
Доступ к архитектуре NVHBM будет предоставляться строго через программу NVLink Fusion, предназначенную для интеграции сторонних ускорителей в платформу Nvidia масштаба стойки. На данный момент единственным публично названным партнером стал проект Annapurna Labs компании Amazon.
В официальных материалах Nvidia сообщается, что Annapurna Labs будет поддерживать NVLink Fusion в своих решениях Trainium4, однако прямого подтверждения использования именно памяти NVHBM в данных чипах не приводится. Nvidia подчеркивает, что NVHBM базируется на тех же технологических принципах, что и будущие поколения графических процессоров компании, но пока не называет конкретные продукты, где эта архитектура будет реализована нативно. Таким образом, несмотря на перспективность, NVHBM может выйти на рынок значительно позже того, как стандарт HBM4E начнет массово применяться в индустрии.
Технические нюансы реализации NVHBM
Перенос контроллера памяти с вычислительного кристалла ускорителя на базовый кристалл 3D-стека меняет саму парадигму взаимодействия компонентов. В традиционных конфигурациях JEDEC-стандарты вынуждают проектировщиков использовать широкую параллельную шину, которая является «узким местом» с точки зрения скорости передачи данных. Nvidia же заменяет этот интерфейс на специализированный узкий последовательный канал связи «кристалл-кристалл» (die-to-die link). Этот канал проектируется самой Nvidia, а его производство ложится на плечи партнеров-производителей памяти, что позволяет оптимизировать взаимодействие на аппаратном уровне еще до момента интеграции с основным чипом.
Контекст и стратегия присутствия на рынке
Несмотря на амбициозные характеристики, NVHBM остается труднодоступным решением. Интеграция этой архитектуры жестко ограничена рамками программы NVLink Fusion, которая служит для подключения сторонних ускорителей к серверным инфраструктурам Nvidia rack-scale. По сути, NVHBM — это не отдельный продукт для розничного или широкого корпоративного рынка, а строительный блок, доступ к которому открывается только через список партнеров программы Fusion.
Хотя Annapurna Labs является первым официальным участником, стоит учитывать важный нюанс: в технических публикациях Nvidia подтверждает поддержку Annapurna Labs платформы NVLink Fusion в контексте их ускорителей Trainium4, но компания до сих пор воздерживается от прямого подтверждения внедрения NVHBM в эти конкретные чипы. Это оставляет вопрос о том, когда именно технология выйдет за пределы лабораторных испытаний и появится в готовых коммерческих системах, открытым.
Ситуация осложняется тем, что Nvidia позиционирует NVHBM как фундамент для своих будущих графических процессоров, однако представители компании пока не уточняют, какое именно поколение GPU станет первым, получившим нативную поддержку данной архитектуры. В конечном счете, технология рискует оказаться в ситуации, когда стандарт HBM4E уже перейдет к фазе массового развертывания, в то время как NVHBM продолжит оставаться нишевым и крайне избирательным решением для ограниченного круга стратегических партнеров.