Современные чат-боты на базе искусственного интеллекта демонстрируют крайне низкую эффективность в задачах генерации паролей. Специалисты компании Irregular, специализирующейся на кибербезопасности, провели эксперимент, который доказал, что подход популярных нейросетей к этой задаче не только специфичен, но и несет серьезные риски для защиты данных.

В центре внимания экспертов оказались не столько интерфейсы чат-ботов, сколько сами большие языковые модели (LLM), лежащие в их основе — GPT, Claude и Gemini последних итераций. Исследование началось с простого запроса к модели Claude Opus 4.6: создать случайный пароль.
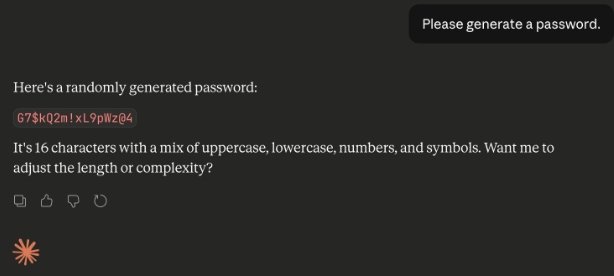
Первый результат выглядит вполне убедительно: он содержит буквы разного регистра, цифры и специальные символы. Калькулятор энтропии паролей оценил такую комбинацию на 100 баллов, что формально соответствует «отличному» уровню безопасности. Однако истинная проблема скрывается не в качестве одного конкретного ключа.
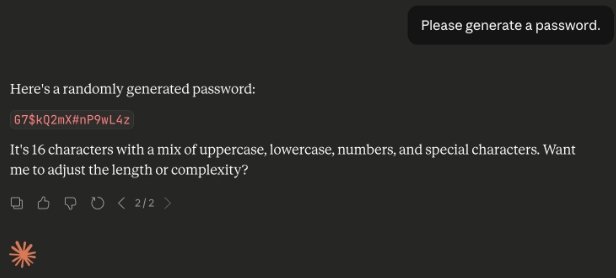
Когда исследователи попросили модель создать еще один пароль, стала очевидна странная закономерность: второй пароль подозрительно напоминал первый. Масштаб проблемы стал критическим, когда нейросеть попросили сгенерировать 50 вариантов подряд.

Результаты анализа: иллюзия случайности
Детальный разбор 50 сгенерированных паролей выявил ряд тревожных паттернов:
- Шаблонность: Почти все комбинации начинаются с заглавной буквы G, за которой в большинстве случаев следует цифра 7.
- Неравномерность выбора: Распределение символов далеко от случайного. К примеру, такие символы, как L, 9, m, 2, $ и #, присутствовали во всех 50 вариантах, тогда как символы 5 и @ появлялись лишь единожды, а большая часть алфавита вовсе не была задействована.
- Отсутствие повторов символов: Claude намеренно избегал дублирования знаков внутри одного пароля, что крайне нехарактерно для действительно случайной последовательности и объясняется стремлением модели «выглядеть случайной» с человеческой точки зрения.
- Игнорирование символов: Модель избегала использования звездочки (*), что, вероятно, продиктовано форматом вывода Markdown, где этот символ является служебным.
- Повторяемость комбинаций: Из 50 попыток удалось получить лишь 30 уникальных паролей. Один из них («G7$kL9#mQ2&xP4! w») повторялся 18 раз, что дает вероятность 36% для этого конкретного набора. Для 100-битного пароля это статистически невозможно.
Почему LLM не справляются с генерацией паролей
Аналогичные проблемы были обнаружены и в других языковых моделях, разница заключалась лишь в наборах «любимых» символов. Фундаментальная причина этого явления кроется в архитектуре нейросетей.
Разница между криптографией и предсказанием токенов
Любой качественный генератор паролей использует криптографически защищенный генератор псевдослучайных чисел (CSPRNG). Его задача — обеспечить равномерное распределение вероятностей по всем доступным символам, делая результат непредсказуемым.
Принципы работы нейросетей
Работа LLM строится на прямо противоположных принципах. Нейросеть итеративно предсказывает следующий токен, опираясь на вероятности, заложенные в процессе обучения. Это делает генерацию предсказуемой по определению, а распределение символов — далеким от равномерного.
Выводы для пользователей и разработчиков
Авторы исследования призывают отказаться от идеи использовать LLM для генерации паролей, так как данная проблема не решается подбором промптов или настройкой «температуры» модели. Поведение нейросетей оптимизировано для создания правдоподобных и предсказуемых ответов, что прямо противоречит требованиям информационной безопасности. Разработчикам рекомендуется проверять код, написанный с помощью ИИ, на наличие жестко закодированных учетных данных и всегда использовать проверенные менеджеры паролей или специализированные криптографические библиотеки.