В условиях жесткой гонки вооружений в сфере искусственного интеллекта оптимизация часто отходит на второй план. Разработчики вспоминают о ней лишь тогда, когда ресурсы подходят к концу или их начинает катастрофически не хватать. Санкционные ограничения США поставили китайских специалистов в условия, где эффективная оптимизация стала не просто временным решением проблемы дефицита железа, а реальным шансом на технологический прорыв.
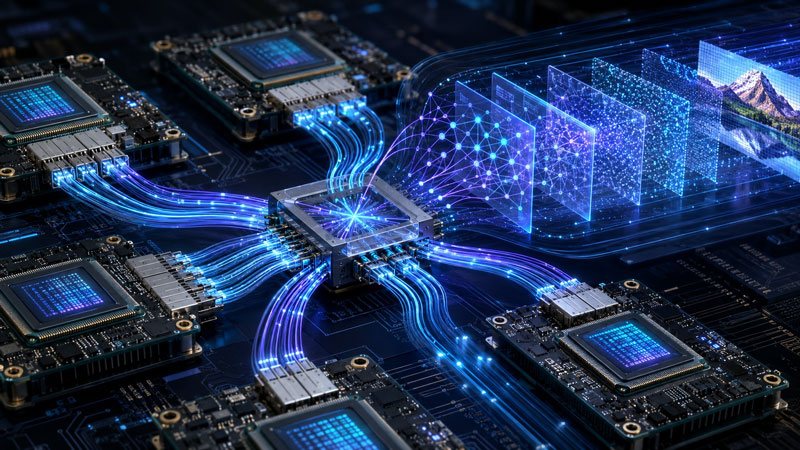
Исследователи из Пекинского университета представили экспериментальную вычислительную платформу, объединяющую несколько стандартных электронных процессоров с помощью кремниевых фотонных передатчиков и оптического коммутатора. В ходе тестов система выполнила задачу нейросетевого шумоподавления почти в 149 раз быстрее, чем традиционный графический процессор. При этом номинальная вычислительная мощность системы составляла лишь 11,6% от показателей GPU — примерно 1,97 Тфлопс против 16,96 Тфлопс.
Архитектура установки включает пять программируемых логических интегральных схем (ПЛИС/FPGA), каждая из которых отвечает за обработку одного слоя пятислойной свёрточной нейросети. Взаимодействие между платами обеспечивается кремниевыми фотонными трансиверами со скоростью 400 Гбит/с и оптическим коммутатором 16 × 16. Четыре канала передачи данных по 100 Гбит/с мультиплексируются по одному волокну на различных длинах волн. Оптический коммутатор с потерями менее 5 дБ теоретически позволяет объединять до 16 вычислительных чипов с общей пропускной способностью до 6,4 Тбит/с.
Ключ к успеху кроется в конвейерной обработке данных. Каждая ПЛИС непрерывно обрабатывает свой слой нейросети, мгновенно передавая результат следующему узлу через оптический канал. Это избавляет систему от необходимости постоянного обращения к внешней памяти для сохранения промежуточных данных, что в случае с классическими GPU приводит к возникновению «стены памяти» и существенным задержкам. В результате обработки массива из тысячи изображений (32 × 32 пикселя) система показала время выполнения 105,16 мкс, тогда как контрольный GPU потратил на ту же задачу 15,643 мс. При этом эффективность использования вычислительных ресурсов ПЛИС достигла отметки 94,7%.
Для испытаний была выбрана пятислойная нейросеть с ядрами 5 × 5 и датасет Fashion-MNIST. Хотя масштабирование такого подхода на современные большие языковые модели требует дальнейших исследований, данный эксперимент наглядно демонстрирует колоссальный скрытый потенциал ускорения ИИ при грамотной оптимизации.
Авторы исследования подчеркивают, что узкоспециализированные задачи могут решаться в условиях ограниченного железа при комплексном подходе, включающем совместную разработку алгоритмов, микроархитектур процессоров и систем межсоединений. Подобная структура способна существенно снизить энергопотребление в дата-центрах, уменьшить задержки и оптимизировать работу в сценариях граничных вычислений.