Компания CoreWeave объявила о развертывании в своей облачной инфраструктуре мультиреечного кластера на базе архитектуры NVIDIA Vera Rubin NVL72. Данное решение объединяет сотни графических процессоров Rubin в единую масштабируемую среду, предназначенную для выполнения сложных агентных задач искусственного интеллекта. CoreWeave стала первым облачным провайдером, который валидировал конфигурацию NVL72 и опубликовал показатели ее производительности, зафиксированные в рамках тестирования MLPerf Inference v6.1 на системе GB300 NVL72.
Особенности аппаратной конфигурации и сетевой архитектуры
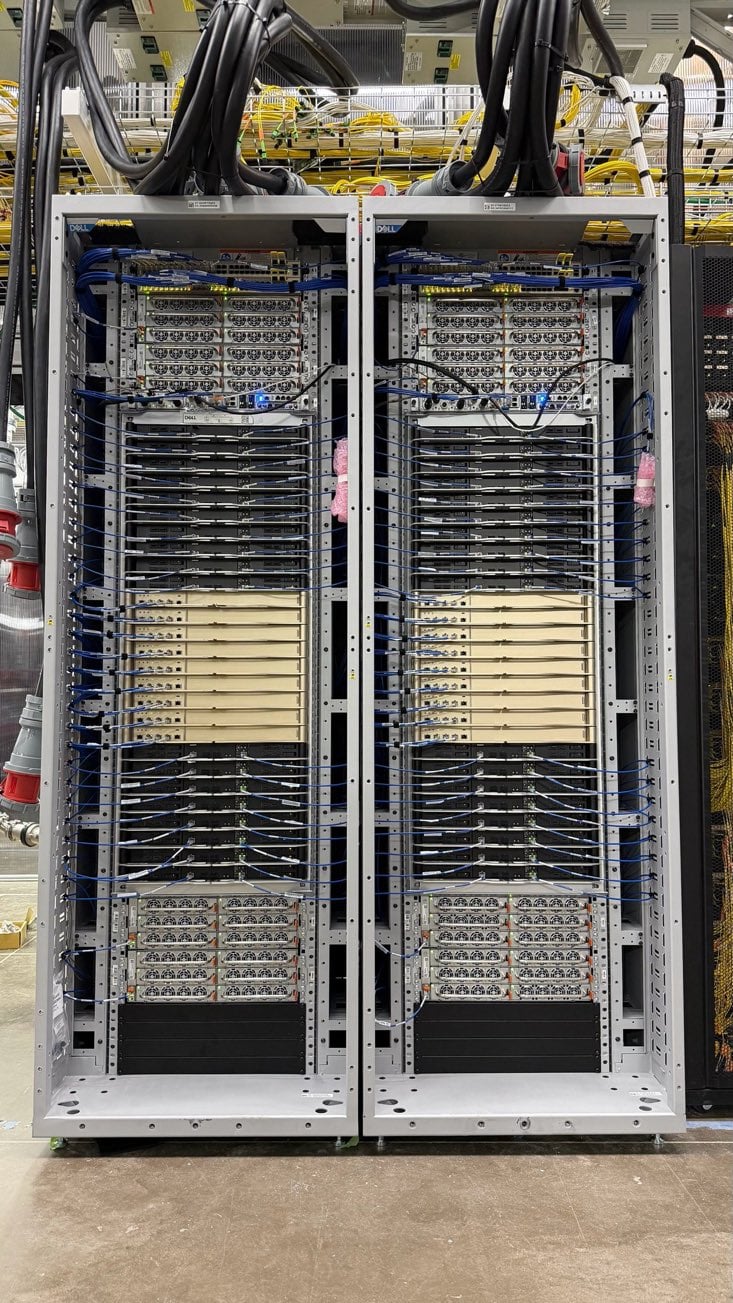
Каждая стойка производства Dell включает 72 графических процессора Rubin и 36 центральных процессоров Vera. В качестве технологии для масштабирования внутри узлов используется NVLink 6, а для обработки сетевого трафика применяются DPU BlueField-4 и по два адаптера ConnectX-9 SuperNIC на каждый GPU. Стойки объединены в двухъярусную неблокирующую фабрику на базе технологии NVIDIA Spectrum-X Ethernet, что, по заявлениям CoreWeave, позволяет масштабировать систему примерно до 128 000 графических процессоров.
Для обеспечения высокой пропускной способности при выполнении агентных рабочих процессов, характеризующихся последовательными циклами рассуждений и частыми вызовами внешних инструментов, на каждый GPU выделено два адаптера ConnectX-9. Они обеспечивают до 1,6 Тбит/с сетевого подключения в расчете на один графический процессор. Модульная архитектура позволяет наращивать емкость системы путем добавления новых стоек в существующую топологию. Отвод тепла реализован с помощью системы жидкостного охлаждения с температурой теплоносителя 45°C.
Управление инфраструктурой и процесс валидации
Для контроля за работой кластера компания использует комплекс программных решений Mission Control. Процесс включает несколько уровней управления: Rack LifeCycle Controller отвечает за провижининг, обнаружение оборудования и первичную валидацию, Racky контролирует параметры питания, а специализированный контроллер Valvey обеспечивает программное управление жидкостным охлаждением и мониторинг датчиков. Стойки проходят многоступенчатую процедуру проверки, включающую диагностику GPU, проверку передачи данных между CPU и GPU, а также стресс-тестирование тепловых режимов.
Обновление системы хранения данных CoreWeave AI Object Storage
Параллельно с обновлением вычислительных мощностей CoreWeave расширила функциональность системы хранения данных AI Object Storage. Ключевым компонентом остается локальный ускоритель транспорта объектов (LOTA), который работает на каждом узле Kubernetes, используя локальные NVMe-накопители для кэширования. По данным компании, скорость кэшированного чтения достигает 7 Гбит/с на один GPU, а задержки p99 снижаются более чем в 8 раз по сравнению с прямым чтением из бакета.
Новая функция ускорения кросс-региональной записи позволяет приложениям выполнять запись в удаленный регион с локальной задержкой без необходимости изменения API или SDK. Метаданные передаются в удаленный регион, в то время как данные объекта фиксируются локально для обеспечения немедленного доступа. Это создает единое пространство имен объектов, устраняя необходимость в сложных конвейерах репликации между регионами.
Архивный уровень хранения данных
В дополнение к существующим классам Hot, Warm и Cold компания представила новый уровень Archive. Он предназначен для долгосрочного хранения редко используемых данных, таких как старые контрольные точки обучения моделей. Основное преимущество нового класса заключается в снижении базовой стоимости емкости и отсутствии сборов за извлечение данных, кэширование, запросы, досрочное удаление и исходящий трафик. CoreWeave рекомендует автоматическую миграцию данных на архивный уровень через 60 дней отсутствия обращений к ним.
Технологический стек управления и контроля
Инфраструктура CoreWeave опирается на многоуровневую систему управления Mission Control, которая автоматизирует жизненный цикл каждой стойки. Процесс начинается с Rack LifeCycle Controller, охватывающего провижининг, прошивку микрокода, аппаратное обнаружение и проверку всех электрических и тепловых контуров. За управление питанием и инфраструктурой отвечает слой Racky, а программно-определяемое управление жидкостным охлаждением и мониторинг экологических датчиков возложены на контроллер Valvey.
Процедура валидации стоек перед вводом в эксплуатацию строго регламентирована:
- Уровень узла: включает многочасовую диагностику GPU, проверку корректности передачи данных между CPU и GPU, а также комплексное тестирование межсоединений и тепловых характеристик под нагрузкой, завершающееся реалистичными прогонами обучения.
- Уровень стойки: выполнение синхронизированных задач на всех 72 GPU для верификации производительности NVLink. Если система демонстрирует показатели ниже эталонных, она отправляется на перенастройку.
- Масштаб кластера: CoreWeave проводит распределенные рабочие нагрузки, намеренно отключая пути NVLink для принудительной передачи трафика через бэкенд-сеть. Это позволяет выявить нестабильные соединения, перегрев оборудования или неравномерное распределение трафика в условиях, имитирующих реальные агентные приложения: резкие всплески спроса, изменение интенсивности параллельных вычислений и пакетную передачу данных.
Особенности работы LOTA и кросс-региональных операций
Система Local Object Transport Accelerator (LOTA) представляет собой кэширующий прокси-сервер, который уже демонстрирует впечатляющие показатели в масштабных проектах. По данным CoreWeave, один из поставщиков пограничных моделей (frontier model provider) использует LOTA на 15 000+ графических процессоров с объемом кэша 20 ПБ, достигая 99,7% эффективности попаданий (hit rate). Важно отметить, что использование LOTA не требует дополнительных затрат со стороны клиентов.
Механизм кросс-региональной записи работает следующим образом: приложение направляет стандартный S3-запрос к локальной конечной точке LOTA. Метаданные немедленно фиксируются в удаленном регионе, а сами данные объекта сохраняются в локальном хранилище, становясь доступными для чтения практически мгновенно, включая того же «автора» записи. В фоновом режиме происходит миграция данных в целевой регион. Такой подход обеспечивает единое пространство имен (bucket namespace) с унифицированными политиками IAM, правилами жизненного цикла и контроля доступа, что избавляет от необходимости выстраивать сложные цепочки репликации между дата-центрами. Сесиль Робер-Мишон, директор по внутренней инфраструктуре в Cohere, подтвердила эффективность этого решения, отметив, что наличие кэшированных локальных копий позволяет избежать простоев в графике обучения из-за задержек при извлечении данных между регионами.