Проблема «островных» ИИ-систем на базе NVIDIA GB10
Системы для работы с ИИ, размещаемые непосредственно на рабочем столе пользователя (deskside), построенные на платформе NVIDIA GB10, выполняют единственную, но важную задачу: они обеспечивают 128 ГБ унифицированной памяти и производительность на уровне одного петафлопса в непосредственной близости от пользователя, что позволяет мгновенно итерировать модели. Однако у них отсутствует подключение к корпоративной системе хранения данных.
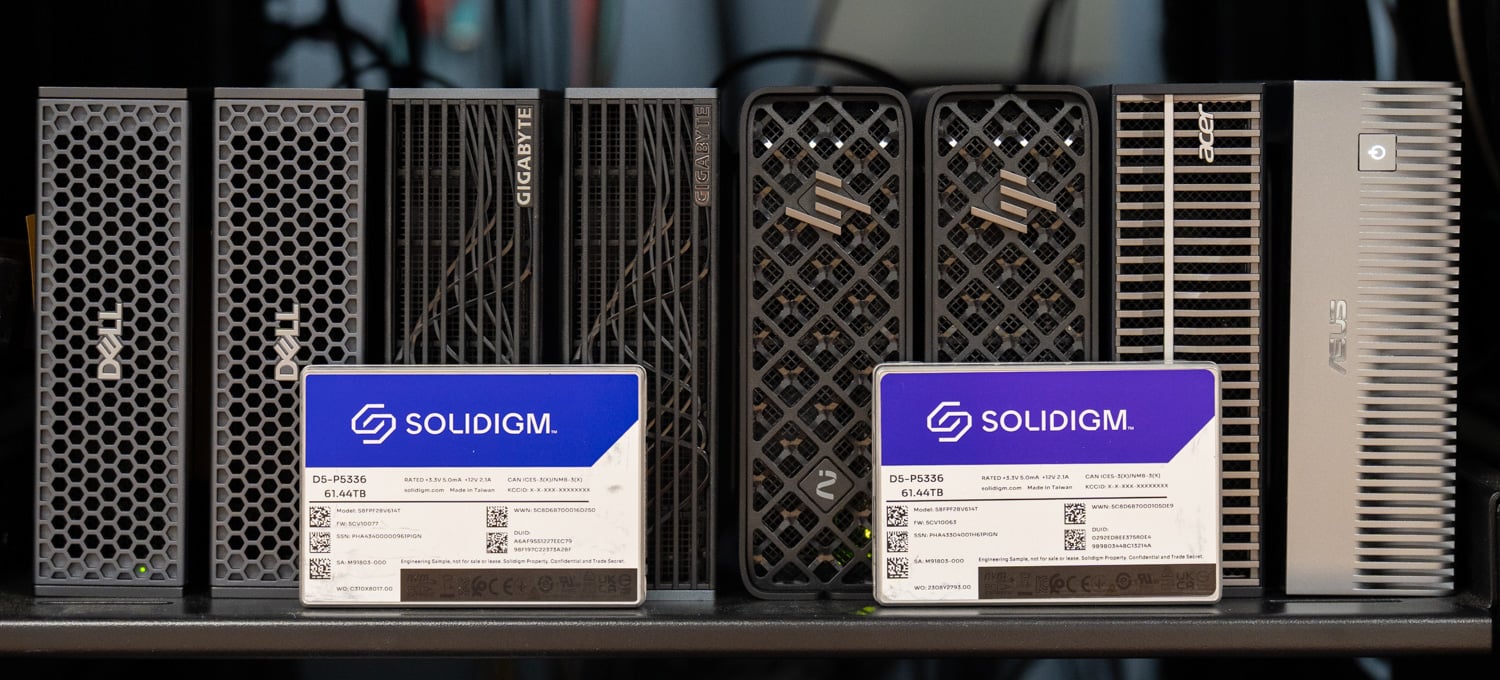
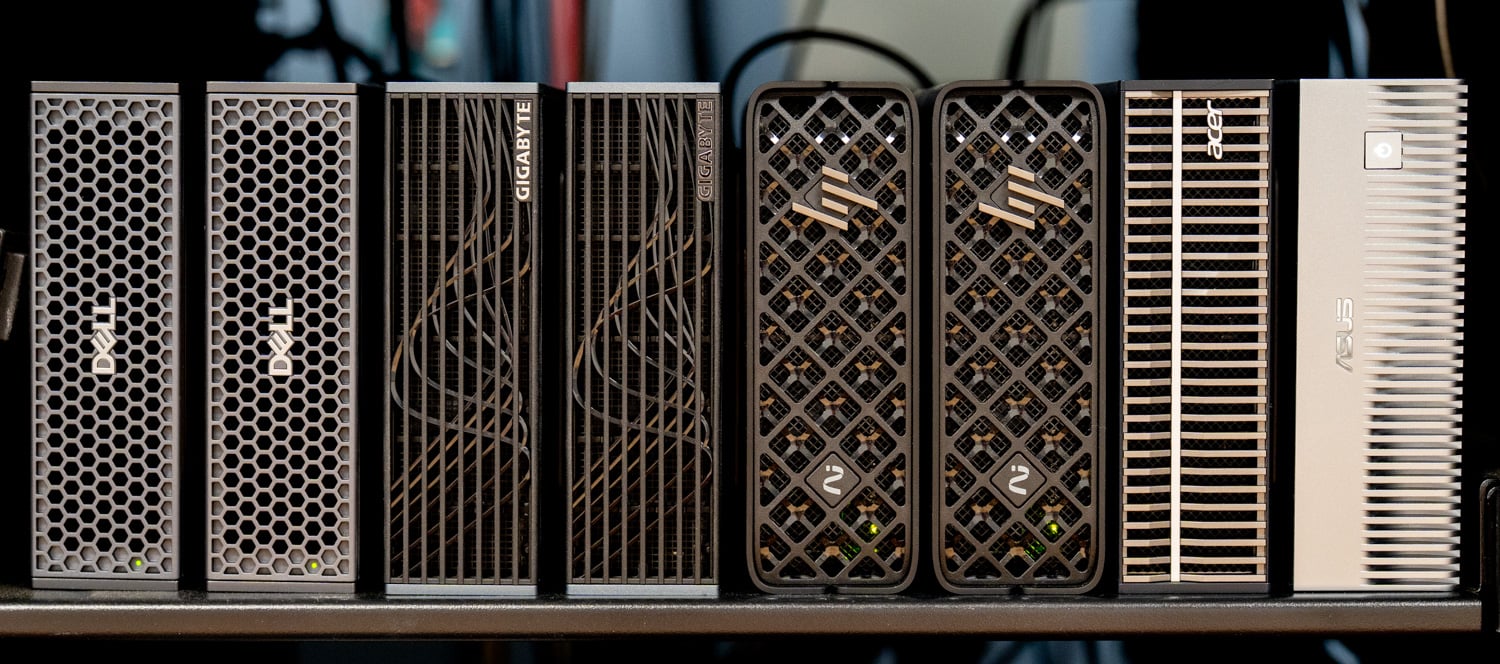
Каждое устройство DGX Spark и его OEM-варианты от Dell, GIGABYTE, HP, Acer и ASUS поставляются с единственным слотом M.2 (короткого форм-фактора), что ограничивает локальную емкость примерно 4 ТБ. В результате все наборы данных, модели и чекпоинты оказываются вне зоны действия механизмов управления, контроля доступа, резервного копирования и аудита, принятых в центре обработки данных. Если масштабировать это на уровень лаборатории, департамента или целого кампуса, возникают десятки изолированных «островов» по 4 ТБ, каждый из которых хранит собственную копию одних и тех же моделей, при этом безопасность данных ограничена лишь физической защищенностью рабочего места.
В нашем первоначальном обзоре DGX Spark мы определили систему хранения как наиболее очевидное ограничение платформы. Внутренний слот поддерживает только короткие накопители M.2, поэтому клиентские SSD емкостью 8 ТБ в форм-факторе 2280 физически туда не помещаются. Решение Luisuantech GP Spark, которое мы тестировали в августе, предполагает использование корпуса с четырьмя отсеками M.2, подключенного к порту 100GbE. Это удобное решение для одного устройства, но при расширении до масштабов лаборатории оно лишь создает более крупные «силосы» данных на каждом столе.
Емкость — это лишь половина проблемы. Вторая половина заключается в судьбе данных после их попадания на настольную систему. Модель объемом 78 ГБ, загруженная на Spark, становится копией, невидимой для IT-отдела. Набор данных для исследований, размещенный на локальной флэш-памяти, выпадает из графика резервного копирования, политики доступа и институциональных аудитов. Десять систем Spark в лаборатории означают десять копий одних и тех же весов, занимающих 780 ГБ дискового пространства, и десять точек потенциальной утечки данных вместе с оборудованием. Эта проблема усугубляется по мере роста парка систем GB10 или любой другой настольной ИИ-инфраструктуры. Организации, управляющие парком ноутбуков, знакомы с этим сценарием: единственный способ решения — хранить данные в центре обработки данных, используя общее хранилище, а рабочие станции оставлять лишь конечными точками.
Реализация централизованного хранилища для DGX Spark
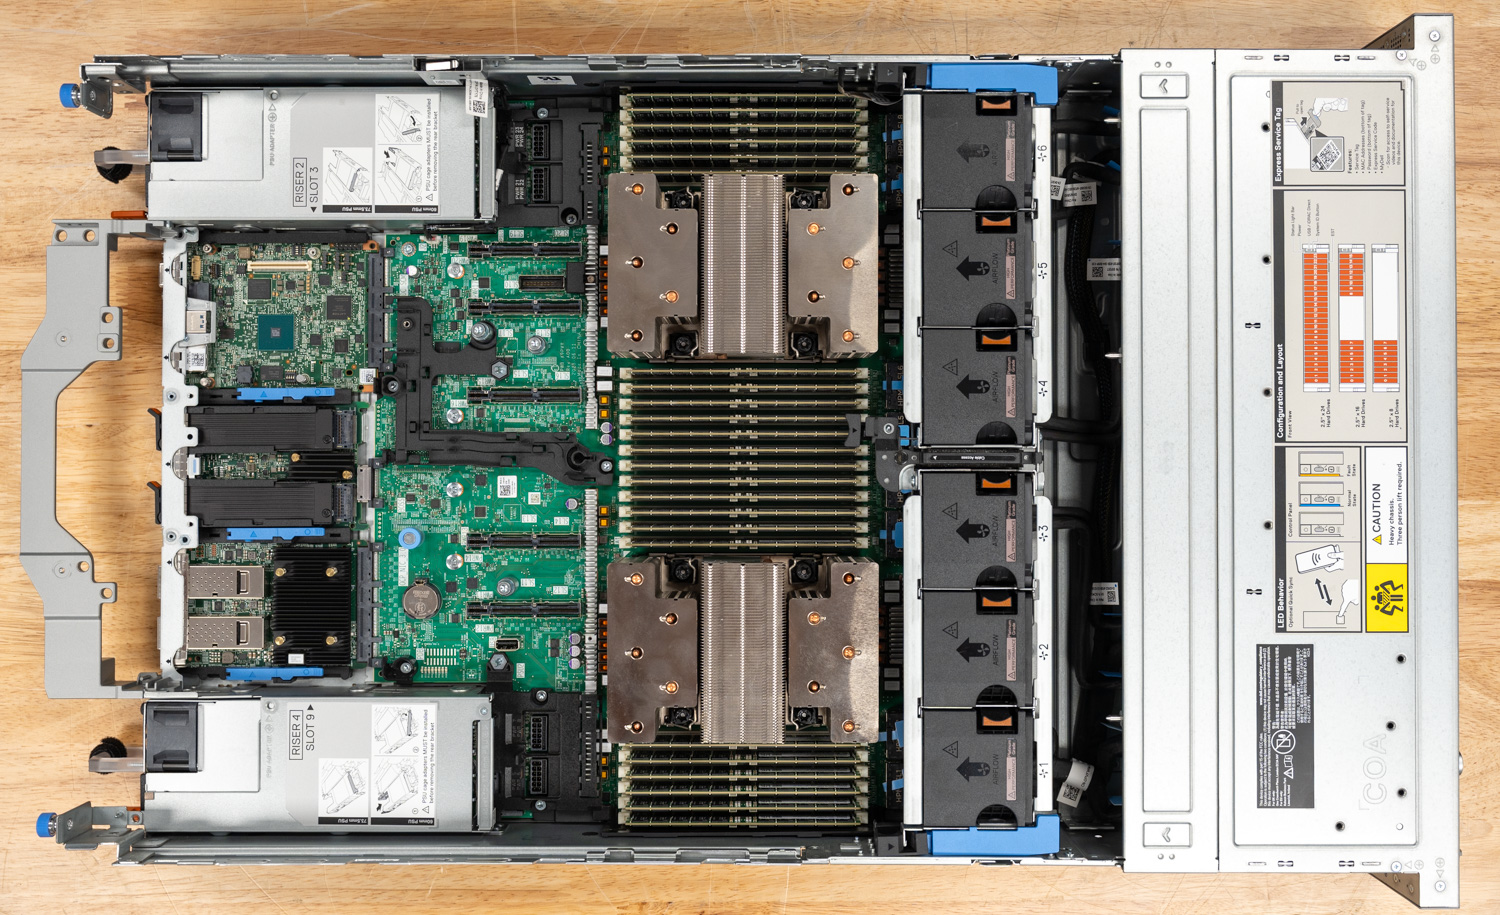
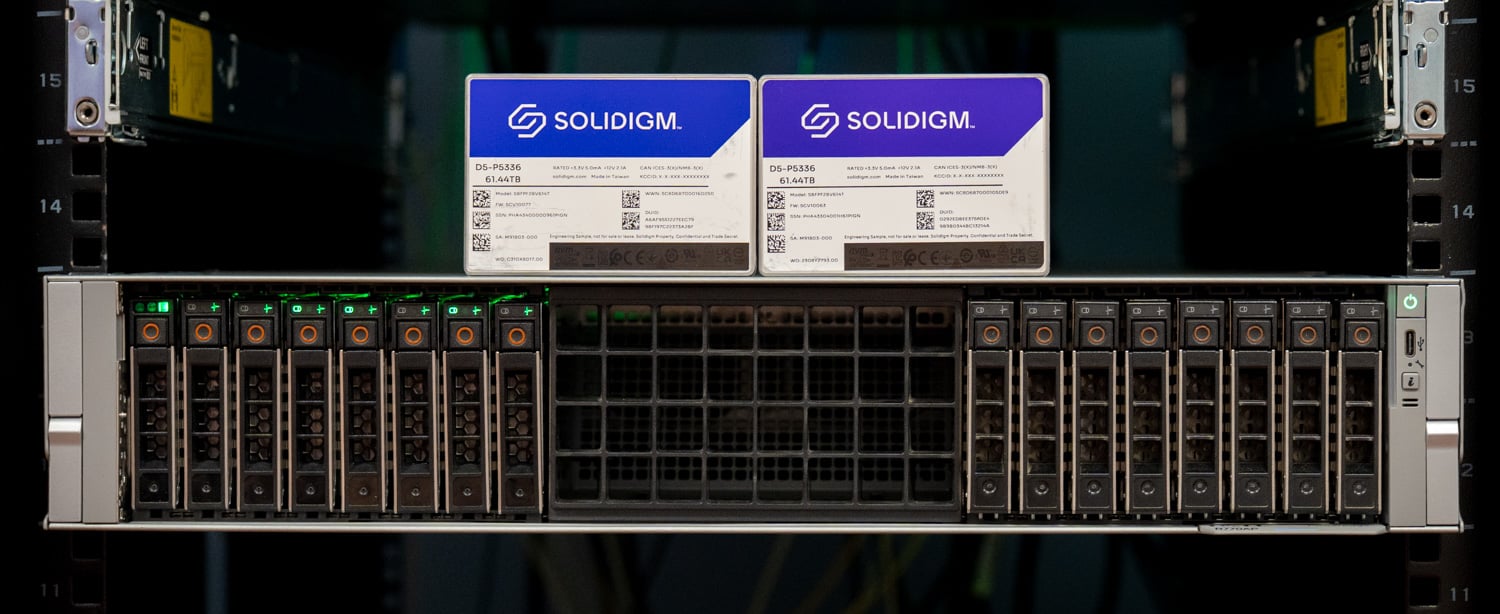
Данный проект возвращает проблему хранения данных в центр обработки данных. Мы создали хост для общего хранилища DGX Spark на базе сервера Dell PowerEdge R770AP, оснастив его восемью SSD-накопителями Solidigm D5-P5336 QLC, контроллером Graid SupremeRAID (RAID 5), сетевыми адаптерами Broadcom 400GbE и программным обеспечением Tuxera Fusion для передачи NFS через RDMA. К портам 100GbE этого сервера мы подключили восемь систем Spark.
Каждый Spark в этой сети монтирует единый управляемый пул хранения с защитой по четности с помощью одной команды. В результате одна копия каждой модели или датасета обслуживает все устройства, рабочим станциям не требуется дополнительное хранилище сверх штатного, а сами системы Spark можно переместить в стойку рядом с массивом, где их проще охлаждать, защищать и совместно использовать. Любой NVMe-сервер с быстрыми сетевыми интерфейсами может выполнять эту роль.
При проектировании мы учитывали опыт Университета штата Орегон, который изучает возможность создания крупномасштабной лаборатории на базе Spark для обучения ИИ. Им требуется предоставить студентам доступ к исследовательским данным объемом в десятки терабайт, и для таких масштабов предложенный подход с общим хранилищем оказался наиболее подходящим.
Ключевые результаты тестирования
- Один массив, восемь систем, без клиентского ПО: Восемь устройств DGX Spark монтируют NFS/RDMA-ресурсы с единого массива на базе Solidigm D5-P5336 QLC, работающего через Graid SupremeRAID и Tuxera Fusion, используя штатные порты 100GbE и одну команду монтирования в стандартной Ubuntu.
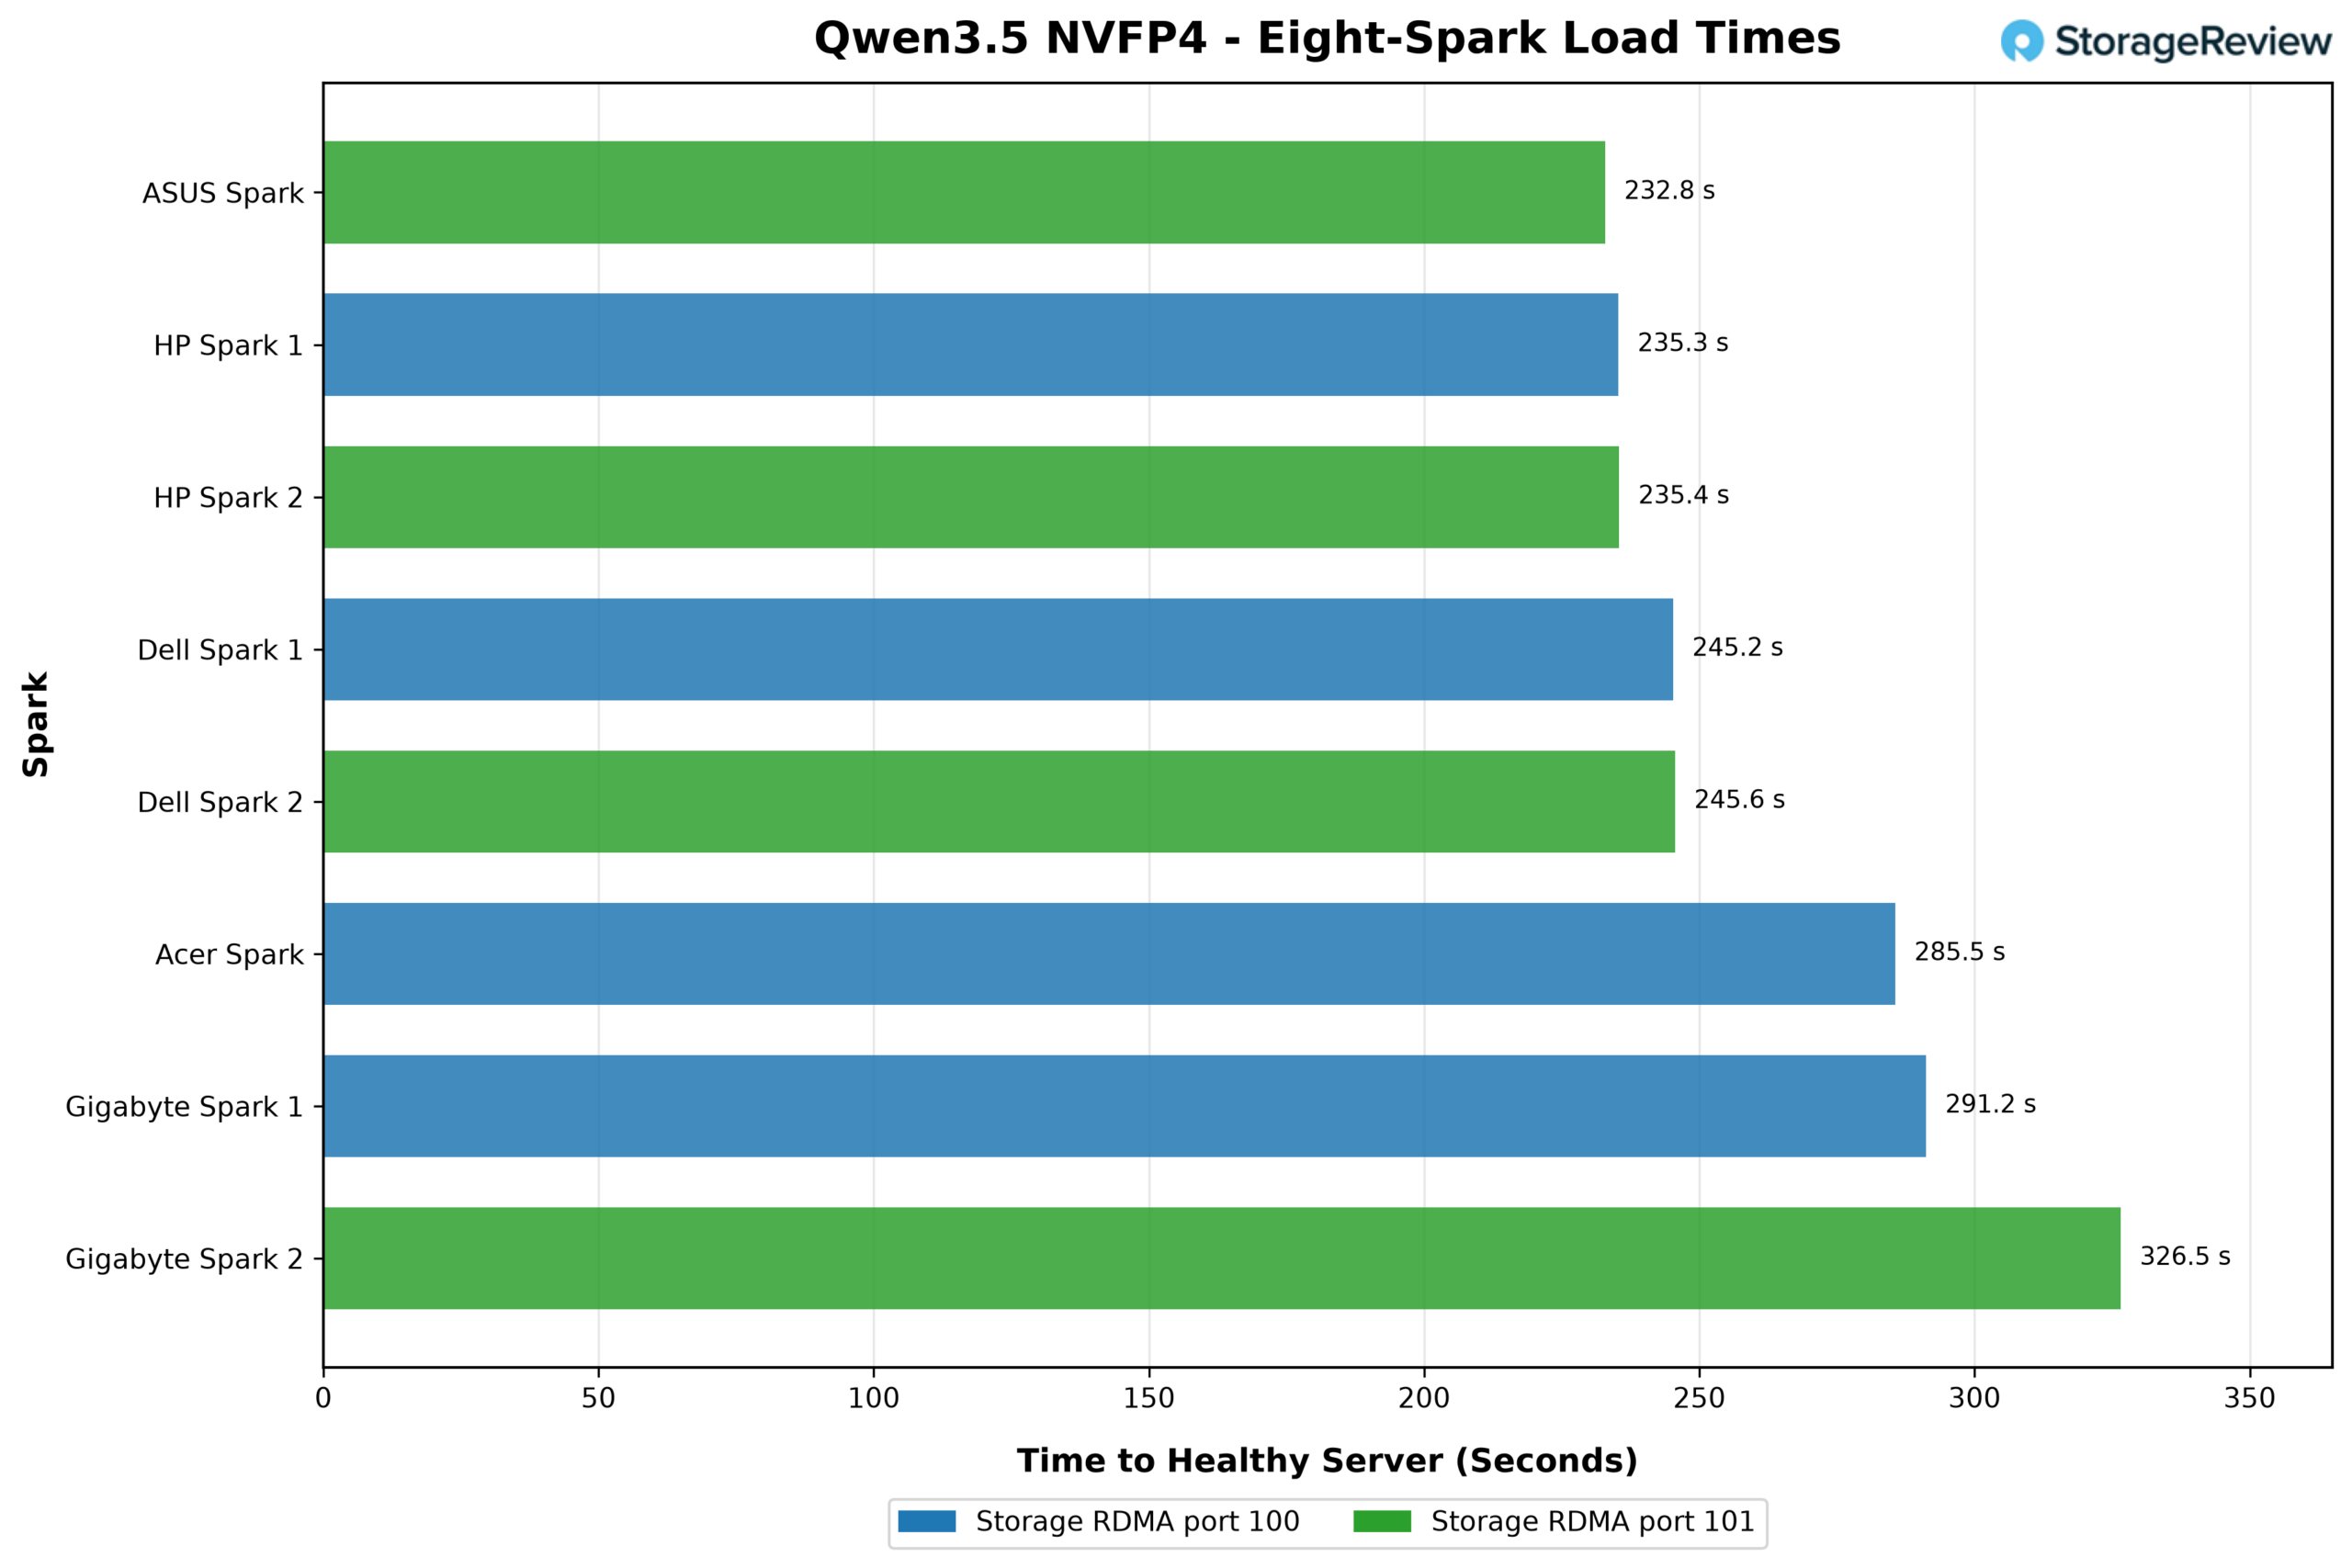
- Загрузка моделей как с локального диска: Модель Qwen3.5-122B-A10B-NVFP4 объемом 78 ГБ загружалась с общего массива на один Spark за 269,6 секунды, что лишь на 13% медленнее, чем при загрузке с внутреннего NVMe (239,6 секунды). При одновременной загрузке той же копии на восемь систем время составило от 232,8 до 326,5 секунды.
- Эффективность использования данных: Модели и датасеты находятся на защищенном хранилище ЦОД. Это повышает коэффициент использования ресурсов, сокращает дублирование данных и избавляет от необходимости апгрейда накопителей в самих Spark.
- Производительность сети и массива: При одновременном чтении всеми восемью системами массив из восьми дисков в RAID 5 выдавал около 25 ГиБ/с (около 214 Гбит/с), что составляет лишь 27% от пропускной способности 800 Гбит/с, обеспечиваемой двумя сетевыми картами Broadcom BCM57608 на хосте. Один Spark при чтении с массива достигает 10,8 ГиБ/с, что соответствует показателям самых быстрых внутренних M.2-накопителей в системах GB10.
- Контроль доступа: Протокол NFS с RDMA позволяет объединить пользовательские папки, общие датасеты и модели в единое пространство имен с поддержкой Active Directory, Kerberos и LDAP. Это обеспечивает централизованное управление данными при размещении систем Spark в серверной стойке.
Сетевая архитектура и роль Spark
Каждое устройство оснащено двумя разъемами QSFP56 на базе интегрированного контроллера ConnectX-7, что обеспечивает суммарную пропускную способность до 200 Гбит/с через пару линий PCIe Gen5 x4. В рамках нашего обзора кластера DGX Spark мы рассматривали конфигурацию с разделением ролей, где один разъем направлен на одноранговый Spark, а второй — на систему хранения данных. В данном проекте используется один разъем на каждый Spark для подключения к хранилищу на скорости 100 Гбит/с, что оставляет второй свободным для задач кластеризации или увеличения пропускной способности.
При скорости 100 Гбит/с каждый Spark получает около 12,5 ГБ/с теоретической пропускной способности к хосту хранения, что превышает показатели внутреннего слота M.2 в большинстве подобных систем. После подключения к сети роль Spark меняется: устройство становится вычислительной конечной точкой с загрузочным и локальным кэширующим накопителем, где емкость перестает быть параметром, приобретаемым для каждой рабочей станции отдельно. Модели и наборы данных записываются один раз и считываются всеми клиентами, что повышает эффективность использования хранилища и снижает количество дубликатов. Защита данных переносится на массив с контролем четности в серверном корпусе, а контроль доступа, шифрование данных, резервное копирование и аудит выполняются централизованно. Поскольку Spark теперь требует только питания и подключения 100 Гбит/с, он может находиться в серверной стойке рядом с хостом хранения, что обеспечивает лучшее охлаждение, тишину, физическую безопасность и доступность для любого пользователя.
Сервер хранения данных
В качестве хоста хранения используется Dell PowerEdge R770AP — платформа 2U на базе процессоров Xeon 6, которую мы тестировали ранее. Любой NVMe-сервер с местом для быстрых сетевых карт и компактным графическим ускорителем может выполнять эту роль. Наша система оснащена двумя процессорами Xeon 6 6978P и 1,5 ТБ памяти DDR5, распределенной по 24 модулям DIMM. Задействован один из двух банков на восемь отсеков Gen5 NVMe; накопители и графический ускоритель Graid подключены к CPU 0, а два адаптера 400 Гбит/с — к CPU 1. Сервер работает под управлением Ubuntu 24.04.
Выбор технологии QLC и накопителей D5-P5336
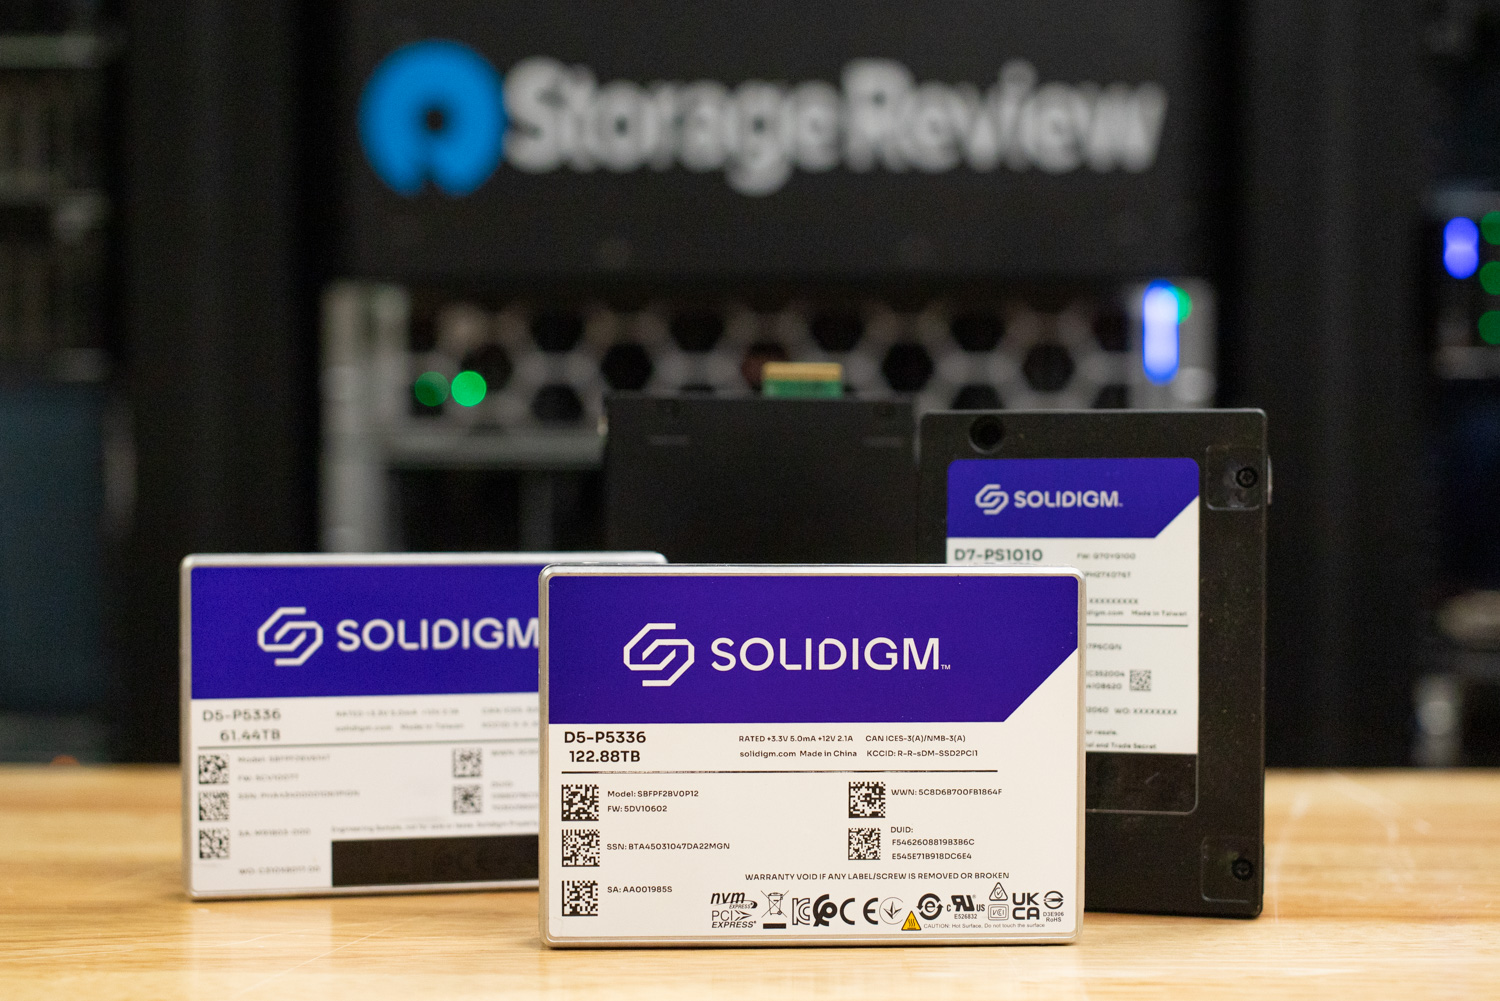
При проектировании лаборатории Spark основным требованием была емкость, так как исследовательские наборы данных крайне велики. Данная система должна хранить все необходимые данные для множества клиентов одновременно. Это профиль с преобладанием операций чтения, большими блоками данных и высокой емкостью — именно для этого создавалась память QLC. Семейство накопителей D5-P5336 варьируется от 7,68 ТБ до 122,88 ТБ. Используемые здесь модели на 61,44 ТБ (U.2) обладают характеристиками: до 7000 МБ/с при последовательном чтении, 3000 МБ/с при последовательной записи, 1,005 млн IOPS при случайном чтении 4K и ресурсом 65,2 ПБ записи (около 0,58 записи на весь диск в день в течение пяти лет) на базе 192-слойной NAND QLC с блоком переадресации 16 КБ.
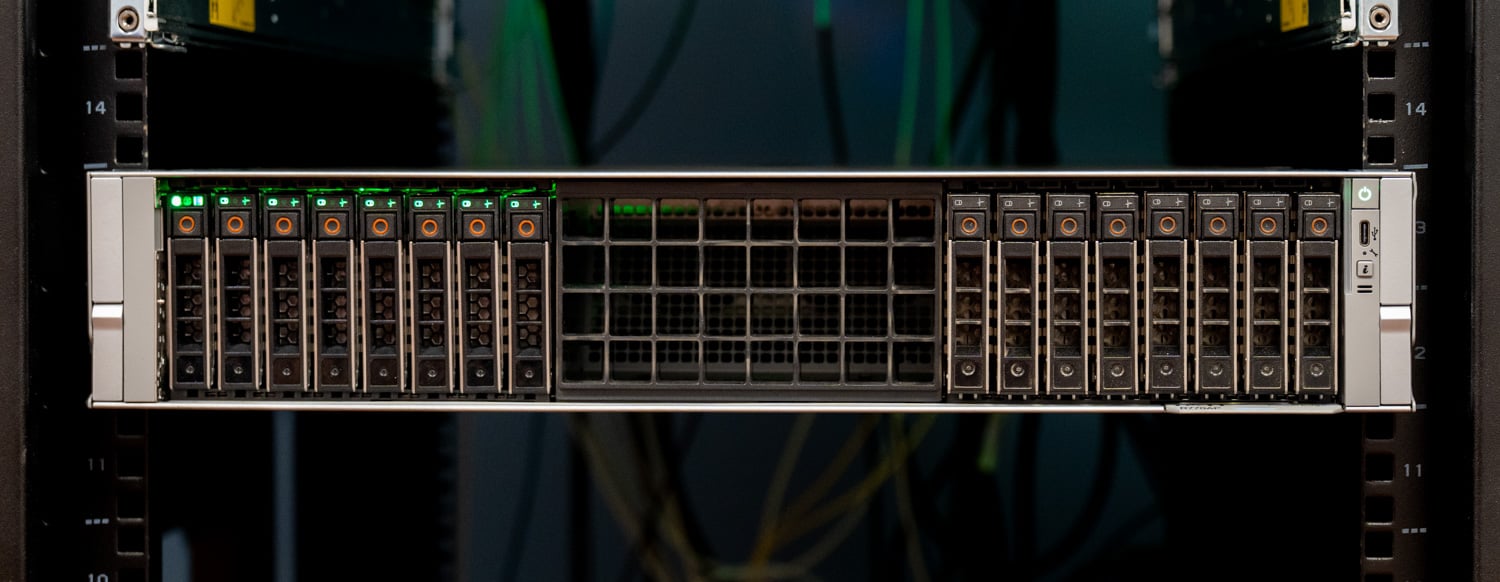
Восемь накопителей по 61,44 ТБ занимают половину передних отсеков R770AP. В конфигурации RAID 5 восемь дисков предоставляют около 430 ТБ полезного пространства с отказоустойчивостью одного диска. Это более чем в 100 раз превышает объем слота M.2 в Spark, что достаточно для библиотек моделей департамента, общих наборов данных и домашних директорий пользователей. Заполнение оставшихся восьми отсеков удваивает емкость без изменения сетевой архитектуры. Размер блока переадресации 16 КБ критичен: большая IU от Solidigm жертвует эффективностью случайной записи ради плотности и стоимости, что оправдано для серверов моделей и данных, где случайные записи — редкий сценарий. Модели и наборы данных загружаются через последовательное чтение, а файлы записываются один раз и читаются часто. Таким образом, разделение труда оптимально: общий QLC-массив хранит данные для всех, а M.2 в Spark берет на себя временные задачи (scratch и swap).
RAID на GPU с Graid SupremeRAID
Для восьми накопителей Gen4, каждый из которых способен читать на скорости 7000 МБ/с, обычная аппаратная RAID-карта становится узким местом, так как данные должны проходить через слот PCIe карты. Программный RAID сталкивается с иными ограничениями ресурсов. Graid SupremeRAID переносит вычисления четности на GPU, сохраняя путь данных на линиях PCIe хоста, что в наших тестах позволило достичь пропускной способности свыше 180 ГБ/с с 16 дисками. Для этого хоста мы использовали NVIDIA RTX A2000. Накопители D5-P5336 были очищены, последовательно заполнены и объединены в массив RAID 5. Полученный виртуальный диск был отформатирован в XFS и представлен средствами Tuxera. RAID 5 выбран как оптимальный уровень: отказ одного диска не прерывает доступ к данным пользователей, восстановление происходит в фоновом режиме, а потеря емкости составляет лишь один из восьми дисков.
Организация сетевой архитектуры и выбор протоколов передачи данных
Для производственного развертывания, где защита во время пересборки массива важнее максимальной емкости, оптимальным выбором станут уровни RAID 6 или RAID 10, поддержку обоих из которых обеспечивает технология SupremeRAID.
Сетевая инфраструктура: Broadcom 400GbE и ядро 800G
Сетевая часть системы хранения данных базируется на двух адаптерах Broadcom BCM57608 Thor 2, установленных в сервер R770AP. Каждый адаптер представляет собой однопортовую сетевую карту 400GbE с интерфейсом PCIe Gen5 x16. Компания Broadcom позиционирует BCM57608 как самый энергоэффективный 400G-адаптер в отрасли. Его возможности включают поддержку RoCEv2 с расширенным механизмом контроля перегрузок DCQCN, адаптивную маршрутизацию, безопасную загрузку с доверенным корнем на уровне кремния и аппаратную разгрузку шифрования kTLS.
В данной архитектуре протокол RoCEv2 обеспечивает передачу NFS поверх RDMA, а контроль перегрузок предотвращает взаимные помехи между клиентами при одновременном обращении к данным. В процессе сборки драйвер bnxt_en зафиксировал достижение оптическими модулями 400G-портов температурного порога в 70°C при длительной нагрузке. Проблема была решена путем внесения небольшого смещения в профиль работы вентиляторов сервера R770AP, после чего сетевые карты работали в штатном режиме.
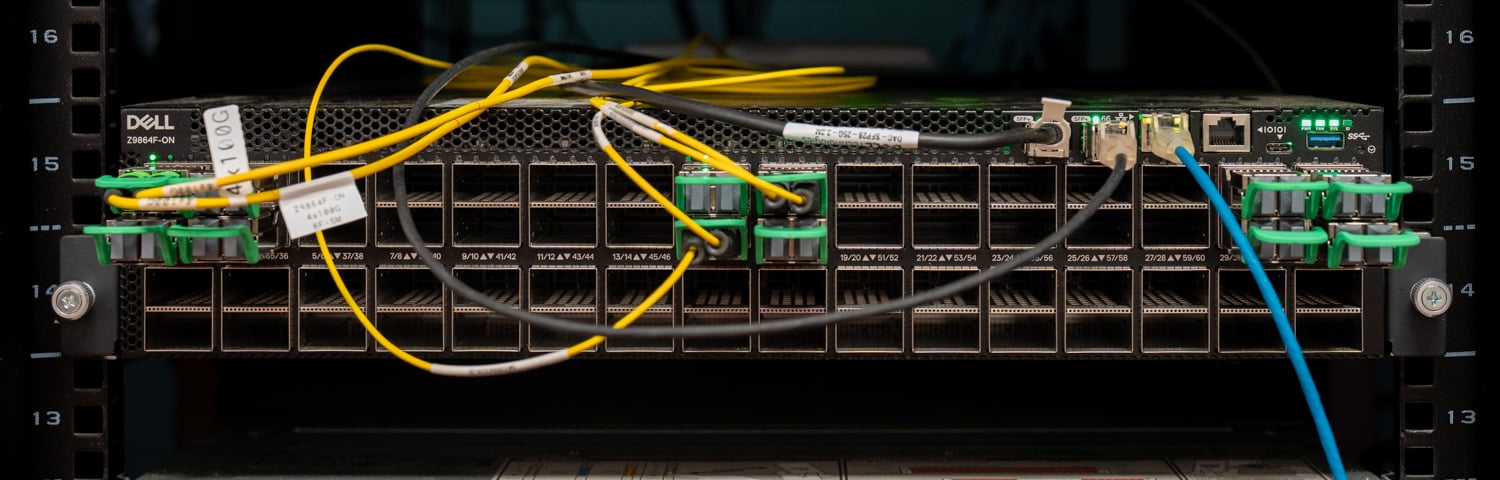
Оба адаптера подключены к коммутатору Dell PowerSwitch Z9864F-ON — центральному узлу лаборатории класса 800G под управлением ОС Enterprise SONiC. Модель Z9864F-ON оснащена 64 портами OSFP112 стандарта 800GbE с возможностью деления каждого порта на 2x400G, 4x200G или 8x100G. Один оптический канал 800G, разделенный на восемь портов по 100G, обеспечивает соединение для восьми систем Spark (по одному линку на устройство). При этом каждая 400G-карта находится в отдельной VLAN и обслуживает четыре Spark, что позволяет равномерно распределить нагрузку между двумя целями RDMA. Фактическая топология обеспечивает пропускную способность клиентской стороны 8x100G и 2x400G на стороне хранилища при суммарной емкости коммутатора в 102,4 Тбит/с.
Валидация фабрики была проведена до развертывания программного обеспечения СХД. Тесты «сервер-сервер» между R770AP и вторым узлом показали работу на полной линейной скорости в обоих направлениях, а трафик RDMA от систем Spark подтвердил работоспособность портов 100G breakout на полной скорости. После настройки NFS-ресурсов инженерами Tuxera тест iperf3 от Spark к соответствующим сетевым картам продемонстрировал стабильную скорость 99 Гбит/с при четырех параллельных потоках с нулевым количеством повторных передач.
Выбор в пользу NFS и Tuxera Fusion
Поскольку Graid предоставляет высокопроизводительное блочное устройство, сервер хранения данных мог работать как в режиме NVMe-oF (блочные цели), так и в качестве файлового сервера. Блочный режим, протестированный ранее с одним клиентом Spark, отлично справляется с задачами, однако для масштабируемой лабораторной среды он не подходит. Блочные тома предполагают соединение «один к одному», что требует создания LUN для каждого пользователя; при необходимости совместного использования одного набора данных пришлось бы его копировать, что противоречит концепции данной архитектуры. Протокол NFS позволяет реализовать единое пространство имен для хранения общих наборов данных, моделей и персональных папок.
Каждое подключение Spark использует стандартный NFS-клиент Ubuntu, а инструменты управления Kubernetes и Slurm, используемые в университетской среде, поддерживают протокол NFS по умолчанию. В качестве реализации используется Fusion NFS — часть мультипротокольного файлового сервера Tuxera Fusion, работающего в пользовательском режиме на базе многопоточного ядра. В собственных тестах Tuxera заявлена пропускная способность до 22,7 ГБ/с через одно 200GbE-соединение с RDMA, что превосходит результаты kernel NFSD и Ganesha. Продукт поддерживает NFS 4.1, активное масштабирование кластеров, прозрачное переключение при отказах, а также интеграцию с Active Directory, Kerberos и LDAP. Последнее обеспечивает управление доступом: права доступа к директориям синхронизированы с учетными записями пользователей Spark.
Важное уточнение: использованная версия Fusion NFS является предварительной (private preview) и не была полностью оптимизирована по производительности; коммерческий релиз запланирован на ноябрь после конференции SC’26. Инженеры Tuxera установили Fusion на R770AP, отформатировали том Graid в XFS и настроили NFS на стандартном порту, а RPC-RDMA на порту 20049. Начальная конфигурация включала четыре протокольных потока с восьмью дополнительными потоками для передачи данных, метаданных и транспорта. На стороне Spark подключение ресурса выполняется одной командой: sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs. Это не требует установки драйверов или стороннего ПО, а любой пользователь при входе в систему получает доступ к файлам посредством аналогичной команды.
Проверка конфигурации: восемь узлов Spark на одном наборе данных
Перед началом работы с моделями мы провели первичную проверку каждого узла Spark по отдельности: запустили последовательное чтение 1M через fio с 16 заданиями и глубиной очереди 16 для выделенной папки на массиве. Все восемь устройств продемонстрировали показатели от 10,0 до 11,2 ГиБ/с, полностью утилизировав свои 100GbE-каналы.
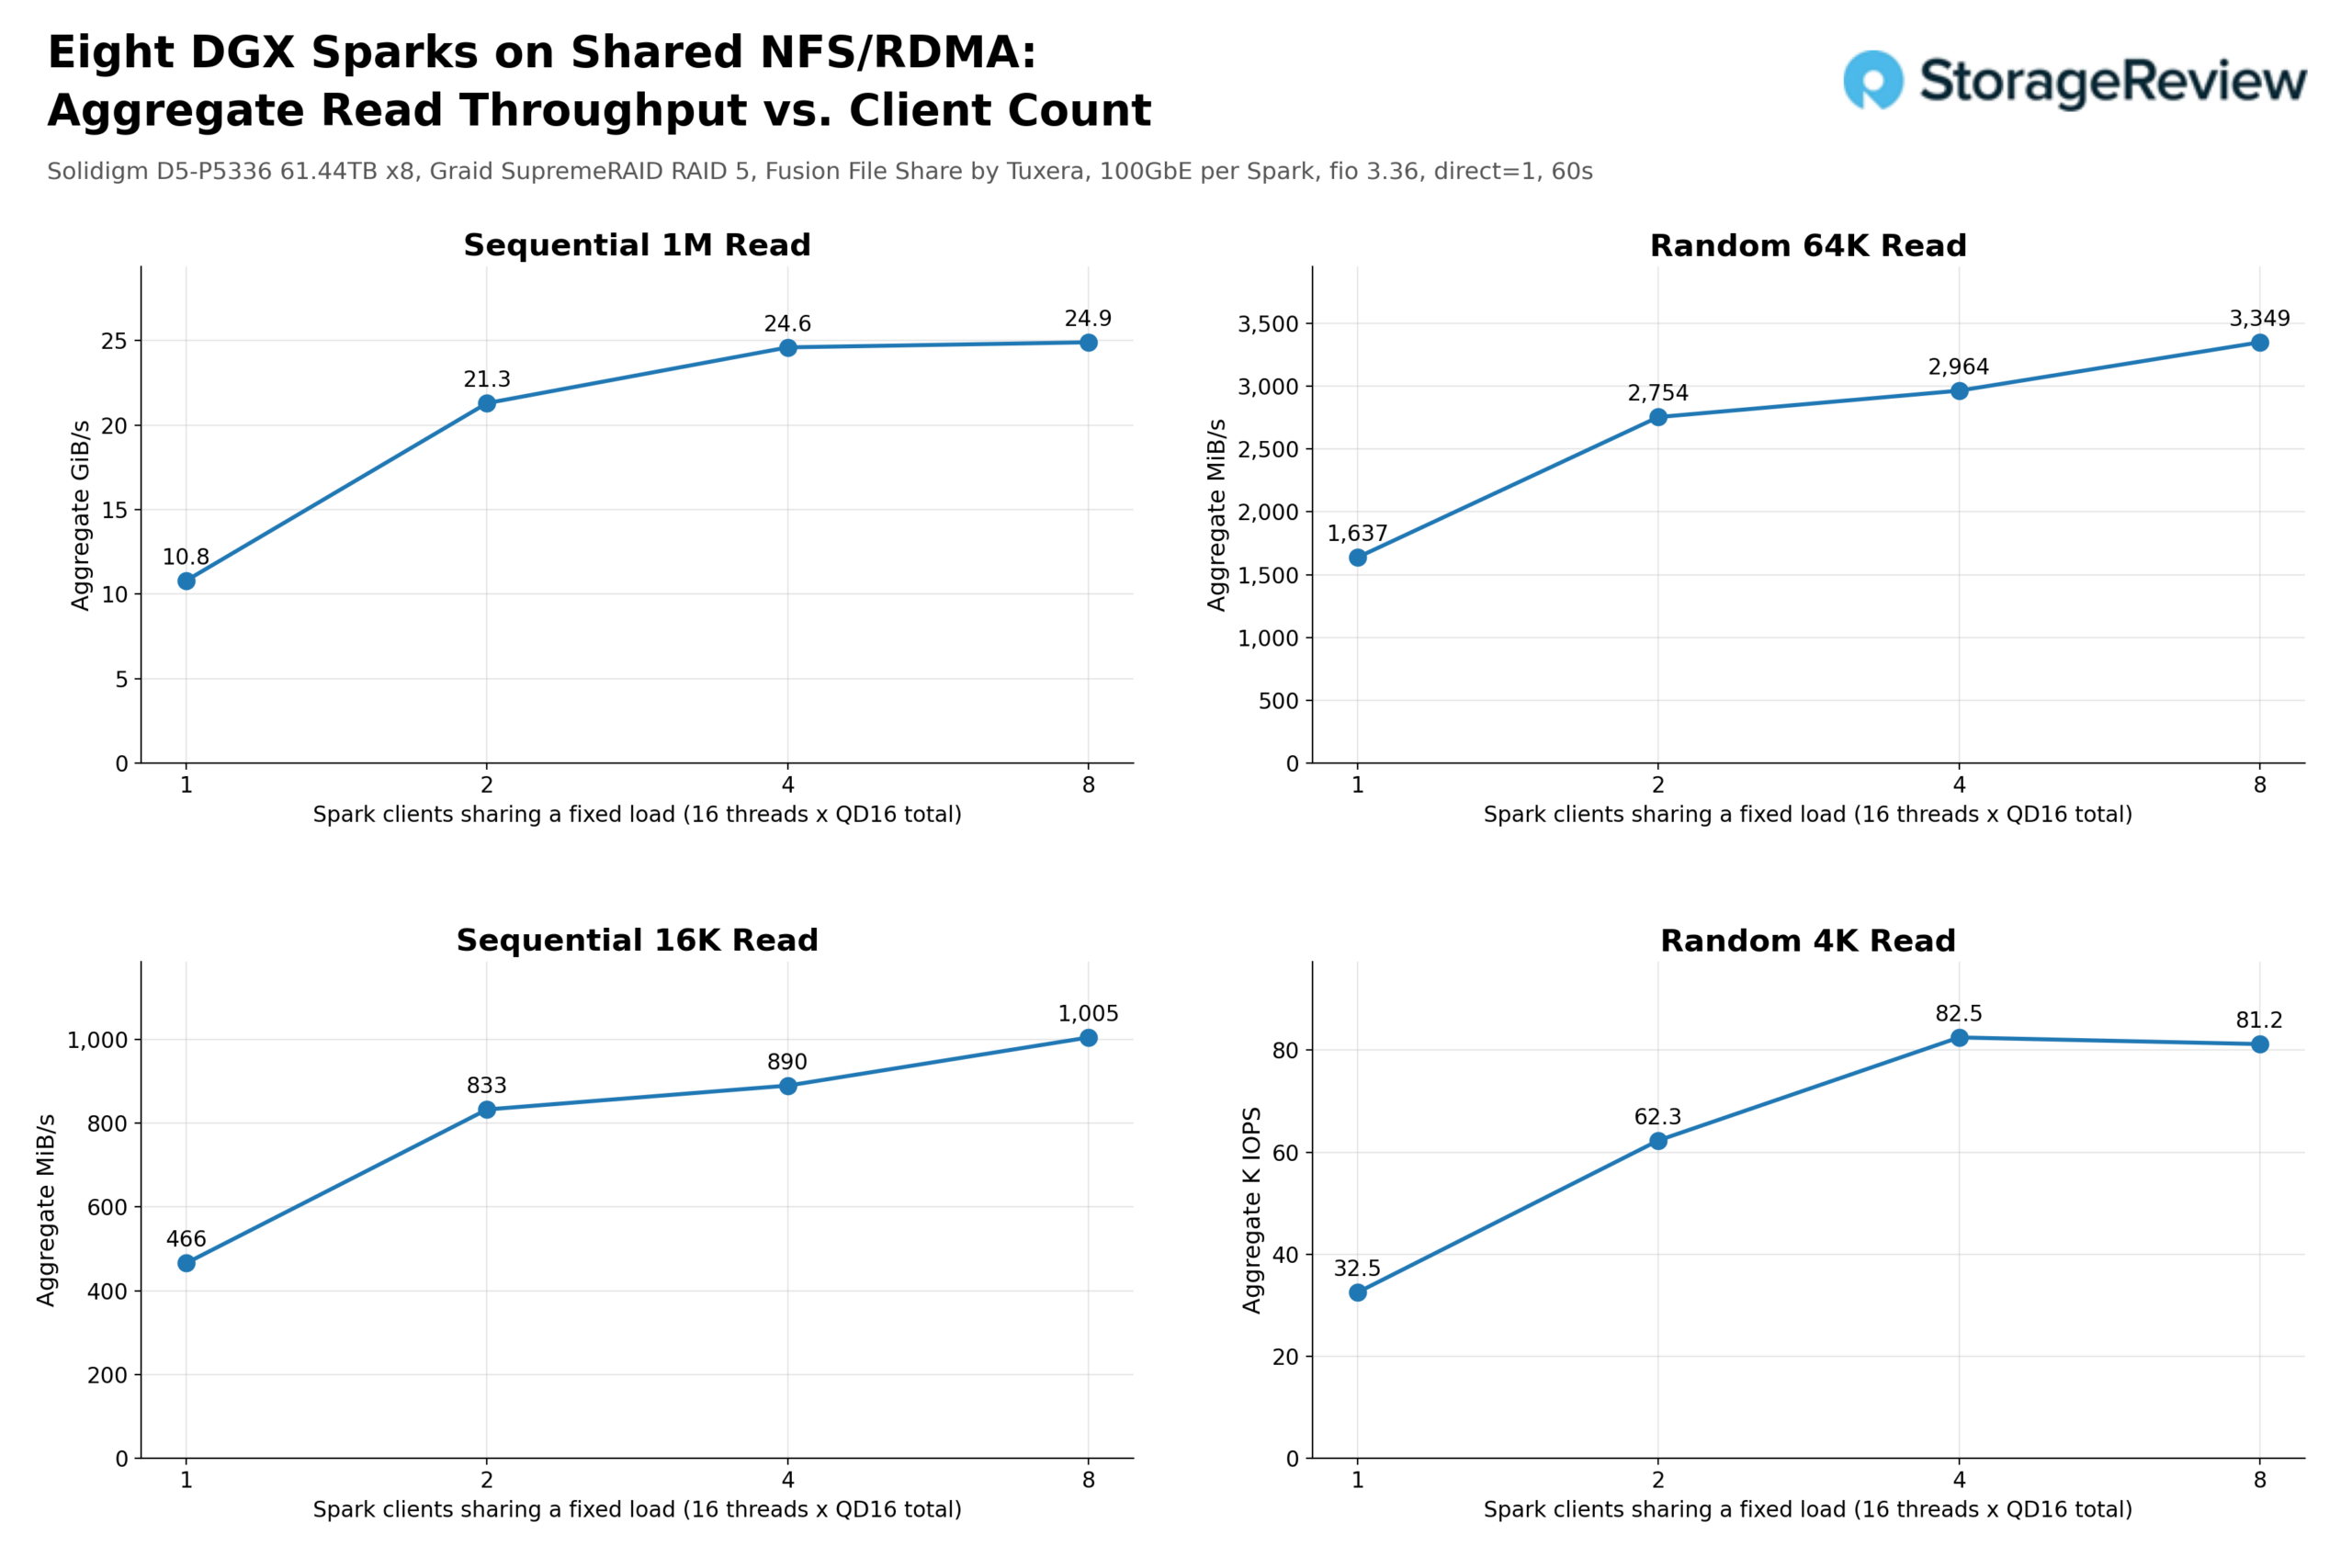
Затем мы провели комплексное тестирование, чтобы подтвердить способность всех восьми узлов распределять нагрузку. Каждый цикл включал суммарно 16 потоков с глубиной очереди 16, распределенных между одним, двумя, четырьмя и восемью узлами Spark. Использовались последовательные нагрузки 1M и 16K, а также случайные нагрузки 64K и 4K при чтении и записи, с прямым I/O и длительностью теста 60 секунд. Каждый Spark записывал данные в собственную папку на массиве (по четыре на один сетевой интерфейс хранилища), при этом функции QoS в стеке отсутствовали.
При одновременной нагрузке на все восемь узлов показатели последовательного чтения 1M варьировались от 3,09 до 3,13 ГиБ/с на устройство, случайного чтения 64K — от 6 648 до 6 779 IOPS, а случайной записи 4K — от 2 136 до 2 155 IOPS. Тестирование проводилось на оборудовании пяти OEM-производителей в двух VLAN без механизмов принудительного распределения нагрузки. Каждый узел получил равную долю ресурсов массива, подтвердив готовность конфигурации к рабочим задачам.
Оценка параметров хоста: два сетевых интерфейса и запас производительности
Результаты тестирования позволяют определить предел пропускной способности и выявить узкие места хоста. Совокупная скорость последовательного чтения 1M увеличилась с 10,8 ГиБ/с при использовании одного Spark до 21,3 ГиБ/с для двух, 24,6 ГиБ/с для четырех и 24,9 ГиБ/с для восьми узлов.
В сетевом выражении это соответствует 93 Гбит/с, 183 Гбит/с, 212 Гбит/с и 214 Гбит/с при общей пропускной способности 800 Гбит/с, обеспечиваемой двумя сетевыми картами Broadcom 400GbE. Таким образом, при полной нагрузке на восемь клиентов массив задействовал лишь 27% сетевой емкости хоста. Плато производительности вблизи 25 ГиБ/с обусловлено работой QLC-массива в режиме RAID 5; сетевые карты, коммутаторы и 100GbE-интерфейсы самих узлов Spark не стали ограничивающими факторами.
Два серверных сетевых интерфейса способны обслуживать восемь узлов Spark на полной скорости и справились бы с нагрузкой еще восьми отсеков R770AP. Увеличение количества накопителей обеспечит более высокую пропускную способность для чтения при использовании тех же двух портов. Аналогичная картина наблюдается и с операциями ввода-вывода: случайное чтение 4K выросло с 32,5 тыс. IOPS на одном клиенте до 81 тыс. IOPS при четырех и более узлах, при этом латентность снизилась с 7,9 мс до 3,1 мс за счет уменьшения глубины очереди на каждого клиента. Случайное чтение 64K показало рост с 1 637 до 3 349 МиБ/с, при этом сетевой лимит достигнут не был.
Сравнение с локальными накопителями узлов Spark показывает следующее: в тестах GB10 чтение GDSIO 1M на Acer Veriton GN100 и GIGABYTE AI TOP ATOM достигало 11,2 ГиБ/с. Dell Pro Max с GB10 и HP ZGX Nano G1n показали около 5,5 ГиБ/с, а ASUS Ascent GX10 — около 5 ГиБ/с. Внешний NVMe-oF блок Luisuantech GP Spark выдал 9,5 ГБ/с через тот же 100GbE-порт. Использование одного Spark с общим QLC-массивом обеспечивает скорость 10,8 ГиБ/с, что сопоставимо с самыми быстрыми внутренними накопителями и почти вдвое превышает показатели самых медленных, при этом данные доступны для всех остальных узлов.
В то время как показатели чтения растут по мере добавления клиентов до достижения лимита массива, показатели записи остаются неизменными из-за ограничений, накладываемых расчетом четности RAID 5. Для архитектуры, ориентированной на интенсивное чтение общих данных и однократную запись при загрузке, такой профиль является целевым.
Размещение моделей на общем хранилище
Мы проверили, насколько эффективно модель загружается с общего массива по сравнению с локальным NVMe. Была выбрана Qwen3.5-122B-A10B в формате NVFP4 — смесь экспертов (MoE) на 122 млрд параметров, занимающая 78 ГБ на диске и полностью умещающаяся в 128 ГБ объединенной памяти одного Spark.
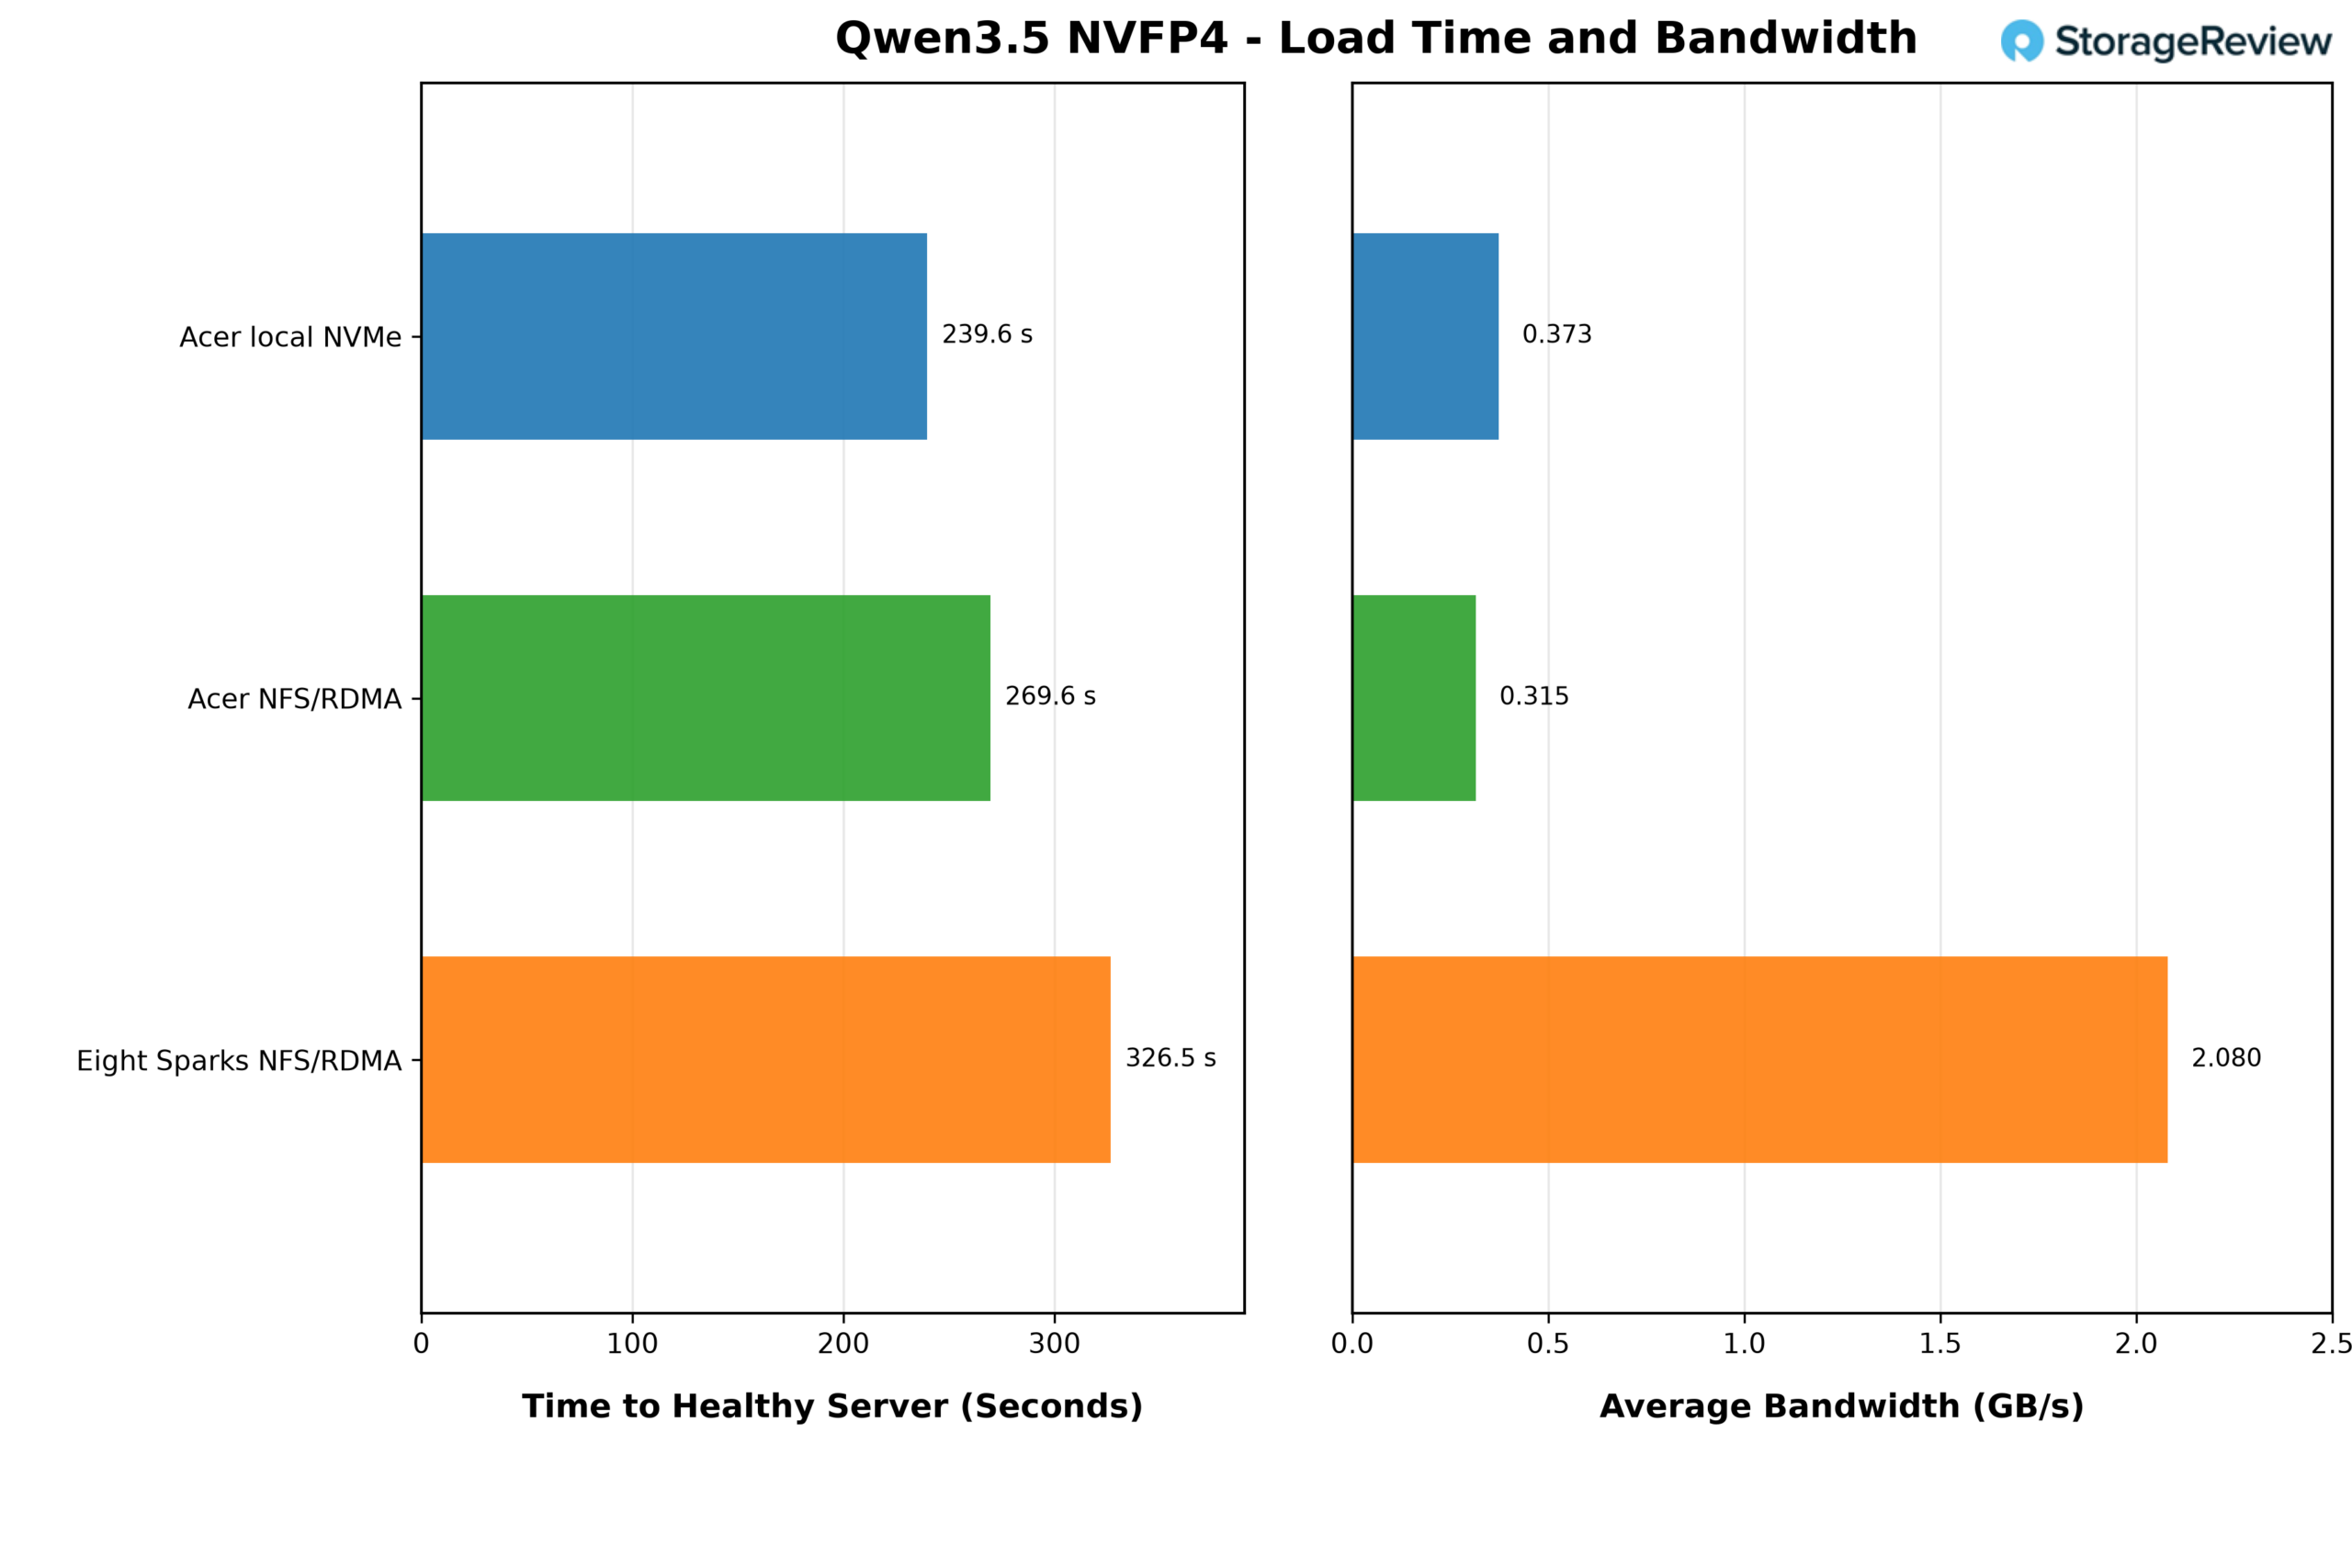
Измерялось время от запуска сервера до достижения статуса готовности и средняя пропускная способность хранилища. Результаты:
- Локальный NVMe: Acer Veriton GN100 достиг готовности за 239,6 секунды при средней скорости 0,373 ГБ/с.
- Общий массив по NFS/RDMA: тот же Spark затратил 269,6 секунды при скорости 0,315 ГБ/с (задержка увеличилась на 30 секунд, или 13%).
Анализ производительности и практическое применение в инфраструктуре
Средние показатели демонстрируют, что при загрузке 78 ГБ данных за четыре минуты процесс загрузки модели на Spark не упирается в ограничения подсистемы хранения ни в одном из сценариев. Фактическим ограничителем скорости выступает обработка весов самим чипом GB10, из-за чего накопитель большую часть времени ожидает завершения операций процессором.
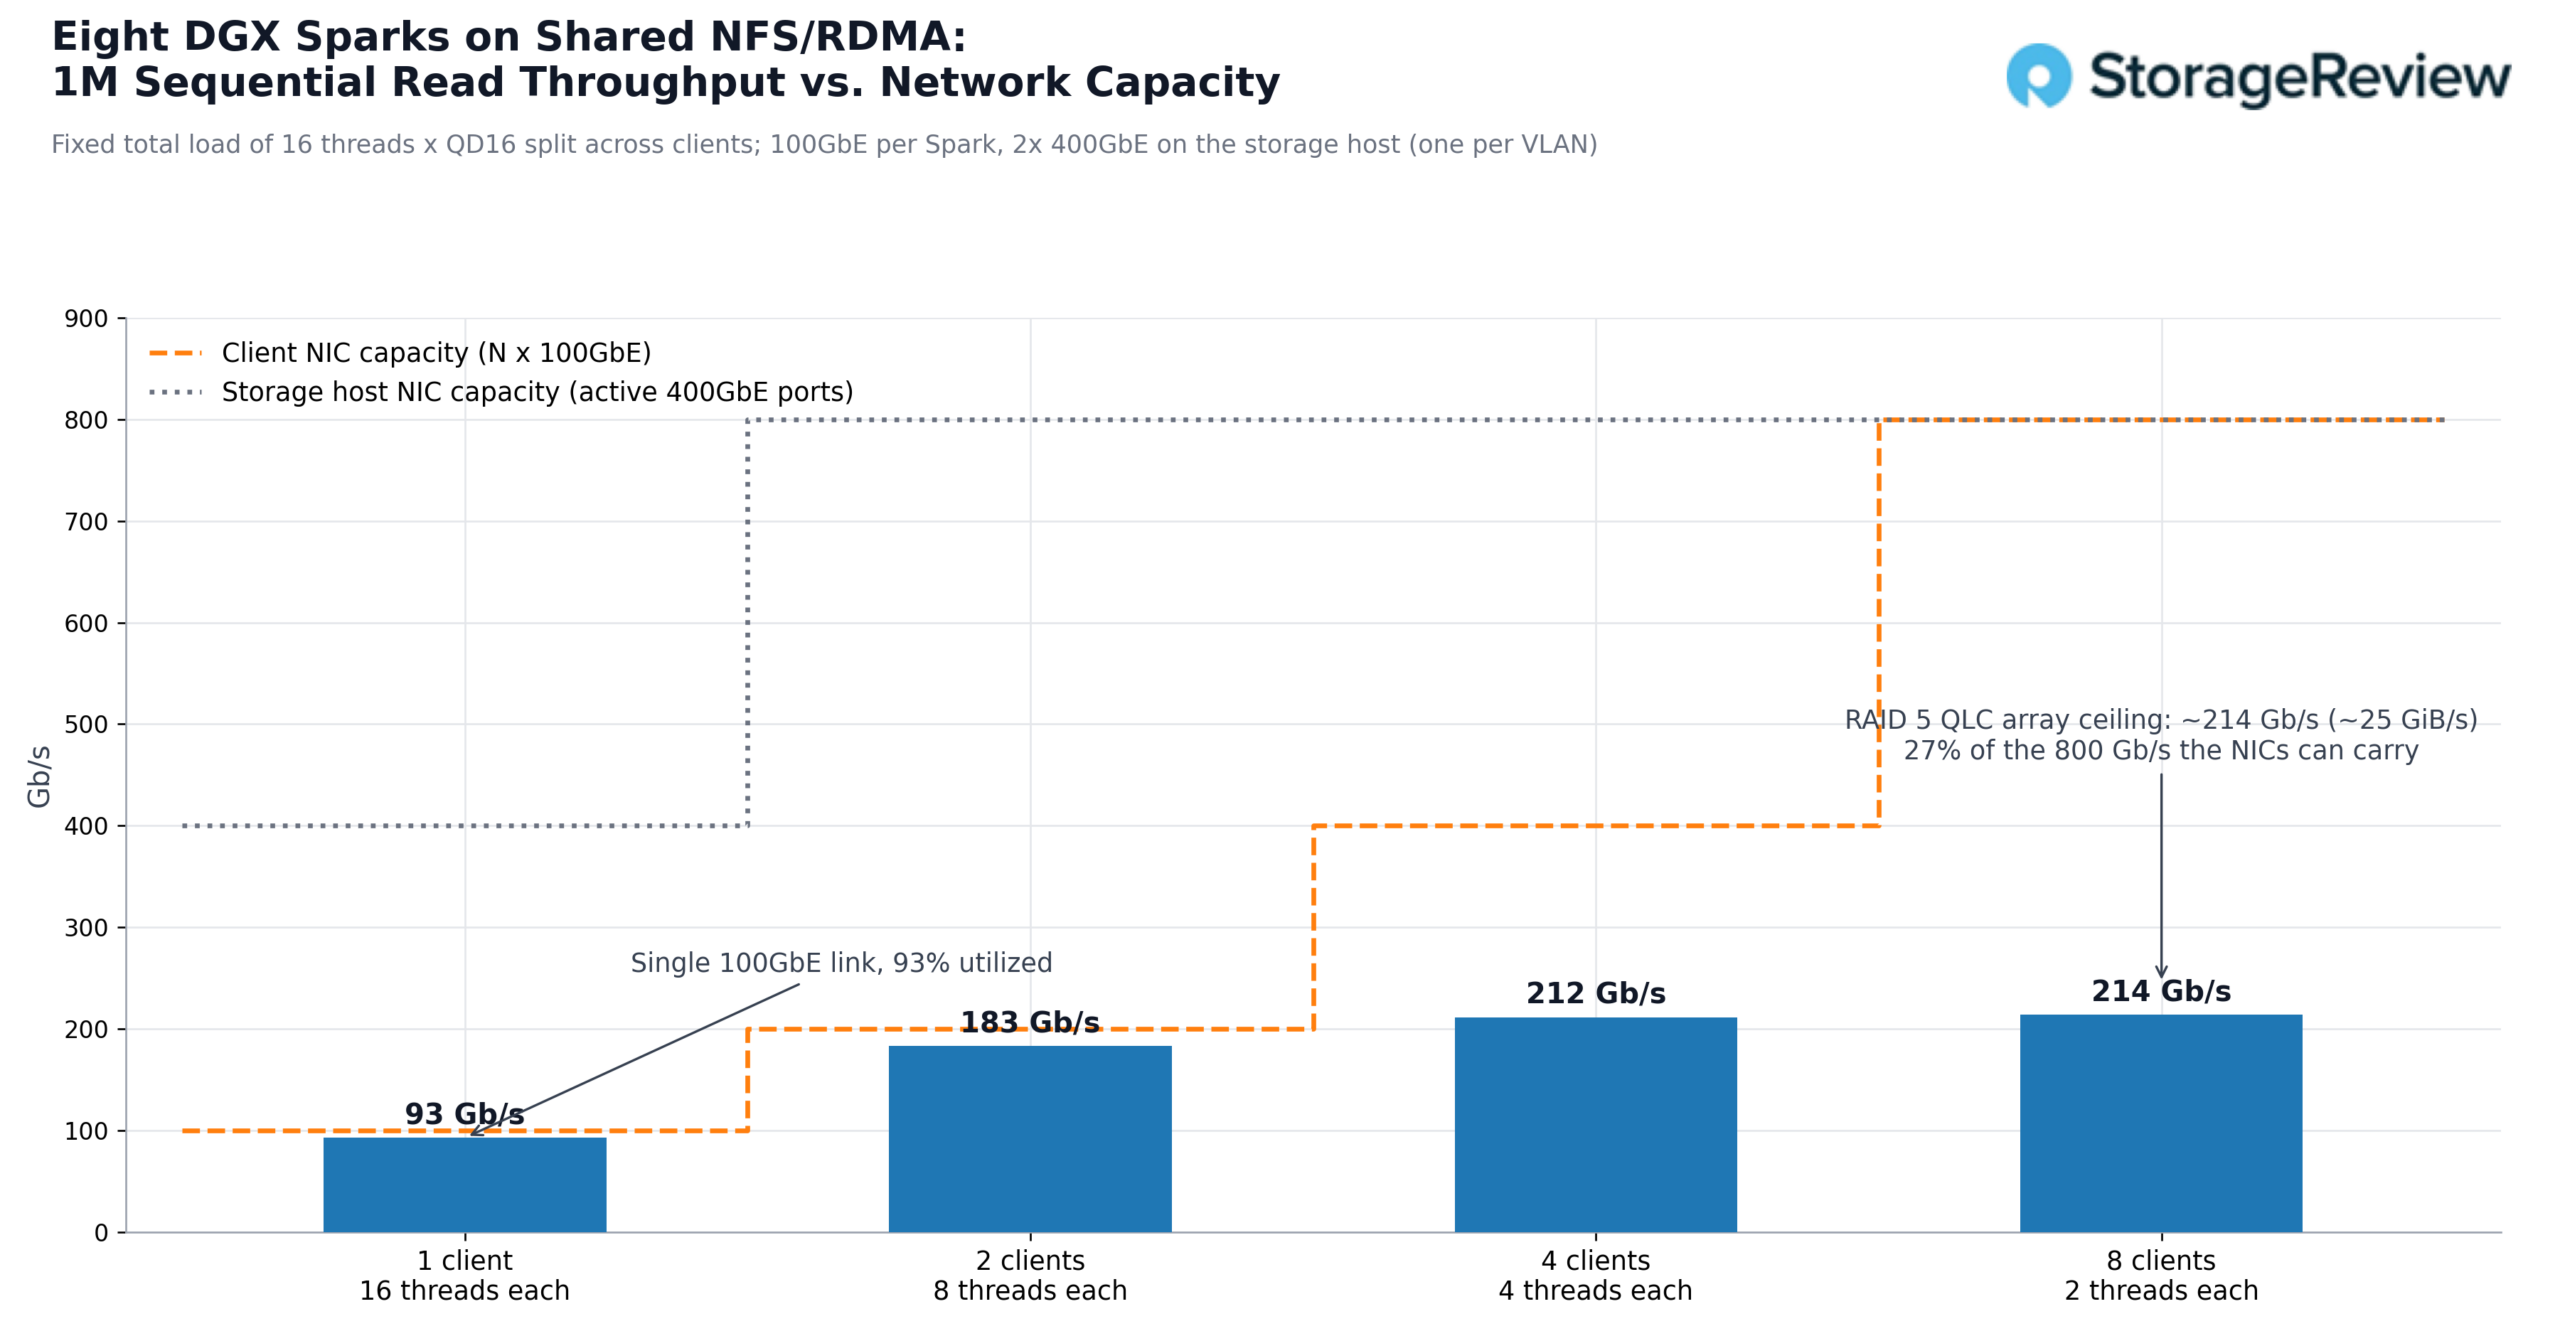
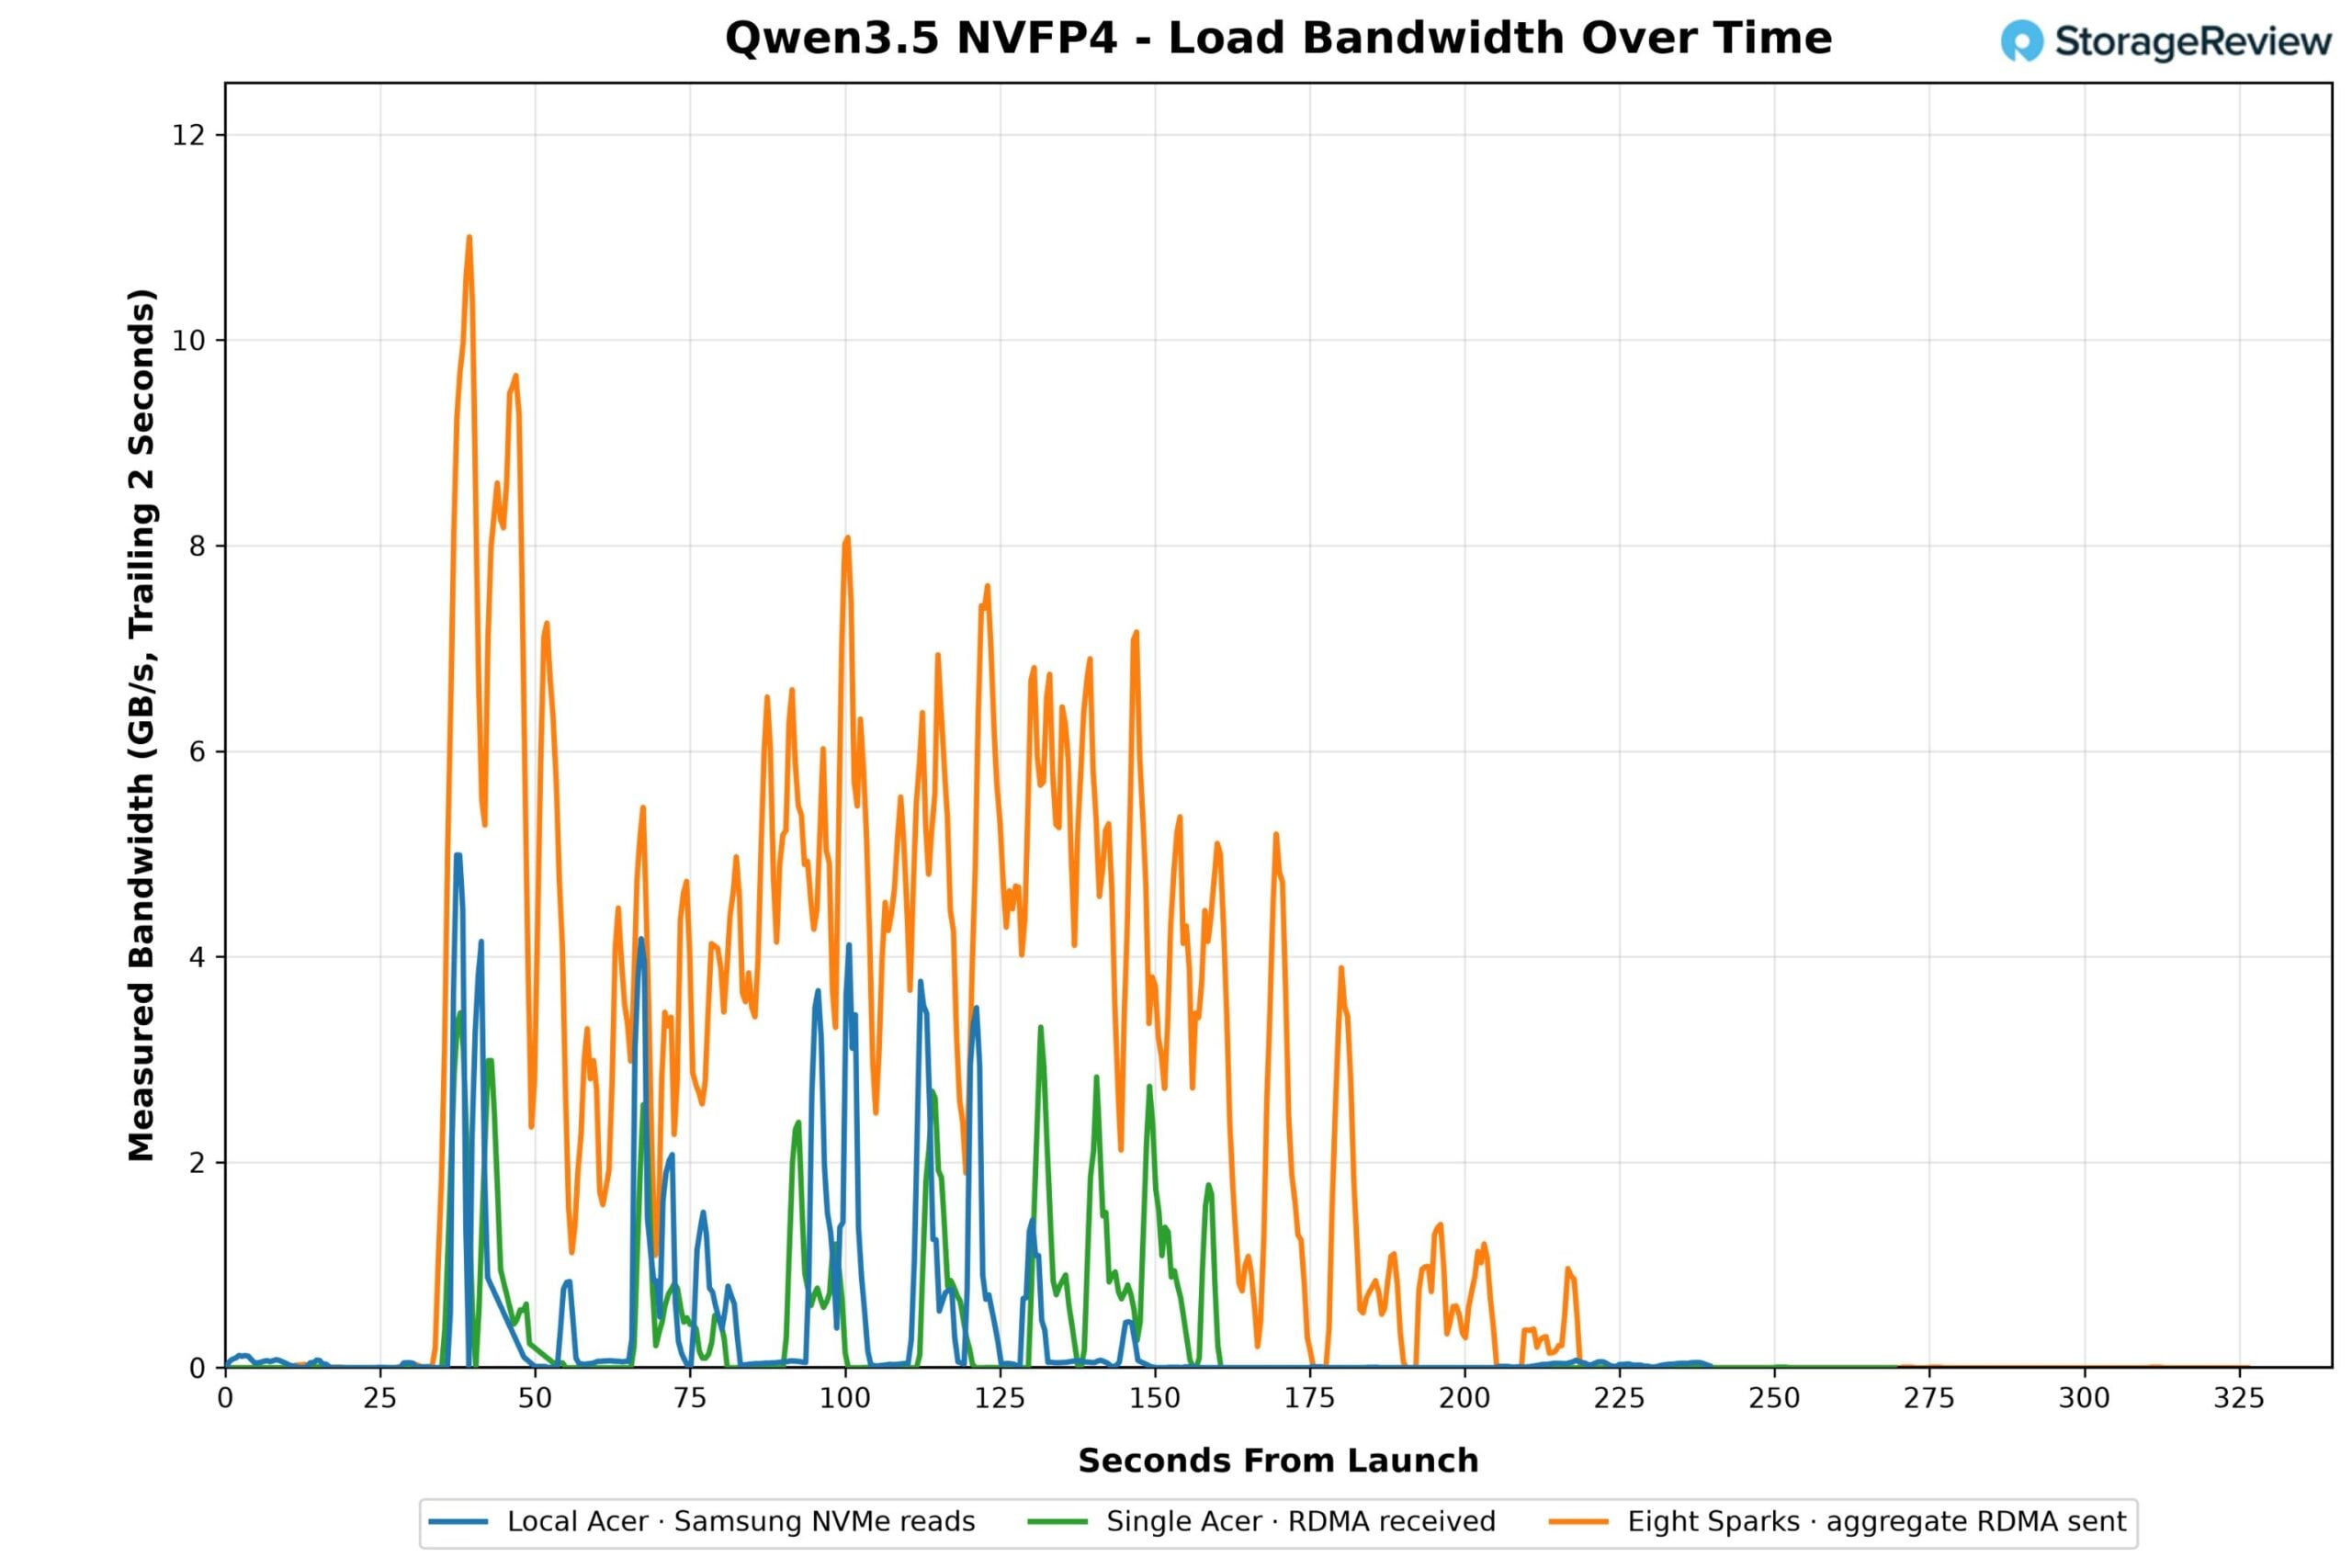
График полосы пропускания подтверждает эту закономерность: чтение с локального NVMe-накопителя происходит короткими всплесками с пиками около 5 ГБ/с и длительными паузами; одиночный NFS-клиент демонстрирует аналогичный характер нагрузки с чуть меньшими пиковыми значениями.
При тестировании восьми систем Spark, работающих одновременно, массив столкнулся с совокупным спросом. В первую минуту работы все восемь устройств запрашивали одни и те же 78 ГБ, что привело к совокупному пику пропускной способности в 11 ГБ/с. В последующие две минуты, пока системы Spark обрабатывали веса моделей, показатель стабилизировался в диапазоне от 4 до 8 ГБ/с, составив в среднем 2,08 ГБ/с за весь период загрузки. Учитывая, что тест fio показал возможности массива на уровне 25 ГИБ/с, одновременная загрузка моделей на восьми Spark использовала лишь малую часть доступного ресурса.
Время загрузки на отдельных устройствах в рамках восьмипоточного теста варьировалось от 232,8 секунды на ASUS Ascent GX10 до 326,5 секунды на одном из узлов GIGABYTE AI TOP ATOM. Системы HP ZGX Nano G1n показали результат 235,3 и 235,4 секунды, а два Dell Pro Max с GB10 — 245,2 и 245,6 секунды. Примечательно, что пять из восьми узлов, загружавших данные из общего массива, справились быстрее, чем один Spark при использовании NFS/RDMA, а три из них обогнали результат работы с локальным NVMe.
Разброс показателей не связан с конкретным вендором. Поскольку в стеке отсутствует QoS (качество обслуживания), очередность доступа устройств к массиву меняется от запуска к запуску, а узлы, подключенные к одному сетевому интерфейсу хранения, распределялись поровну между «быстрыми» и «медленными» значениями в таблице результатов.
Для лаборатории это означает возможность хранения единственной копии каждой модели на массиве. Любой Spark (или все сразу) загружает модель примерно за то же время, что и локальную копию, но без этапа предварительного скачивания, без затрат локальной емкости и без необходимости хранить дубликаты весов на каждом рабочем месте.
Кейс Университета штата Орегон (OSU)
Колледж наук о Земле, океане и атмосфере при OSU является постоянным партнером в исследованиях инфраструктуры ИИ — от океанографических изысканий в реальном времени на борту исследовательского судна до использования ИИ в академической оценке совместно с Metrum AI. Крис Салливан, директор по исследованиям и академическим вычислениям OSU, и архитектор Томас Томас Олсон работают над созданием масштабной лаборатории Spark на 100 узлов, и их требования к хранению данных определили два ключевых принципа проектирования.
Во-первых, система хранения должна быть независима от вычислительных узлов Spark. В OSU отвергли идею распределенной файловой системы, развернутой на самих узлах, так как добавление или удаление любого модуля нарушило бы работу хранилища для всех остальных пользователей. Централизованный массив, к которому подключается любой Spark, позволяет добавлять, удалять, переустанавливать или передавать устройство другому студенту без угрозы потери или влияния на данные других пользователей.
Во-вторых, хранилище должно следовать за пользователем. Требования OSU представляют собой расширенную версию общих папок для нужд ИИ, где студенты хранят свои данные при переходе между системами. При использовании NFS это реализуется как папка для каждого студента: достаточно авторизоваться на любом Spark, примонтировать сетевой ресурс, и рабочие файлы будут доступны.
Для OSU это критически важно из-за объемов наборов данных. Колледж стремится сделать доступными для студентов свои архивы океанографических и атмосферных данных, измеряемые десятками терабайт. Размещение этих данных на локальных накопителях невозможно: слот M.2 на 4 ТБ не вместит ни один из таких массивов. Закупка внешних хранилищ для каждого стола и поддержание актуальности копий на каждом из них экономически нецелесообразны.
Размещение данных в централизованном массиве с доступом по сети 100GbE полностью решило эту задачу в ходе оценки. Тот же массив содержит библиотеку моделей, поэтому студенты могут запускать Qwen, Llama или любые другие нейросети без необходимости их скачивания. Аналогичный подход применим в корпоративном секторе при развертывании ИИ-рабочих станций для разработчиков: монтирование производственного набора данных через высокоскоростную сеть позволяет работать с ними на месте, исключая необходимость создания второго «озера данных» для локальных машин.
Данные остаются в центре обработки данных под контролем политик доступа, шифрования и резервного копирования. В результате, при выносе устройства Spark за пределы офиса на нем не остается никакой критически важной информации.
Заключение
Настольное оборудование для ИИ эффективно во многих задачах, но плохо интегрируется в общую ИТ-инфраструктуру организации. Наличие всего одного слота M.2 в каждой системе GB10 приводит к тому, что все необходимые пользователю данные копируются на локальную флеш-память, становясь «невидимыми» для ИТ-отдела, незащищенными и дублируемыми на каждом рабочем месте. Для единичного узла Spark использование внешнего локального хранилища является оправданным решением.
Организация централизованного хранения данных для систем Spark
Для лабораторий, профильных отделов или предприятий, внедряющих десятки систем Spark, локальное хранение данных на каждой рабочей станции создает проблему изолированных «силосов» информации. Решение этой задачи аналогично тому, к которому пришли центры обработки данных много лет назад: размещение емкости хранения за высокоскоростной сетью, единое управление и организация совместного доступа.
Системы Spark уже обладают возможностями высокоскоростного сетевого подключения, и данный проект наглядно демонстрирует, как эффективно использовать этот потенциал, обосновывая необходимость размещения самих систем Spark в стойке рядом с сервером хранения.
Техническая реализация и производительность
В ходе тестирования восемь QLC-накопителей Solidigm D5-P5336, объединенных в массив Graid RAID 5 внутри сервера Dell, предоставили восьми системам Spark единый массив данных с защитой четности. Сетевая инфраструктура, включающая две сетевые карты Broadcom 400GbE и коммутатор Dell Z9864F-ON с кабелем-разветвителем 800G, обеспечила каждому из восьми устройств Spark пропускную способность 100GbE.
Реализация Tuxera Fusion NFS over RDMA позволила монтировать этот объем хранилища одной командой в стандартной ОС Ubuntu, используя привязки к службе каталогов для контроля доступа. При фиксированной нагрузке, распределенной между всеми восемью узлами, массив продемонстрировал совокупную скорость последовательного чтения 24,9 ГиБ/с без использования QoS. В одиночном режиме один Spark насыщал свое соединение на скорости 10,8 ГиБ/с, что соответствует показателям лучших внутренних накопителей в любых протестированных системах GB10. Этот предел задействовал лишь 27% пропускной способности двух серверных сетевых карт, что указывает на наличие значительного запаса сети для более масштабных конфигураций.
Тестирование с моделью объемом 78 ГБ, размещенной на общем массиве, показало, что время загрузки на один Spark всего на 13% превышает показатели локального NVMe. При одновременной загрузке на восемь систем пять из них завершили процесс быстрее, чем в одиночном сеансе через NFS.
Экономическая эффективность и перспективы
Использование QLC-флеш-памяти делает такую экономическую модель оправданной, так как рабочая нагрузка является емкой и ориентированной на чтение — это сильная сторона накопителей D5-P5336. Один сервер способен хранить объем данных, который невозможно разместить локально на сотне систем Spark, при этом обеспечивая единство копий и централизованный контроль со стороны дата-центра.
В настоящее время Университет штата Орегон использует промышленные системы хранения для критически важных исследований. Крис Салливан и Томас Олсон изучают концепцию создания образовательного уровня инфраструктуры, которого сейчас не хватает в колледже. Речь идет об управляемом общем пуле емкости, рассчитанном на стойку систем Spark и построенном на базе одного сервера с высокоемкими накопителями. Это позволит предоставить доступ к десяткам терабайт реальных океанографических и атмосферных данных для крупномасштабных лабораторий искусственного интеллекта в рамках той же сетевой архитектуры, что используют устройства Spark.
Данный отчет подготовлен при спонсорской поддержке компании Solidigm. Все мнения и суждения, выраженные в этом отчете, основаны на объективном взгляде на рассматриваемые продукты. Упоминание коммерческих продуктов в этой статье носит информационный характер и не является официальной рекомендацией со стороны Университета штата Орегон.