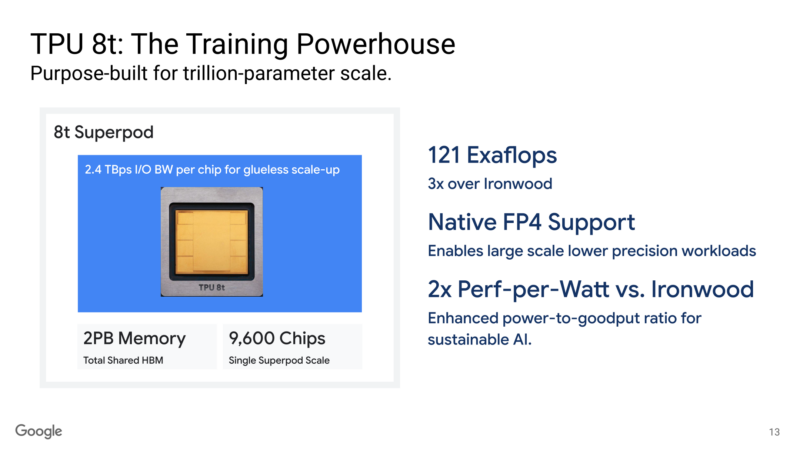
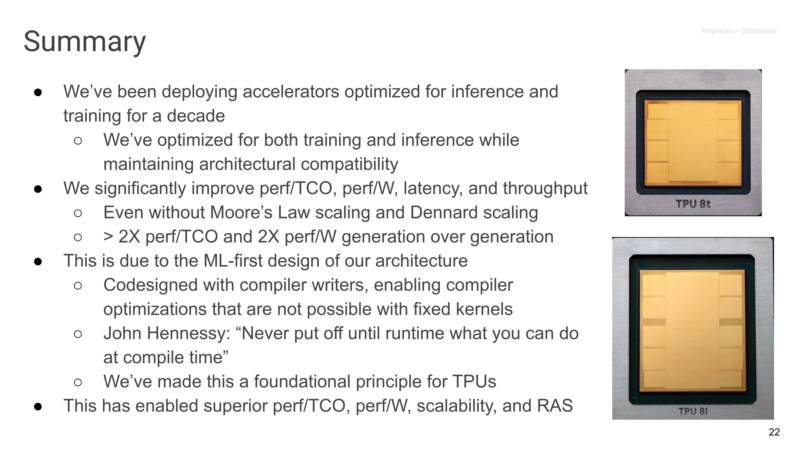
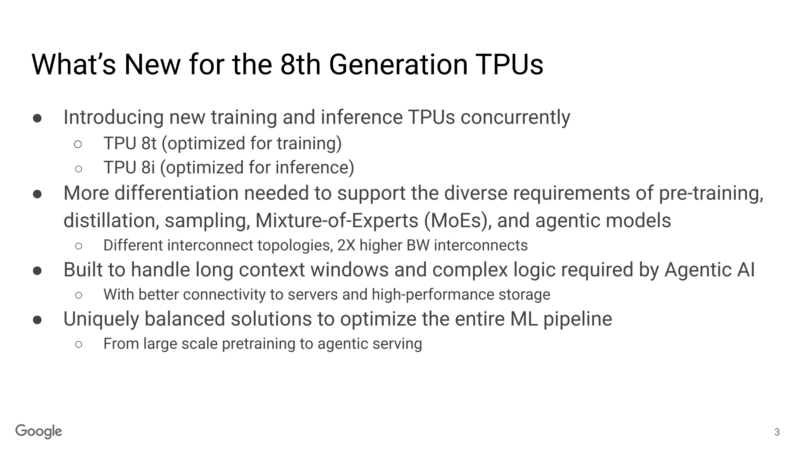
Компания Google представила восьмое поколение своих тензорных процессоров (TPU), продолжая стратегию разработки собственного аппаратного обеспечения для задач искусственного интеллекта. В отличие от других крупных облачных провайдеров, которые часто полагаются на сторонние решения для обучения моделей, Google создает специализированные чипы как для тренировки, так и для инференса. Новая линейка TPUv8 включает модель TPU 8t, предназначенную для обучения, и TPU 8i, оптимизированную для инференса.
Особенности аппаратного обеспечения для инференса TPU 8i
Чип TPU 8i стал важным элементом инфраструктуры Google. Одной из его ключевых характеристик является интеграция с фирменными центральными процессорами Axion, разработанными на базе архитектуры Arm. В узлах Google эти компоненты используются в соотношении 2 к 1, что позволило компании полностью отказаться от процессоров архитектуры x86 в данной задаче.
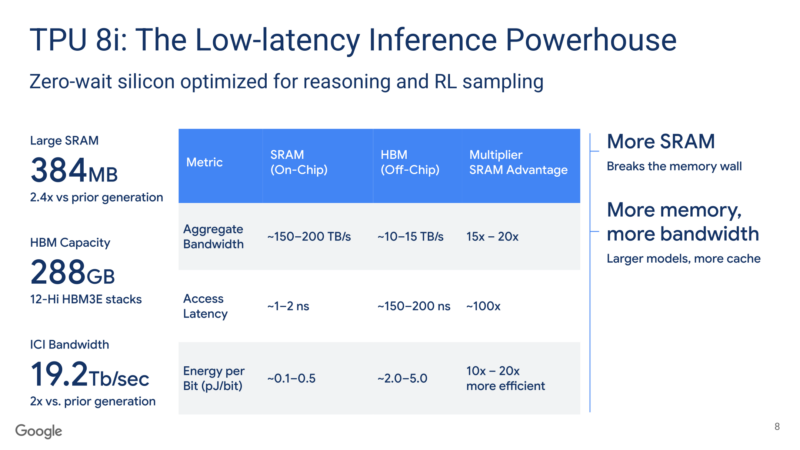
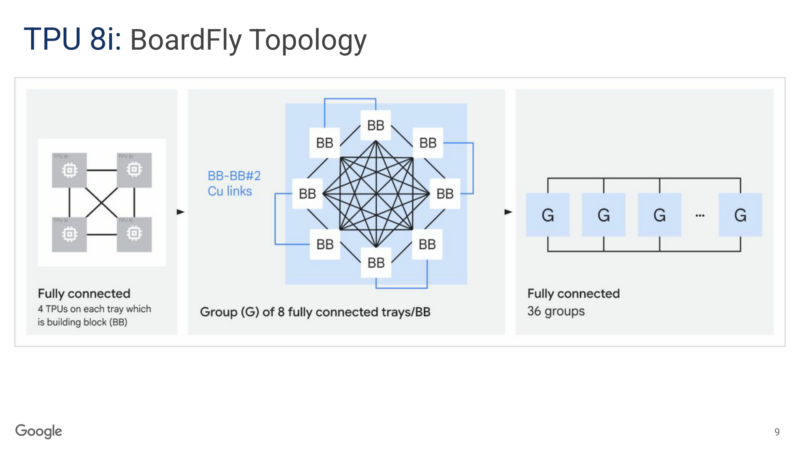
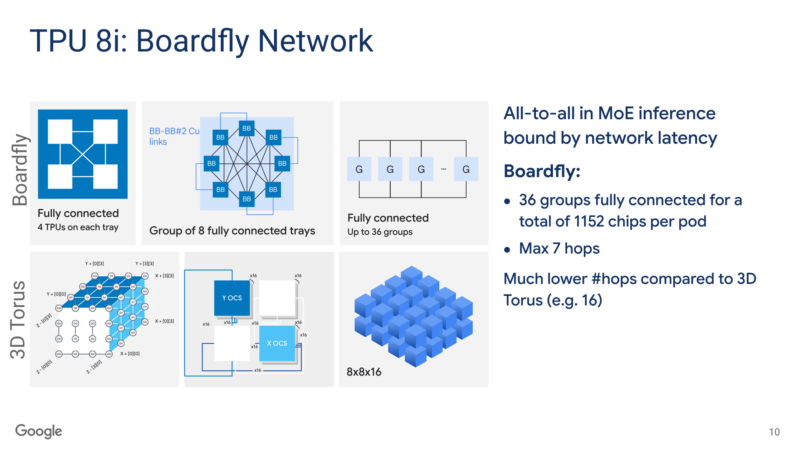
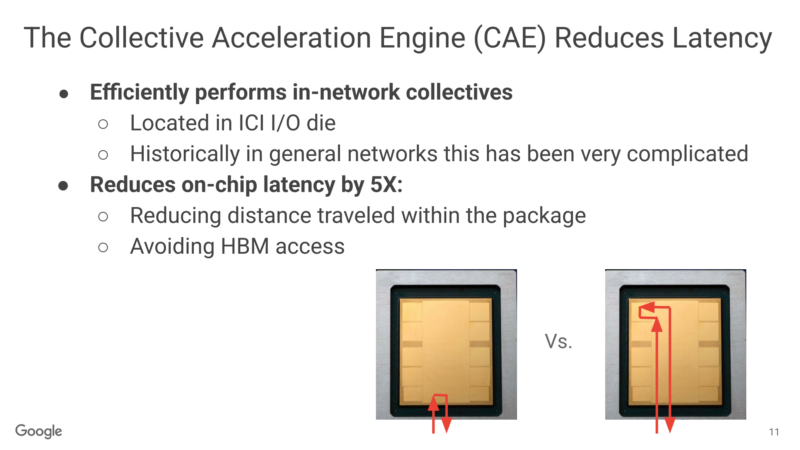
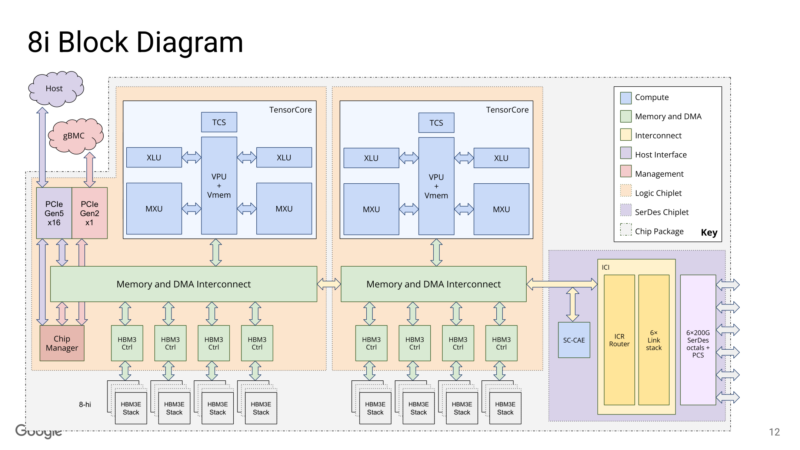
При проектировании TPU 8i инженеры Google сделали упор на увеличение объема SRAM, памяти и пропускной способности. В отличие от чипов для обучения, инференс требует большего объема памяти HBM на единицу вычислений. Для обеспечения высокой производительности и снижения задержек в TPU 8i применяется сетевая топология BoardFly, которая использует 8 лотков по 4 чипа в каждом, формируя 36 групп. Такая архитектура сокращает количество переходов (hops) до семи против 16 в традиционной 3D-топологии Torus. Обработка коллективных операций выполняется непосредственно в модуле ввода-вывода (I/O die), что исключает лишние обращения к HBM и снижает задержки при передаче данных.
Разработка TPU 8t для масштабного обучения моделей
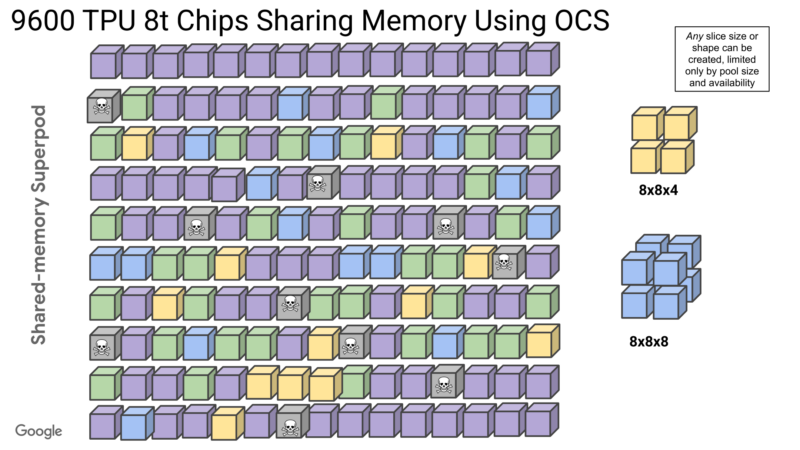
Модель TPU 8t ориентирована на создание высокопроизводительных вычислительных систем. Обучение нейросетей требует огромного количества операций с плавающей запятой (FLOPS) и развитой сетевой связности. Суперпод на базе TPU 8t включает 9600 чипов, обеспечивающих совокупную емкость HBM-памяти 2 ПБ и производительность 121 ЭФЛОПС в формате FP4.
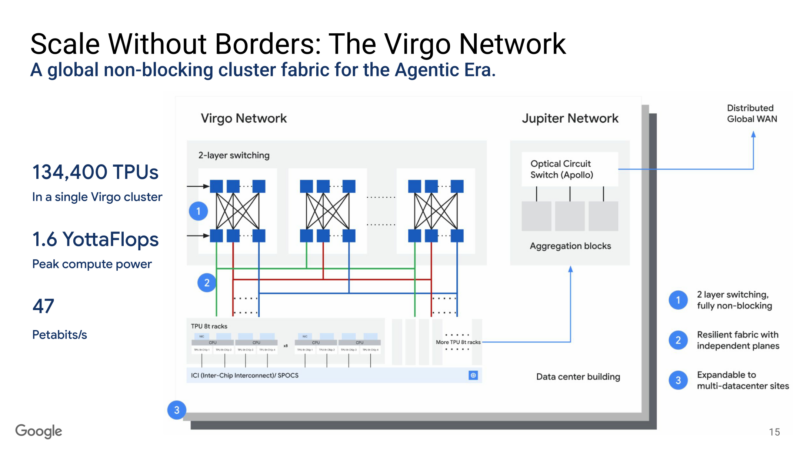
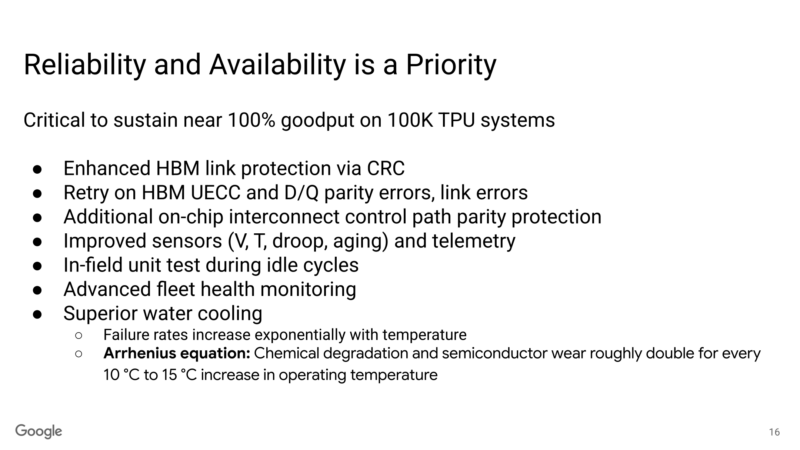
Для управления такой системой Google внедрила оптические коммутаторы (OCS), которые обеспечивают динамическую конфигурацию сегментов сети, высокую отказоустойчивость и возможность оперативной замены вышедших из строя узлов. В поколении 8t также дебютировала сетевая архитектура Virgo. Она поддерживает объединение до 134 000 чипов в одном домене с пропускной способностью 47 Пбит/с. Одной из новых функций надежности (RAS) стало внутрисхемное тестирование, которое запускается в периоды простоя процессоров для выявления возможных аппаратных сбоев.
Оптимизация охлаждения и энергоэффективности
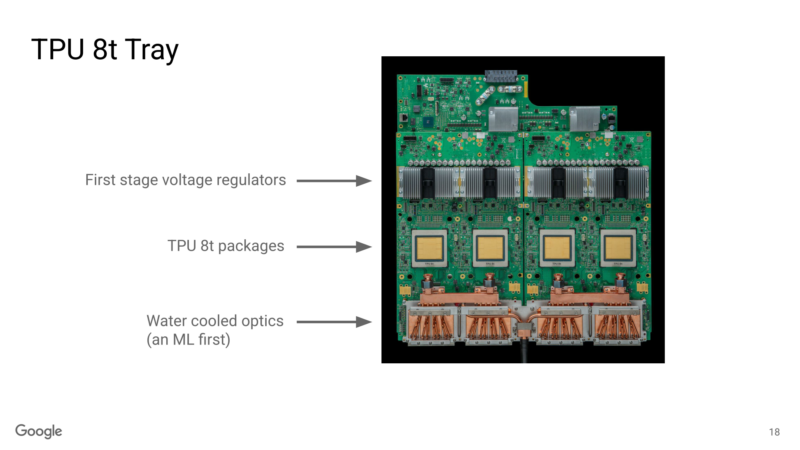
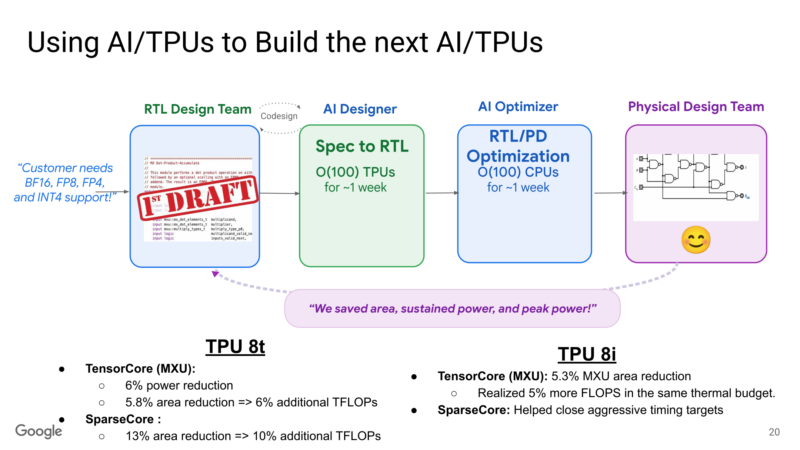
Учитывая экспоненциальный рост частоты отказов при повышении температуры, Google уделила особое внимание охлаждению. Впервые для своей линейки компания применила жидкостное охлаждение не только для вычислительных компонентов, но и для оптических элементов. Кроме того, при разработке TPUv8 активно использовались модели искусственного интеллекта, которые помогли оптимизировать энергопотребление и сократить площадь кристалла, позволив разместить больше вычислительных ядер.
Совместимость и программная экосистема
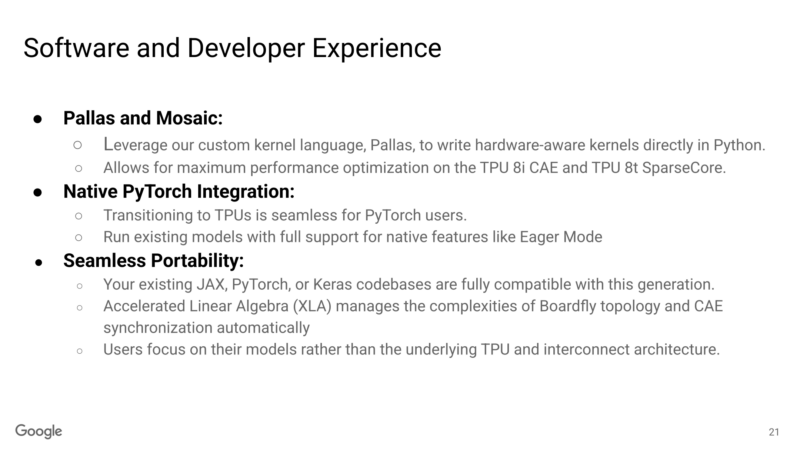
Программная экосистема TPUv8 сохраняет полную совместимость с предыдущими поколениями. Разработчики могут использовать язык Pallas, который позволяет создавать аппаратные ядра непосредственно на Python. Философия дизайна Google остается неизменной: тесная интеграция между разработчиками компиляторов и аппаратного обеспечения помогает минимизировать затраты вычислительных ресурсов во время выполнения задач, сохраняя при этом эффективность при работе с длинными контекстными окнами агентного ИИ.
Эволюция и философия проектирования TPU
История развития тензорных процессоров Google охватывает уже восемь поколений. Традиционно компания чередовала выпуск чипов, оптимизированных либо под инференс, либо под обучение. Этот процесс был взаимосвязан, так как примерно треть операций прямого прохода (forward pass) при обучении по своей сути является инференсом. Однако восьмое поколение стало исключением: Google выпустила оба типа процессоров одновременно. Это решение продиктовано возросшим спектром задач и новыми требованиями моделей, таких как Mixture of Experts (MoE), которые создают значительные сетевые задержки, требующие масштабирования не только FLOPS, но и коммуникационных возможностей.
Важным аспектом является смена парадигмы проектирования: если раньше акцент делался исключительно на внутренних задачах Google, то теперь при разработке учитываются и рабочие нагрузки сторонних облачных клиентов. Тем не менее, внутренние задачи компании остаются критически важным ориентиром. Google продолжает придерживаться концепции отказа от «компромиссных» решений: использование специализированных чипов под конкретные задачи позволяет избегать «темного кремния» (dark silicon), который занимает полезную площадь кристалла и расходует бюджет мощности без пользы для специфической нагрузки.
Технические нюансы TPU 8i и 8t
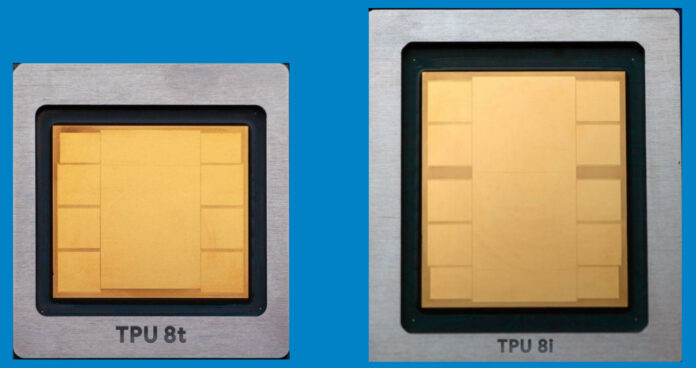
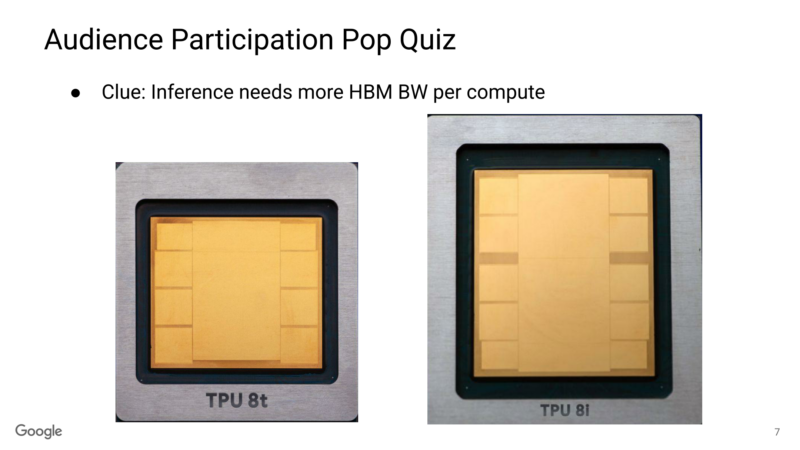
Визуальное сравнение чипов 8t и 8i раскрывает фундаментальные различия в их архитектуре. Несмотря на то что многие ошибочно принимают меньший чип за инференс-решение, ситуация обратная:
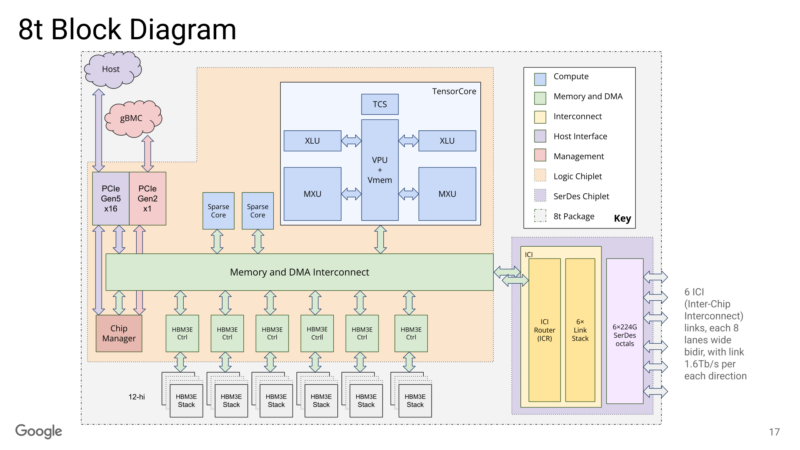
* **TPU 8t (обучение):** меньший размер кристалла, оснащен 6 стеками HBM.
* **TPU 8i (инференс):** более крупный кристалл, оснащен 8 стеками HBM.
Это подтверждает базовый принцип: инференс требует больше памяти HBM и SRAM на единицу вычислений. Кроме того, TPU 8i проектировался с учетом оптимизации для агентного ИИ с длинными контекстными окнами. Для обеспечения эффективности коллективных операций, модуль ICI I/O в TPU 8i расположен непосредственно рядом с сетевым оборудованием на краю кристалла. Это позволяет обрабатывать данные до того, как они попадут на вычислительный кристалл, экономя время на физическую передачу данных и исключая лишние обращения к памяти HBM.
Для обучения (TPU 8t) критически важным является не только FP4-производительность, но и эффективная работа со смешанной точностью (mixed precision). Именно баланс между FP4 и традиционными типами данных позволил добиться двукратного прироста энергоэффективности по сравнению с поколением TPUv7 (Ironwood).
Надежность, охлаждение и вспомогательные технологии
В вопросах надежности (RAS) Google исходит из «рабочей предпосылки», что чипы будут работать нестабильно. Архитектура 8t спроектирована так, чтобы система продолжала функционировать даже при выходе из строя отдельных компонентов. Использование оптических коммутаторов (OCS) позволяет динамически исключать неисправные узлы из цепочки, выделять резервные мощности и восстанавливать работу системы из контрольных точек (checkpoint) без остановки общего процесса.
Вопросы охлаждения напрямую связаны с физикой полупроводников. Согласно уравнению Аррениуса, химическая деградация и износ полупроводников примерно удваиваются при повышении температуры на каждые 10–15°C. Именно поэтому переход на жидкостное охлаждение оптики в дополнение к вычислительным модулям стал важным шагом в обеспечении долговечности 9600-чиповых суперподов.
Наконец, стоит отметить роль самого ИИ в разработке: алгоритмы машинного обучения применялись для трассировки и оптимизации топологии чипов 8-го поколения. Это позволило высвободить дополнительную площадь на кристалле и увеличить плотность вычислительных ядер, что делает текущую линейку TPU наиболее совершенным инструментом в истории компании.
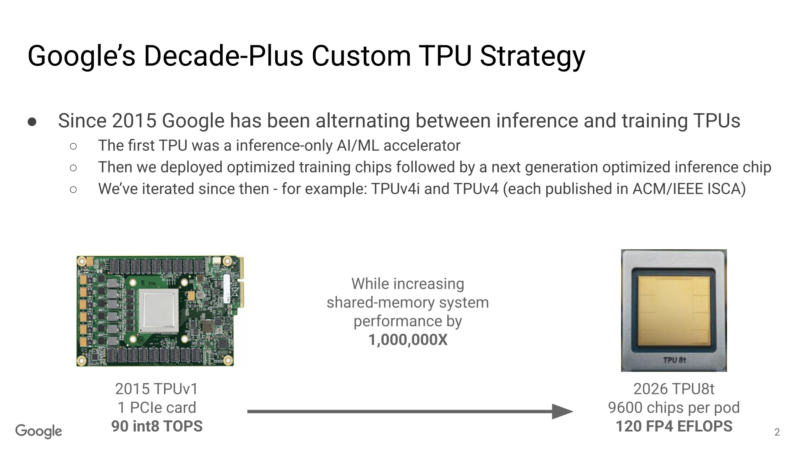
История разработки тензорных процессоров Google насчитывает уже восемь поколений, начавшихся с первого TPU, который представлял собой PCIe-карту, оптимизированную исключительно под задачи инференса. За ним последовал дизайн, ориентированный на обучение с использованием разделяемой памяти. На протяжении многих лет компания придерживалась стратегии чередования: один чип был сфокусирован на инференсе, следующий — на обучении. Этот подход позволял технологиям развиваться симбиотически, так как примерно треть операций в рамках прямого прохода при обучении нейросетей по своей сути является разновидностью инференса. За годы работы Google удалось увеличить производительность своих систем в миллион раз.
В восьмом поколении компания отошла от привычного чередования, выпустив сразу два типа процессоров в рамках одного календарного года. Это решение обусловлено широким спектром современных приложений, где масштабирования одних лишь FLOPS недостаточно. Архитектуры типа MoE (Mixture of Experts) создают специфические узкие места, требуя кратного увеличения сетевого трафика и интенсивности коммуникаций между вычислительными узлами. Кроме того, при проектировании TPUv8 разработчики стали уделять значительно больше внимания потребностям внешних облачных клиентов, хотя внутренние рабочие нагрузки Google по-прежнему остаются приоритетным вектором развития.
Важным дополнением к экосистеме является роль со-дизайна аппаратного и программного обеспечения. Google стремится избежать лишних операций во время выполнения кода (runtime), поэтому разработчики компиляторов и инженеры-микроархитекторы работают в тесной связке. Этот философский подход позволяет эффективно справляться с вызовами, которые ставят перед «железом» новые модели, включая агентный ИИ с крайне длинными контекстными окнами.
Отдельного внимания заслуживает аппаратная реализация: если раньше для обучения использовались x86-процессоры, то переход на Axion ознаменовал не только использование собственного CPU, но и полноценный переход на архитектуру Arm. В архитектуре TPU 8t эффективность достигается не только за счет сырой мощности FP4 — чип спроектирован для эффективной работы со смешанной точностью, что и позволило достичь показателя энергоэффективности, превышающего возможности TPUv7 (Ironwood) в два раза. Для обеспечения надежности в сетях Virgo используется двухслойная топология коммутации, способная обслуживать до 134 тысяч тензорных процессоров в едином домене.