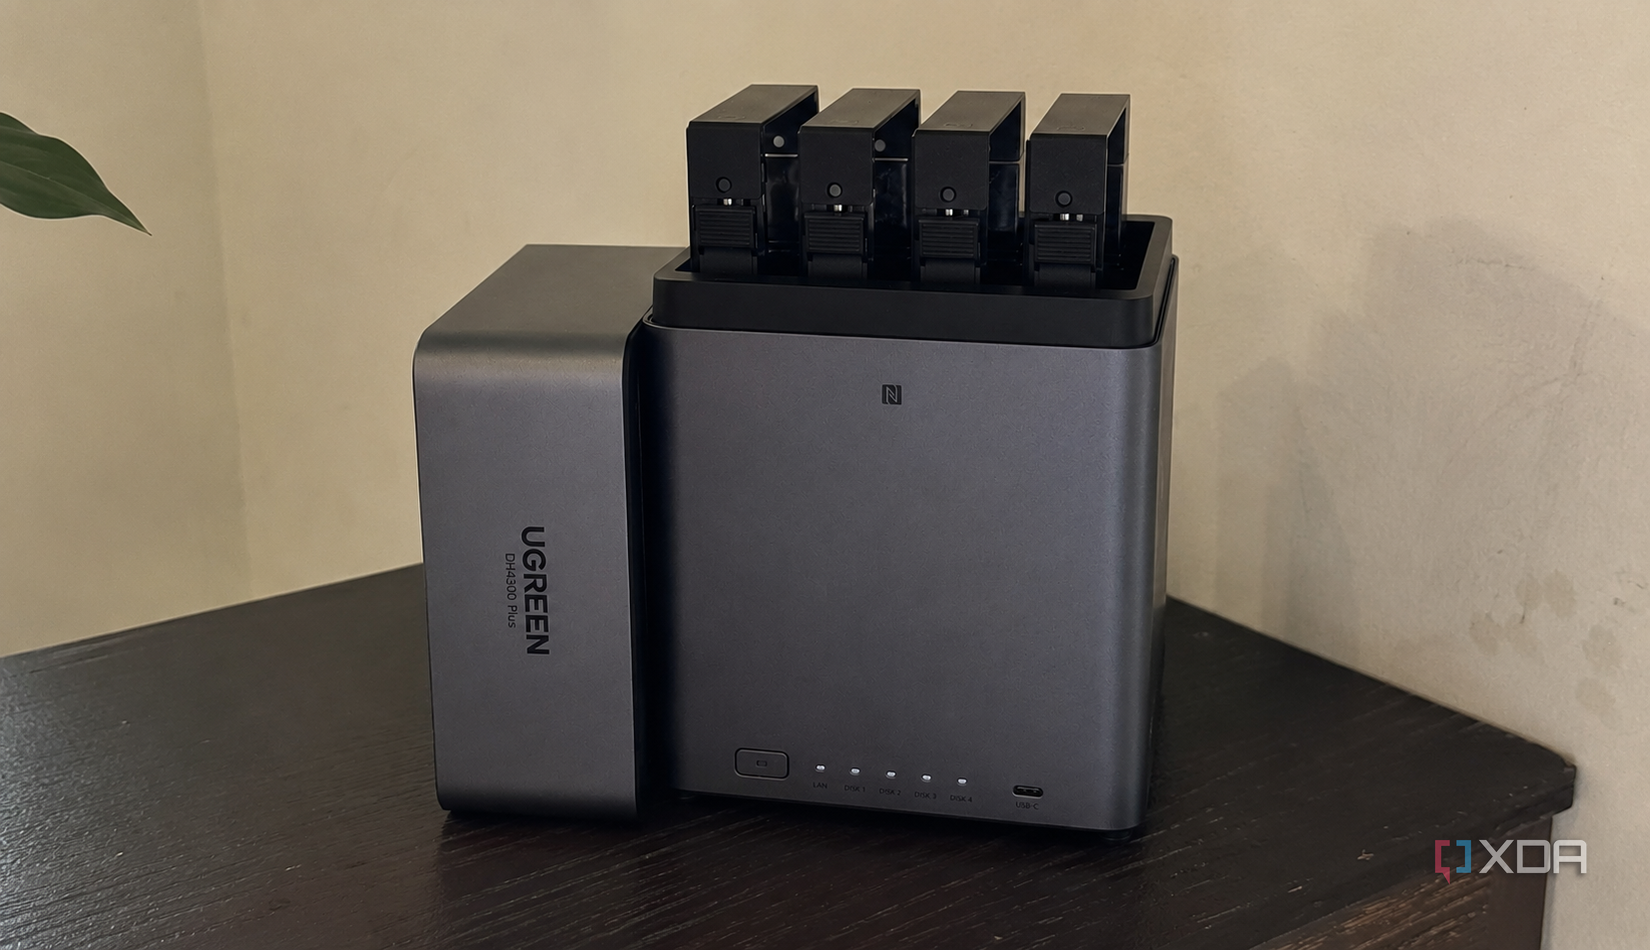
Автоматизированные системы резервного копирования позволяют пользователям не заботиться о ручном переносе данных, однако со временем в хранилищах накапливается множество лишних файлов. Владелец NAS-устройства UGREEN DH4300 Plus на личном опыте убедился, что регулярные проверки содержимого папок необходимы для оптимизации пространства. С помощью ИИ-агента удалось просканировать файловую систему и обнаружить 2 ТБ данных, которые дублировались и избыточно оплачивались в рамках облачной подписки.
Почему автоматические бэкапы требуют контроля
Настройка резервного копирования по расписанию создает иллюзию безопасности. Пользователь выбирает определенные директории, но спустя месяцы внутри них могут оказаться ненужные рабочие версии, старые экспортные файлы или копии данных, уже размещенные в других местах. Проблема усугубляется, если в систему включены разные папки, содержащие идентичные элементы. Например, перемещение фотографий из бэкапа ноутбука в общую медиабиблиотеку приводит к тому, что в резервной копии сохраняются сразу два экземпляра одного и того же контента.
Дополнительную нагрузку создают пересекающиеся задачи резервного копирования. Если одна задача охватывает всю корневую папку, а вторая настроена на защиту отдельной подпапки внутри нее, система будет создавать избыточные копии. Для эффективного управления хранилищем важно различать целевые резервные копии и случайные дубликаты. Хотя методы сжатия и дедупликации данных частично компенсируют расход места, наличие лишних файлов всё равно увеличивает объем используемого пространства, за который приходится платить.
Организация аудита через SSH и ИИ
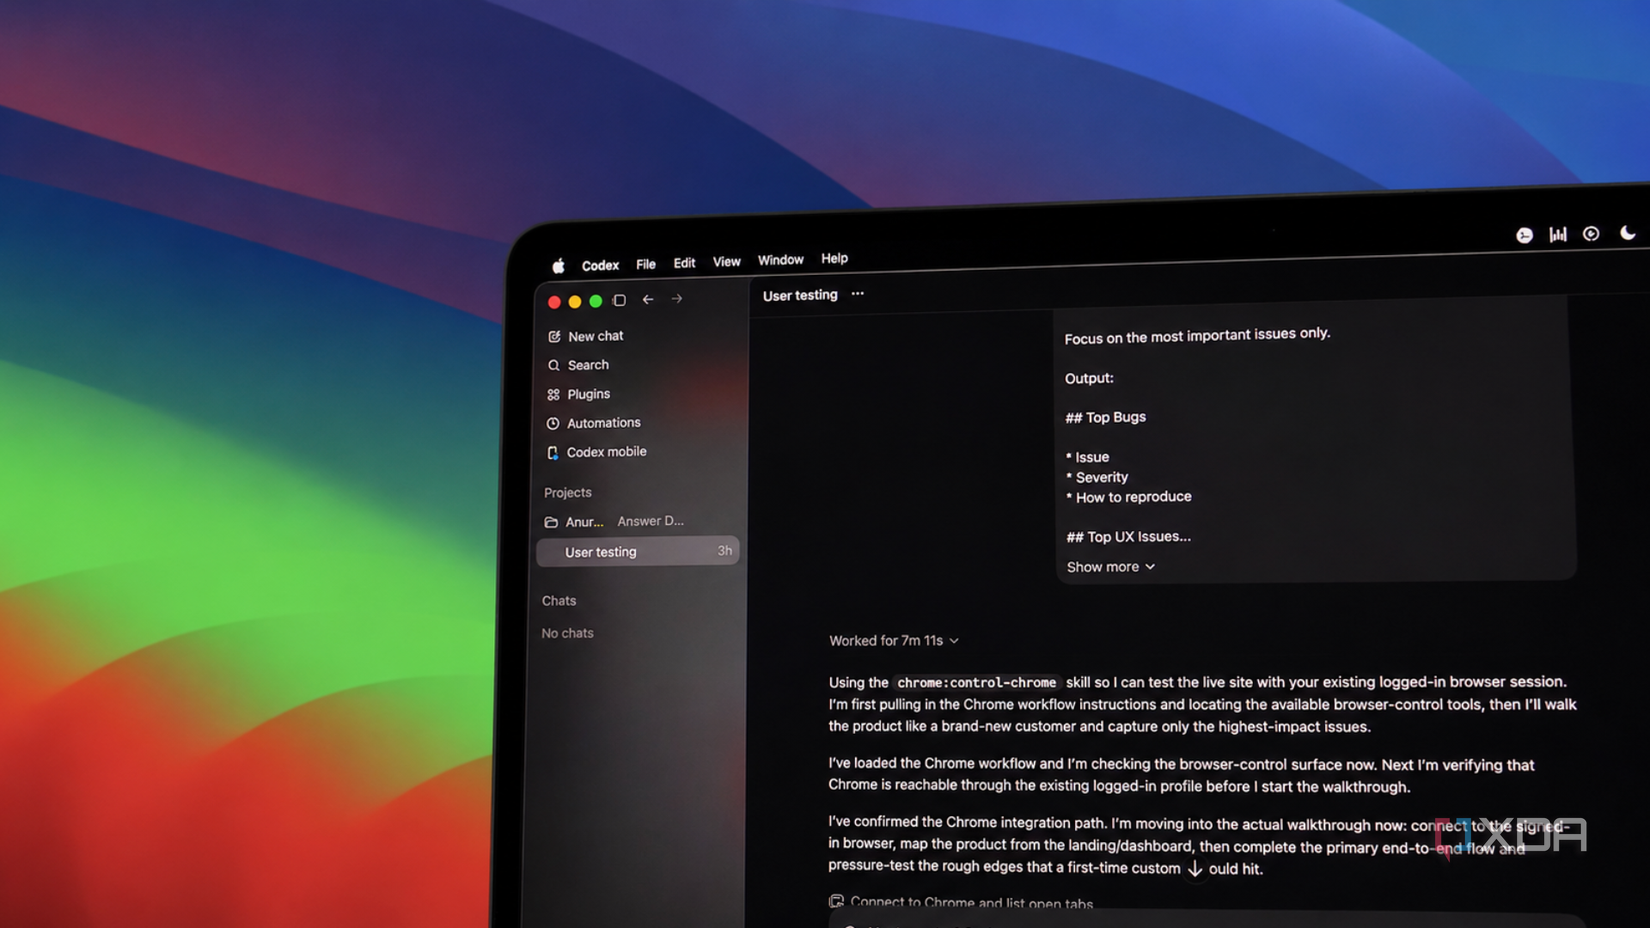
Для проведения проверки автор воспользовался возможностями модели Codex. В качестве среды исполнения был выбран Mac, а доступ к сетевому хранилищу UGREEN DH4300 Plus осуществлялся через протокол SSH. Использование удаленного соединения позволяет выполнять команды напрямую на устройстве NAS. Для успеха операции необходимо иметь учетную запись с правами чтения проверяемых каталогов и знать IP-адрес оборудования.
В ходе эксперимента применялись модели GPT 6.1 Sol, которые успешно справились с задачей в рамках лимитов использования. Как отмечает автор, для подобных целей подходят и более ранние версии, например GPT‑5.6, тогда как использование продвинутых моделей вроде GPT‑6 Astra может быть неоправданно дорогим для задач такого типа. Ключ к успеху заключается в предоставлении агенту четких инструкций: какие папки анализировать, какие методы сравнения контента использовать и как оценивать конфигурацию бэкапов.
Инструкции для ИИ-агента
Если настройки резервного копирования недоступны для прямого анализа через SSH, рекомендуется передать агенту экспорт конфигурации или подробное описание исходных и целевых путей всех задач. Это даст ИИ контекст, необходимый для отличия запланированных резервных копий от случайных дубликатов. При первом запуске аудита важно установить жесткое правило: ИИ не должен удалять или изменять файлы, а обязан только составить отчет.
Отчет должен содержать полные пути к файлам, размеры групп дубликатов и пояснения, почему каждый набор данных был помечен как подозрительный. Учитывая, что сканирование нескольких терабайт создает высокую нагрузку на диски, следует ограничить количество одновременных операций и попросить систему логировать ошибки доступа или файлы, изменившиеся в процессе работы.
Результаты поиска избыточных данных
Итогом аудита стало выявление 2 ТБ дублирующихся файлов. Особенно полезными оказались находки среди крупных форматов, таких как проекты Adobe Photoshop и видеофайлы. Проекты Photoshop часто копятся в разных папках: в рабочей директории, в архиве завершенных проектов и в папке для передачи клиенту. Если все эти ветки включены в систему бэкапа, происходит многократное сохранение одного и того же тяжелого файла.
Также были найдены идентичные видеоролики с разными именами. Стандартный поиск по имени файла не выявил бы такой дубликат, однако контент файлов был полностью идентичен. После проведения аудита автор приступил к ручной очистке, начиная с самых крупных групп дубликатов. Главная рекомендация — перед окончательным удалением проверить, что в системе осталась хотя бы одна актуальная и доступная для восстановления копия данных, а затем оптимизировать задачи бэкапа, чтобы исключить повторения в будущем.
Тонкости настройки и проведения аудита
Для того чтобы самостоятельно проверить соединение по SSH, можно воспользоваться терминалом, введя команду ssh username@NAS_IP, где вместо username и NAS_IP подставляются соответствующие учетные данные и IP-адрес вашего хранилища. После ввода пароля и подтверждения успешного соединения, агент получает возможность полноценного доступа для инспекции файловой системы и запуска сканера непосредственно на NAS.
Важно помнить, что анализ дубликатов — это задача, требующая контекста: рабочая копия файла и его резервная версия по определению идентичны, поэтому ИИ должен уметь отделять запланированное дублирование от избыточного хранения. Если ИИ-агент не имеет прямого доступа к настройкам бэкапов через SSH, предоставление ему экспорта конфигурации или четкое описание источников данных является критическим шагом для предотвращения ложных срабатываний.
Особенности работы с данными
Особое внимание стоит уделить тому, что поиск по именам файлов принципиально неэффективен для обнаружения дубликатов. Переименование видеоролика для удобства сортировки не меняет его контрольную сумму или внутреннее содержимое, а хранение оригинала в другом месте приводит к тому, что вы занимаете место дважды. В случае с тяжелыми видеофайлами даже несколько таких «забытых» копий способны существенно увеличить занимаемый объем на дисках.
Также нередки ситуации, когда пользователь архивирует завершенный проект на NAS, при этом оставляя исходные файлы в папке на ноутбуке, которая автоматически синхронизируется с облаком или резервным хранилищем. В результате две независимые задачи бэкапа сохраняют идентичные данные. Хотя это может выглядеть как намеренная перестраховка, такие случаи заслуживают аудита, если вы сохраняете обе копии лишь из-за того, что забыли об одной из них.
Рекомендации по безопасности и восстановлению
Используйте результаты аудита для итеративного процесса очистки: сначала выбирайте самые крупные группы дубликатов, а затем последовательно удаляйте лишнее. Важное правило безопасности: перед окончательным удалением любых данных обязательно убедитесь, что оставшаяся копия успешно проходит проверку на восстановление. Лишь после подтверждения целостности архива следует перенастраивать задачи резервного копирования, чтобы избежать накопления избыточных копий в будущем.