Администрирование домашней лаборатории часто сталкивается с проблемой избыточности данных. Системы, такие как Proxmox, Home Assistant или контейнеры DNS, генерируют тысячи строк журналов событий, где полезная информация составляет лишь около двух процентов от общего объема. Попытка вручную отследить ошибки в подобных условиях становится трудновыполнимой задачей.

Методология анализа логов с помощью Claude Code
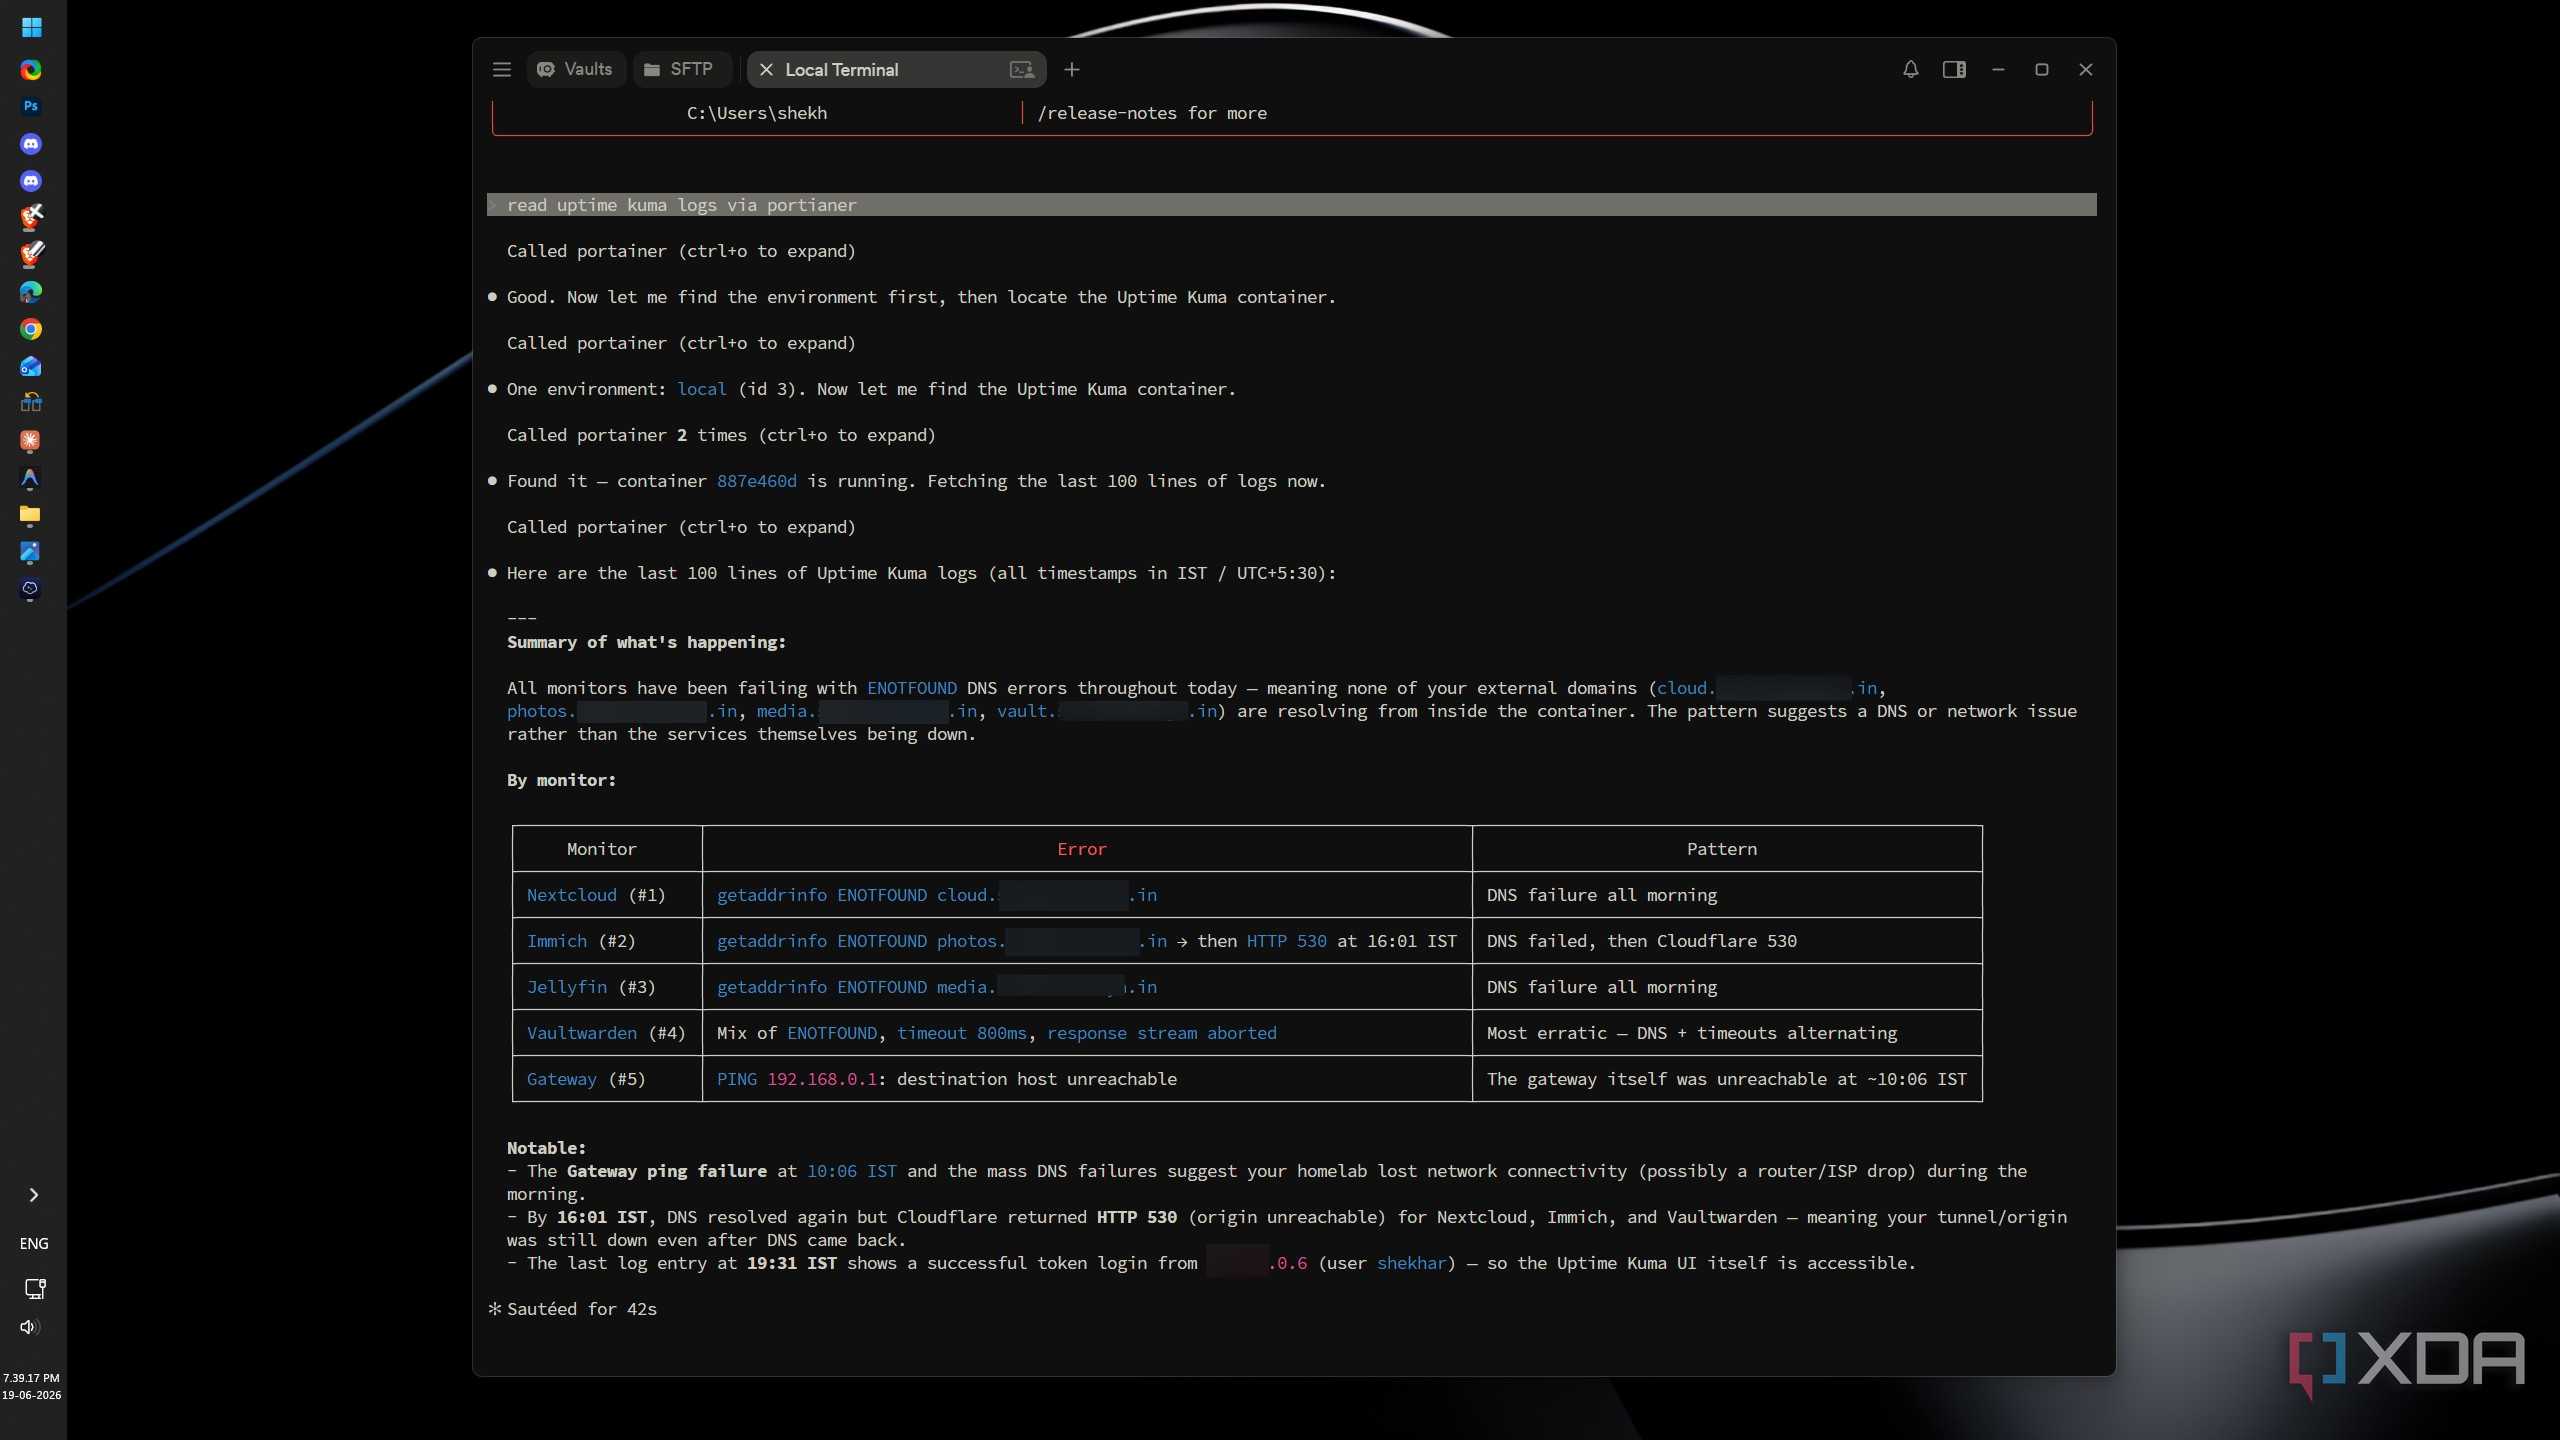
Для решения проблемы автор эксперимента применил модель Claude Code, организовав работу не через полноценное обучение, а посредством контекстного инжиниринга. Было протестировано два подхода: создание предварительно сжатой выборки данных через Python-скрипты и предоставление модели прямого доступа к «сырым» логам через инструменты journalctl и pvesh. Для проверки надежности системы использовались синтетические данные, имитирующие реальную инфраструктуру с конкретными VMID, IP-адресами и конфигурациями ZFS.
В ходе синтетического тестирования Claude Code проанализировал около 64 000 строк журналов. Специально созданный инструмент для подготовки данных (диджестер) позволил сократить объем информации до 21,5 КБ, обеспечив сжатие в 273 раза. Модель успешно прошла тесты на проверку знаний, отказавшись отвечать на запросы о несуществующих в системе узлах, что подтвердило отсутствие галлюцинаций при обработке инфраструктурных данных.
Выявление реальных проблем в инфраструктуре
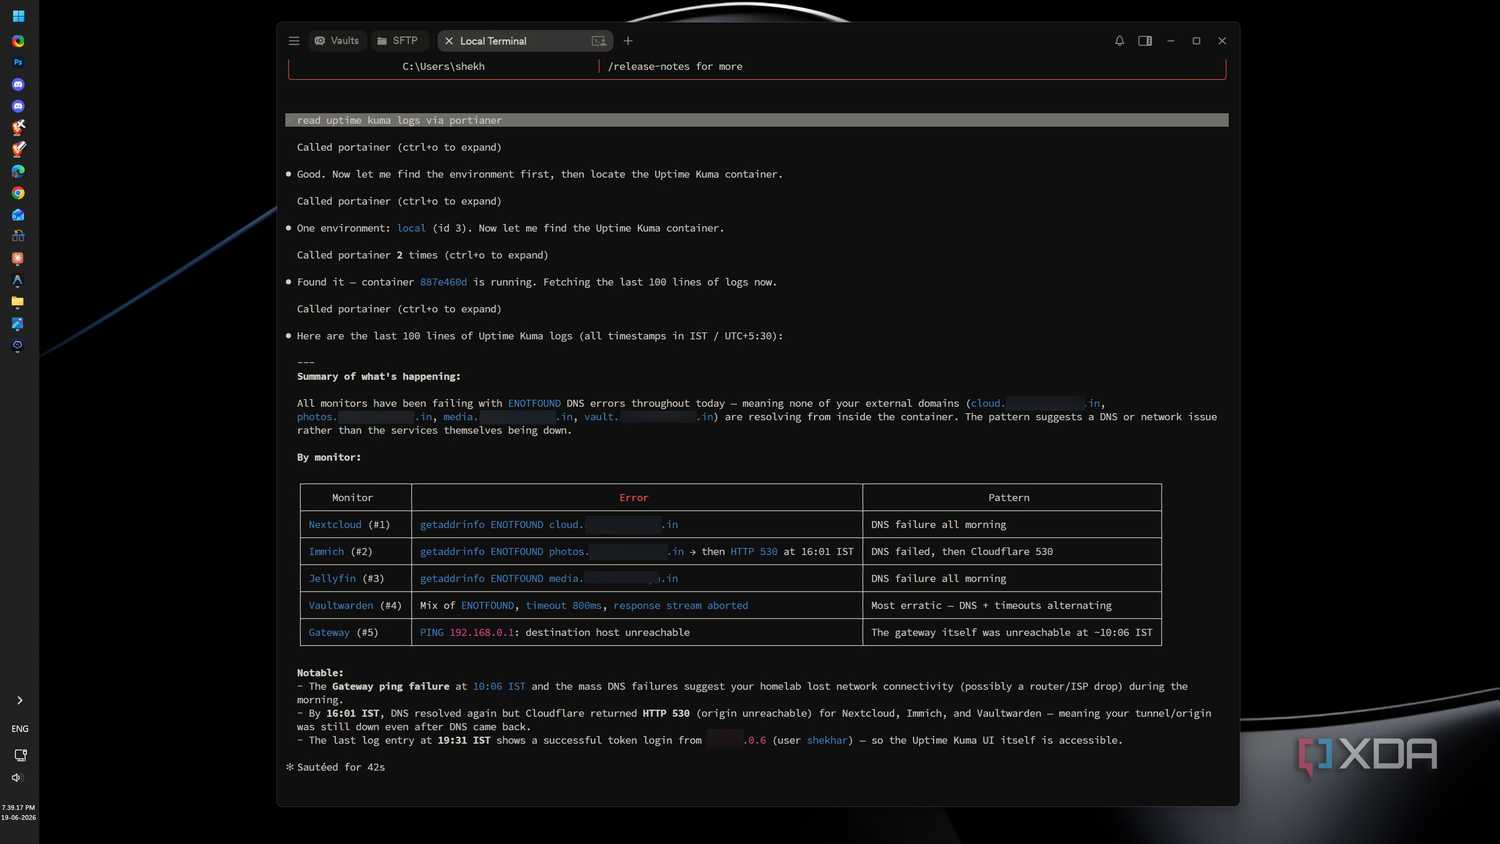
После отладки процесса на тестовых данных автор перешел к анализу 15-дневного архива журналов реального сервера Proxmox, дополненного данными о состоянии ZFS и конфигурациями гостевых систем. В результате Claude Code выявил несколько критических недочетов, которые оставались незамеченными в течение длительного времени:
- Ошибки при загрузке шаблонов виртуальных машин, которые не должны были запускаться автоматически.
- Отсутствие настроенных процессов резервного копирования для 41 задачи в индексе.
- Систематические сбои при отправке уведомлений на почту из-за ограничений SMTP-серверов при использовании домашних IP-адресов.
- Единичный аппаратный сбой сетевого интерфейса Realtek, приведший к некорректному завершению работы системы 21 августа.
Особенности настройки автоматизированного анализа
Опыт показал важность точной настройки регулярных выражений (regex). Например, на ранних этапах модель не могла определить причину отсутствия уведомлений, так как инструмент не был настроен на поиск специфических ошибок postfix, связанных с подключением к 25-му порту. После корректировки фильтров система начала корректно идентифицировать подобные проблемы.
Автор подчеркивает, что Claude Code выполнил задачу чтения журналов, с которой человек не справлялся годами. При этом ИИ используется исключительно как инструмент для анализа и обнаружения проблем, оставляя процесс принятия решений и непосредственного исправления ошибок за администратором. Использование LLM позволило сосредоточиться на устранении последствий, а не на поиске причин в бесконечном потоке системных уведомлений.
Специфика «обучения» и архитектура взаимодействия
Термин «обучение» в данном случае является лишь удобной метафорой для процесса контекстного инжиниринга. Автор подчеркивает, что никакого глубокого обучения (fine-tuning) или запуска моделей на локальном графическом ускорителе не проводилось. Вместо этого была создана сложная система регулярных выражений (regex) и рубрикатор для оценки точности результатов.
Существует два основных способа предоставить модели необходимые данные, и каждый из них имеет свои критические точки отказа:
* Предварительное сжатие (Digest): Детерминированный Python-скрипт обрабатывает журнал, индекс задач и конфигурации гостевых систем, превращая их в шесть компактных Markdown-файлов (инвентаризация, резервные копии, инциденты, активность, временная шкала и «шум»). ИИ в этом процессе не участвует, поэтому модель видит только то, что администратор заранее счел важным.
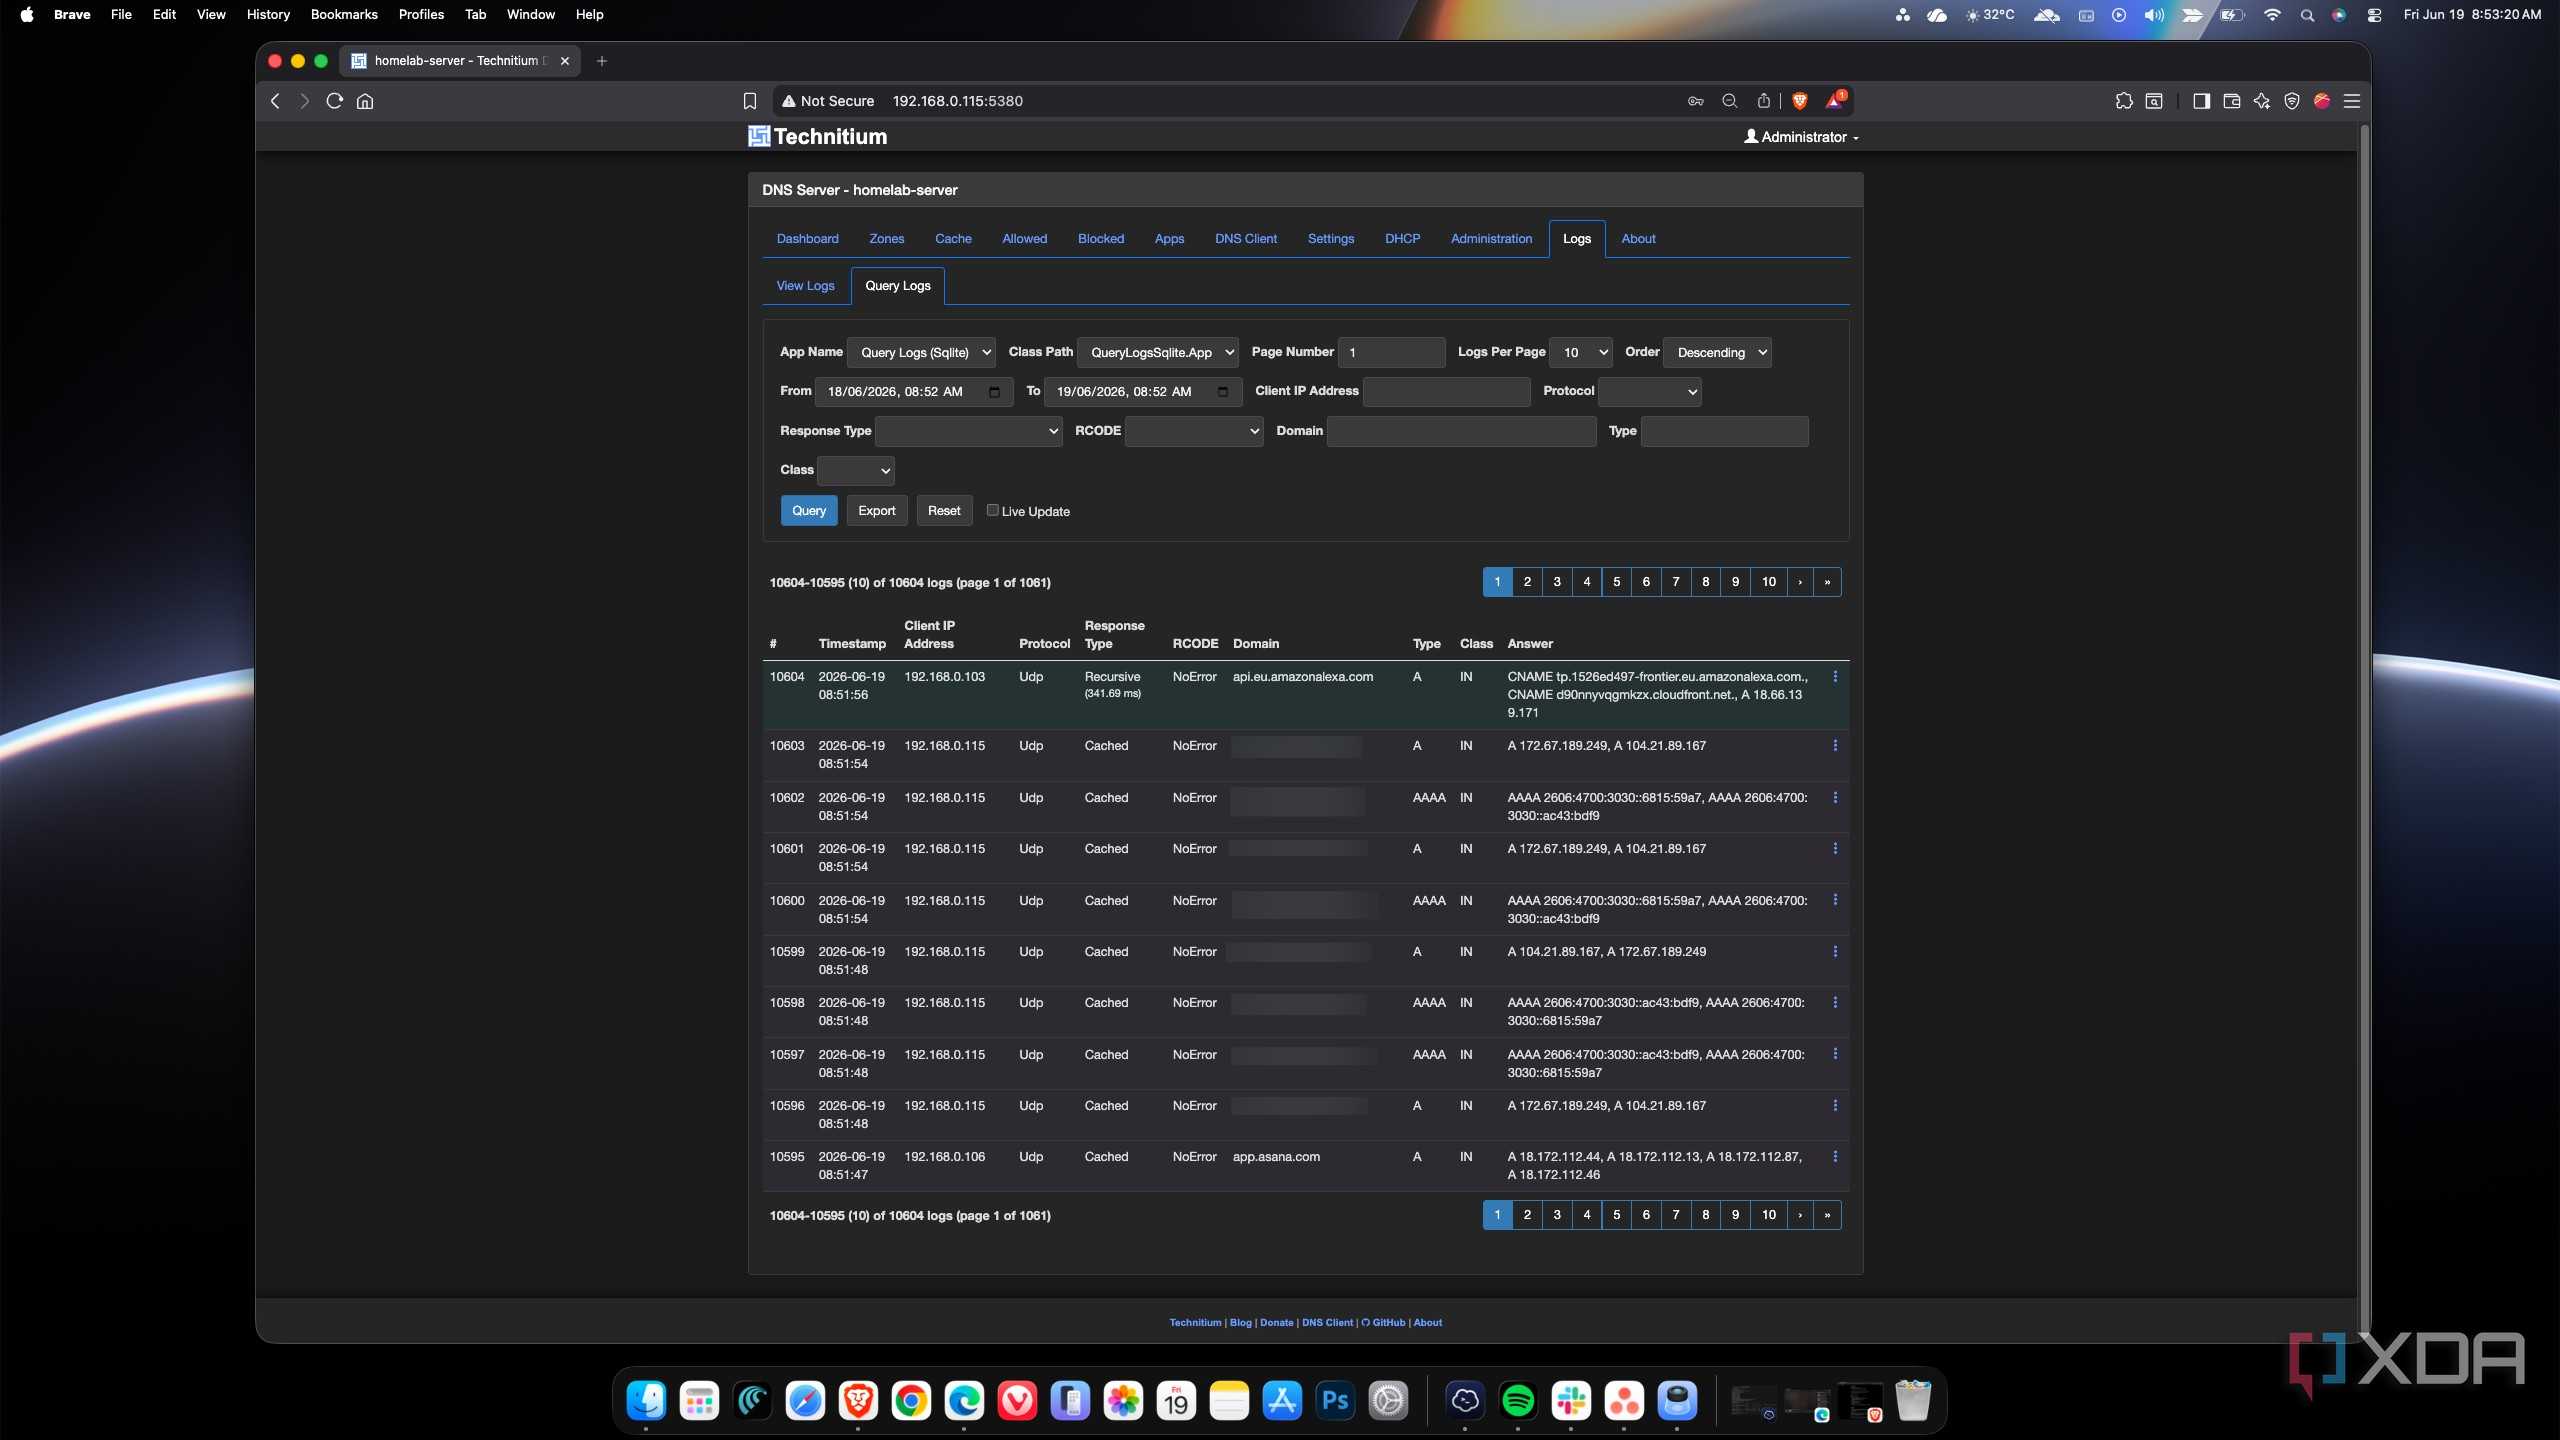
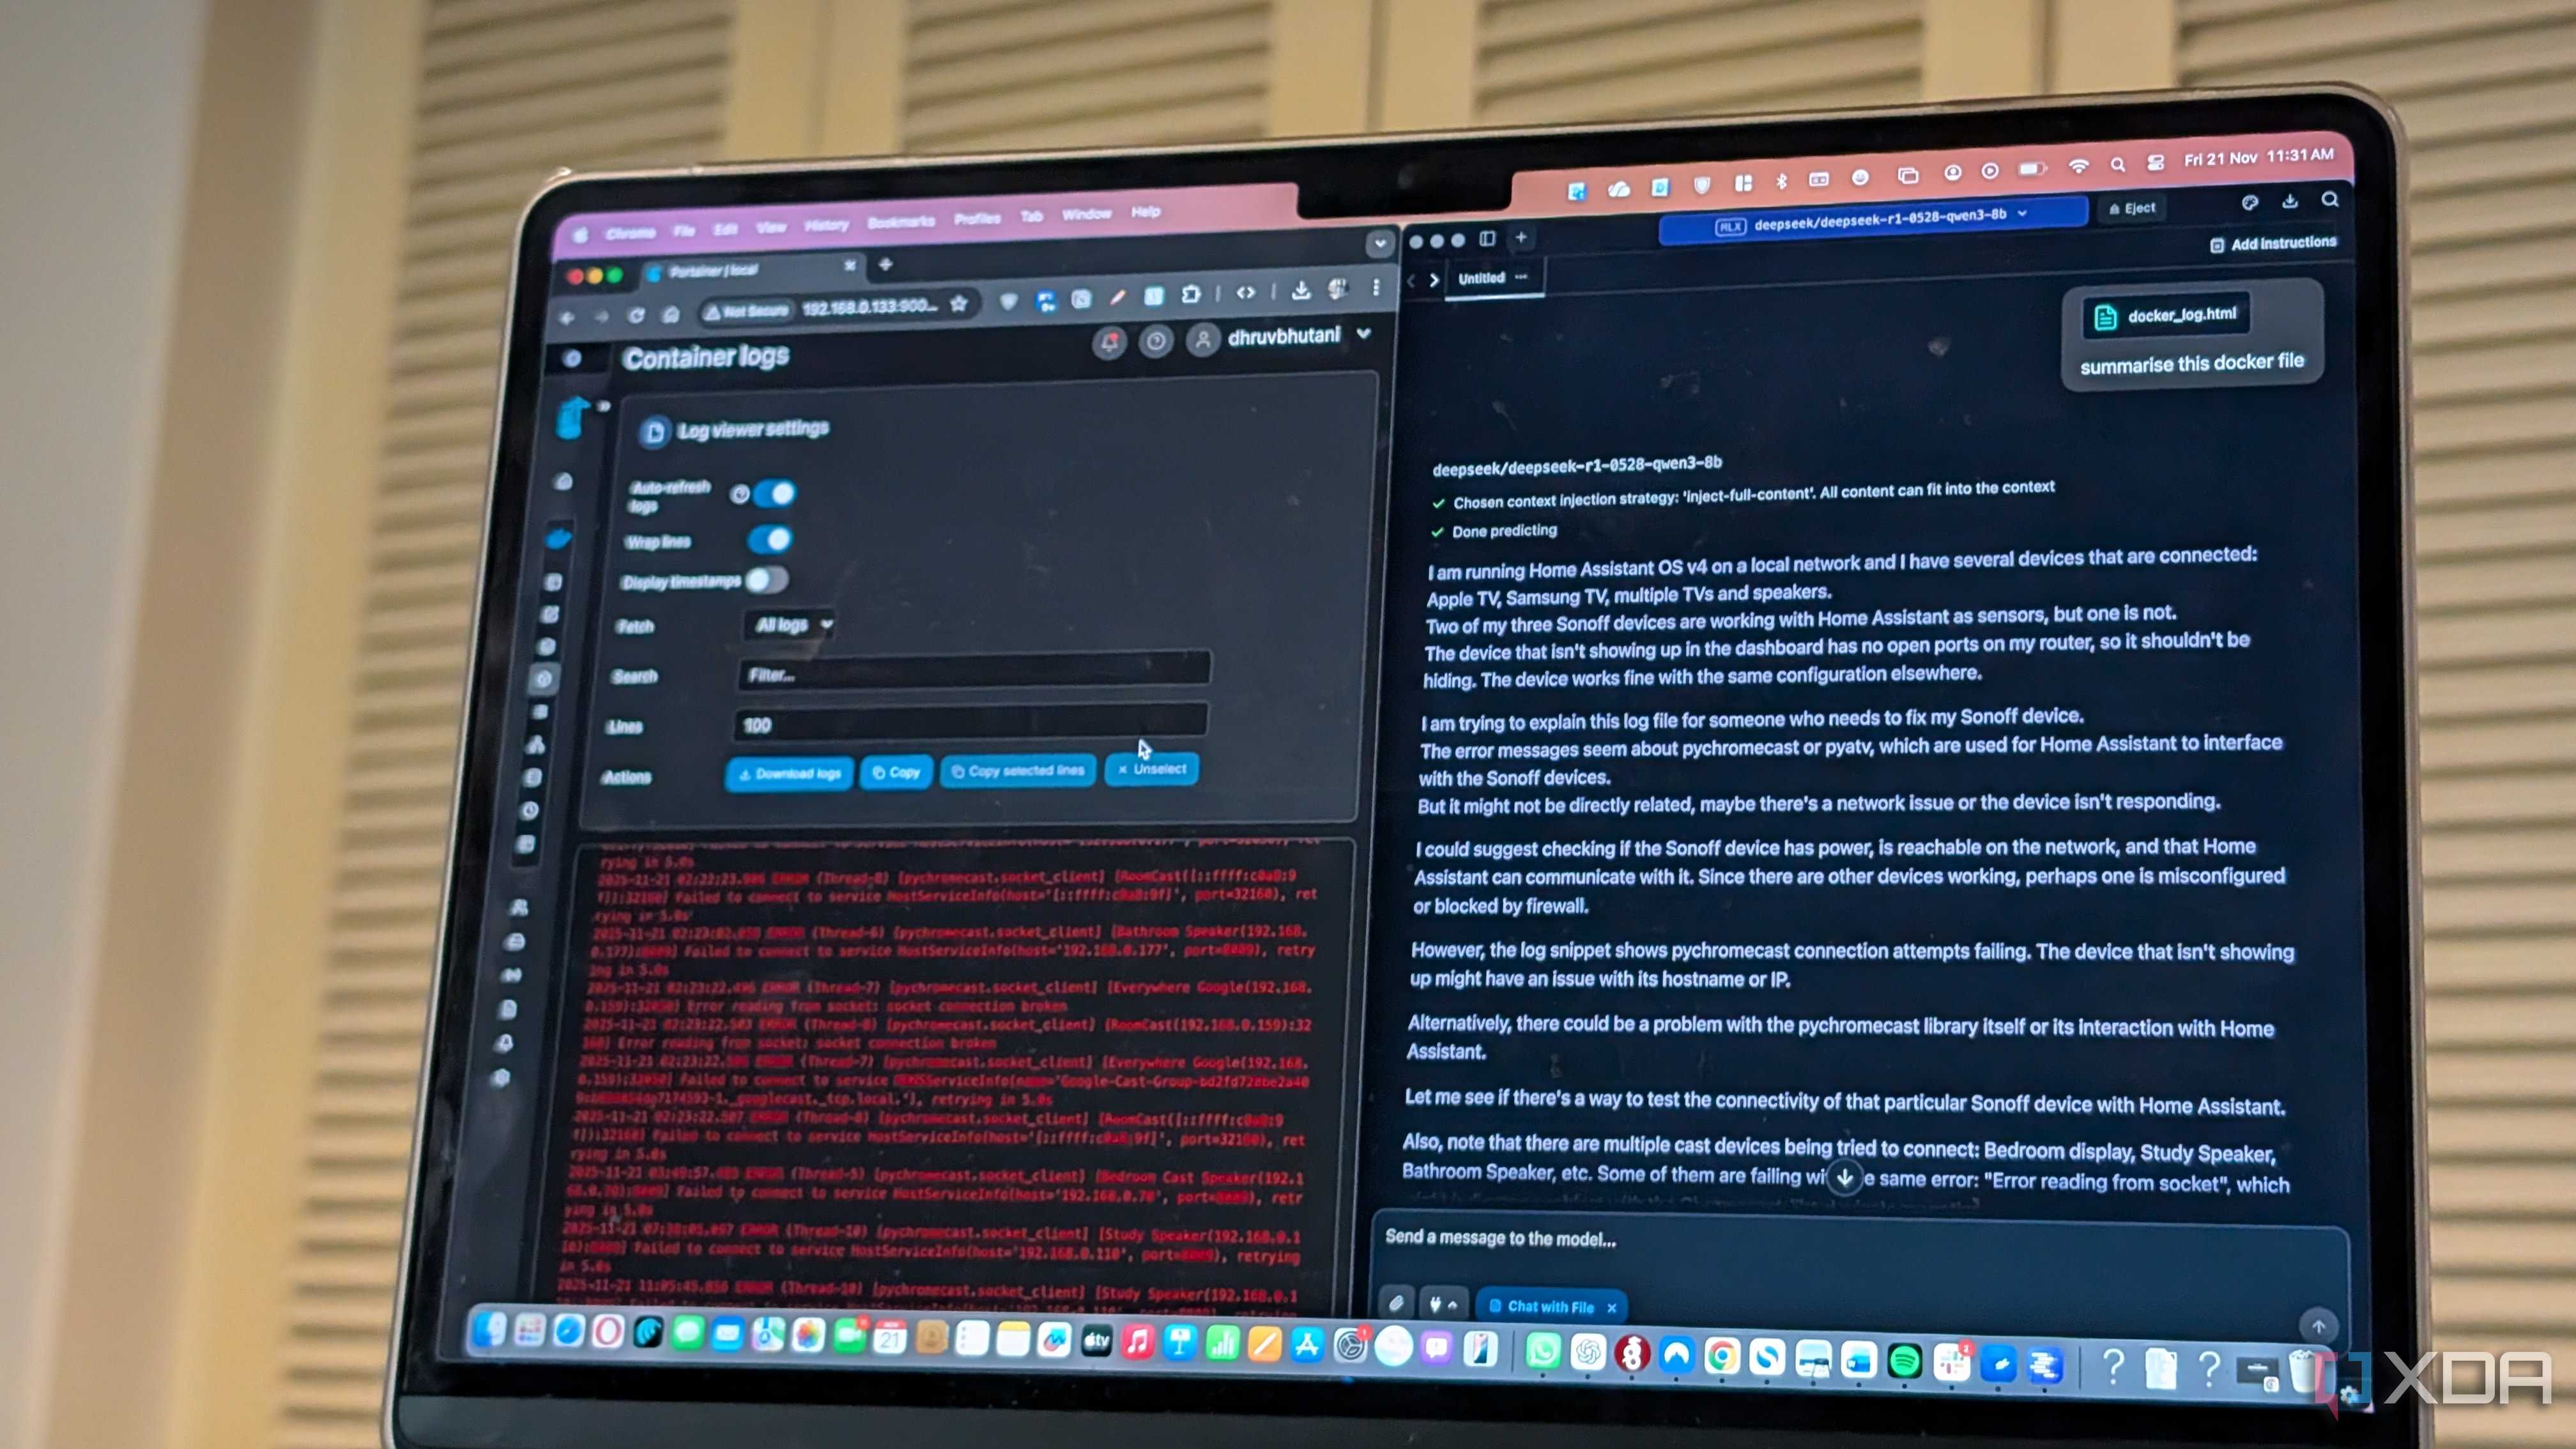
* «Живой» доступ: Claude Code получает доступ к «сырому» архиву логов вместе с двумя инструментами — обертками над `journalctl` и `pvesh`. Это позволяет модели проводить расследование динамически, отвечая на уточняющие вопросы пользователя.
Сравнительное тестирование обоих методов показало, что они склонны к разным типам ошибок, поэтому выбор подхода напрямую зависит от ожидаемого баланса между контролем данных и гибкостью анализа.
Синтетическая проверка: испытание на «галлюцинации»
Перед тем как допустить Claude Code к реальному серверу, была проведена симуляция на сгенерированных логах. В них были намеренно внедрены «ловушки» для проверки критического мышления модели:
- Запрос информации об IP-адресе, который не используется в домашней сети.
- Вопрос о процедуре failover в keepalived, которая физически существует только внутри двух DNS-контейнеров и не отражается в основном журнале хоста.
Если бы модель ответила на эти вопросы утвердительно, это стало бы сигналом того, что ИИ склонен к выдумкам (галлюцинациям) относительно инфраструктуры. Однако при тестировании с использованием модели Sonnet 3.5 модель проявила должную осторожность и отказалась обрабатывать ложные данные, что подтвердило надежность системы.
Тонкая настройка: от grep к контекстному пониманию
В процессе работы возникли поучительные инциденты, потребовавшие доработки инструментов. Например, при анализе отсутствия email-оповещений Claude Code сначала выполнил команду grep, не нашел вхождений и сделал логический вывод: «почтовый получатель не настроен». Однако реальная проблема заключалась в том, что postfix отклонял отправку из-за отказа в соединении с портом 25. Анализ показал, что инструмент нуждался в расширении словаря поиска, чтобы различать отсутствие настроек и программные сбои при передаче пакетов.
Также были выявлены ложные срабатывания регулярных выражений: например, отсутствие данных о перезагрузке узла в «дайджесте» было вызвано тем, что в правила обработки не была включена строка `apt: Installing`, отвечающая за логи обновлений системы. После простой корректировки кода диджестера эти пробелы в «знаниях» модели были устранены.
Результативность метода
Анализ 15-дневного архива журналов показал, что реальные логи Proxmox в десять раз меньше синтетических, так как они не содержат избыточных данных о репликации, запускаемой каждую минуту. Тем не менее, именно этот объем данных позволил обнаружить:
- Проблему с шаблоном ВМ, который при каждой загрузке пытался инициализироваться, будучи ошибочно помеченным как активный объект с параметром onboot: 1.
- Отсутствие реальных записей о выполнении резервного копирования для 41 задачи в индексе.
- Скрытую проблему с уведомлениями: почтовые серверы Google отклоняли все письма из-за отсутствия релея для домашнего IP-адреса, что привело к накоплению bounced-сообщений за два года.
- Факт кратковременного сбоя (flapping) сетевой карты Realtek 21 августа, который привел к «нечистой» (not clean) загрузке системы.
Автор отмечает: хотя инфраструктура изначально строилась с упором на отказоустойчивость, логи хранили свидетельства ошибок, о которых администратор даже не догадывался. Использование ИИ в данном контексте — это не замена администратора, а способ преодолеть «проблему чтения», превращая 60 000 строк системного шума в четкий список задач для обслуживания.