Современные голосовые помощники, такие как Alexa и Google Gemini, обеспечивают высокий уровень удобства, однако за это приходится платить приватностью, подписками и воздействием рекламных алгоритмов. Помимо вопросов конфиденциальности, существует проблема задержек: большинство процессов обработки команд происходит на облачных серверах. В попытке создать полностью частную систему автор проекта пришел к выводу, что локальный голосовой помощник не только надежнее, но и заметно быстрее коммерческих аналогов, работая на обычном потребительском графическом процессоре.
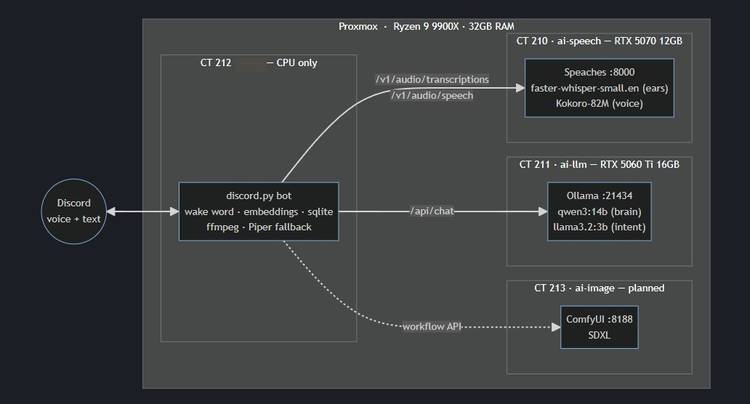
Архитектура локальной голосовой системы
Для создания полноценного ассистента потребовалась комбинация из пяти компонентов с открытым исходным кодом. Изначально многие из них были разработаны для Discord-ботов, но они оказались вполне пригодны для использования в домашней автоматизации.
Основные компоненты стека
- Распознавание кодовой фразы: За активацию системы отвечает легкая и постоянно работающая модель. Оптимальным выбором стала openWakeWord, хотя также можно рассмотреть microWakeWord.
- Преобразование речи в текст: Для этой задачи используется модель Parakeet от NVIDIA. При запуске на видеокарте 5060 Ti она транскрибирует речь быстрее, чем человек успевает говорить.
- Дерево решений: Текстовые команды сначала проходят через систему классификации. Простые запросы, такие как «Включи X», выполняются мгновенно без обращения к ИИ-моделям.
- Обработка естественного языка: Если простая команда не найдена, запрос направляется в модель llama3.2:3b, которая сопоставляет разговорную речь со списком предопределенных действий.
- Интеллектуальное ядро: Для сложных бесед используется модель Qwen 3. Она анализирует фразы, которые не являются прямыми командами, и позволяет поддерживать полноценный диалог.
- Синтез речи: За озвучивание ответов отвечает система Kokoro.
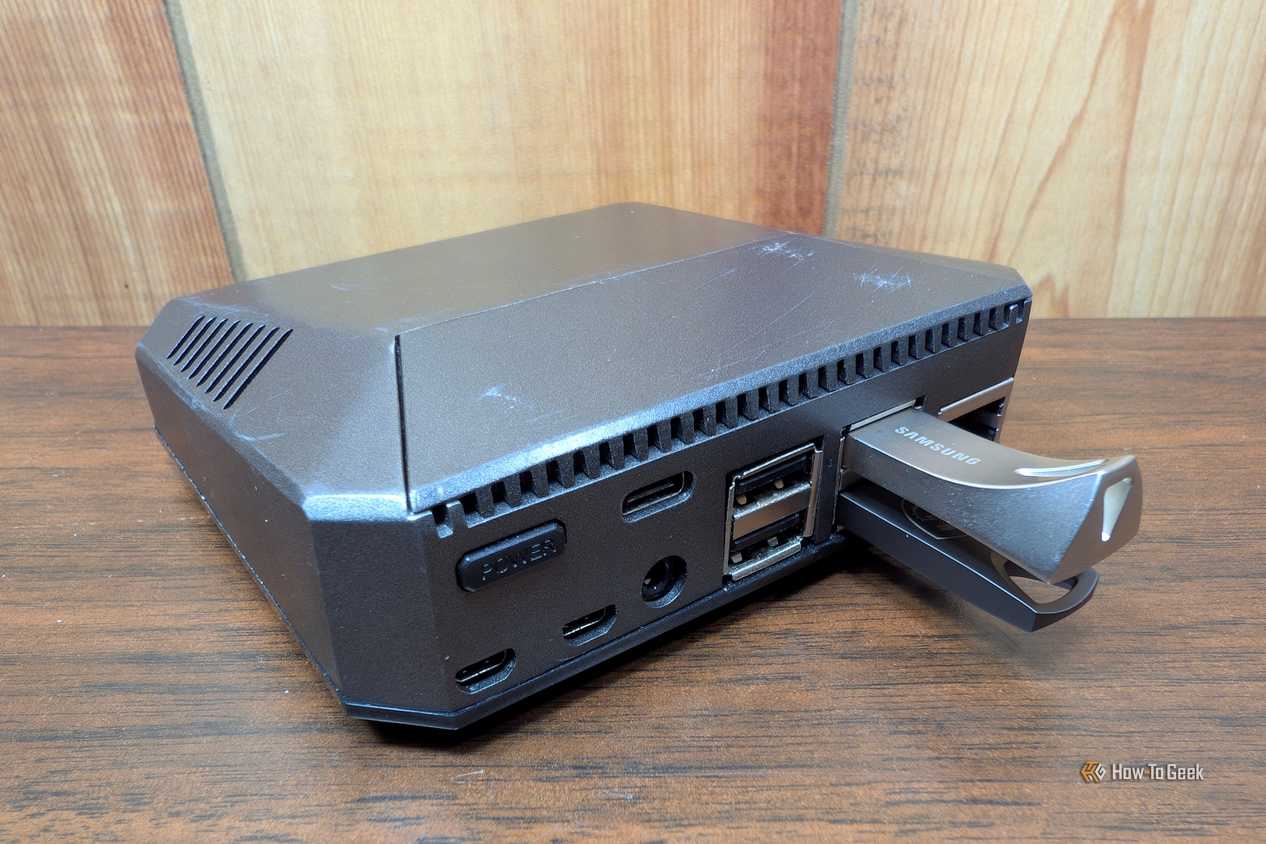
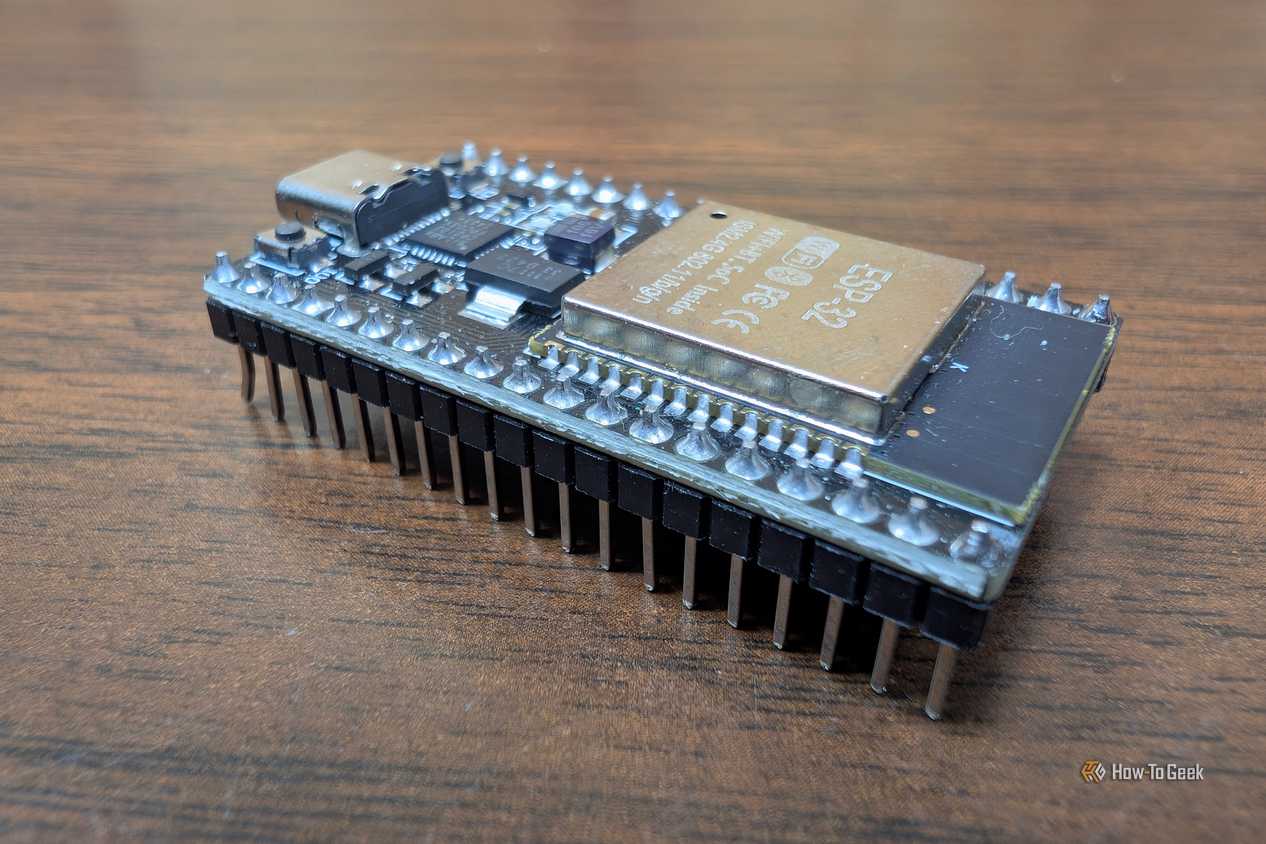
Оркестрация всех элементов возможна через конвейер Home Assistant Assist по протоколу Wyoming или с помощью пользовательских скриптов. Аппаратная часть требует сервера с дискретной видеокартой для обработки нагрузки, а в качестве микрофонов и динамиков (сателлитов) по комнатам могут выступать устройства на базе Raspberry Pi или ESP32.
Преимущества локальных вычислений
При использовании коммерческих помощников конфиденциальность пользователя полностью зависит от политики компании. Неясно, сохраняются ли фрагменты разговоров, используются ли случайные записи для дообучения моделей и что происходит при ложных срабатываниях на кодовую фразу. Локальный помощник полностью лишен этих рисков.
В конфигурации автора предусмотрена возможность отказа от хранения любых записей после настройки системы. Также полностью исключена таргетированная реклама на основе данных о предпочтениях пользователя.
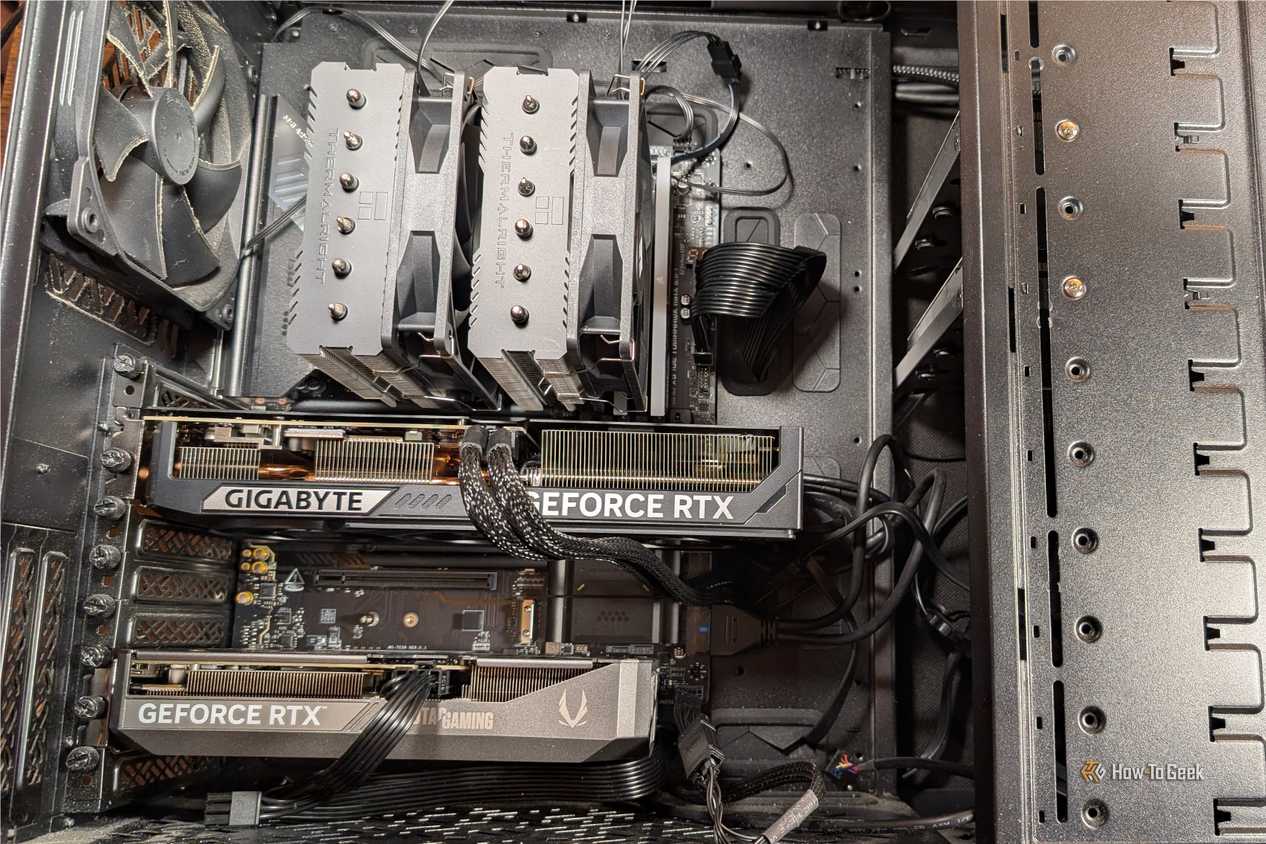
Производительность в сравнении с облачными решениями
Локальная обработка данных оказалась значительно быстрее облачных сервисов. Автор отметил, что типичная задержка при взаимодействии с коммерческим ассистентом заметна на слух. В собственной системе активация происходит за доли секунды, а простая транскрипция завершается быстрее окончания речи.
Сложнее обстоит дело с «мозгом» системы — моделью Qwen 3.x. При первом запуске она загружается более 10 секунд, но после размещения в видеопамяти (VRAM) выдает ответы в темпе живого общения. Для работы Parakeet, Kokoro и Llama3.2:3b достаточно графического адаптера с 8 ГБ памяти, а модели с 12–16 ГБ позволяют расширить функциональность.
Сложности внедрения проекта
Создание такой системы — проект не для новичков. На отладку надежной работы всех компонентов у автора ушло более двух недель при активной поддержке ИИ-ассистента. Необходимо учитывать время на исправление ошибок взаимодействия моделей, настройку передачи данных и отладку команд. Тем не менее, возможность создать полностью приватную систему, обученную под конкретные речевые привычки и нужды пользователя, оправдывает затраченные усилия.
Как именно работает логика команд
Важным аспектом системы является многоуровневая обработка запросов, которая минимизирует лишние вычисления. Архитектура построена так, чтобы не нагружать тяжелые нейросети там, где достаточно простого сопоставления с базой данных. Если пользователь произносит явную команду вроде «Play X», она перехватывается еще на этапе анализа дерева решений — в этот момент не требуется обращение к LLM. Однако гибкость системы проявляется именно в работе с естественной речью. Когда пользователь говорит: «Эй, помощник, я в настроении послушать немного AC/DC», модель llama3.2:3b не просто распознает слова, она сопоставляет семантическое содержание фразы со списком заданных команд. Система «понимает», что под этим предложением скрывается стандартное действие «Play AC/DC», даже если само название группы или фраза не были произнесены буквально. И только если llama3.2:3b определяет, что запрос не является командой управления устройствами, «эстафета» передается модели Qwen 3, которая выступает в роли «большого мозга», способного поддерживать контекстный диалог.
Приватность как осознанный выбор
В коммерческих решениях приватность пользователя — это величина переменная, зависящая от текущих и будущих условий обслуживания. Одной из главных проблем остается так называемый «сбор данных при ошибках»: если устройство сработало ложно (активировалось без кодовой фразы), вы не можете быть уверены, что фрагмент вашего разговора не был записан и отправлен в облако для последующего «улучшения качества распознавания». В локальной системе такой риск исключен на уровне архитектуры. На этапе отладки автор проекта специально настроил сохранение логов с «ложных срабатываний» и непонятых команд, чтобы дообучить модель (создать LORA-адаптер) под свои индивидуальные речевые особенности и специфические запросы. Однако после завершения этапа калибровки все процессы сохранения данных были отключены. Теперь система не хранит историю обращений, что делает ее абсолютно автономной и защищенной от попыток маркетингового профилирования.
Производительность: миф об облачном превосходстве
Вопреки распространенному мнению, что локальное оборудование всегда уступает мощностям корпоративных серверов, практика показала обратное. Задержка в ответе, которую мы привыкли воспринимать как данность при использовании облачных помощников, зачастую вызвана не столько скоростью интернета, сколько временем «путешествия» пакетов данных и их последующей серверной обработки. В локальной среде этот цикл сокращен до минимума. Parakeet транскрибирует аудио в текст быстрее, чем человек успевает физически произнести фразу. Даже при использовании LLM для интерпретации сложных запросов, время отклика составляет менее одной секунды после завершения речи пользователя. Единственный момент, требующий внимания, — это время холодного старта: первая загрузка модели Qwen 3 в VRAM занимает около 10 секунд, однако после того как данные закреплены в памяти, последующие ответы происходят на уровне «человеческой» скорости, без раздражающих пауз.
Масштабируемость и советы по внедрению
Проект обладает высокой степенью модульности — «сердце» этой системы, состоящее из связки пяти компонентов, может быть перенесено в другие среды. Например, нет принципиальной разницы между тем, слушает ли модель физический микрофон для управления умным домом или анализирует текстовый чат в Discord. Для тех, кто решится на повторение, ключевым требованием является наличие видеокарты с объемом памяти от 8 ГБ, что позволяет одновременно запустить Parakeet, Kokoro и Llama3.2:3b. Карты с 12–16 ГБ VRAM открывают еще большие возможности для расширения стека. Основным препятствием остается время: даже при использовании помощи ИИ (в частности, Claude), на создание стабильной системы ушло более двух недель. Это не «коробочный» продукт, а конструктор, требующий кропотливой настройки цепочек передачи данных между моделями, но итоговый результат в виде полностью контролируемого и невероятно быстрого помощника стоит затраченных усилий.