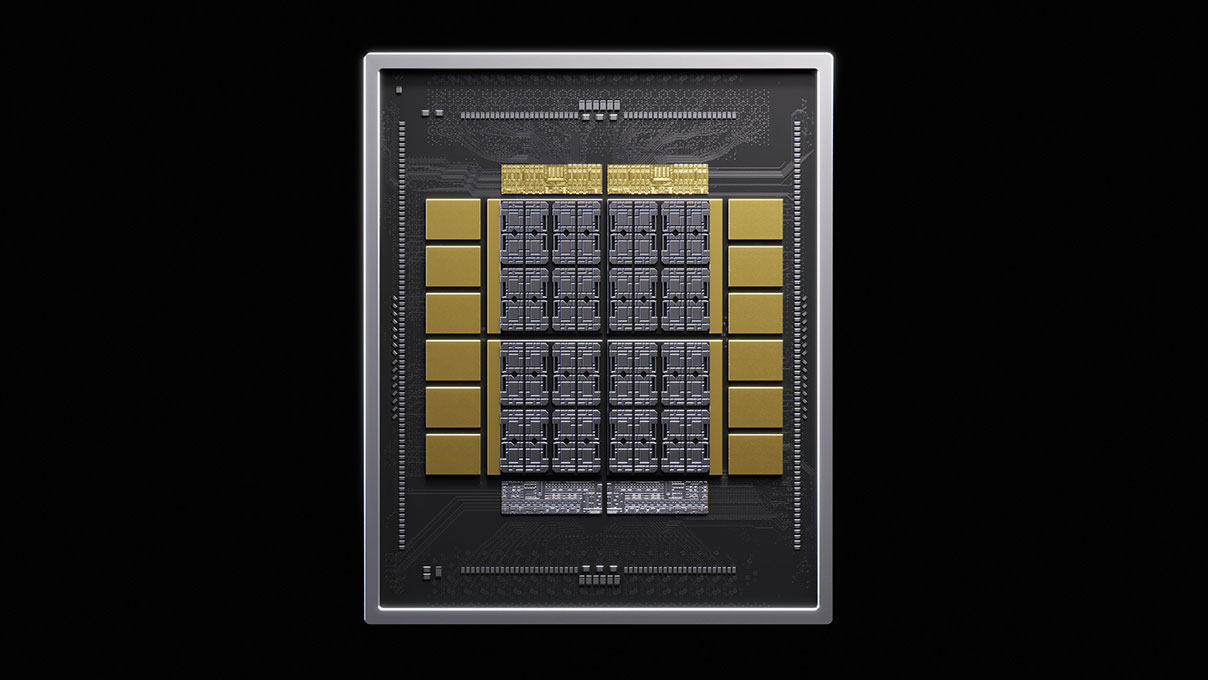
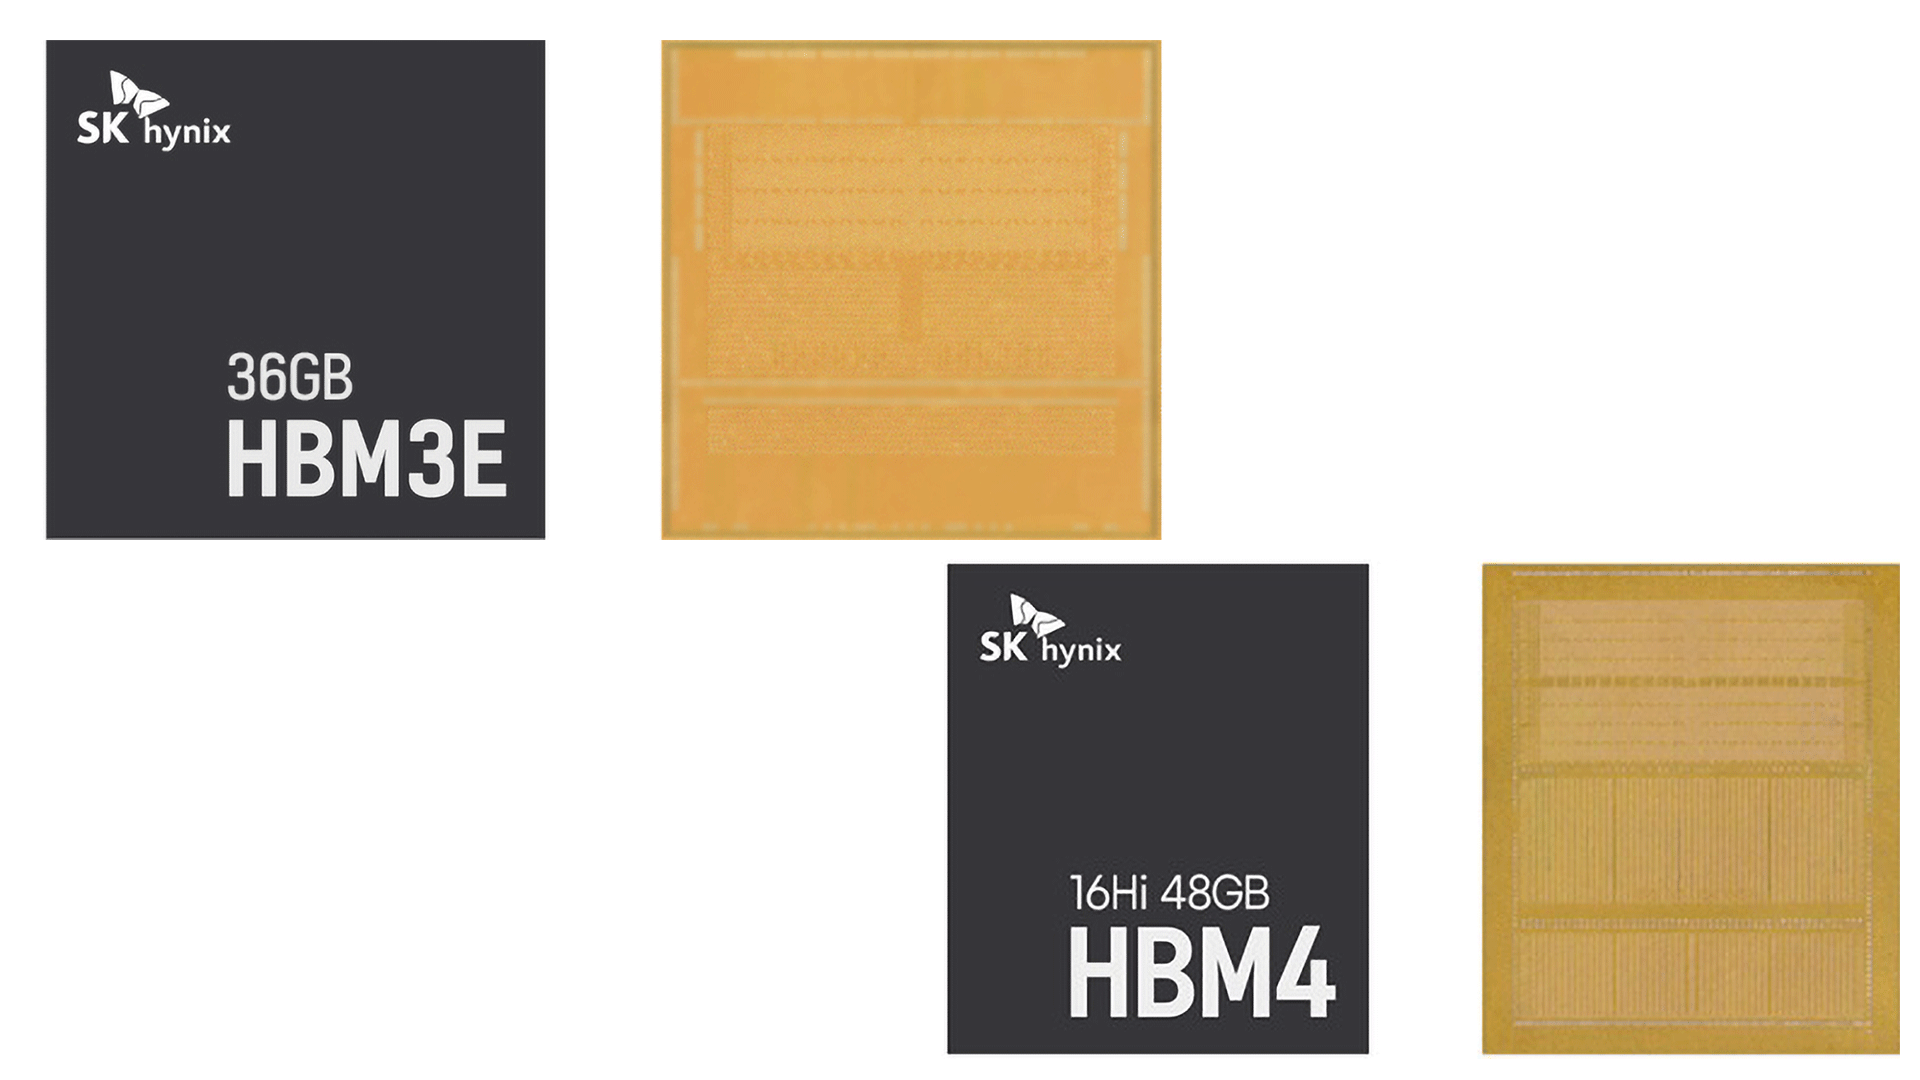
Компания Nvidia расширила инструментарий программы NVLink Fusion, представив новый компонент — NVHBM. Это специализированная реализация высокоскоростной памяти, предназначенная для интеграции в кастомные чипы, используемые в масштабируемых ИИ-системах, таких как Vera Rubin NVL72. Новая технология представляет собой кастомную базовую подложку, которая, по заявлениям разработчика, превосходит стандартные решения HBM4e по ключевым техническим характеристикам.
Преимущества кастомной архитектуры памяти
Согласно техническим спецификациям, NVHBM обеспечивает прирост пропускной способности до 30% на стек по сравнению с серийной памятью HBM4e. Для задач, связанных с работой искусственного интеллекта, где скорость передачи данных является критическим фактором, это позволяет существенно повысить производительность, например, увеличить количество обрабатываемых токенов в секунду при выполнении операций логического вывода.
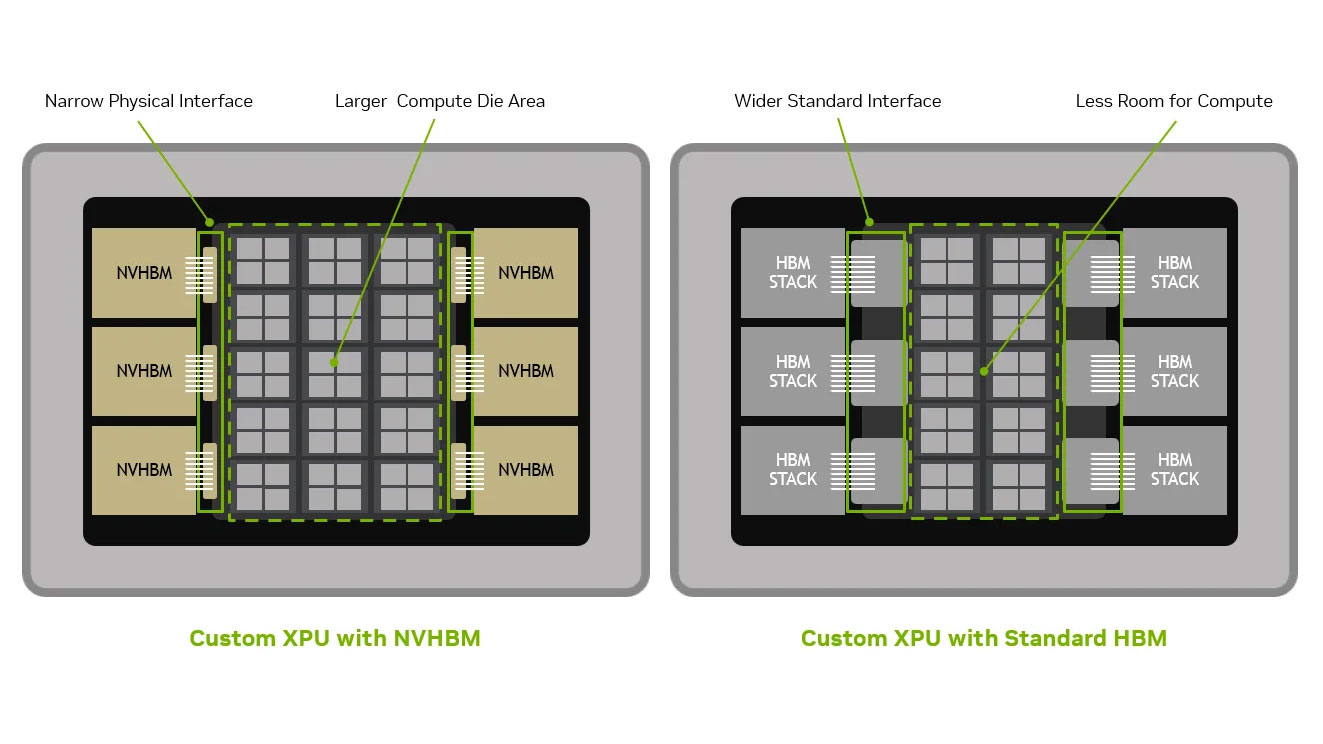
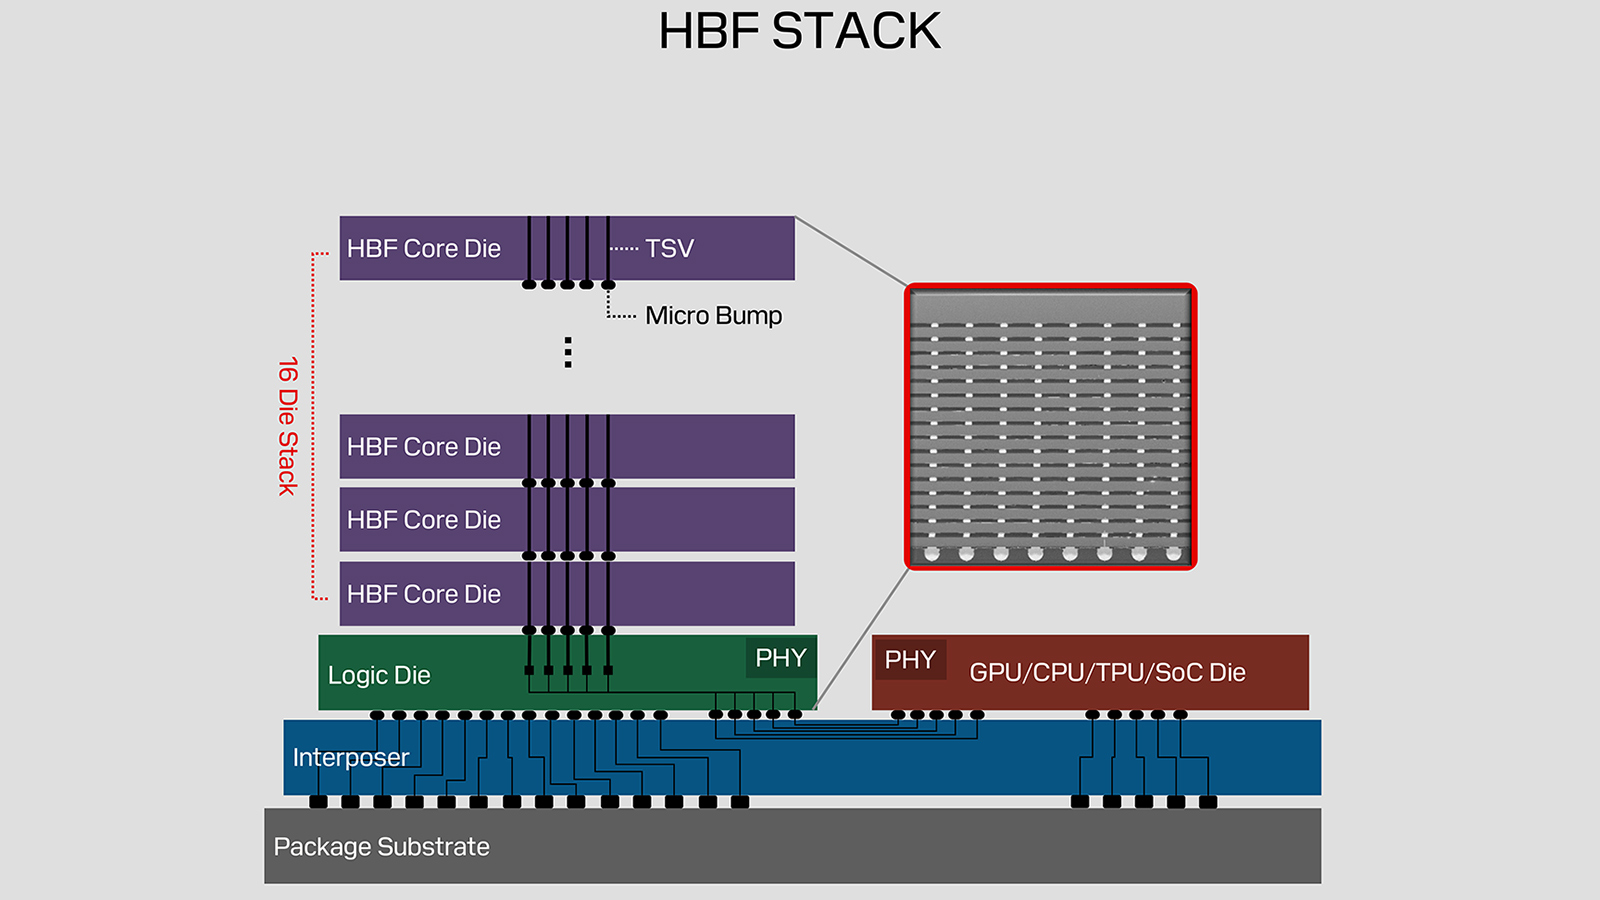
Кроме того, использование NVHBM позволяет оптимизировать компоновку основного процессора. В традиционных архитектурах контроллер памяти обычно размещается на главном вычислительном кристалле. В случае с NVHBM контроллер перенесен в базовую подложку самого стека памяти, а для взаимодействия с ним используется компактный PHY-интерфейс. По расчетам Nvidia, такой подход освобождает до 30% площади основного кремниевого кристалла, которую можно использовать для расширения вычислительных мощностей чипа.
Энергоэффективность и простота интеграции
Помимо производительности, новая разработка ориентирована на снижение энергопотребления. NVHBM потребляет на 15% меньше энергии, чем стандартные модули HBM4e. В масштабах крупных вычислительных систем, состоящих из тысяч процессоров, это обеспечивает значительную экономию энергии. Высвобожденный энергетический бюджет разработчики кастомных ускорителей могут направить либо на повышение общей производительности, либо на наращивание функциональных блоков внутри системы.
Nvidia отмечает, что данная технология разрабатывалась совместно с ключевыми производителями памяти. Это должно сократить время выхода готовых продуктов на рынок для партнеров компании, использующих кастомный кремний, по сравнению с проектированием систем на базе стандартной памяти с нуля.
Первые шаги программы NVLink Fusion
Важно подчеркнуть, что NVHBM не является полной заменой стандартных модулей памяти HBM. Это специализированное решение, доступное исключительно в рамках программы NVLink Fusion для партнеров Nvidia, занимающихся созданием собственных ускорителей. В уже существующих системах серии Rubin, находящихся в производстве, данная технология не применяется.
Первым партнером, который будет внедрять NVHBM в свои разработки, стала компания Annapurna Labs, подразделение Amazon. Вице-президент Annapurna Нафеа Бшара отметил, что компания планирует использовать плоды этого технологического сотрудничества для будущих инфраструктурных решений AWS. Учитывая, что следующие поколения ИИ-чипов Annapurna Trainium 4 уже получили поддержку интерфейса NVLink Fusion, логично предположить, что интеграция NVHBM станет следующим этапом развития данных процессоров.
Особенности интеграции и технические детали
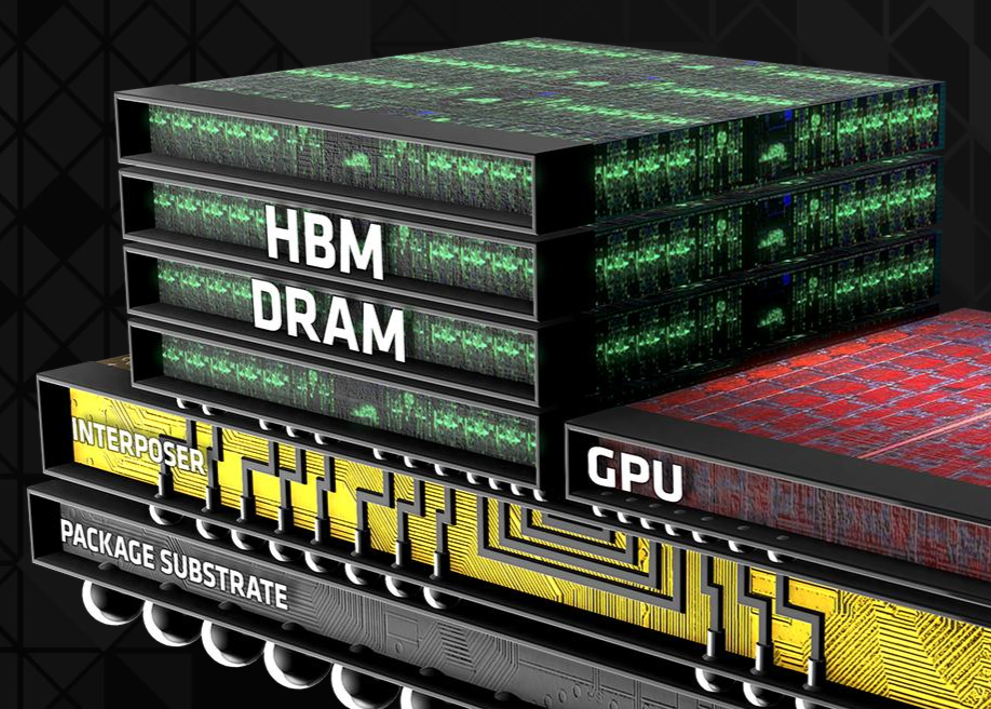
Важным аспектом внедрения NVHBM является оптимизация производственного процесса. Nvidia заявляет, что новая архитектура была спроектирована и прошла процесс валидации совместно с «ведущими производителями памяти». Такой подход дает разработчикам кастомных чипов возможность значительно быстрее вывести свои продукты на рынок, избавляя их от необходимости проектировать интерфейсы взаимодействия с памятью HBM с нуля. Кроме того, NVHBM упрощает проектирование трассировки интерпозера — критически важного компонента, который используется для объединения нескольких чипов в единую систему с применением передовых методов корпусирования.
Перенос контроллера памяти с основного кристалла на базовую подложку стека NVHBM радикально меняет подход к компоновке ускорителя. Если в классических схемах память требует значительных ресурсов основного процессора для управления потоками данных, то использование кастомного PHY-интерфейса в составе NVHBM снимает эту нагрузку с главного кремния. Освободившаяся площадь упаковки — те самые 30% — становится «золотым стандартом» для проектировщиков, позволяя либо нарастить количество вычислительных блоков, либо интегрировать дополнительные функциональные модули, которые ранее не помещались на кристалл из-за ограничений по размеру.
Энергоэффективность как ключевой фактор масштабирования
Вопрос энергопотребления стал центральной темой при представлении архитектуры Vera Rubin, и NVHBM здесь играет вспомогательную, но решающую роль. Nvidia подчеркивает, что каждый ватт, который не уходит на поддержание процессов генерации токенов, является критически важным ресурсом. Экономия в 15% по сравнению с серийными стеками HBM4e при умножении на тысячи чипов в составе стоечного решения дает колоссальный выигрыш в общей эффективности системы.
Эту энергию можно «зарезервировать» для достижения более высоких показателей производительности на ватт, перераспределить на питание дополнительных ядер внутри кастомного ускорителя или же использовать для повышения тактовых частот в рамках заданного теплового пакета. Для современных ИИ-нагрузок, где критически важные данные, такие как веса моделей и KV-кэши (Key-Value caches), постоянно перемещаются между вычислительными узлами и памятью, подобная оптимизация энергопотребления становится главным способом обхода «бутылочного горлышка» при масштабировании систем до уровня тысяч процессоров.
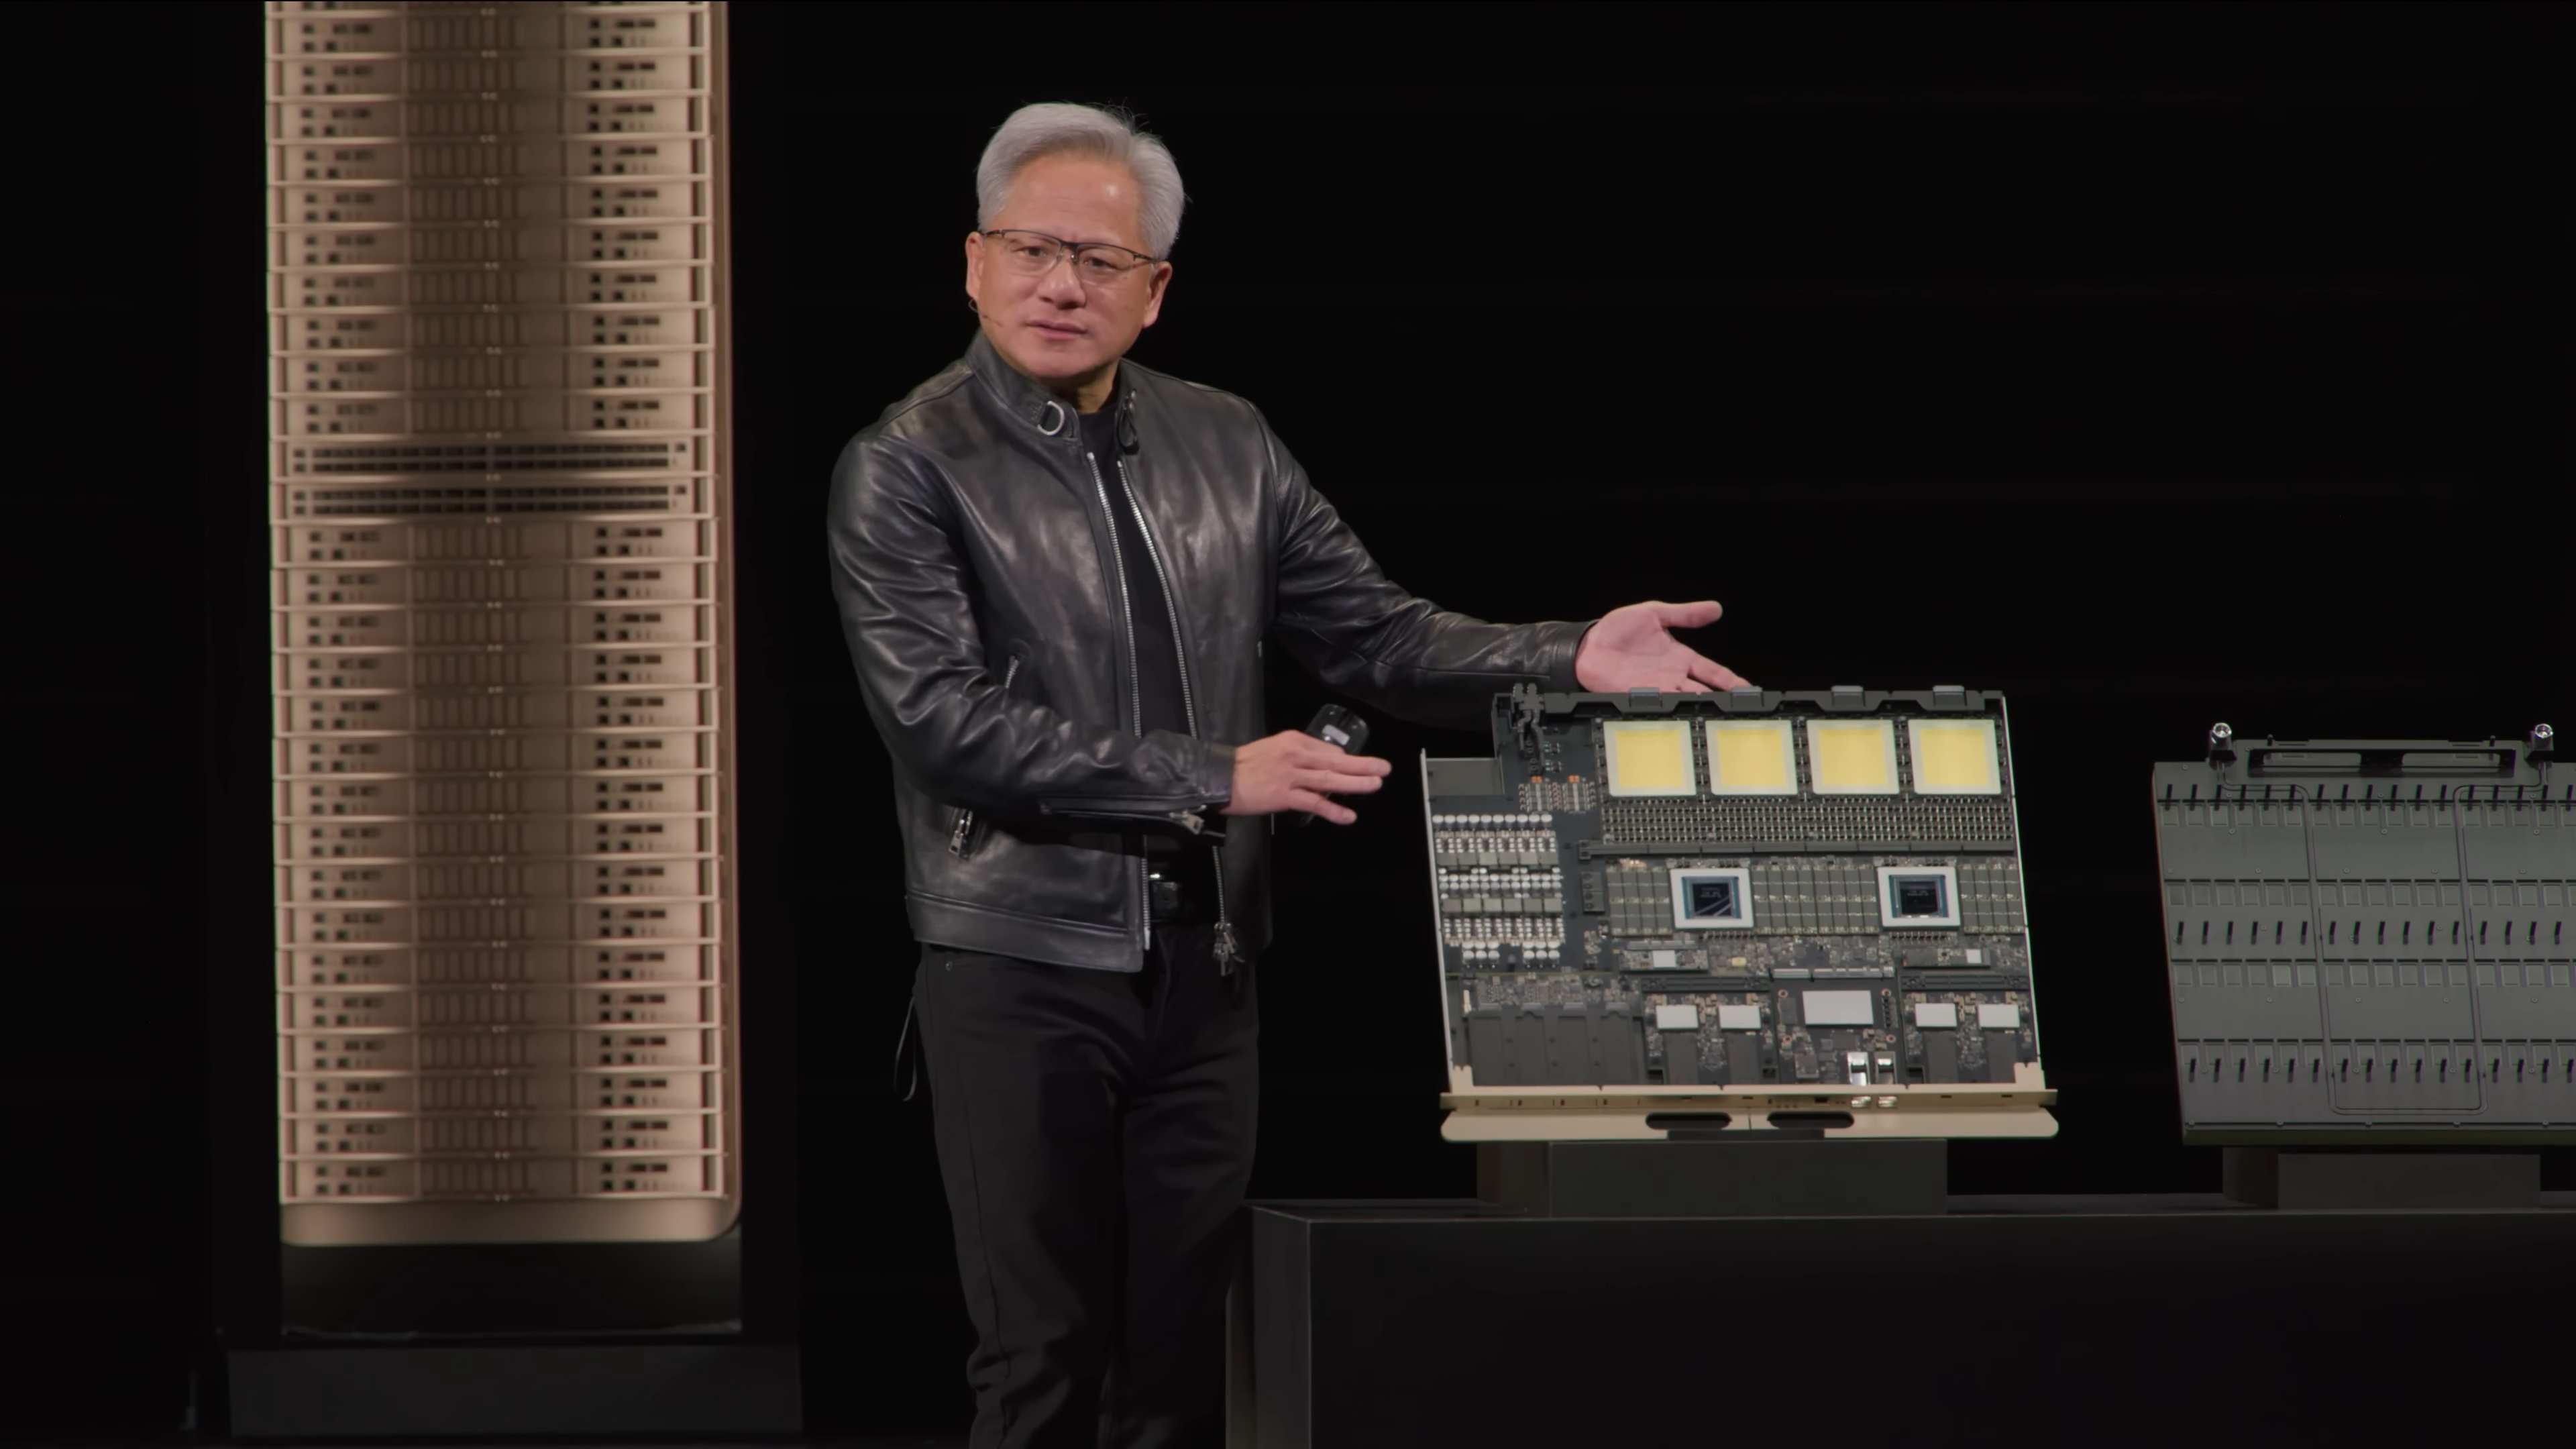
Несмотря на высокую эффективность, важно еще раз подчеркнуть: NVHBM — это не замена существующим стандартам, а узкоспециализированный инструмент, доступный только участникам экосистемы NVLink Fusion. На данный момент преимущества этой технологии — лишь аргумент для перспективных партнеров Nvidia, планирующих развитие своих архитектур, а не функционал, реализованный в текущем поколении стоек Rubin.