Использование облачных сервисов искусственного интеллекта, таких как ChatGPT и Claude, стало привычной частью повседневного рабочего процесса. Однако необходимость оплачивать подписки стоимостью 20 долларов в месяц за каждый сервис подтолкнула к поиску альтернатив, способных справиться с аналогичными задачами локально. Оказалось, что современные модели с открытым исходным кодом позволяют отказаться от ежемесячных платежей, сохранив при этом высокую эффективность выполнения рутинных операций.
Опыт работы с моделью Qwen 3.8-27B
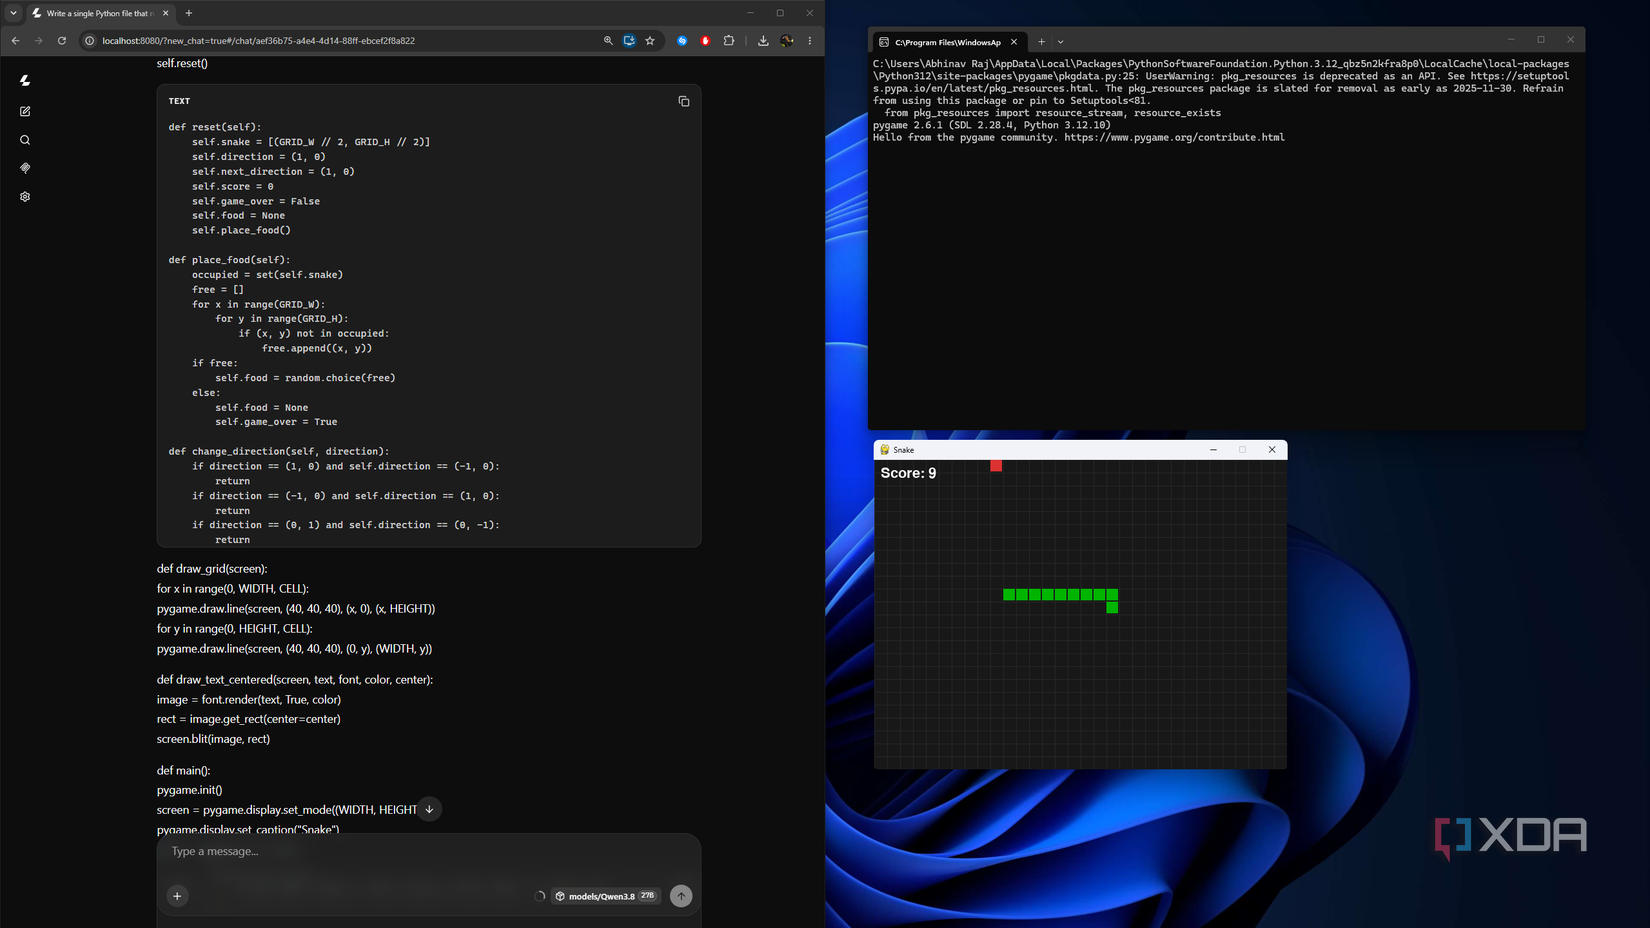
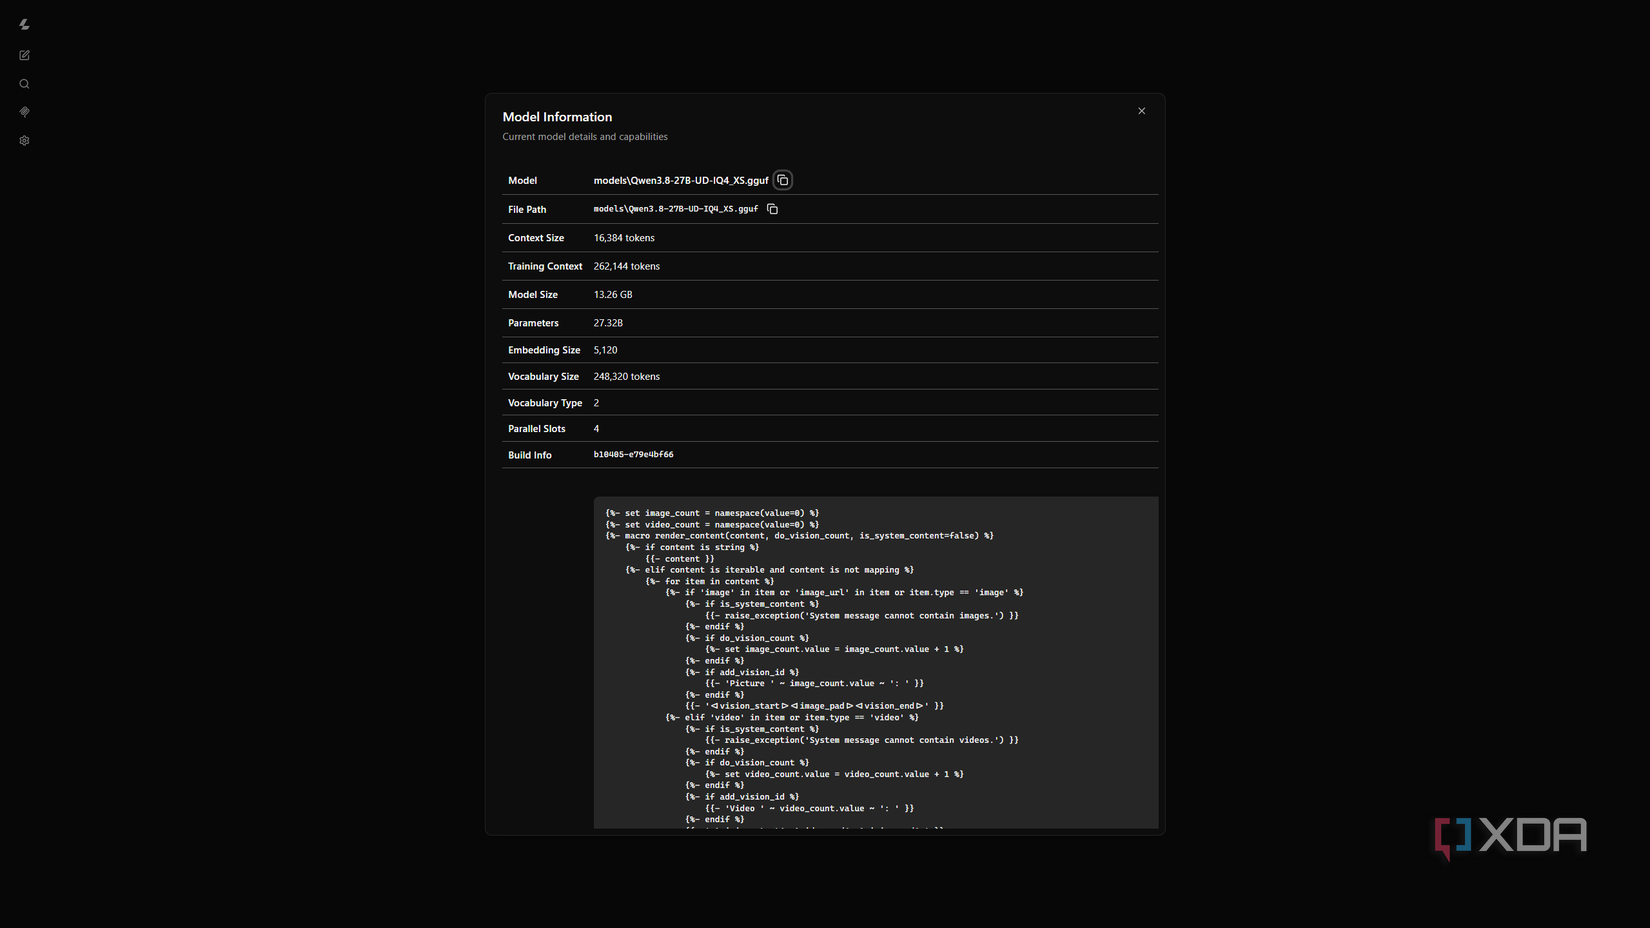
Одним из наиболее удачных решений стала модель Qwen 3.8-27B. Использование сборки UD-IQ4_XS от Unsloth требует 13,3 ГБ свободного места. При запуске на видеокарте 4070 Ti Super, оснащенной 16 ГБ памяти GDDR6X, модель демонстрирует стабильную работу с контекстным окном 16K. Инструмент llama.cpp позволяет использовать модель через локальный хост с комфортной скоростью генерации, достигающей примерно 33,7 токена в секунду. Практические тесты подтвердили состоятельность решения: модель успешно справляется с написанием кода для простых игр, таких как Snake, создавая рабочий проект в один заход.
Замена ChatGPT для повседневных задач
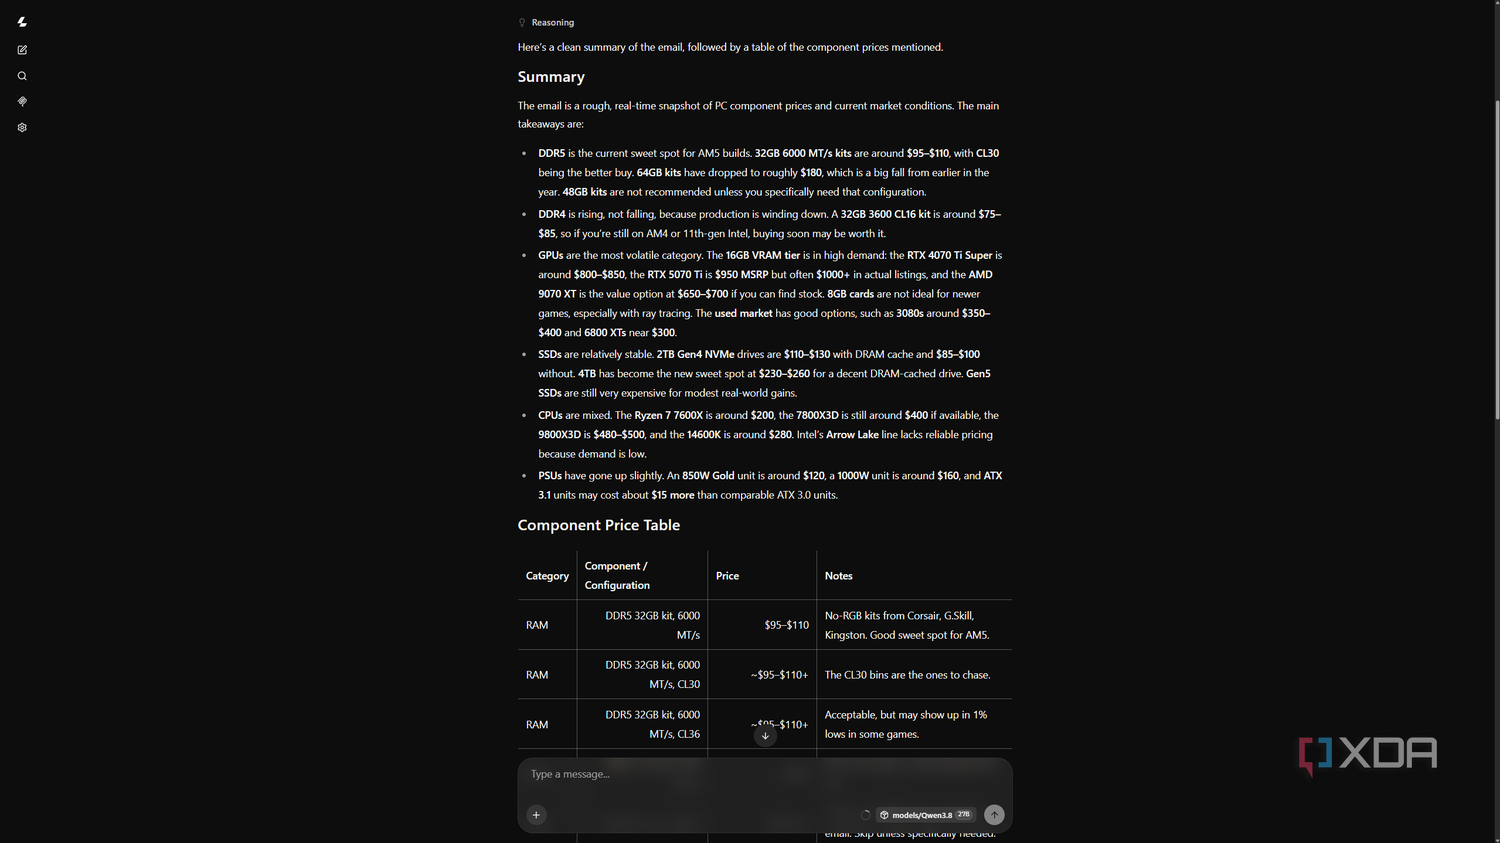
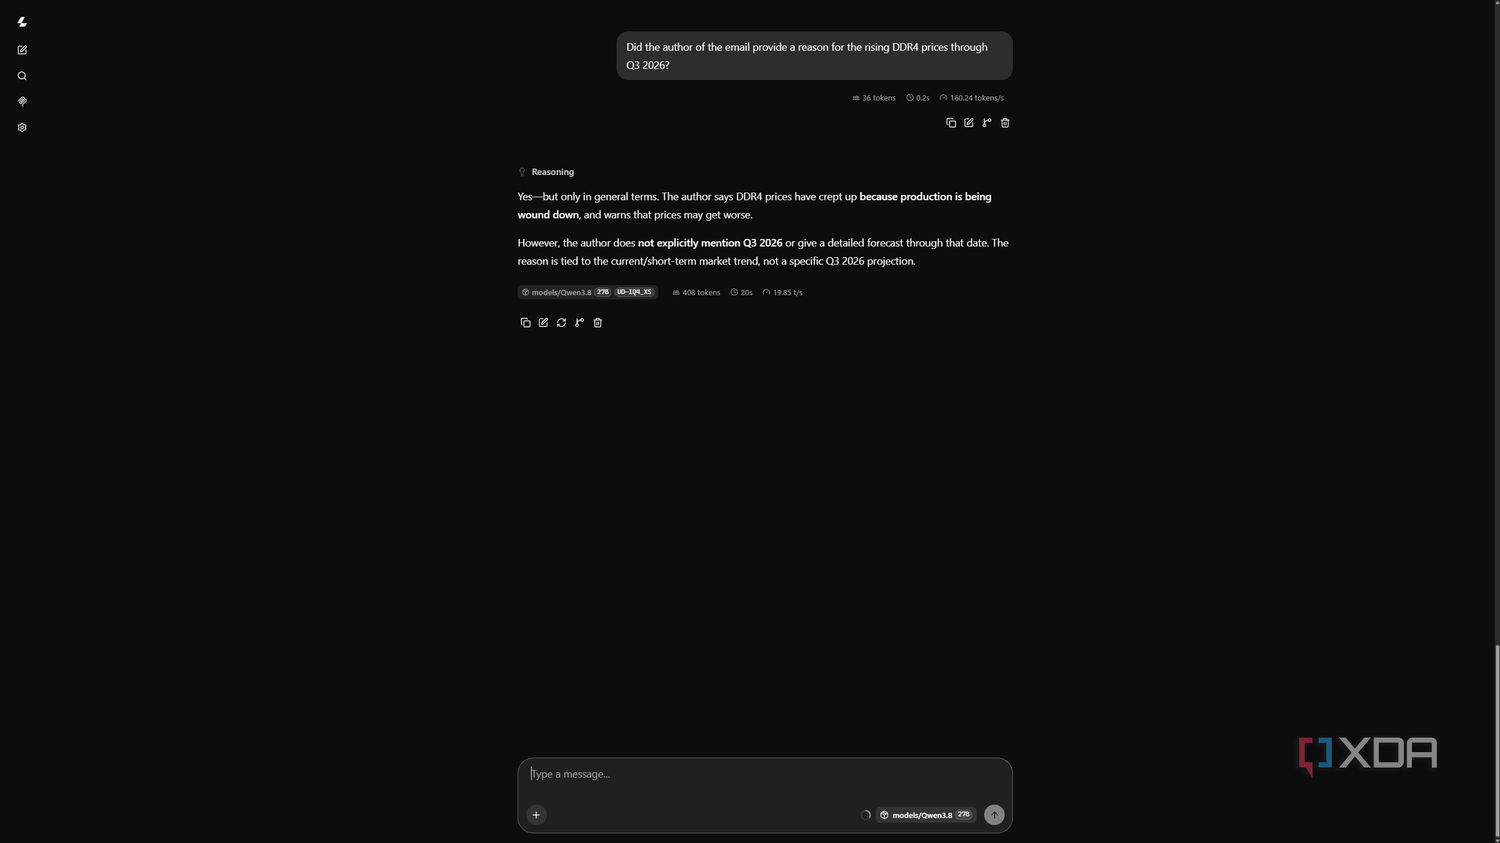
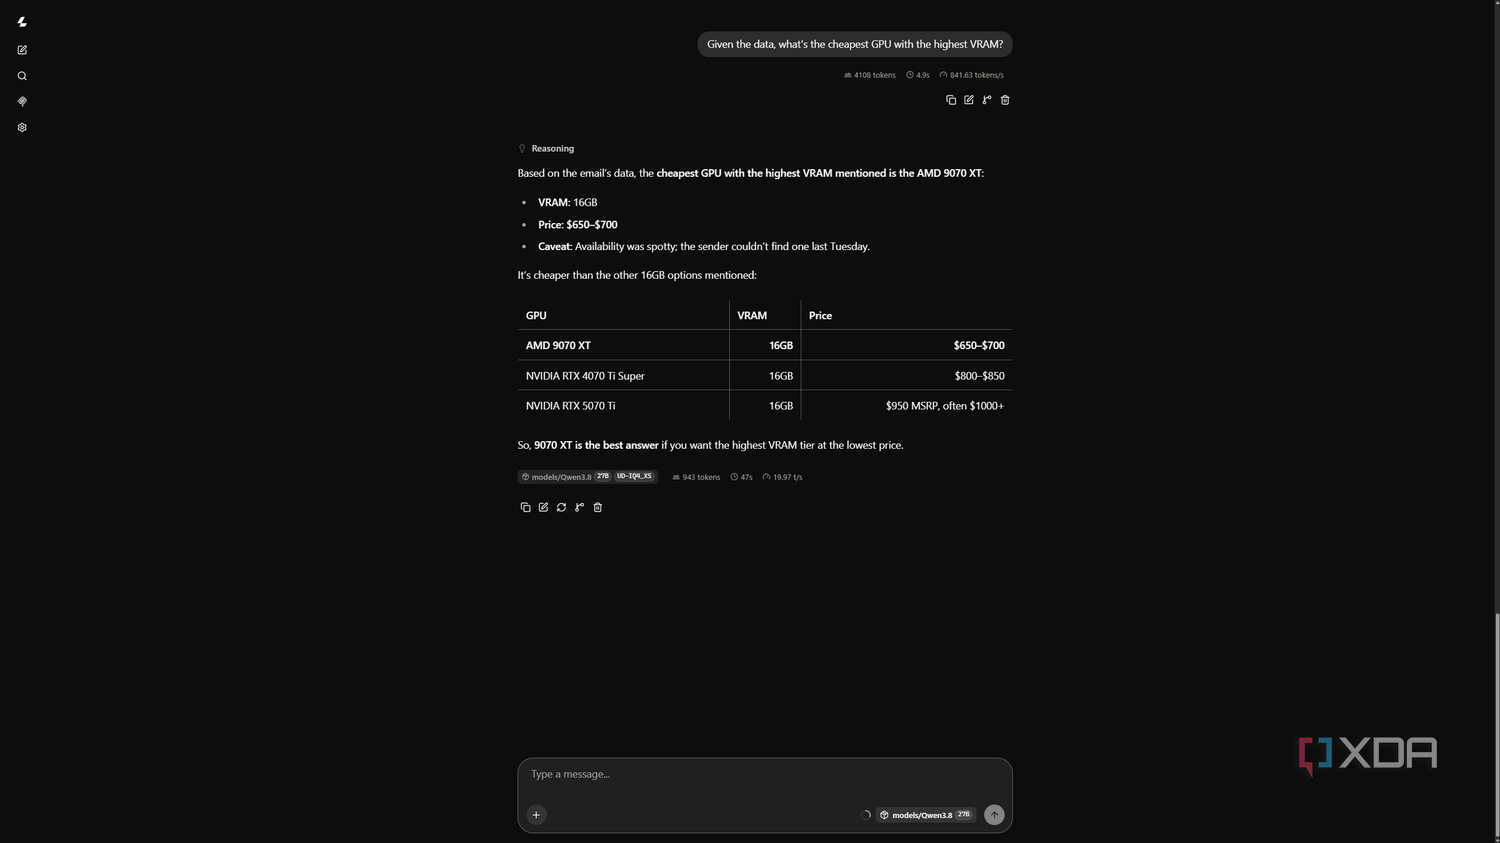
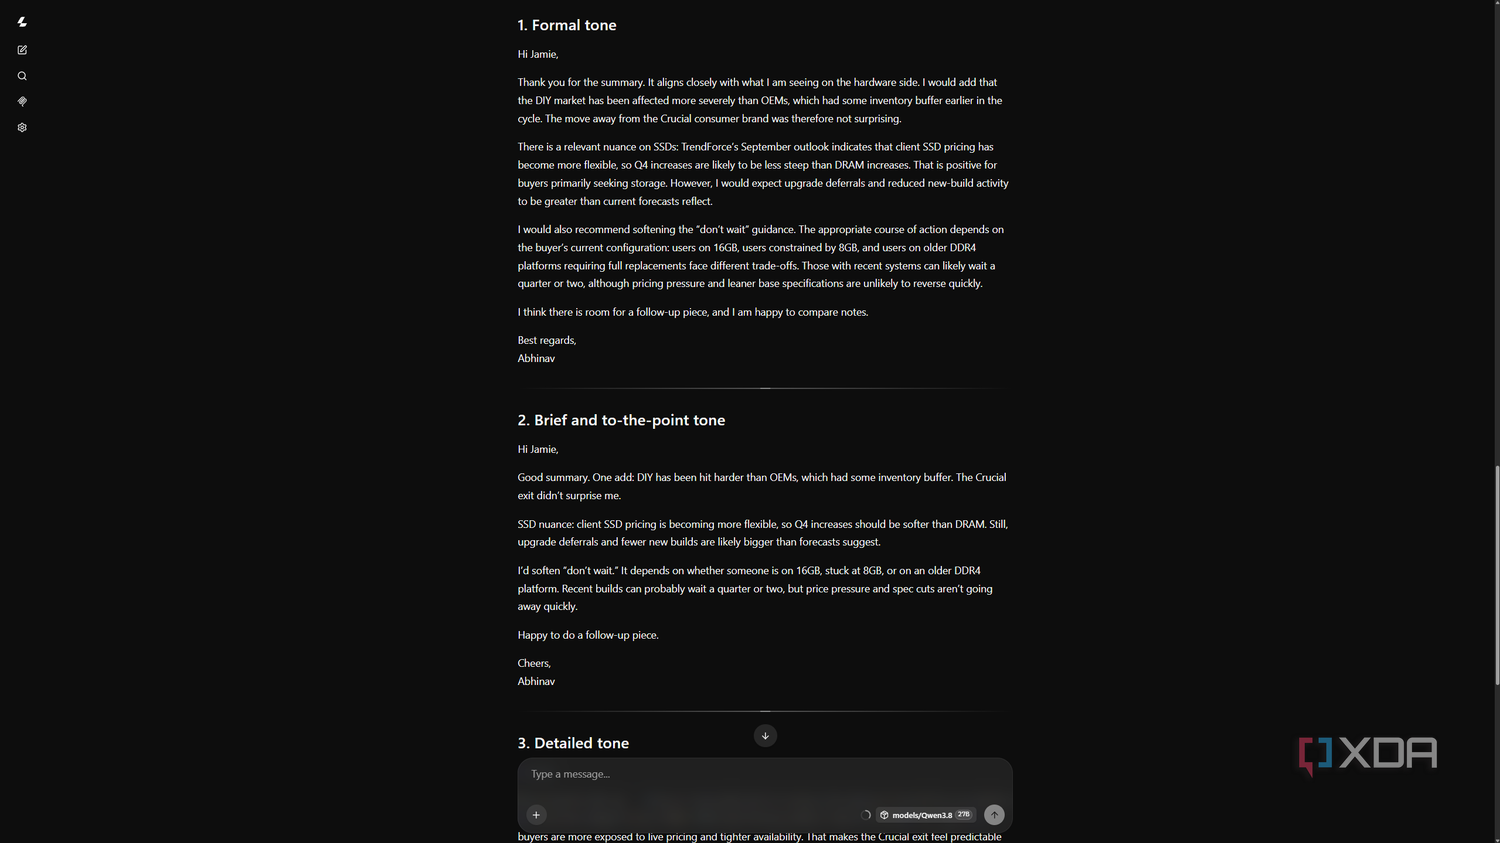
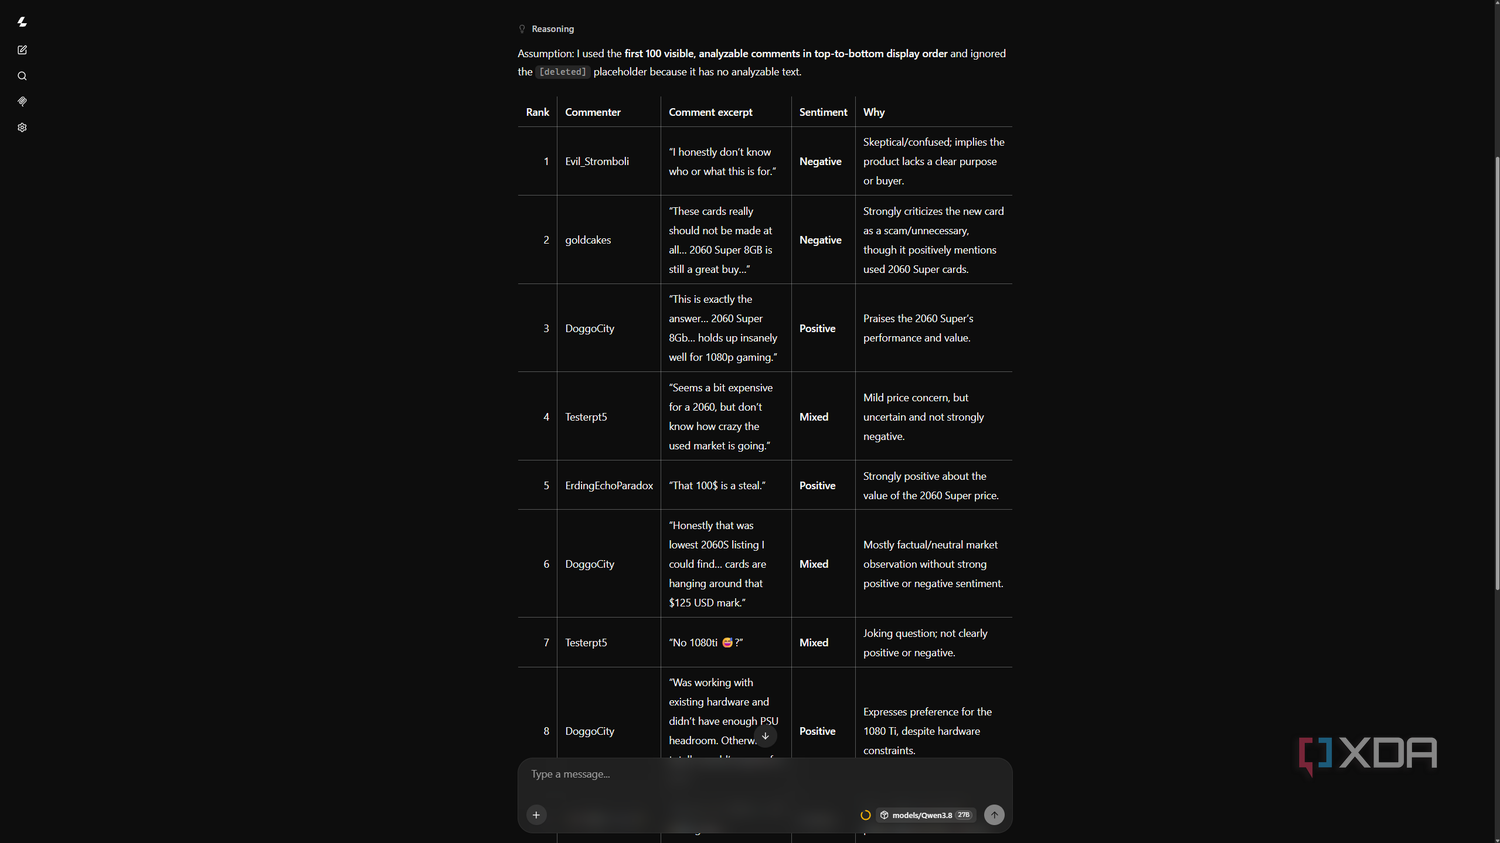
Облачные модели часто избыточны для выполнения простых операций, таких как проверка грамматики, редактирование электронных писем или анализ тональности сообщений на форумах. Локальные модели, включая семейства Qwen и Gemma, справляются с этими задачами без потери качества. В ходе проверки модель Qwen 3.8-27B продемонстрировала способность извлекать разрозненные числовые данные из хаотичного текста о ценах на компьютерные компоненты и структурировать их в аккуратную таблицу. Это доказывает, что для подобных аналитических задач нет необходимости в передаче данных на внешние серверы.
Преимущества локального запуска в программировании
Использование нейросетей для программирования часто сталкивается с ограничениями облачных сервисов. Хотя модели от Anthropic, например Claude, показывают высокую эффективность в написании кода, их использование сопряжено с жесткими лимитами и правилами безопасности. Ограничение в пять часов при выполнении итеративных задач нарушает рабочий ритм: после блокировки пользователю приходится либо ждать сброса лимита, либо совершать дополнительные платежи, что негативно сказывается на продуктивности. В отличие от них, локально запущенная модель Qwen не имеет ограничений по времени, еженедельных квот или счетов за превышение лимитов. Пользователь может оставлять систему работающей всю ночь, расходуя лишь электроэнергию (потребление GPU составляет около 285 Вт). Дополнительным преимуществом является полная конфиденциальность: исходный код и данные для бенчмарков не покидают пределы персонального компьютера, оставаясь вне зоны доступа сторонних организаций.
Доступность и гибкость локальных решений
Модели типа Qwen не всегда занимают первые строчки в глобальных рейтингах бенчмарков, однако их производительности достаточно для большинства пользовательских нужд. На платформе Hugging Face можно найти подходящие варианты практически для любой аппаратной конфигурации: от компактных моделей серии Gemma для ноутбуков с 16 ГБ оперативной памяти до различных версий Qwen, адаптированных даже для устаревшего «железа». Отсутствие платы за подписку делает такие инструменты экономически выгодными, требуя лишь наличия соответствующего оборудования для их запуска.
Экономия на подписках и реальные возможности
Долгое время существовало убеждение, что облачные модели обладают уникальными способностями, которые невозможно воспроизвести на домашнем ПК. Однако переход на Qwen 3.8-27B полностью опроверг эти ожидания. Использование локальной модели позволило не только сэкономить средства, которые раньше уходили на оплату двух подписок по 20 долларов, но и получить инструмент, сопоставимый по функциональности с платными решениями. Оказалось, что для большинства повседневных задач, вроде приведения в порядок длинных писем, стилистической правки слишком «тяжелых» предложений или переработки жаргонных мыслей в эффективные сообщения, мощностей облачных гигантов вовсе не требуется.
Опыт анализа данных и работы с текстом
Особую пользу локальная LLM приносит при работе с большими объемами неструктурированной информации. Автор часто сталкивается с необходимостью анализа потребительских мнений на форумах и в обсуждениях, чтобы оценить реакцию пользователей на новинки или изменение ценовой политики. Раньше для этих целей приходилось обращаться к облачным сервисам. Теперь же Qwen и семейство моделей Gemma выполняют аналогичную работу «не потея». Возможность локально обрабатывать такие данные исключает риск того, что сторонние компании получат доступ к анализируемой информации или смогут изменить политику хранения данных в одностороннем порядке.
Преодоление барьеров Claude
Несмотря на то что модели Anthropic часто показывают лучшие результаты в сложных задачах по программированию, они накладывают серьезные ограничения на пользователя. Пятичасовые лимиты крайне контрпродуктивны для программирования, которое требует итеративного подхода и постоянного общения с моделью. Ситуация, когда доступ к инструменту прерывается в разгар работы, заставляет либо ждать восстановления, что убивает «темп» написания кода и приводит к потере идей, либо доплачивать сверх подписки. Локальный запуск полностью решает эту проблему: отсутствие «пятичасовой стены», еженедельных квот или скрытых платежей позволяет делегировать модели даже ресурсоемкие задачи на всю ночь. Единственным «расходом» в таком случае становится потребление электроэнергии — для 4070 Ti Super оно составляет около 285 Вт.
Гибкость под любое «железо»
Важно понимать, что поиск идеальной модели — это вопрос подбора конфигурации под конкретное оборудование. Хотя Qwen 3.8-27B отлично показала себя на 16 ГБ VRAM, на платформе Hugging Face представлено огромное количество вариаций, адаптированных под разную память и вычислительную мощность. Будь то компактные модели для 16-гигабайтных ноутбуков или облегченные сборки Qwen для более старого оборудования — каждое из этих решений является бесплатным. Это создает среду, где эксперименты с локальным ИИ не требуют ничего, кроме наличия видеокарты и желания настроить систему под себя.