Сравнение NVIDIA RTX PRO 4500 Blackwell Server Edition и L4 в периферийном сервере
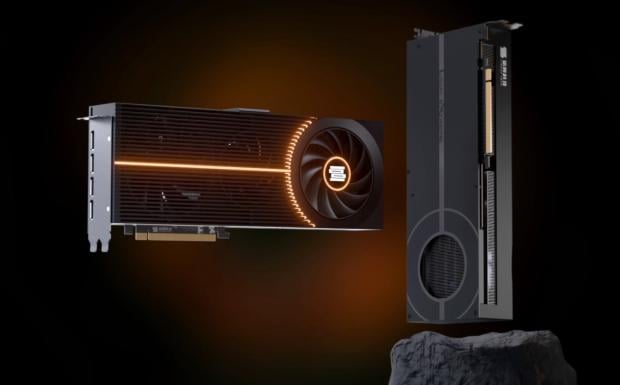
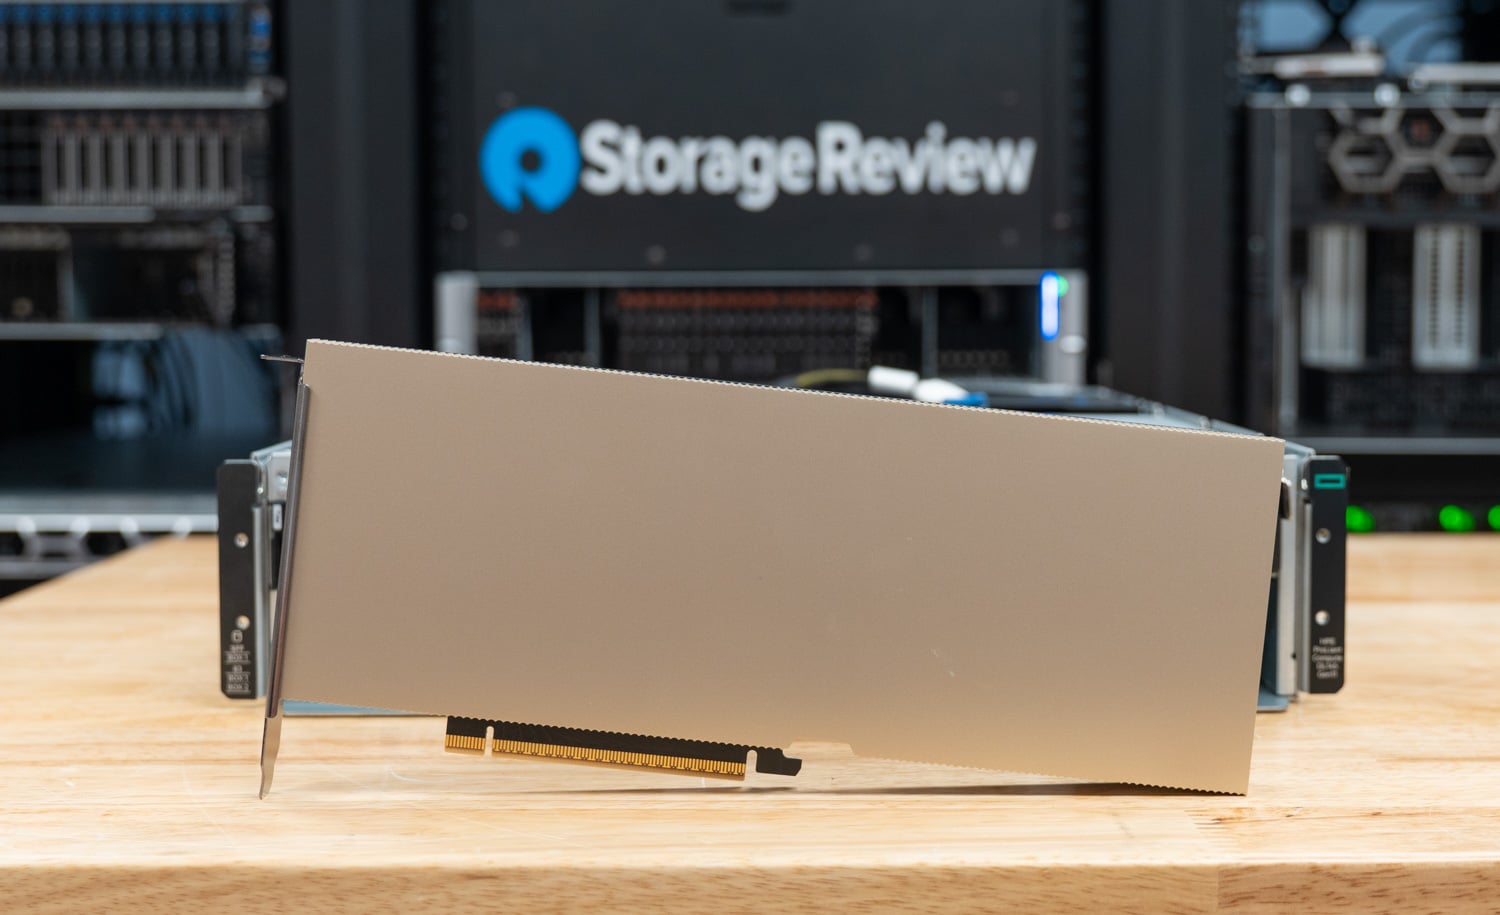
Видеокарта NVIDIA RTX PRO 4500 Blackwell Server Edition создана компанией NVIDIA главным образом для замены ускорителя L4 в серверах, размещенных за пределами традиционных дата-центров. Это однослотовое решение с поддержкой PCIe Gen5, пассивным охлаждением, энергопотреблением 165 Вт, 32 ГБ памяти GDDR7 и полным набором функций архитектуры Blackwell, включая тензорные ядра FP4 и технологию Multi-Instance GPU (MIG).
Компания HPE предоставила нам сервер ProLiant DL145 Gen11 — короткий периферийный сервер, с которым эта видеокарта поставляется в составе решения Nemotron edge. Мы провели одинаковое тестирование инференса vLLM на RTX PRO 4500 и на карте L4, установленной в том же самом шасси.
Данный обзор RTX PRO 4500 для периферийных систем посвящен именно этому прямому сравнению: что получает площадка, уже использующая L4 в периферийном сервере, при замене его на модель 4500 в пересчете на токены, задержку и энергопотребление.
На двух небольших моделях в формате BF16 при практическом уровне параллелизма RTX PRO 4500 обеспечивает пропускную способность в 2,7 раза выше, чем у L4. При этом она удерживает задержку выдачи первого токена на уровне ниже одной секунды при нагрузках, на которых L4 уже начинает простаивать в очереди, увеличивая при этом общее энергопотребление сервера DL145 примерно со 196 Вт до 301 Вт.
В пересчете на один ватт мощности графического процессора прирост производительности составляет от 1,3 до 1,4 раза.
В пересчете на одну карту разница заключается в возможности обслуживать от 32 до 64 одновременных чат-сессий против 256 сессий.
В пересчете на весь сервер: модель DL145 вмещает до трех карт L4, и три такие карты при нагрузке в 32 сессии каждая по пропускной способности приближаются к одной карте 4500. Таким образом, аргументы в пользу 4500 на уровне сервера сводятся к скорости для каждого отдельного пользователя, задержке, единому пулу памяти объемом 32 ГБ и поддержке формата FP4.
Этот материал представляет собой взгляд периферийного сервера на одну конкретную карту по сравнению с ее предшественницей, полученный на платформе Metrum AI® Bench Platform с использованием моделей, которые комфортно помещаются в 24 ГБ и 32 ГБ памяти.
Версия RTX PRO 4500 Server Edition также заслуживает более широкого сравнения с остальной линейкой инференс-решений NVIDIA, и соответствующие тесты у нас уже ведутся для отдельной публикации.
В рамках данного обзора карта L4 является наиболее релевантным объектом для сравнения, а один набор данных по RTX PRO 6000 Blackwell был добавлен исключительно для демонстрации возможностей формата NVFP4 на модели с 26 миллиардами параметров при наличии более мощной карты для сопоставления.
Видеокарта RTX PRO 6000 не поддерживается в периферийном сервере от HPE.
Ключевые выводы
- Производительность выше в 2,7 раза по сравнению с L4 в том же сервере: На основе 18 комбинаций входных и выходных данных для моделей Qwen3.5-4B и Gemma 4 E4B видеокарта RTX PRO 4500 показала медианную скорость генерации выходных токенов в секунду, превышающую показатели L4 в 2,7 раза при 8–32 одновременных запросах и в 3,0–3,2 раза при 256 запросах, когда обе карты были установлены в один и тот же сервер HPE ProLiant DL145 Gen11.
- Задержка — это больший разрыв: Карта 4500 генерирует текст со скоростью 12–15 мс на токен против 35–40 мс у L4. При 256 одновременных запросах ее медианное время до получения первого токена составляло от 264 до 650 мс для промптов длиной 256 токенов, в то время как у L4 этот показатель вырастал до 9 и 39 секунд.
- На 105 Вт больше от розетки при росте числа токенов в 2,7 раза: Сервер DL145 потреблял около 196 Вт при обслуживании запросов на L4 и около 301 Вт на карте 4500 при 32 параллельных сессиях. Выходные токены на один ватт системы выросли с 2,7 до 5,1 для Qwen3.5-4B и с 2,9 до 5,6 для Gemma 4 E4B.
- Скорость на одного пользователя сохраняется при 256 сессиях на промптах чат-формата: При делении общей пропускной способности на уровень параллелизма карта 4500 все еще обеспечивает каждому пользователю от 11 до 22 токенов в секунду при 256 одновременных сессиях с ответами длиной от 256 токенов и выше на короткие и средние промпты, тогда как производительность L4 падает до 3,7–8,7 токенов. L4 опускается ниже минимального порога в 10 токенов в секунду в диапазоне от 32 до 256 сессий для большинства конфигураций и в диапазоне от 8 до 16 сессий для конфигурации 1024/32 с преобладанием префилла; карта 4500 остается выше этого порога при 256 сессиях везде, кроме коротких ответов и конфигураций с промптами на 1024 токена.
- Объем 32 ГБ и формат FP4 открывают класс моделей, которые L4 не может запустить нативно: На модели Gemma 4 26B-A4B в формате NVFP4 с кэшем KV FP8 карта 4500 выдавала 1613 выходных токенов в секунду при 32 одновременных запросах и энергопотреблении 165 Вт. Это составляет примерно половину от показателей RTX PRO 6000 Blackwell в рабочей станции, которая потребляла от 266 до 471 Вт при 8–32 параллельных запросах. При 256 одновременных запросах разрыв увеличивается примерно до 2,5 раз.
Для каких задач предназначена RTX PRO 4500 Server Edition?
Компания NVIDIA анонсировала RTX PRO 4500 Blackwell Server Edition на конференции GTC 2026 в качестве начального уровня в своем семействе серверных продуктов RTX PRO и преемника ускорителя L4.
Новинка разделяет название с рабочей станцией RTX PRO 4500 Blackwell, они используют одинаковый кремний и одинаковое количество ядер CUDA (10 496), однако это совершенно разные продукты.
Серверная версия лишена видеовыходов и вентилятора, ее энергопотребление ограничено на отметке 165 Вт, при этом она дополнена функциями дата-центров: поддержкой технологии MIG с выделением до двух экземпляров по 16 ГБ, конфиденциальных вычислений (confidential computing), третьим блоком NVENC и NVDEC, а также поддержкой vGPU.
NVIDIA оценивает пропускную способность памяти этой карты в 800 ГБ/с, пиковую производительность тензорных ядер FP4 с разрежением (sparsity) на уровне 1,6 PFLOPS и описывает ускоритель как «энергоэффективный графический процессор архитектуры Blackwell для корпоративного искусственного интеллекта», нацеленный на «основные дата-центры и периферийные серверы». Мы освещали это в нашем репортаже с конференции HPE GTC 2026.
Компания NVIDIA также изменила форм-фактор: протестированная нами в 2024 году карта L4 представляет собой низкопрофильное решение половинной длины (half-height, half-length) мощностью 72 Вт с 24 ГБ памяти GDDR6 со скоростью 300 ГБ/с. В то время как RTX PRO 4500 Server Edition выполнена в полноразмерном форм-факторе для стандартных корпусов (full-height, full-length) как однослотовая плата мощностью 165 Вт. Таким образом, она по-прежнему занимает один слот расширения, но требует полноразмерного райзера и подключения 16-контактного кабеля питания.
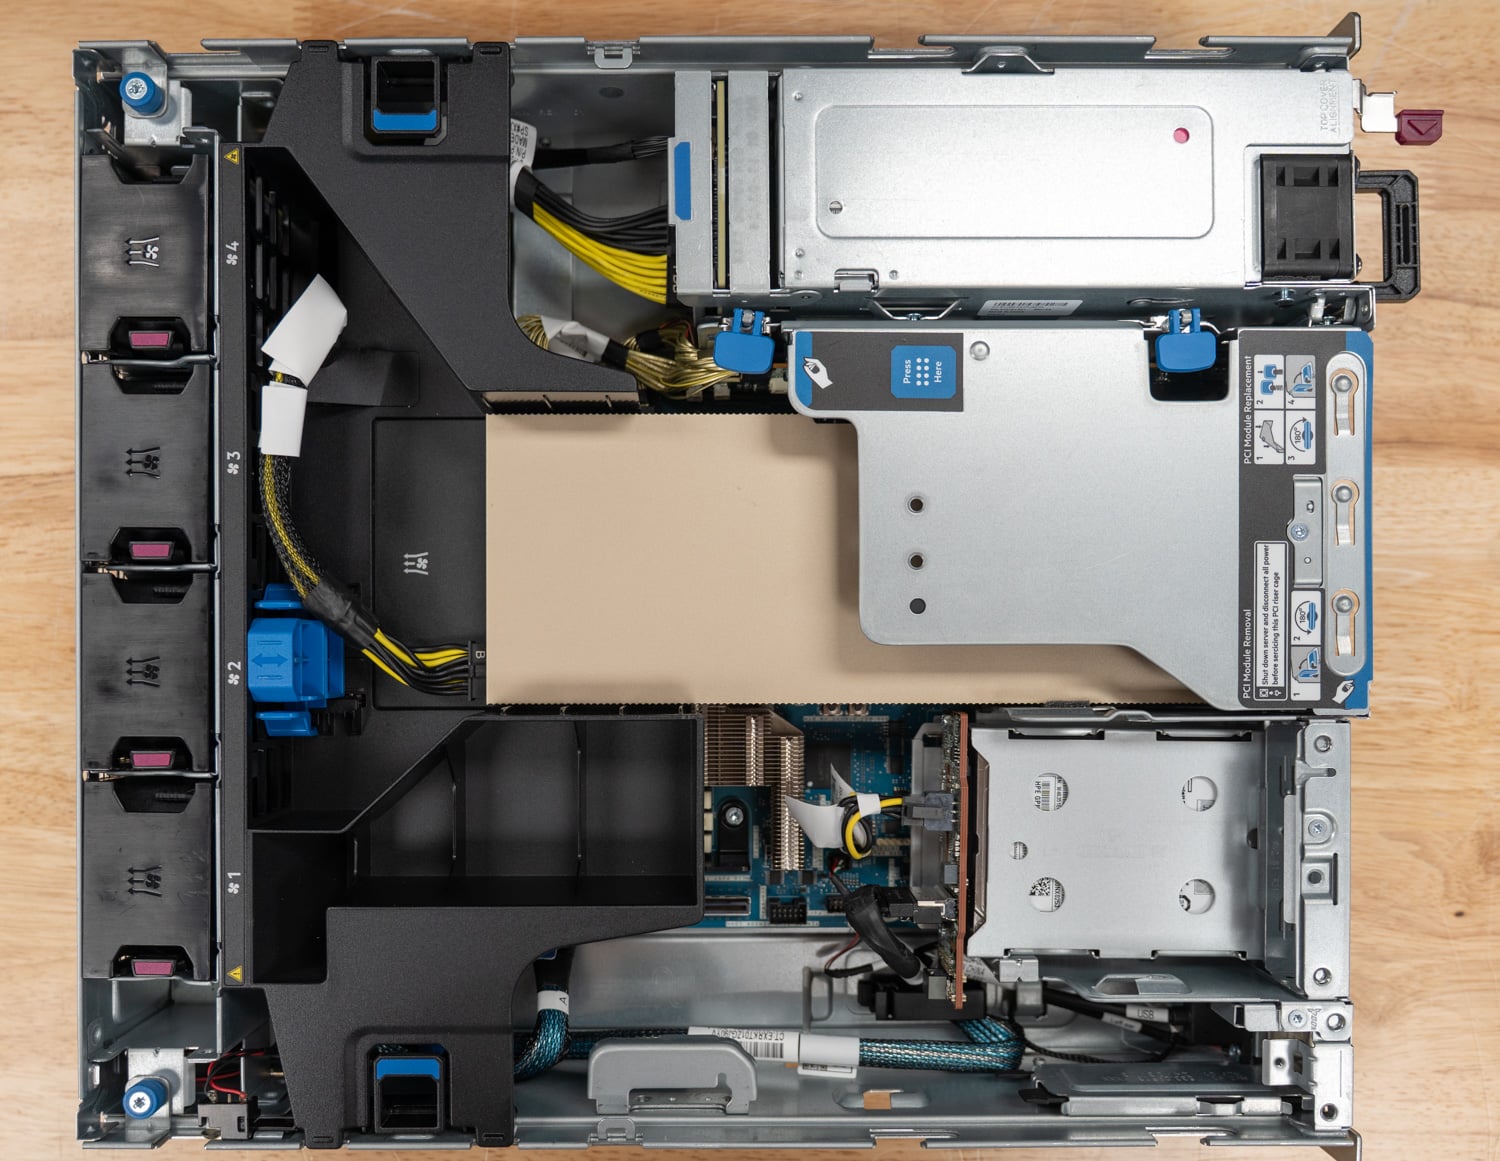
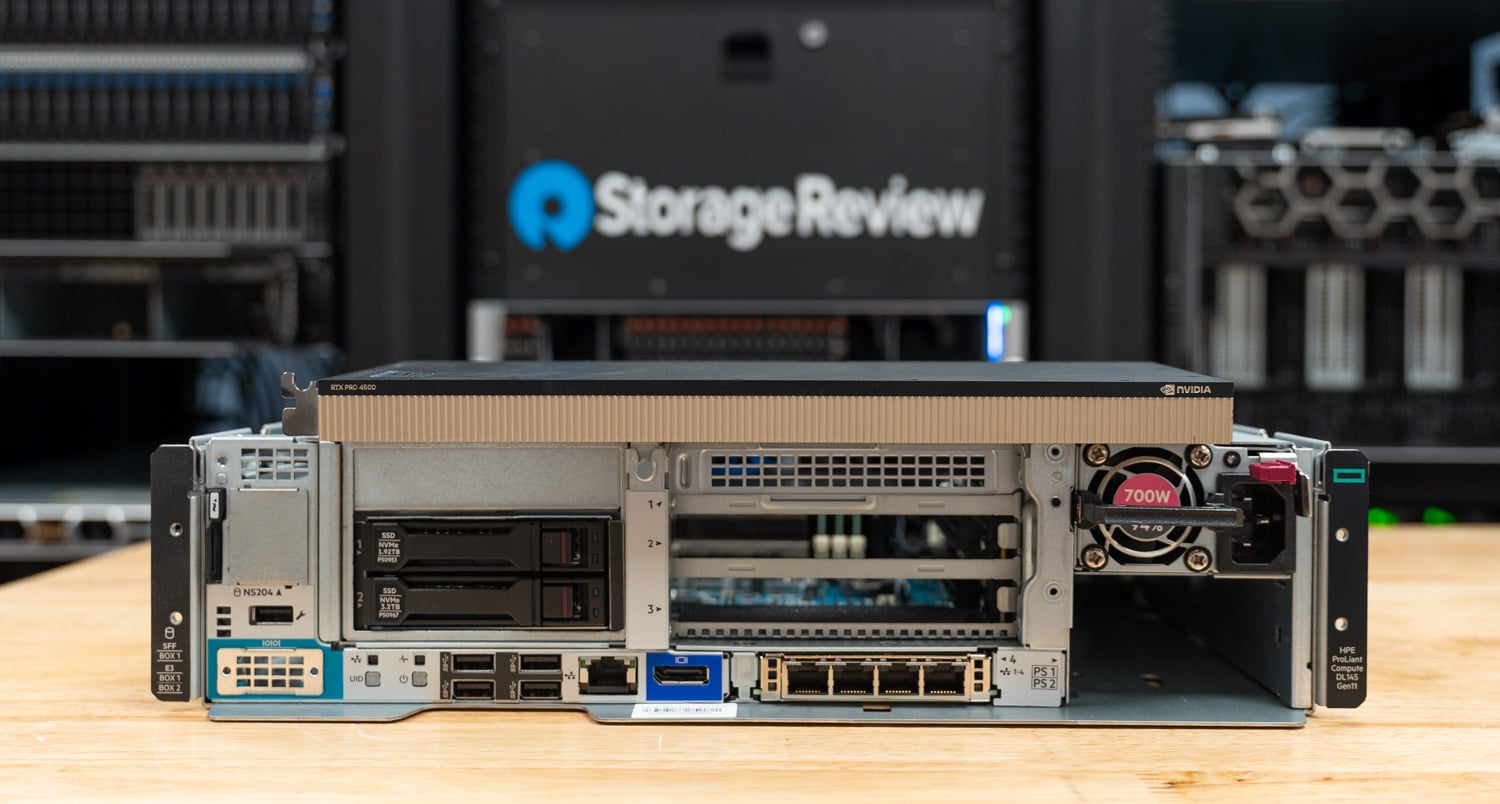
Стандартный слот сервера DL145 Gen11 рассчитан на платы полной высоты и половинной длины, поэтому компания HPE укомплектовала наше тестовое устройство полноразмерным райзером и кабелем питания.
Производительность на бумаге и особенности аппаратной платформы HPE ProLiant DL145 Gen11
На бумаге модель 4500 превосходит L4 по пропускной способности памяти в 2,7 раза, предлагает на 33% больше объема памяти, а также обеспечивает пиковый показатель FP8 Tensor в 1,7 раза выше при двукратном и трехкратном увеличении потребляемой мощности (2,3x), не говоря уже о наличии пути FP4, для которого у ускорителя L4 вообще нет аппаратной поддержки.
Компания HPE позиционирует сервер DL145 Gen11 как решение для объектов, где отсутствует специализированное серверное помещение. В информационном бюллетене по решению для DL145 и NVIDIA Nemotron описывается монтируемый на стену корпус с почти бесшумной работой, рассчитанный на температурный диапазон от -5 °C до 55 °C. Он предназначен для телекоммуникационных шкафов с минимальным воздушным потоком, запыленных локаций, а также для жарких или холодных помещений. Устройство оснащено средствами iLO и Compute Ops Management для развертывания сотен удаленных площадок, где есть только электропитание и подключение по Ethernet.
В качестве целевых отраслей HPE предлагает розничную торговлю, здравоохранение, финансовый сектор, производство и энергетику. В качестве рабочих нагрузок перечисляются те сценарии, которые измеряются в данном обзоре: малые языковые модели, RAG и векторный поиск, выполняемые локально, благодаря чему конфиденциальные и регулируемые данные никогда не покидают пределы объекта.
Платформа DL145 Gen11 уже рассматривалась редакцией на этапе ее запуска, поэтому повторный обзор аппаратной базы не проводится. Тестируемый образец, присланный компанией HPE, укомплектован одним процессором AMD EPYC 8534P (64-ядерный, 128-поточный чип архитектуры Siena), 96 ГБ оперативной памяти DDR5-4800 (шесть модулей DIMM по 16 ГБ) и видеокартой RTX PRO 4500 Blackwell Server Edition, установленной на полноразмерный райзер.
Шасси имеет дисковую объединительную панель с двумя отсеками U.3; поскольку присланный экземпляр был укомплектован кабелями только для SATA-накопителей, загрузка осуществлялась с твердотельного накопителя 6.4TB Solidigm D7-P5620 NVMe на карте расширения PCIe, что никак не влияет на результаты тестирования графического процессора. Сравнение с ускорителем L4 проводилось на абсолютно той же конфигурации сервера.
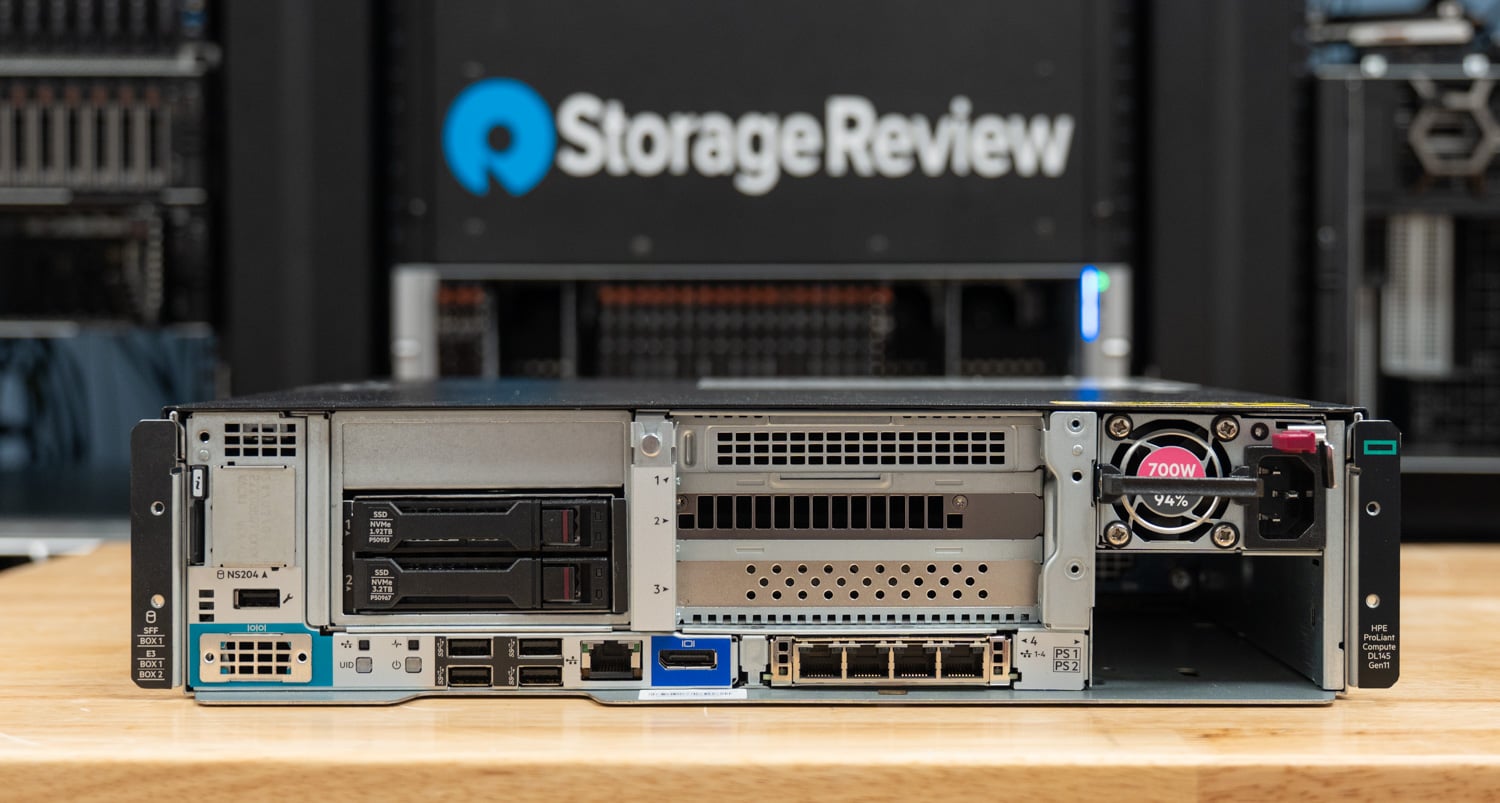
Ускоритель 4500 — это карта, которую HPE поставляет в данной платформе для своего периферийного решения Nemotron, в то время как L4 — это компонент, который сегодня с наибольшей вероятностью уже установлен в такой слот у владельцев серверов DL145 за последние два года.
Для дальнейшего анализа важны еще два аппаратных показателя: сервер DL145 передает данные об энергопотреблении всей системы через интерфейс iLO, а измерительная платформа Bench Platform фиксировала эти показатели параллельно с собственным энергопотреблением графического процессора во время каждого запуска. Это позволяет оценивать потребление энергии как на уровне всей системы («у розетки»), так и непосредственно на самой плате.
Штатный воздушный поток сервера позволил удерживать обе пассивные видеокарты в пределах допустимых температурных лимитов: во время самых продолжительных тестов средняя температура графического процессора 4500 достигала пика в 84 °C, а у карты L4 — 86 °C. Оба значения зафиксированы в условиях непрерывной работы при полной нагрузке на вывод в коротком шасси форм-фактора 2U.
Методология тестирования производительности
Все данные по инференсу в этом обзоре были собраны с помощью платформы Metrum AI Bench Platform (версия 3.9.2, в файлах запусков записана под своим прежним названием Metrum Insights) при управлении сервером инференса vLLM версии 0.24.0.
Платформа Bench Platform запускает фиксированную сетку сценариев для каждой системы, регистрирует пропускную способность, процентили задержки, телеметрию графического процессора и энергопотребление хоста для каждого сценария, после чего экспортирует результаты в виде единого набора данных для каждой задачи.
Редакция уже публиковала материалы о совместной работе Metrum AI и Университета штата Орегон, кроме того, компания Dell использовала эту же платформу для своего технического отчета по модели R770AP. Тем не менее, данное тестирование является первым случаем комплексного использования этого инструмента для сквозного сравнения графических процессоров собственными силами редакции.
Инженеры Metrum AI и лабораторная команда проводили задачи совместно: платформа Bench Platform отвечала за сбор данных, а команда издания настраивала аппаратное обеспечение, выбирала модели и формировала запросы.
Компания Metrum AI также публикует сопутствующий инструмент с открытым исходным кодом — Metrum AI Bench CLI, который читатели могут использовать для проведения аналогичных тестов на собственных системах.
Metrum AI является зарегистрированным товарным знаком, а Metrum AI Bench CLI и Metrum AI Bench Platform выступают в качестве товарных знаков компании Metrum AI, Inc. Использование инструментария Metrum AI Bench не означает его одобрения со стороны Metrum AI.
Тестовая сетка включает девять вариантов промптов: все возможные комбинации входных токенов длиной 32, 256 и 1024 с максимальным количеством выходных токенов 32, 256 и 1024. Каждая комбинация запускалась при 1, 8, 16, 32 и 256 одновременных запросах, что в сумме дает 45 сценариев для каждой модели на каждом графическом ускорителе.
Для карты L4 тест с моделью Gemma 4 также включал 64 и 128 одновременных запросов, что оказалось полезным для определения предела ее возможностей.
В рамках каждого сценария отправляется 15 запросов на поток для диапазона от 1 до 32 одновременных запросов, и 1280 запросов при значении 256 одновременных потоков.
Задача для модели Gemma 4 E4B на ускорителе 4500 запускалась трижды; вариативность результатов от сценария к сценарию между повторными прогонами составляла менее 2%, и в отчете приводится медианное значение.
Тесты моделей L4 и 4500 в формате BF16, а также две задачи для Gemma 4 26B (по одной на каждую карту) составляют в общей сложности 378 запущенных сценариев. За все время тестирования был зафиксирован лишь один неудачный запрос в одном повторе одного из сценариев для карты 4500, о чем упоминается исключительно в целях полной прозрачности отчетности.
В испытаниях задействованы три модели: Qwen3.5-4B и Gemma 4 E4B (обе запущены в формате BF16 с кэшем KV в формате BF16), которые выполнялись как на L4, так и на 4500. Это модели того масштаба, который периферийные развертывания на карте с 24 ГБ памяти сегодня обслуживают в реальных условиях.
Модель Gemma 4 26B-A4B, представляющая собой смесь экспертов (MoE) на 26 миллиардов параметров с примерно 4 миллиардами активных параметров, выполнялась в формате NVFP4 с кэшем KV в формате FP8 исключительно на ускорителе 4500. В качестве ориентира при этом использовалась рабочая станция RTX PRO 6000 Blackwell Workstation Edition (600 Вт) в корпусе Dell Pro Max Tower T2.
Ускоритель L4 не имеет нативной поддержки вычислений FP4 и не располагает достаточными ресурсами памяти для запуска этой модели в формате BF16, поэтому он не участвует в данной части тестирования.
При изучении графиков следует учитывать три примечания: построение графиков пропускной способности начинается с отметки в 8 одновременных запросов.
Производительность Qwen3.5-4B и сравнительный анализ карт
Сценарии с одним запросом настолько коротки (15 запросов, по нескольку секунд каждый), что первый запрос каждого сценария для одного пользователя с моделью Qwen на карте 4500, столкнувшийся с задержкой первого токена от 37 до 39 секунд, искажает показатель пропускной способности всего прогона. По этой причине для сценария с одним пользователем мы приводим задержку на токен и время отклика, которые не подвержены этому эффекту.
Мощность GPU представляет собой усредненное значение по выборке, поэтому показатели токенов на ватт рассчитываются только для тех прогонов, длительность которых достаточна для стабилизации среднего значения — на практике это от 16 одновременных запросов и выше.
При 256 одновременных запросах с длинными промптами обе карты исчерпывают кэш ключей-значений (KV cache), и vLLM ставит запросы в очередь. Эти точки все еще отражают реальные цифры пропускной способности, но показатели времени до первого токена при такой нагрузке описывают именно очередь, поэтому в качестве рабочего диапазона для задач, чувствительных к задержкам, мы рассматриваем 32 одновременных запроса.
Результаты модели Qwen3.5-4B
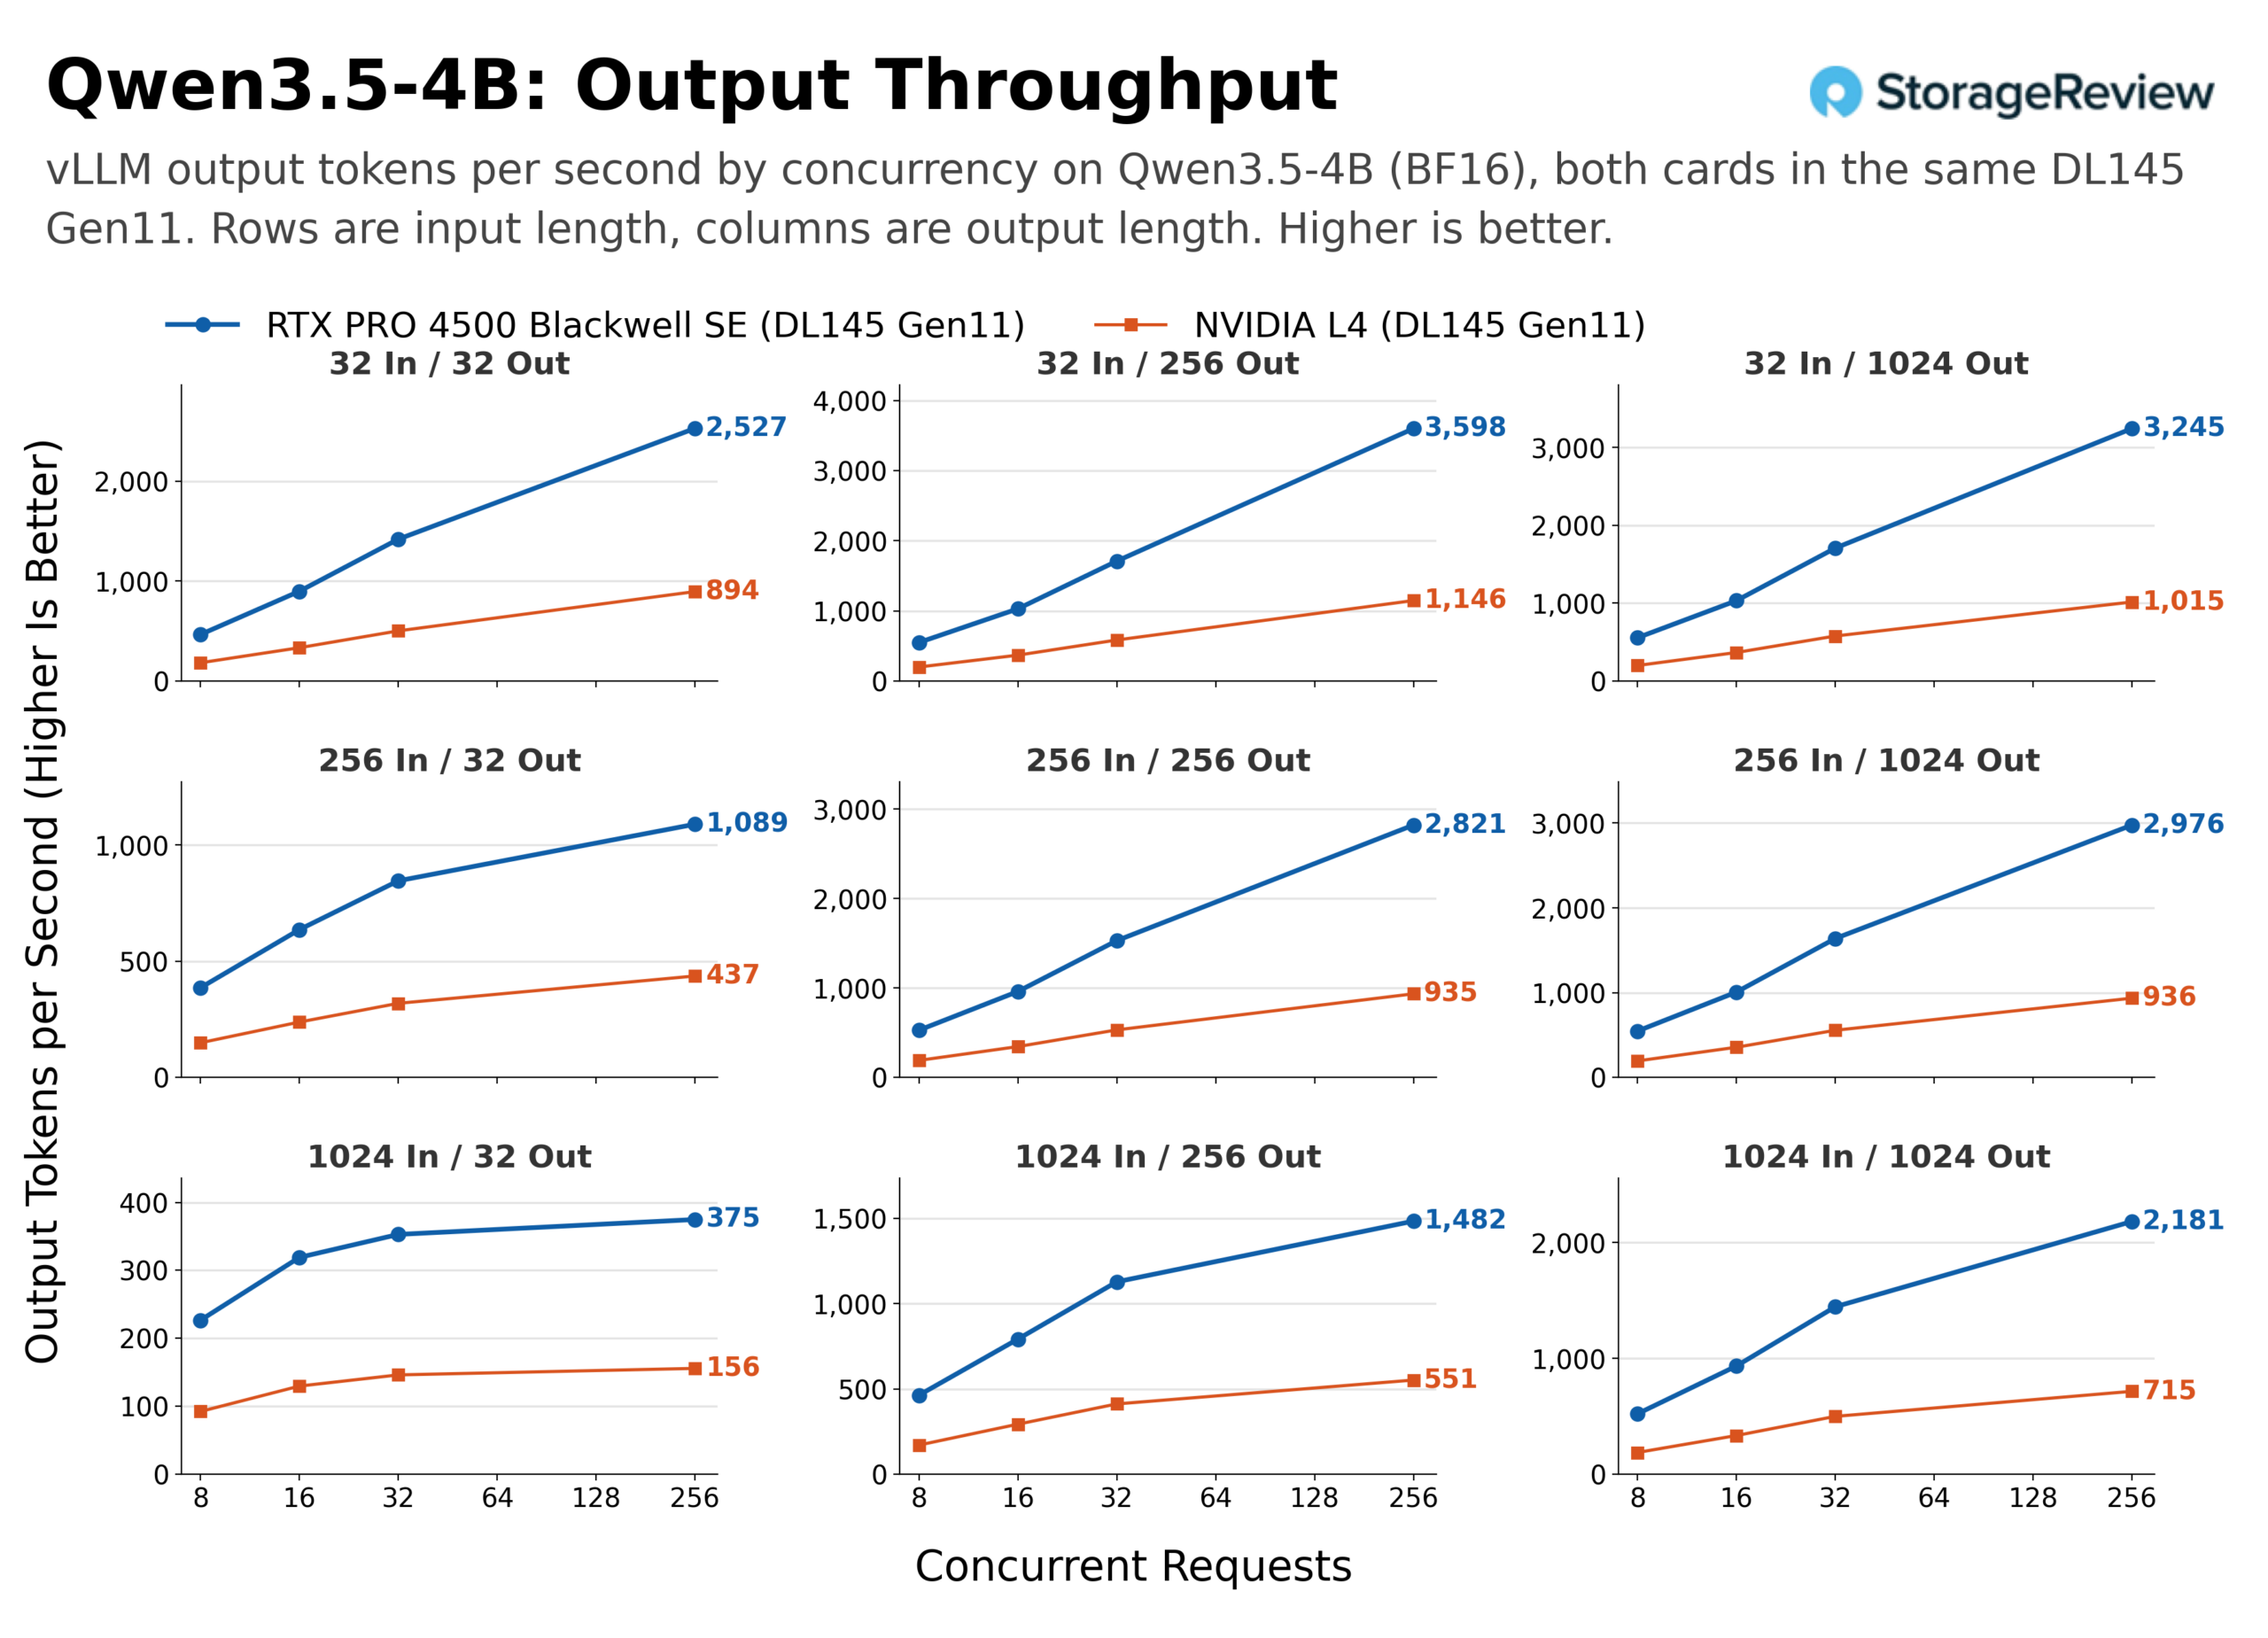
Ниже представлена общая сводка сравнения Qwen3.5-4B: количество выходных токенов в секунду на обеих картах для всех конфигураций промптов в диапазоне от 8 до 256 одновременных запросов.
Одинаковая форма кривой повторяется во всех девяти панелях: карта 4500 демонстрирует на старте примерно в 2,5–2,8 раза большую производительность по сравнению с L4 при 8 одновременных запросах, масштабируется немного быстрее при переходе к 32 запросам и останавливается на отметке от 2,4x до 3,2x при 256 запросах.
Если взять конфигурацию 256-in, 256-out в качестве эталона для чат-размера, то при 8 одновременных запросах карта L4 выдавала 192 выходных токена в секунду, а 4500 — 529 (в 2,76 раза больше); при 32 одновременных запросах показатели составили 532 против 1 529 (в 2,87 раза); при 256 одновременных запросах — 935 против 2 821 (в 3,02 раза).
Самая длинная конфигурация (по 1 024 токена в обе стороны) демонстрирует практически идентичную динамику: 499 против 1 445 при 32 одновременных запросах и 715 против 2 181 при 256 запросах.
Наименьший разрыв во всей матрице наблюдается в сценарии с преобладанием префилла (1 024-in, 32-out), где карта 4500 удерживает стабильное преимущество в 2,4 раза начиная с 8 одновременных запросов и далее. Это обусловлено тем, что данная рабочая нагрузка почти полностью сводится к обработке промпта, и обе карты упираются в вычислительные ограничения с самого начала.
Для конфигурации с таким форматом производительность модели Qwen3.5-4B неуклонно растет на обеих картах.
Единственное падение при 16 одновременных запросах в сетках BF16 зафиксировано для карты 4500 при запуске Gemma 4 E4B на конфигурации 1 024/32, что проявилось во всех трех повторных прогонах; точную причину этого явления мы пока не изолировали.
Метрики для одного пользователя и задержки
Для одного пользователя коэффициент пропускной способности не полностью отражает разницу, поскольку человек воспринимает то, насколько быстро появляются слова.
На конфигурации 256/256 карта 4500 генерировала данные с медианным значением 12,4 мс на токен, а L4 — 35,0 мс. Таким образом, ответ длиной 256 токенов занимал около 3,2 секунды на карте 4500 и 9,0 секунд на L4.
Для конфигурации по 1 024 токена в обе стороны эти показатели составили 13,1 секунды против 36,6 секунды.
Задержка первого токена для этого одиночного пользователя составляла 43 мс на карте 4500 и 81 мс на L4 для более короткого промпта, а для более длинного — 99 мс против 219 мс.
В условиях нагрузки разрыв в задержках увеличивается: при 32 одновременных запросах на конфигурации 256/256 медианное время до первого токена для L4 составляло 884 мс, а для 4500 — 386 мс.
При 256 одновременных запросах задержка L4 возрастала до 39 секунд, в то время как 4500 удерживала показатель на уровне 650 мс.
На конфигурации 1 024/1 024 карта L4 уже превышала отметку в одну секунду при 32 одновременных запросах (1 022 мс), а при 256 запросах достигала 255 секунд. Последнее означает, что запрос простаивал в очереди vLLM в течение четырех минут в ожидании освобождения кэша KV.
Карта 4500 пересекла секундный рубеж на этой же конфигурации только при 256 одновременных запросах, показав результат в 12,9 секунды.
На приведенном ниже графике линии карты L4 выходят за пределы области построения в диапазоне от 32 до 256 запросов, тогда как линии 4500 для более короткой конфигурации стабильно удерживаются ниже одной секунды на всем протяжении.
Производительность в расчете на пользователя и энергоэффективность
Альтернативный способ интерпретации тех же данных — расчет на одного пользователя: количество выходных токенов в секунду, разделенное на число одновременных запросов. Это скорость, которую видит каждый отдельный человек в очереди. На графике ниже она сопоставлена для каждой конфигурации с базовым порогом в 10 токенов в секунду, служащим общим ориентиром для интерактивного использования.
При 32 одновременных запросах карта 4500 обеспечивает от 44 до 53 токенов в секунду на пользователя для всех конфигураций, кроме 1 024-in, 32-out, где этот показатель равен 11. В то же время карта L4 находится в диапазоне от 10 до 18 токенов и уже просела до 4,6 на этой же конфигурации.
При 256 одновременных запросах карта 4500 остается выше порогового значения на четырех чат-конфигурациях (14,1 для 32/256, 12,7 для 32/1,024, 11,0 для 256/256 и 11,6 для 256/1,024), достигает его на значении 9,9 для 32/32 и падает ниже порога на промптах размером 1 024 токена и конфигурациях с коротким ответом — вплоть до 1,5 для 1 024/32, где почти вся работа приходится на префилл.
Карта L4 при 256 запросах опускается ниже порогового уровня на абсолютно всех конфигурациях, находясь в диапазоне от 0,6 до 4,5.
Тестирование в промежутке между 32 и 256 запросами не проводилось, поэтому точка пересечения каждой линии с пунктирным порогом лежит где-то между этими двумя уровнями параллельности. График показывает, что пересечение у L4 происходит задолго до 256 запросов на любой конфигурации, а у 4500 — на отметке 256 или близко к ней для чат-конфигураций.
Обе карты работали на пределе своих лимитов энергопотребления платы или близко к нему (72 Вт для L4 и 165 Вт для 4500) на большинстве конфигураций при числе одновременных запросов от 16 и выше.
Конфигурации с коротким выводом потребляли меньше энергии — например, 125 Вт на карте 4500 для Qwen3.5-4B 32/32 при 32 одновременных запросах, поэтому показатель токенов на ватт GPU тесно коррелирует с пропускной способностью.
При 256 одновременных запросах карта 4500 продемонстрировала медианное значение в 1,33x от показателей L4 по числу выходных токенов на ватт во всех девяти конфигурациях: от 1,07x в сценарии 1 024/32, ограниченном префиллом, до 1,39x для конфигурации 256/1,024.
Производительность модели Gemma 4 E4B и энергоэффективность системы
Если умножить этот показатель на разницу в мощности в 2,3 раза, получается 3-кратное превосходство по пропускной способности. При этом 1,33x обеспечивается за счет того, что архитектура Blackwell выполняет больше работы на один ватт, а 2,3x достигается благодаря тому, что модель 4500 потребляет больше ватт.
Анализ работы Gemma 4 E4B
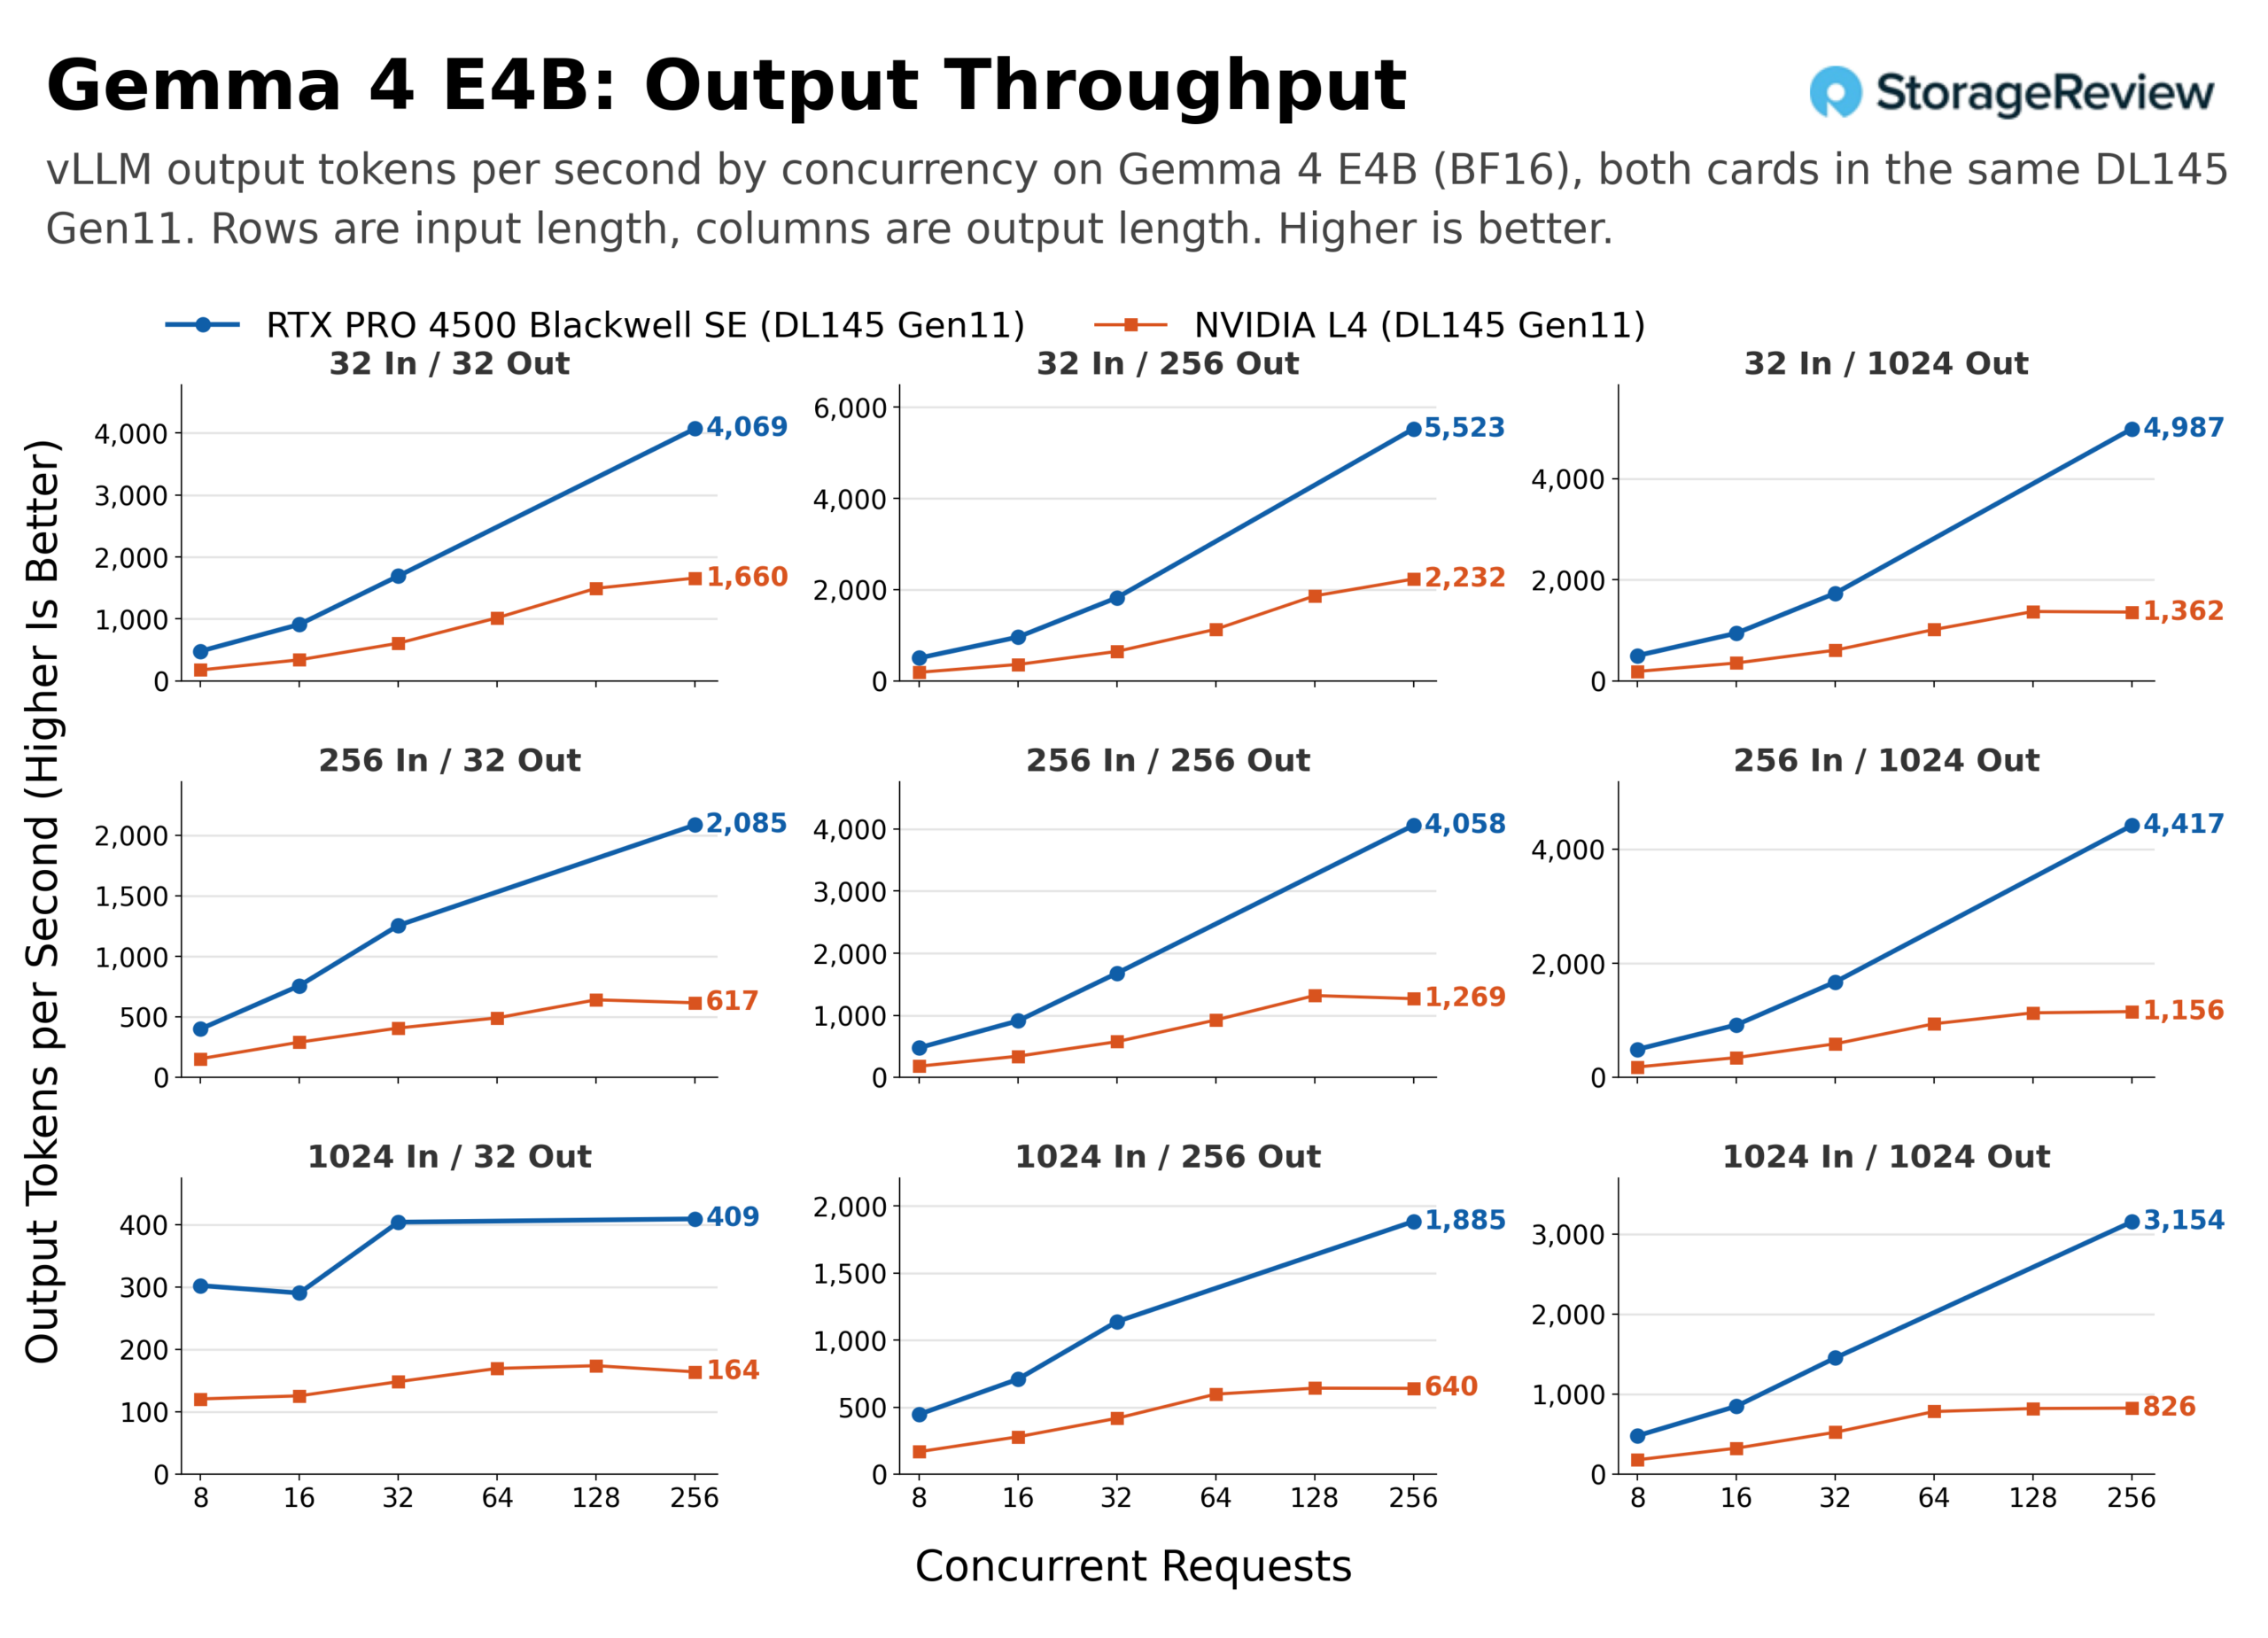
Gemma 4 E4B представляет собой младшую модель в семействе Google Gemma 4, где буква E означает эффективные 4 млрд параметров (effective 4B parameters). Она ведет себя аналогично Qwen3.5-4B на обеих картах, демонстрируя чуть лучшее масштабирование в верхней части сетки.
Медианное соотношение пропускной способности при числе одновременных запросов от 8 до 32 составляет 2,67x (в диапазоне от 2,31x до 3,07x), а при 256 запросах оно достигает 3,20x. На конфигурации 1024/1024 этот показатель доходит до 382x, поскольку карта L4 оказывается исчерпавшей свой лимит кэша KV.
На конфигурации 256/256 карта L4 выдавала 183 токена вывода в секунду при 8 одновременных запросах, 577 при 32 и 1269 при 256; в то время как 4500 выдавала 479, 1678 и 4058 токенов соответственно.
На конфигурации 1024/1024 показатели L4 составляли 180, 524 и 826, а у 4500 — 480, 1454 и 3154 токена в секунду.
Показатель 4500 для 256 одновременных запросов на длинной конфигурации в 3,8 раза превышает результат L4. Причину можно увидеть на графике L4: она добавила всего 302 токена в секунду при переходе от 32 к 256 одновременным запросам, так как у нее не осталось свободной памяти для добавления новых сеансов.
Поскольку тестирование L4 для задачи Gemma 4 включало также 64 и 128 одновременных запросов, эта модель точно показывает, где именно L4 исчерпывает свои возможности.
Медианное время до первого токена (time to first token) для L4 на конфигурации 256/256 составляло 184 мс при 32 одновременных запросах, чуть более секунды при 64 и 9,1 секунды при 256.
На конфигурации 1024/1024 оно составляло 339 мс при 32, более секунды при 64, 60 секунд при 128 и 191 секунду при 256.
Карта 4500 удерживала показатель на уровне 64 мс при 32 одновременных запросах и 264 мс при 256 на более короткой конфигурации. На длинной конфигурации задержка составляла 142 мс при 32 и превысила одну секунду только при 256 запросах, достигнув 1036 мс.
Таким образом, для модели Gemma 4 E4B при длине промптов чат-формата карта L4 в данном сервере является решением на 32–64 сеанса, тогда как 4500 справляется с 256 сеансами, имея запас по задержке.
Метрики в расчете на пользователя
Пользовательский срез с заполненными точками для 64 и 128 запросов на L4 показывает, где именно система пересекает минимальный порог.
На конфигурации 256/256 карта L4 обеспечивает 18,0 токена в секунду на пользователя при 32 одновременных запросах, 14,5 при 64, 10,3 при 128 и 5,0 при 256. Таким образом, она пересекает порог в 10 токенов в секунду в диапазоне между 128 и 256 запросами для этой конфигурации.
На конфигурации 256/1024 этот показатель падает до 8,9 к 128 запросам, а на конфигурациях с короткими ответами и длинными входами опускается ниже порога уже при 64 запросах (7,7 для 256/32 и 9,3 для 1024/256).
Модель 4500 удерживает от 52 до 57 токенов на пользователя в чат-конфигурациях при 32 одновременных запросах и остается выше минимального порога при 256 запросах на шести из девяти конфигураций (от 15,9 до 21,6 на конфигурациях с входами 32 и 256, кроме 256/32, а также 12,3 на 1024/1024). Она опускается ниже порога только на трех конфигурациях с короткими ответами и длинными промптами (8,1 для 256/32, 7,4 для 1024/256 и 1,6 для 1024/32).
Энергоэффективность и задержки
В пересчете на ватт мощности графического процессора Gemma 4 E4B обеспечивает для 4500 медианное преимущество в 1,39x по сравнению с L4 при 256 одновременных запросах. Наибольший отрыв (1,68x) наблюдается на конфигурации 256/1024, а показатель 1,6x или выше — на других конфигурациях с длинными ответами, где L4 испытывает нехватку KV-кэша. Наименьшая разница (1,07x) зафиксирована на 32/32, где рабочая нагрузка слишком мала, чтобы какая-либо карта могла проявить себя в полной мере.
На конфигурации 256/256 эффективность составляет 24,6 токена вывода в секунду на ватт против 17,7 у конкурента.
Задержка на один токен для одного пользователя совпадает с результатами Qwen: 14,1 мс на токен для 4500 против 39,1 мс для L4 на конфигурации 256/256, и 14,6 мс против 39,8 мс на конфигурации 1024/1024. Соответственно, ответ длиной в 1024 токена занимает около 15 секунд на 4500 и 41 секунду на L4.
Энергопотребление на уровне стойки (At the Wall)
Периферийные площадки (Edge sites) часто имеют жесткие ограничения по энергопотреблению, поэтому исследователи отслеживали суммарное энергопотребление сервера через интерфейс iLO сервера DL145 во время каждого запуска.
При легкой нагрузке в однопользовательских тестах, когда GPU потреблял от 43 до 65 Вт, энергопотребление сервера составляло около 160 Вт независимо от установленной карты.
При обслуживании 32 одновременных запросов на конфигурации 256/256 медианное энергопотребление составляло 196 Вт с картой L4 и 301 Вт с RTX PRO 4500. Эти медианные значения сохранялись для обеих моделей BF16; максимальное зафиксированное потребление составило 209 Вт с L4 и 308 Вт с 4500.
Таким образом, апгрейд увеличивает нагрузку на розетку примерно на 105 Вт, что близко к разнице в 93 Вт между паспортными показателями энергопотребления самих карт с учетом небольших потерь на преобразование и дополнительной нагрузки на вентиляторы.
При 32 одновременных запросах на конфигурации 256/256 сервер выдавал 2,7 токена вывода в секунду на системный ватт на модели Qwen3.5-4B с картой L4 и 5,1 с картой 4500; для модели Gemma 4 E4B показатели составили 2,9 и 5,6 соответственно.
Прирост эффективности на уровне системы выше, чем на уровне самой карты, поскольку значительная часть энергопотребления DL145 является фиксированной: центральный процессор, память, вентиляторы и накопители потребляют примерно одинаково независимо от того, выдает ли GPU 532 токена в секунду или 1529.
Площадка, которая уже оплатила содержание самого сервера, получает за счет замены 1,9x токенов на ватт по измерению из розетки против 1,3x на уровне видеокарты.
Для парка оборудования, рассчитываемого исходя из жесткого лимита мощности на одну площадку, именно этот показатель является ключевым для планирования.
Что дают 32 ГБ памяти и формат NVFP4
Все описанные выше задачи карта L4 способна выполнять, хотя и медленнее.
Вторым аргументом в пользу карты 4500 является класс моделей, который L4 вообще не может обслуживать нативно: это Gemma 4 26B-A4B в формате NVFP4. Данная модель представляет собой смесь экспертов (mixture-of-experts) с 26 млрд параметров, из которых около 4 млрд активны на один токен, и обслуживается с использованием KV-кэша в формате FP8.
Производительность модели 26B MoE и общие итоги тестирования
В формате BF16 веса этой модели превышают 24 ГБ, тогда как в NVFP4 они помещаются в 32 ГБ памяти карты 4500, оставляя место для рабочего кэша KV, а тензорные ядра Blackwell FP4 выполняют этот формат нативно. vLLM может загружать веса NVFP4 на архитектуру Ada карты L4 через ядро, работающее только с весами, и 4-битные веса объемом около 14 ГБ поместились бы в 24 ГБ, но у L4 нет нативных вычислений FP4, поэтому там этот тест не запускался.
Для масштабирования сравнения ту же задачу запустили на RTX PRO 6000 Blackwell Workstation Edition — карте с 96 ГБ памяти и энергопотреблением 600 Вт, установленной в системном блоке Dell Pro Max Tower T2. Это другой хост и другой класс видеокарты, и она приведена исключительно как ориентир для сопоставления с результатами модели 4500.
Сравнение производительности с RTX PRO 6000
В конфигурации 256/256 карта 4500 выдавала 647 выходных токенов в секунду при 8 одновременных сессиях, 1613 при 32 сессиях и 4607 при 256 сессиях; в то время как RTX PRO 6000 показала 1198, 3252 и 11 682 токена в секунду соответственно.
В диапазоне от 8 до 32 одновременных сессий производительность 4500 составляет от 48% до 55% от показателей модели 6000 для всех сценариев, за исключением случая 1024/32, ограниченного этапом префилла, где при 32 сессиях этот показатель падает до 29%. При этом энергопотребление 4500 составляет 165 Вт против 266–471 Вт, измеренных на карте 6000 для протестированных сценариев.
При 256 одновременных сессиях показатель падает до 23–42%, поскольку ее 32 ГБ памяти заполняются.
Задержка первого токена демонстрирует ту же картину, что и модели в формате BF16: при 32 одновременных сессиях медианное значение для 4500 составляло 67 мс для сценария 256/256 и 103 мс для 1024/1024 (что отличается от 6000 всего на несколько десятков миллисекунд), а при 256 сессиях для короткой формы оно оставалось на уровне 204 мс.
В сценарии 1024/1024 при 256 одновременных сессиях карта 4500 формировала очередь с задержкой до 62 секунд, в то время как карта 6000, обладающая втрое большим объемом памяти, удерживала этот показатель на уровне 560 мс.
Для модели класса 26B MoE карта 4500 подходит как решение на 32 сеанса при большой длине контекста и на 256 сеансов при длине диалогового окна, запуская модель на оборудовании FP4, которого у L4 нет.
Сервер DL145 потреблял максимум 306 Вт при обслуживании модели 26B на карте 4500 против пикового значения в 308 Вт на моделях 4B, поскольку энергопотребление самой видеокарты в обоих случаях составляет 165 Вт.
Появление модели класса 26B в периферийном устройстве с энергопотреблением 300 Вт от сети представляет собой качественный скачок возможностей, который не требует большего энергопотребления, чем младшие модели.
Заключение
Компания NVIDIA оценивает RTX PRO 4500 Blackwell Server Edition как решение, превосходящее L4 более чем в 5 раз, опираясь при этом на форматы FP4 и технологию NIM.
В прямом сравнении BF16 на том же сервере DL145 Gen11 карта 4500 обеспечила медианную производительность генерации в 2,7 раза выше, чем у L4, на двух малых моделях при рабочей нагрузке, и в 3,0–3,2 раза при насыщении; генерировала токены в 2,8 раза быстрее для одиночного пользователя и удерживала задержку первого токена ниже одной секунды при нагрузках, на которых у L4 возникали очереди длиной в десятки секунд.
Карта L4 удерживает показатель каждого пользователя выше 10 выходных токенов в секунду в диапазоне от 32 до 256 сессий для большинства сценариев и только до 8 сессий для сценария 1024/32 с тяжелым префиллом, тогда как 4500 справляется с этим на уровне 256 сессий для промптов длиной как в чате.
Кроме того, 4500 успешно обслуживала модель Gemma 4 26B-A4B в формате NVFP4, которую L4 не способна запускать нативно.
Цена вопроса — дополнительные 105 Вт из розетки (рост примерно с 196 Вт до 301 Вт для всего сервера под нагрузкой) и увеличение энергопотребления самой платы в 2,3 раза.
В пересчете на графический процессор 4500 оказывается в 1,3–1,4 раза эффективнее L4 в расчете на один выходной токен; при измерении на уровне розетки, где энергопотребление остальной части системы расходуется независимо от нагрузки, показатель эффективности составляет около 1,9 раза.
Дата-центры и площадки с фиксированным лимитом энергопотребления на один сервер найдут карту 4500 более рациональным способом использования уже затрачиваемых ватт, а площадки с ограничениями по слотам расширения смогут заменить одну карту 4500 производительностью трех карт L4 (по 32 сессии на каждую), получив генерацию на 28% быстрее для каждого пользователя и единый пул объемом 32 ГБ.
Оговорка об ограничении масштаба из начала обзора остается в силе, так как в данном случае тестировалась одна карта против ее предшественницы в одном периферийном сервере на трех малых моделях, а позиционирование RTX PRO 4500 Server Edition среди L40S, RTX PRO 6000 Server Edition и остального актуального модельного ряда для инференса — это отдельный вопрос, который прорабатывается в рамках более масштабного материала.
Для владельца сервера DL145 с установленной картой L4 ответ заключается в том, что 4500 представляет собой именно то обновление, под которое создана эта платформа — при условии, что корпус оснащен полноразмерным райзером и 16-контактным кабелем питания, а выбор компании HPE связать эту карту с данным сервером для задач Nemotron на периферии полностью соответствует возможностям «железа».
Сам сервер DL145 Gen11 представлен в категории периферийных систем в рейтинге лучших серверов (Best Servers), где данный результат теперь служит основой для раздела периферийного инференса.