

Тег: Llama
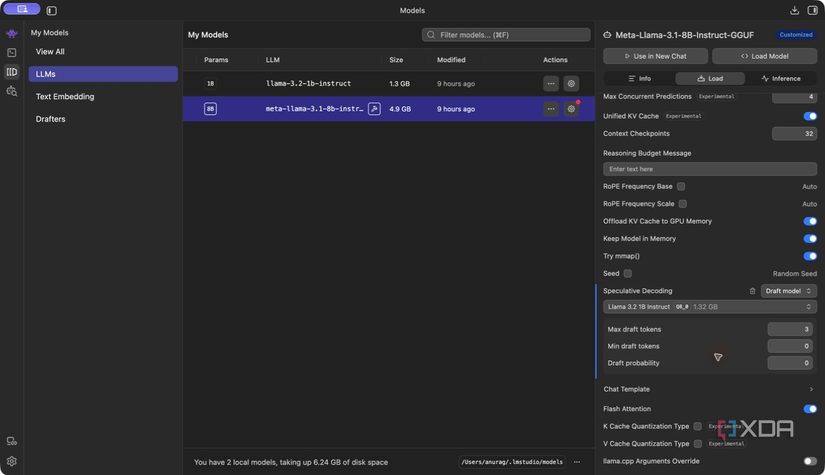
Ускорение локальных LLM с помощью метода speculative decoding
Метод speculative decoding позволяет значительно увеличить скорость генерации локальных языковых моделей, используя связку из основной модели и более компактной модели-помощника.
