Запуск локальных языковых моделей (LLM) на обычном ПК или ноутбуке часто сопровождается низкой скоростью работы. Основным ограничивающим фактором становится аппаратное обеспечение, которое не позволяет эффективно использовать мощные нейросети. Ранее для оптимизации работы приходилось прибегать к гибридным схемам, сочетающим облачные решения с локальными, однако технология speculative decoding позволяет полностью отказаться от облачных API, заметно повысив производительность вычислений.
Принцип работы метода ускоренной генерации
Суть speculative decoding заключается в совместном использовании двух моделей: основной и вспомогательной, называемой «черновой» (draft model). Традиционная авторегрессионная генерация обрабатывает каждый токен поочередно, что создает значительные задержки. В новой конфигурации компактная модель-помощник берет на себя задачу быстрого предсказания нескольких токенов вперед, выступая в роли ассистента.
Основная модель выполняет роль старшего эксперта: она проверяет предсказания «черновика» за один проход, принимает корректные варианты и корректирует ошибки, если они возникают. Такой подход снижает задержки и увеличивает пропускную способность системы, не влияя на итоговое качество генерируемого текста. Метод позволяет эффективно распределять нагрузку, где легкий «черновик» выполняет рутинную часть работы, а крупная нейросеть берет на себя финальное решение.
Настройка системы через LM Studio
Для реализации этого метода удобнее всего использовать программное обеспечение LM Studio. Процесс настройки требует предварительной загрузки двух совместимых моделей из одного семейства, использующих одинаковые токенизаторы. Важно, чтобы размер «черновой» модели был значительно меньше основной, иначе этап предварительной генерации будет слишком затратным по ресурсам, что нивелирует преимущество метода.
В личном опыте настройки автор использовал модель Llama 3.1 8B в качестве основного исполнителя и Llama 3.2 1B — в качестве модели-помощника. Процесс конфигурации в интерфейсе программы выглядит следующим образом:
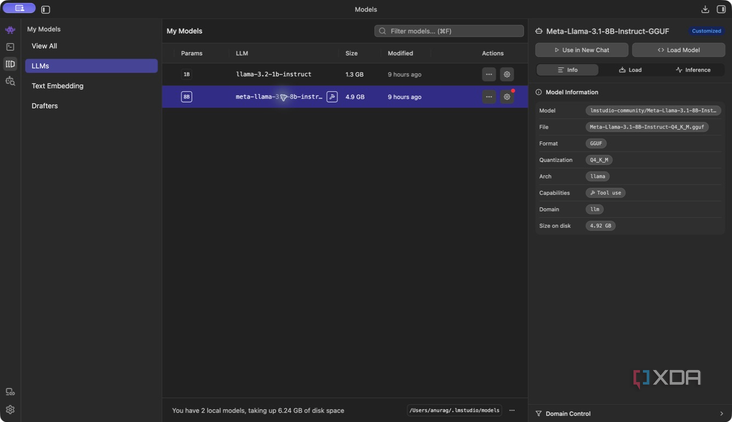
- В разделе «My Models» необходимо выбрать основной экземпляр, например Meta Llama 3.1 8B Instruct, и перейти в настройки «Edit Model Default Config».
- Далее нужно следовать по пути Load -> Advanced -> Speculative Decoding.
- Параметр необходимо переключить с «Off» на «Draft Model» и выбрать Llama 3.2 1B Instruct (Q8_0).
- Для параметров «Max draft tokens» рекомендуется значение 3, для «Min draft tokens» — 0, а для «Draft probability» — 0.
- После нажатия «Load Model» с активной опцией «Remember settings» система начнет использовать обе модели в связке.
Результаты тестирования и влияние на производительность
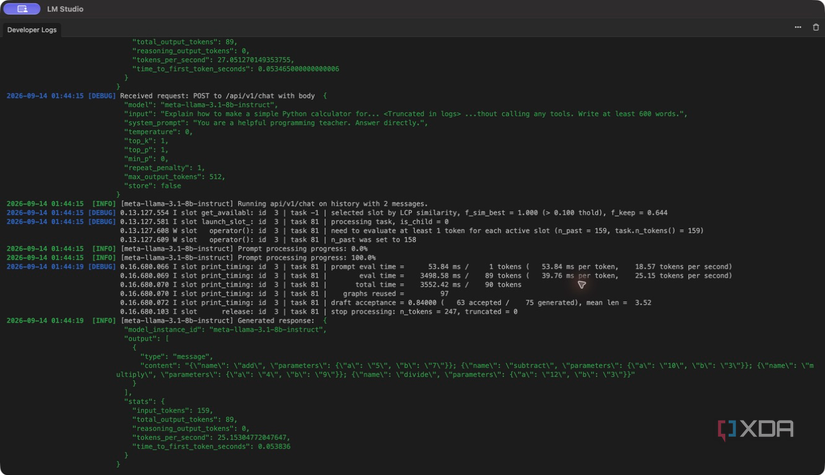
Практическое применение метода показало ощутимый рост скорости при выполнении типичных задач: суммаризации исследований, написании программного кода и ответов на повседневные вопросы. Сравнительные тесты проводились при идентичных параметрах промптов с включенной и выключенной функцией speculative decoding. Без оптимизации базовая модель Llama 3.1 8B демонстрировала среднюю скорость 23,35 токена в секунду. С подключением Llama 3.2 1B этот показатель вырос до 29,46 токена в секунду, обеспечив прирост производительности примерно на 26%.
Несмотря на то что абсолютное увеличение скорости может показаться скромным, накопленный эффект при работе с длинными ответами и последовательными цепочками запросов значительно сокращает время ожидания. Использование speculative decoding оправдано в случаях, когда оба экземпляра моделей свободно размещаются в оперативной памяти устройства. Однако если основная нейросеть уже работает на пределе возможностей аппаратного обеспечения, дополнительная нагрузка от «черновой» модели может снизить общую эффективность системы.
Опыт отказа от облачных решений
До внедрения спекулятивного декодирования автор экспериментировал с гибридной моделью «облако + локальный хост». В этой конфигурации использовалась GPT-5.6 Luna для этапа планирования и проверки задач, тогда как нейросеть Qwen 3.5-9B отвечала непосредственно за их исполнение. Хотя такая связка работала исправно, основной целью было полное исключение зависимости от облачных API, что и привело к переходу на speculative decoding.
Важные нюансы реализации
Несмотря на кажущуюся простоту, выбор моделей имеет решающее значение. Важно убедиться, что используемая вами «черновая» модель значительно меньше основной. Если выбрать слишком тяжелый «черновик», этап предварительной генерации станет энергозатратным и долгим, что полностью лишит метод смысла, так как вся суть подхода заключается в легковесности вспомогательной модели.
Для корректной настройки в LM Studio после активации режима Speculative Decoding важно следовать правилам выбора компонентов:
- Модели должны принадлежать к одному семейству и использовать идентичные токенизаторы.
- В качестве конкретного примера автор рекомендует связку Llama 3.1 8B (основная) и Llama 3.2 1B (draft).
- При выборе параметров для «черновика» следует придерживаться проверенных значений: Max draft tokens — 3, Min draft tokens — 0, и Draft probability — 0.
- Для фиксации конфигурации необходимо нажать кнопку «Load Model» с установленным флажком «Remember settings».
Анализ эффективности и «стоимость» метода
Метод speculative decoding позволяет достичь 26-процентного прироста производительности без изменения итогового качества ответов. Для получения объективных данных автор проводил тесты после предварительного «прогрева» моделей, выполняя каждый запрос по три раза в обоих режимах.
Хотя дополнительные 6 токенов в секунду могут показаться незначительными, они критически влияют на комфорт при решении повседневных задач, где скорость отклика определяет удобство диалога с нейросетью. Тем не менее, у метода есть обратная сторона: использование двух моделей одновременно требует большего объема видеопамяти и ресурсов процессора. Поэтому, если ваше «железо» уже работает на пределе возможностей с одной основной моделью, запуск второй может привести к снижению общей производительности. Рекомендуется протестировать обе конфигурации и оставить ту, которая показывает лучший результат на конкретной аппаратной базе.