В редакторе кода Visual Studio Code появилась функция распознавания речи, которая работает полностью на устройстве пользователя. В отличие от многих сторонних инструментов, эта система не отправляет данные в облако, что решает вопросы конфиденциальности, связанные с обработкой голосовых команд.
Особенности локальной модели распознавания речи
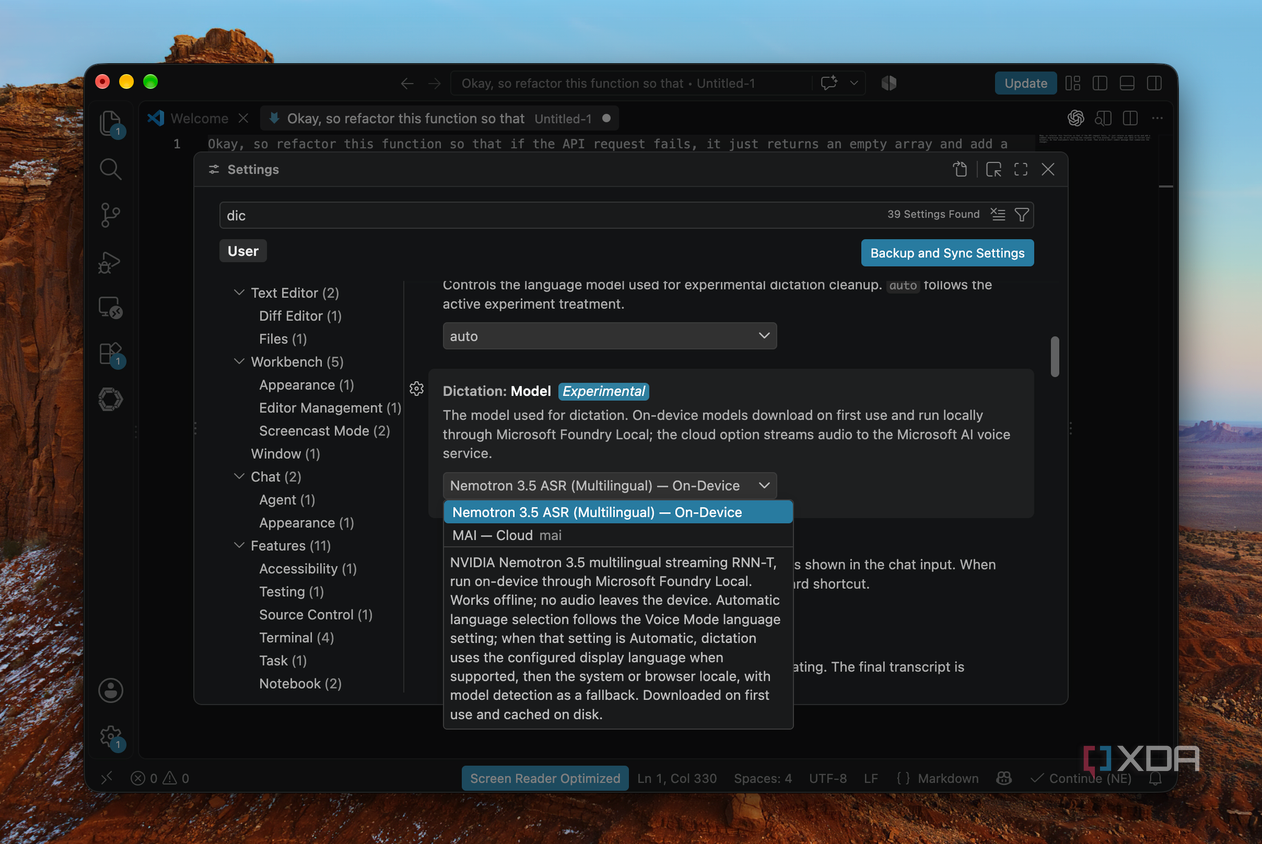
Для реализации функции диктовки VS Code загружает легкую ИИ-модель Nemotron 3.5 ASR Streaming 0.6B через инфраструктуру Microsoft Foundry Local. Это решение с 600 миллионами параметров разработано компанией Nvidia специально для низкозадержковой многоязычной транскрипции в режиме реального времени. Модель поддерживает более 40 языковых локалей и способна выполнять автоматическое определение языка с помощью одного контрольного параметра.
Технически Nemotron 3.5 базируется на архитектуре FastConformer-RNNT. Она обрабатывает аудиофрагменты, повторно используя кешированный контекст, что позволяет избежать избыточных вычислений. Система обеспечивает задержку транскрипции менее 100 мс при настраиваемом размере фрагментов от 80 мс. Поскольку модель эффективно справляется с расстановкой знаков препинания и капитализацией на лету, дополнительные этапы обработки не требуются. Благодаря компактному размеру, она стабильно работает на различном локальном оборудовании, включая процессоры ноутбуков.
Как начать использование встроенной диктовки
Инструмент интегрирован в различные элементы интерфейса VS Code, включая панель чата, встроенный чат, текстовый редактор, терминал и поля для фиксации коммитов. Это позволяет пользователям диктовать запросы для GitHub Copilot или других локальных ИИ-агентов, а также записывать код, документацию и команды.
Если функция не активировалась автоматически, её можно включить в настройках: через сочетание клавиш Ctrl+, (в Windows/Linux) или Cmd+, (в macOS), найдя пункт dictation.enabled. Для начала записи в редакторе используются горячие клавиши: Ctrl + Alt + V (Windows/Linux) или Alt + Command + V (macOS). Также в полях ввода, например в чате Copilot, отображается иконка микрофона.
Качество транскрипции и возможности модели
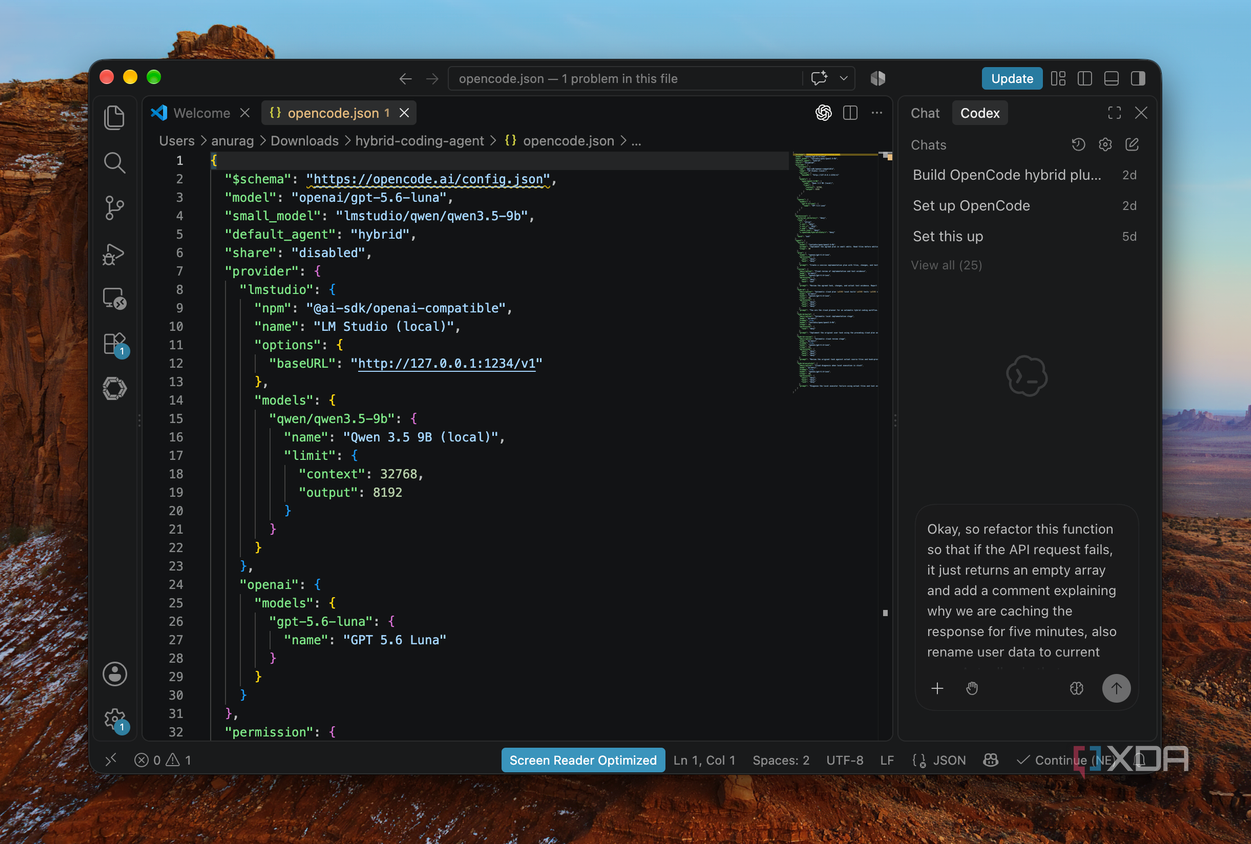
Модель 0.6B демонстрирует высокую эффективность, особенно при написании заметок, Markdown-файлов или обычного текста. Главная область применения — озвучивание промптов для ИИ-агентов. Даже при наличии мелких погрешностей, например, в форматировании специфических идентификаторов кода, модель достаточно точно передает суть сказанного. В тестах при диктовке сложных инструкций по рефакторингу функций, ИИ-модели на другом конце успешно распознавали намерения пользователя, несмотря на незначительные изменения в написании имен переменных. Для инструмента такого размера результат работы признан достаточно качественным и пригодным для повседневных задач разработчика.
Почему переход на встроенный инструмент оправдан
Для многих разработчиков вопрос использования инструментов распознавания речи долгое время упирался в проблему конфиденциальности. Ранее приходилось полагаться на сторонние облачные сервисы, такие как Wispr Flow. Использование подобных решений несло в себе серьезные риски: этим программам часто требуются права доступа к системе уровня Accessibility (специальные возможности), что фактически дает им возможность «видеть» всё, что происходит на экране пользователя, и отправлять любые произнесенные слова на удаленные серверы. Осознание того, что персональные данные, критически важный программный код и рабочая переписка отправляются в облако сторонней компании, делает доверие к таким инструментам крайне затруднительным.
Некоторые пользователи пытались перейти на альтернативные open-source решения, такие как FreeFlow, которые позволяют подключаться к локальным LLM. Однако появление встроенного решения непосредственно в VS Code стало долгожданным упрощением процесса. Если раньше для реализации голосовых функций в редакторе требовалось устанавливать отдельное расширение VS Code Speech, то теперь функциональность стала нативной и полностью автономной.
Технические детали и архитектура Nemotron
Модель Nemotron 3.5 ASR Streaming 0.6B представляет собой открытое решение с 600 миллионами параметров, которое специально оптимизировано для работы в условиях ограниченных ресурсов. Помимо поддержки более 40 языковых локалей, ключевой особенностью модели является использование технологии language-ID prompt conditioning. Это позволяет системе гибко адаптироваться к разным языкам, сохраняя при этом возможность автоматического определения языка на лету без необходимости вручную переключать настройки.
Архитектура FastConformer-RNNT была выбрана неслучайно. Она эффективно решает проблему избыточных вычислений за счет того, что каждый новый фрагмент аудио обрабатывается с учетом уже накопленного кешированного контекста. Это позволяет достичь крайне низких задержек — менее 100 мс на окончание высказывания, при этом пользователь может гибко настраивать размер обрабатываемых чанков, начиная с 80 мс. Поскольку модель берет на себя еще и расстановку знаков препинания, а также капитализацию, необходимость в сторонних пост-процессорах отпадает, что значительно снижает нагрузку на CPU.
Практический опыт и тестирование
В ходе тестирования возможностей модели была предпринята попытка продиктовать сложный технический промпт, содержащий специфические инструкции по рефакторингу, включая упоминание имен переменных (userData, currentUser) и требования к комментариям. Итоговая транскрипция показала, что модель безупречно справляется с общим смыслом предложения, структурой задачи и техническими деталями.
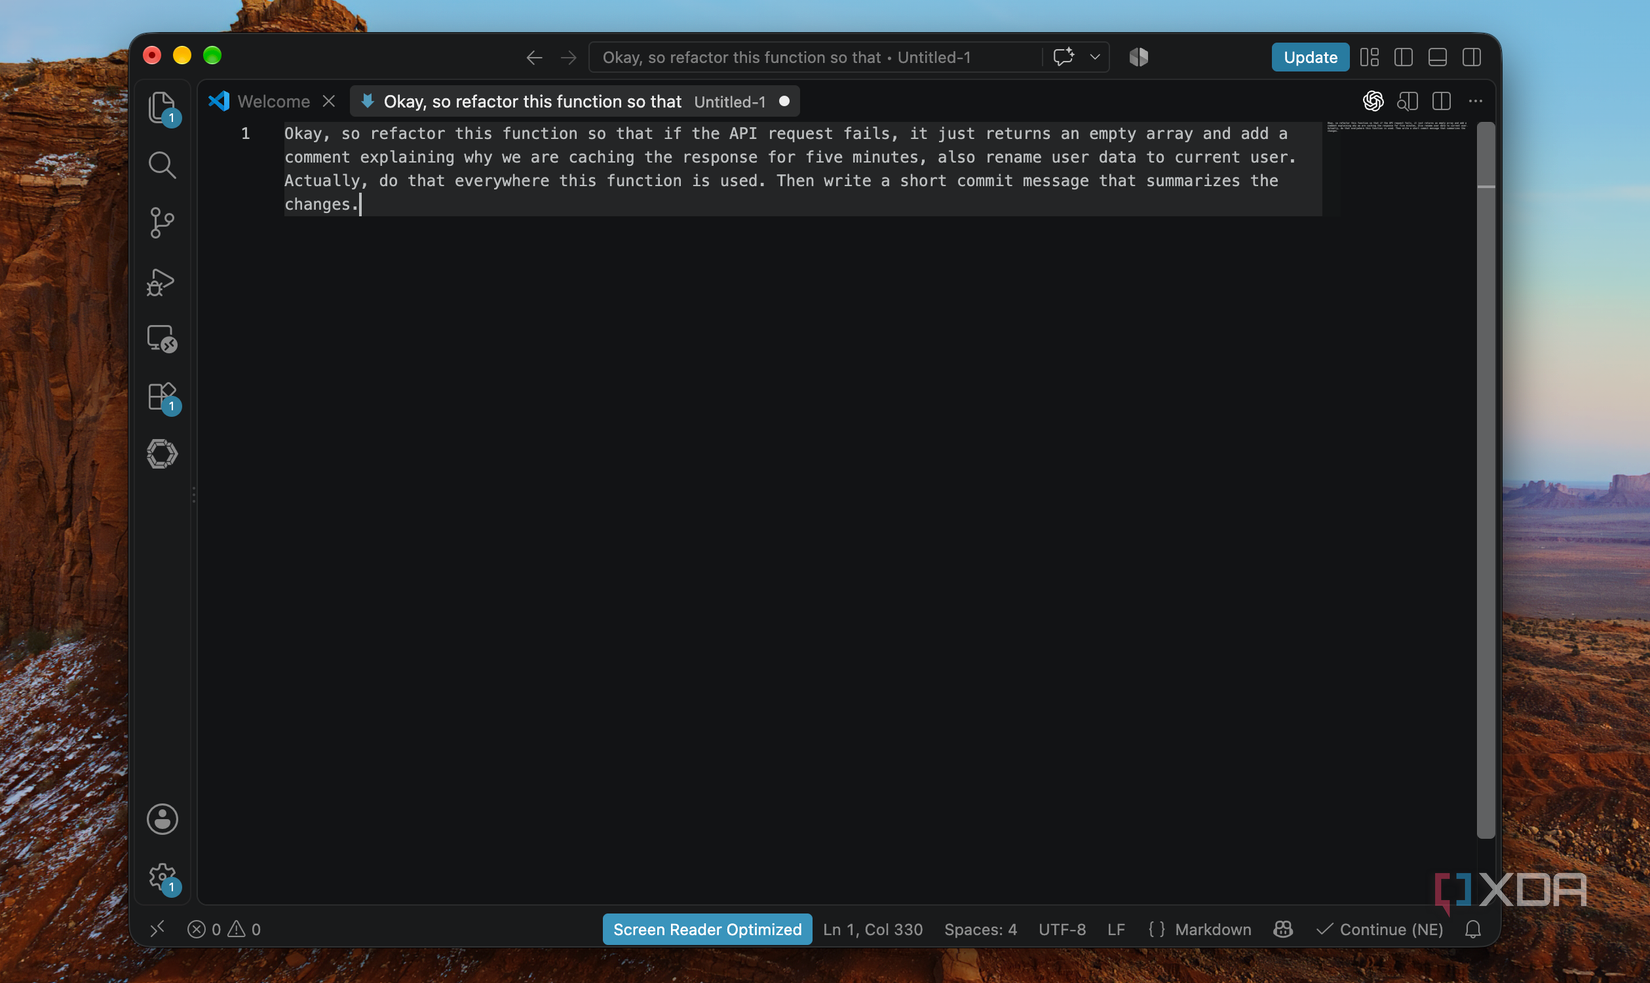
Единственным выявленным нюансом стало превращение идентификаторов userData и currentUser в «user data» и «current user» (с пробелами). Однако, как показала практика, этот недочет является скорее вопросом форматирования, чем ошибкой распознавания речи. В контексте взаимодействия с ИИ-агентами (например, при работе с Claude или GitHub Copilot) этот аспект практически не имеет значения. LLM успешно интерпретирует намерение разработчика и понимает, о каких именно переменными идет речь в коде. Таким образом, даже при наличии небольших расхождений в написании, модель на «той стороне» получает достаточно точную инструкцию, что делает встроенный инструмент крайне эффективным помощником в повседневной работе.