Использование нейросетей, размещенных локально, обладает рядом преимуществ по сравнению с облачными платформами вроде ChatGPT или Perplexicity. Пользователям не нужно ежемесячно платить за подписки или учитывать лимиты на количество запросов. Кроме того, локальные модели обеспечивают высокую приватность при работе с финансовой отчетностью, научными данными, личными проектами и конфиденциальными файлами, исключая передачу информации на серверы сторонних компаний. Ранее для корректной работы требовались значительные вычислительные ресурсы, однако развитие архитектур сделало возможным запуск мощных моделей на потребительских видеокартах с приемлемой скоростью.
Архитектура Mixture-of-Experts для оптимизации VRAM
Модели типа Mixture-of-Experts (MoE) кардинально изменили подход к работе с памятью видеокарт. В традиционных LLM используются плотные слои, тогда как MoE опираются на небольшие специализированные сети — «эксперты», работающие параллельно. При выполнении задачи маршрутизатор выбирает только тех экспертов, чья компетенция достаточна для формирования точного ответа, игнорируя остальные компоненты.
Эта архитектура позволяет оставить механизм внимания и маршрутизатор в видеопамяти (VRAM), в то время как веса экспертов выгружаются в системную оперативную память. Такой подход решает проблему производительности при нехватке VRAM. Ранее приходилось либо чрезмерно квантовать модель до уровня INT2, что критически снижало точность, либо переносить слои на центральный процессор через флаг -ngl, что приводило к катастрофическому падению скорости генерации токенов.
Практика запуска моделей на картах прошлых лет
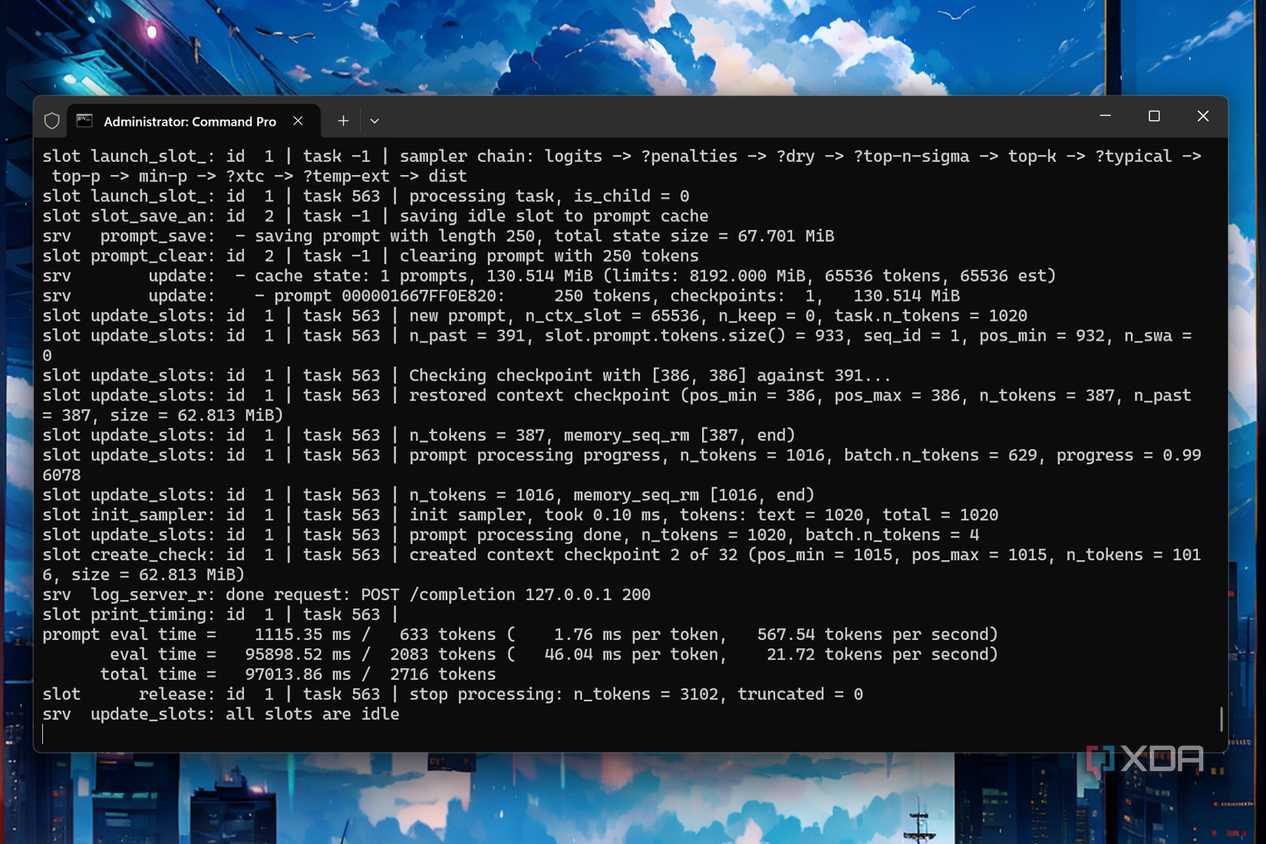
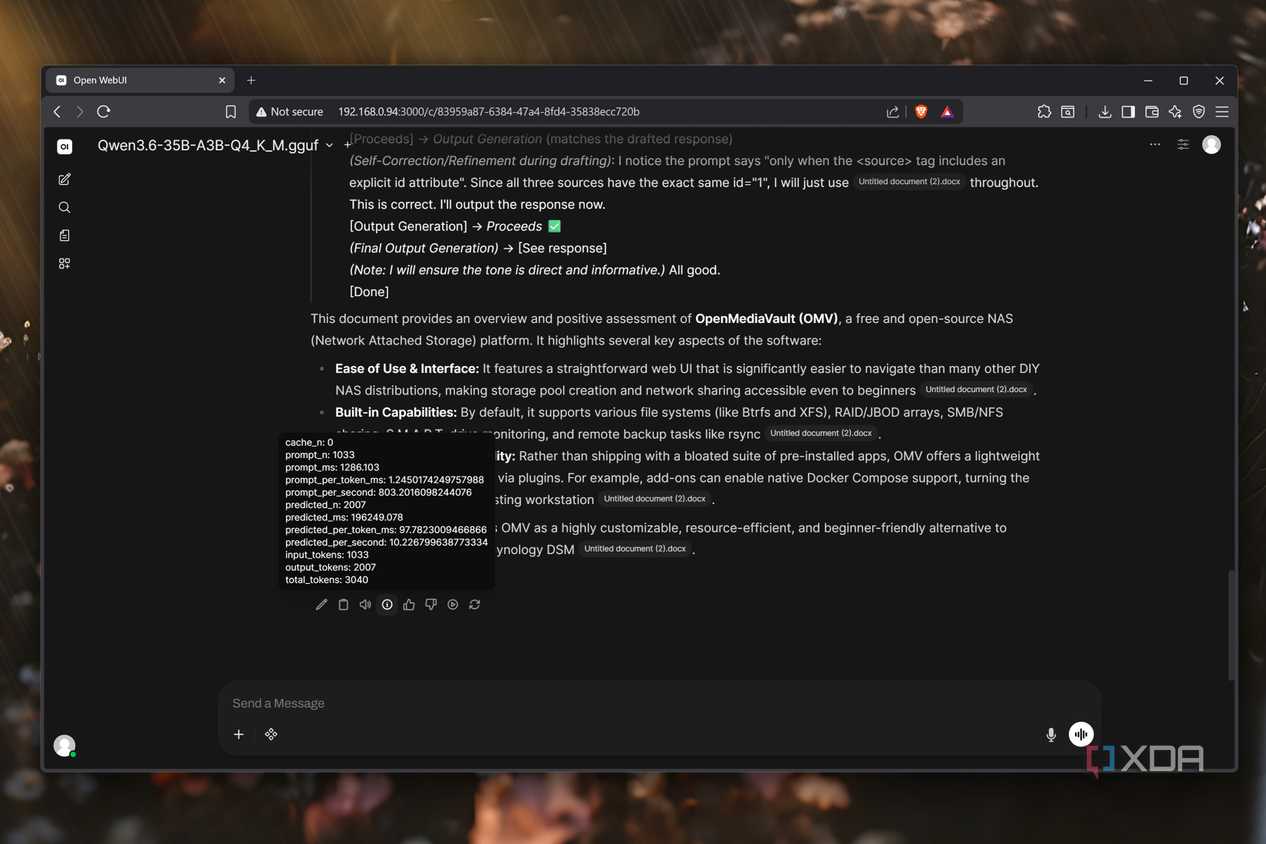
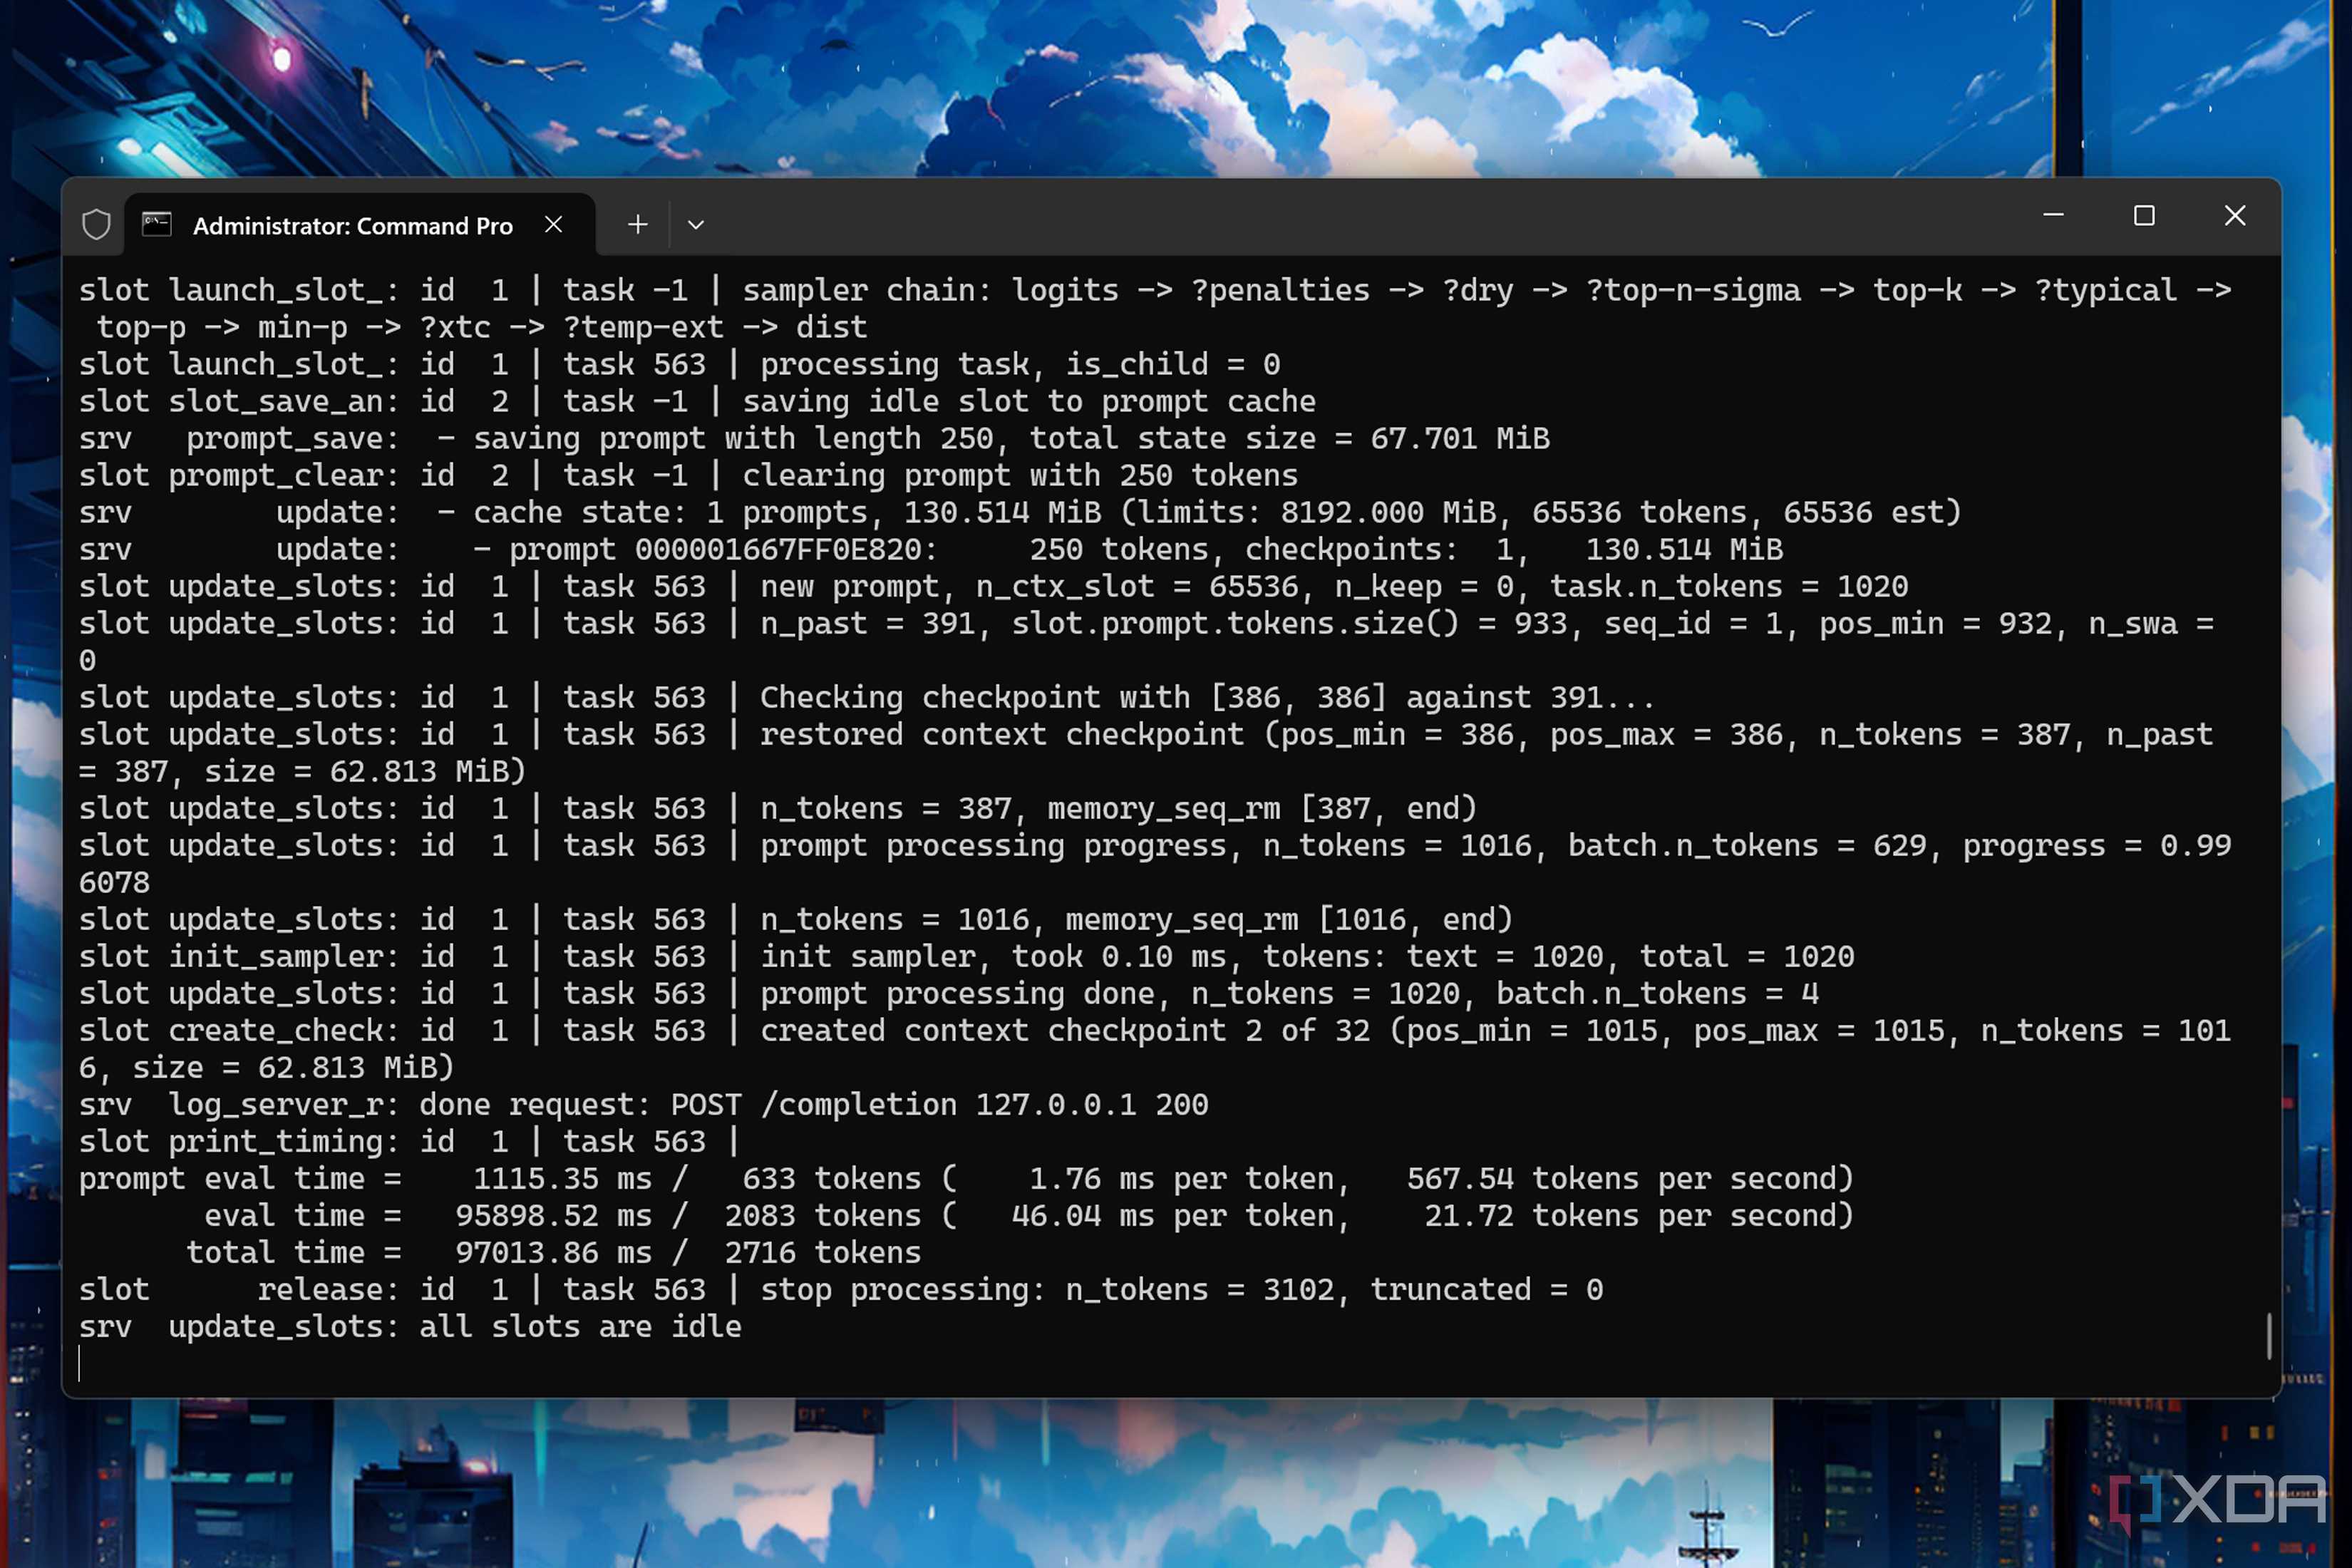
Для владельцев видеокарт с ограниченным объемом памяти MoE-модели стали оптимальным решением. Например, на видеокарте RTX 3080 Ti с 12 ГБ VRAM при использовании параметра —n-cpu-moe со значением 25 и более в llama.cpp, модель Qwen3.6-35B-A3B (квантование Q4_K_M) показывает скорость не менее 25 токенов в секунду. Модель эффективно справляется с написанием Terraform-конфигураций, отладкой серверных логов, созданием YAML-фрагментов, кода для Arduino и Jinja2-шаблонов для Home Assistant.
Даже более старые решения, такие как GTX 1080 (архитектура Pascal), позволяют использовать инстансы Gemma-4-26B-A4B. Несмотря на десятилетний возраст карты, она обеспечивает скорость около 14 токенов в секунду, чего достаточно для фоновых задач, таких как Open Notebook или Paperless-GPT.
Легковесные модели и периферийные задачи
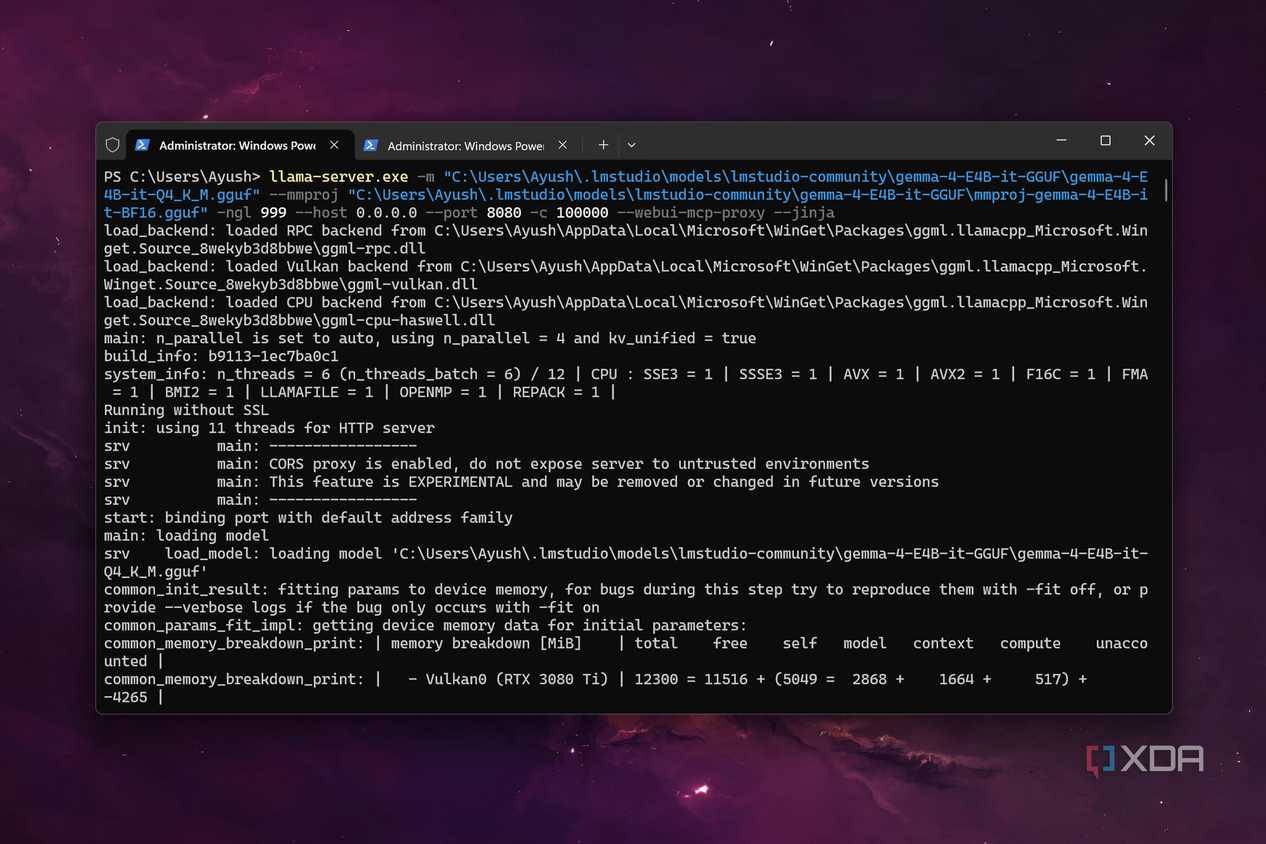
Особое место в локальном ИИ занимают компактные модели, такие как Gemma-4-E4B. Несмотря на малый вес, они превосходят многие другие нейросети с параметрами менее 8 млрд. Это достигается за счет использования механизма Per Layer Embedding, где каждый декодерный слой имеет собственную таблицу вложений. Такая оптимизация позволяет модели с реальным весом 4,5 млрд параметров обладать базой знаний, сопоставимой с моделями класса 8B.
- На RTX 3080 Ti эта модель выдает около 100 токенов в секунду.
- На GTX 1080 скорость достигает 35–40 токенов в секунду.
- На Intel Arc A750 и старых ноутбуках с GTX 1060 производительность держится на уровне 30 токенов в секунду.
Этих показателей достаточно для использования модели в качестве центрального компонента голосового ассистента в составе Home Assistant или для автоматизации задач домашнего сервера.
Вспомогательные модели для работы с контекстом
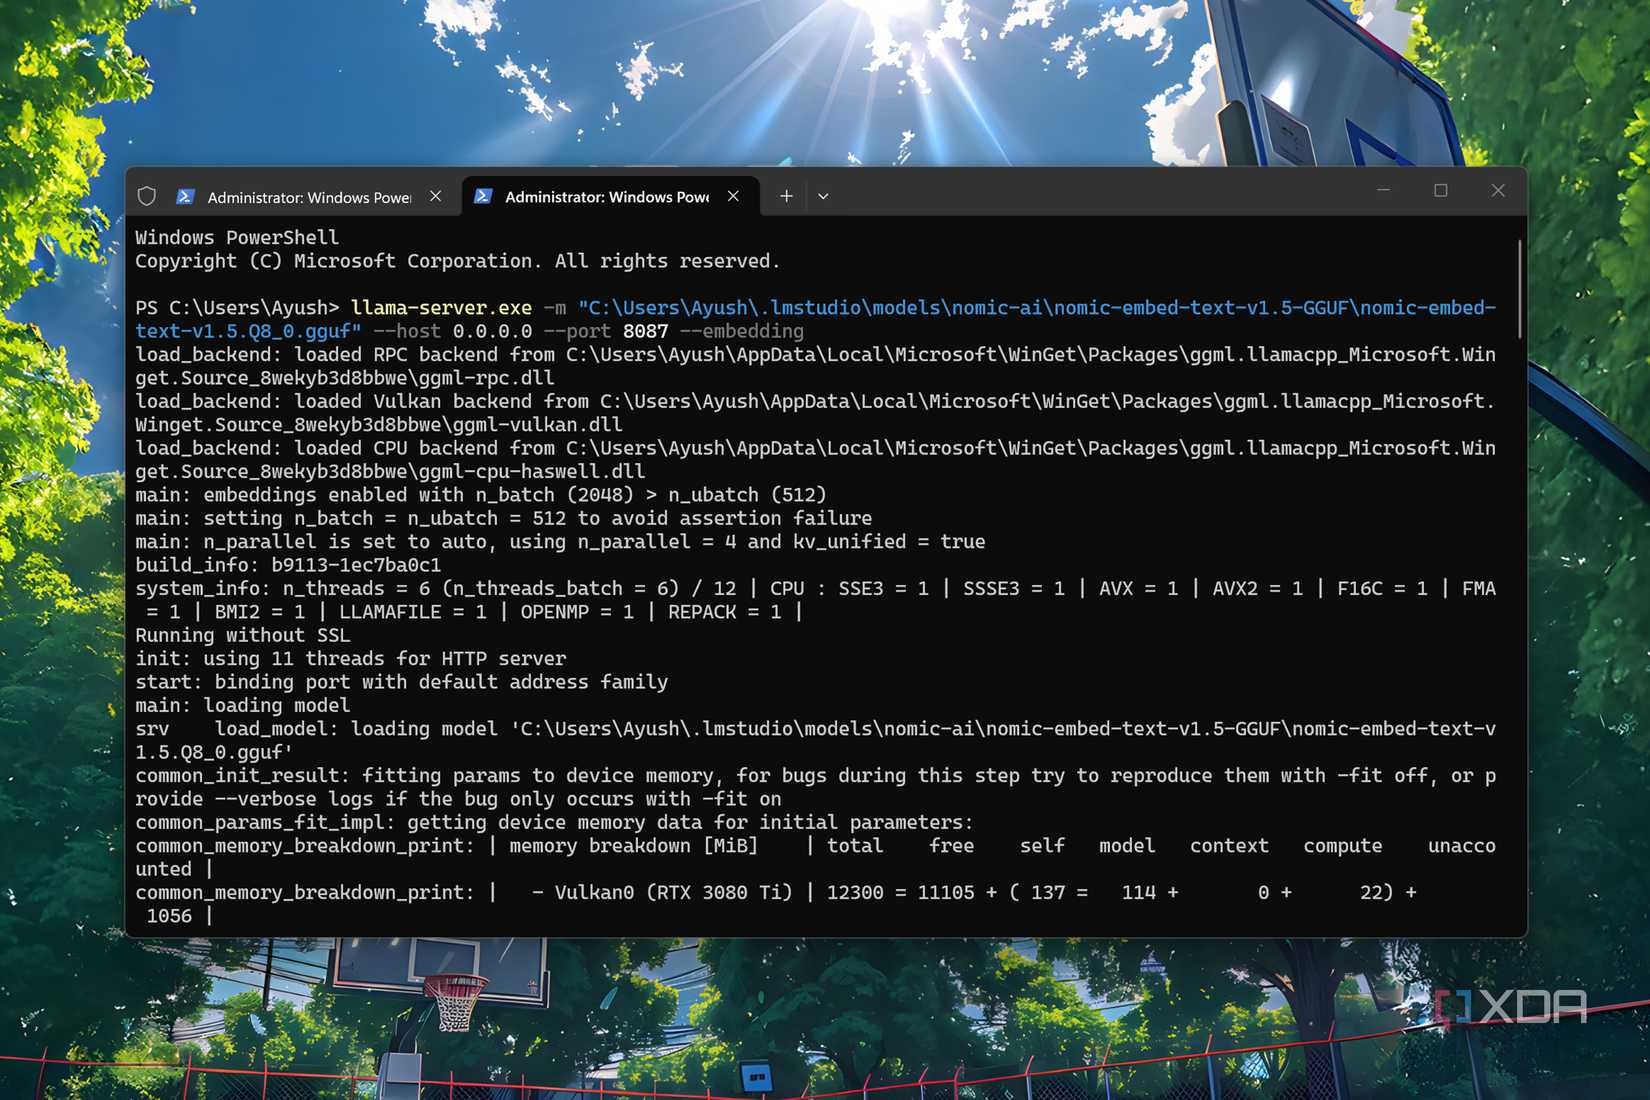
Для эффективной работы ИИ-экосистемы на домашнем сервере также необходимы модели эмбеддингов, преобразующие текст и изображения в векторы. Большинство из них, включая nomic-embed-text-1.5, обладают низкими требованиями к железу и могут работать непосредственно на процессоре. Они помогают приложениям, таким как Open Notebook и Blinko, добавлять необходимый контекст к запросам пользователя.
Аналогичная ситуация складывается с моделями преобразования текста в речь (TTS) и речи в текст (STT). В отличие от генераторов изображений, они не требуют мощных GPU. Для базовых задач достаточно обычного процессора Xeon, однако использование Docker-контейнера Speaches, привязанного к видеокарте GTX 1080, позволяет добиться минимальной задержки при работе с голосовым интерфейсом Open WebUI.
Технические нюансы работы MoE-архитектуры и производительность
Важно понимать, почему MoE-модели совершили такой прорыв для пользователей с ограниченным объемом видеопамяти. В отличие от традиционных плотных моделей, где каждое вычисление требует полного доступа к весам, MoE-архитектура позволяет гибко балансировать между VRAM и оперативной памятью (RAM). Когда вы пытаетесь запустить, скажем, модель класса 25B+ на видеокарте, объем памяти которой в два раза меньше необходимого, именно сочетание RAM и VRAM становится критическим фактором успеха. При использовании флага —n-cpu-moe в llama.cpp, вы фактически заставляете систему эффективно распределять ресурсы, не допуская «узкого горлышка» в виде центрального процессора, которое обычно возникает при попытке выгрузки обычных слоев через -ngl.
Для сравнения: если бы упомянутая модель Qwen3.6-35B-A3B была обычной плотной моделью, принудительная выгрузка слоев на CPU сделала бы процесс генерации настолько медленным, что производительность пришлось бы измерять уже не в токенах в секунду, а в секундах на генерацию одного токена. В текущей конфигурации на RTX 3080 Ti это решение выступает полноценным компаньоном для VS Code, а также является «мозговым центром» для агентов Pi и сервера мониторинга Pulse.
Особенности оптимизации Gemma-4-E4B: «Per Layer Embedding»
Успех модели Gemma-4-E4B в задачах, где критична скорость отклика, обусловлен принципиально иным подходом к обработке данных. Вместо использования тяжелых матричных операций для каждого запроса, модель применяет метод Per Layer Embedding. Каждому декодерному слою предоставляется собственная таблица вложений, что позволяет осуществлять быстрые поисковые операции (lookups). Такой архитектурный трюк дает возможность «упаковать» внутрь нейросети гораздо больше логических связей и знаний, чем это было возможно в моделях аналогичного веса ранее. Фактически, имея физический размер 4,5 млрд параметров, модель демонстрирует глубину рассуждений, характерную для моделей с 8 млрд параметров. Это делает ее идеальным кандидатом для развертывания на самом разном «железе» — от энтузиастских сборок с устаревшими GPU вроде GTX 1060 до современных интегрированных или бюджетных дискретных решений, таких как Intel Arc A750.
Роль embedding-моделей и специфика TTS/STT в локальной среде
Помимо самих LLM, для построения полноценной домашней экосистемы неоценимую роль играют модели эмбеддингов. Их задача — преобразование текстов и изображений в векторы и последующее их отображение в едином векторном пространстве, где семантически похожие объекты группируются вместе. Это позволяет таким инструментам, как Open Notebook или Blinko, снабжать локальную LLM релевантным контекстом «на лету», что резко снижает вероятность галлюцинаций при ответах на специфические вопросы по вашим личным файлам.
Что касается моделей для работы с голосом (TTS — Text-to-Speech и STT — Speech-to-Text), они представляют собой отдельный класс инструментов, которые не требуют топовой видеокарты. Существует распространенный миф, что для качественного синтеза и распознавания речи обязательно нужен мощный графический ускоритель. На практике, многие подобные модели отлично отрабатывают даже на серверных процессорах начального уровня, например, на старых чипах Xeon. Переход на связку Docker + Speaches с использованием GTX 1080 оправдан лишь в том случае, если вы стремитесь к получению практически мгновенного отклика при выстраивании голосового интерфейса, например, для управления умным домом через Open WebUI. В остальных сценариях использование ресурсов процессора является вполне оправданной стратегией, высвобождающей видеопамять для более требовательных задач интеллектуального анализа.