

Эволюция мобильной графики: аппаратное ускорение ИИ от Arm
Мобильные графические решения постепенно сокращают разрыв в производительности с интегрированными видеокартами настольного класса, успешно внедряя передовые технологии рендеринга, характерные для игровых консолей и ПК. Примером этого служит трассировка лучей, которая уже доступна в смартфонах в облегченном виде при минимальном энергопотреблении. В то же время настольные GPU совершили рывок благодаря нейросетевому апскейлингу и генерации кадров, позволяющим достигать показателей 4K/120 fps. Теперь мобильная индустрия перенимает этот опыт, и в скором времени новые смартфоны могут получить поддержку ИИ-апскейлинга благодаря графическим процессорам Arm Mali серии NX.
Знакомство с Arm Mali G2-Ultra
Прежде чем рассматривать ИИ-инновации, необходимо оценить архитектурные изменения в новой серии G2. В сравнении 14-ядерной эталонной платформы Mali G1-Ultra с аналогом G2-Ultra (при разнице тактовой частоты шейдерных ядер 1,53 ГГц против 1,70 ГГц) прирост игровой производительности варьируется от 9% в Honkai: Star Rail до 14% в Fortnite. В наиболее требовательных мобильных бенчмарках Arm ожидает улучшения на 17–20%. Хотя прирост в классической растеризации можно назвать умеренным, внутреннее устройство претерпело кардинальные изменения — это самое масштабное обновление Mali за семь поколений.
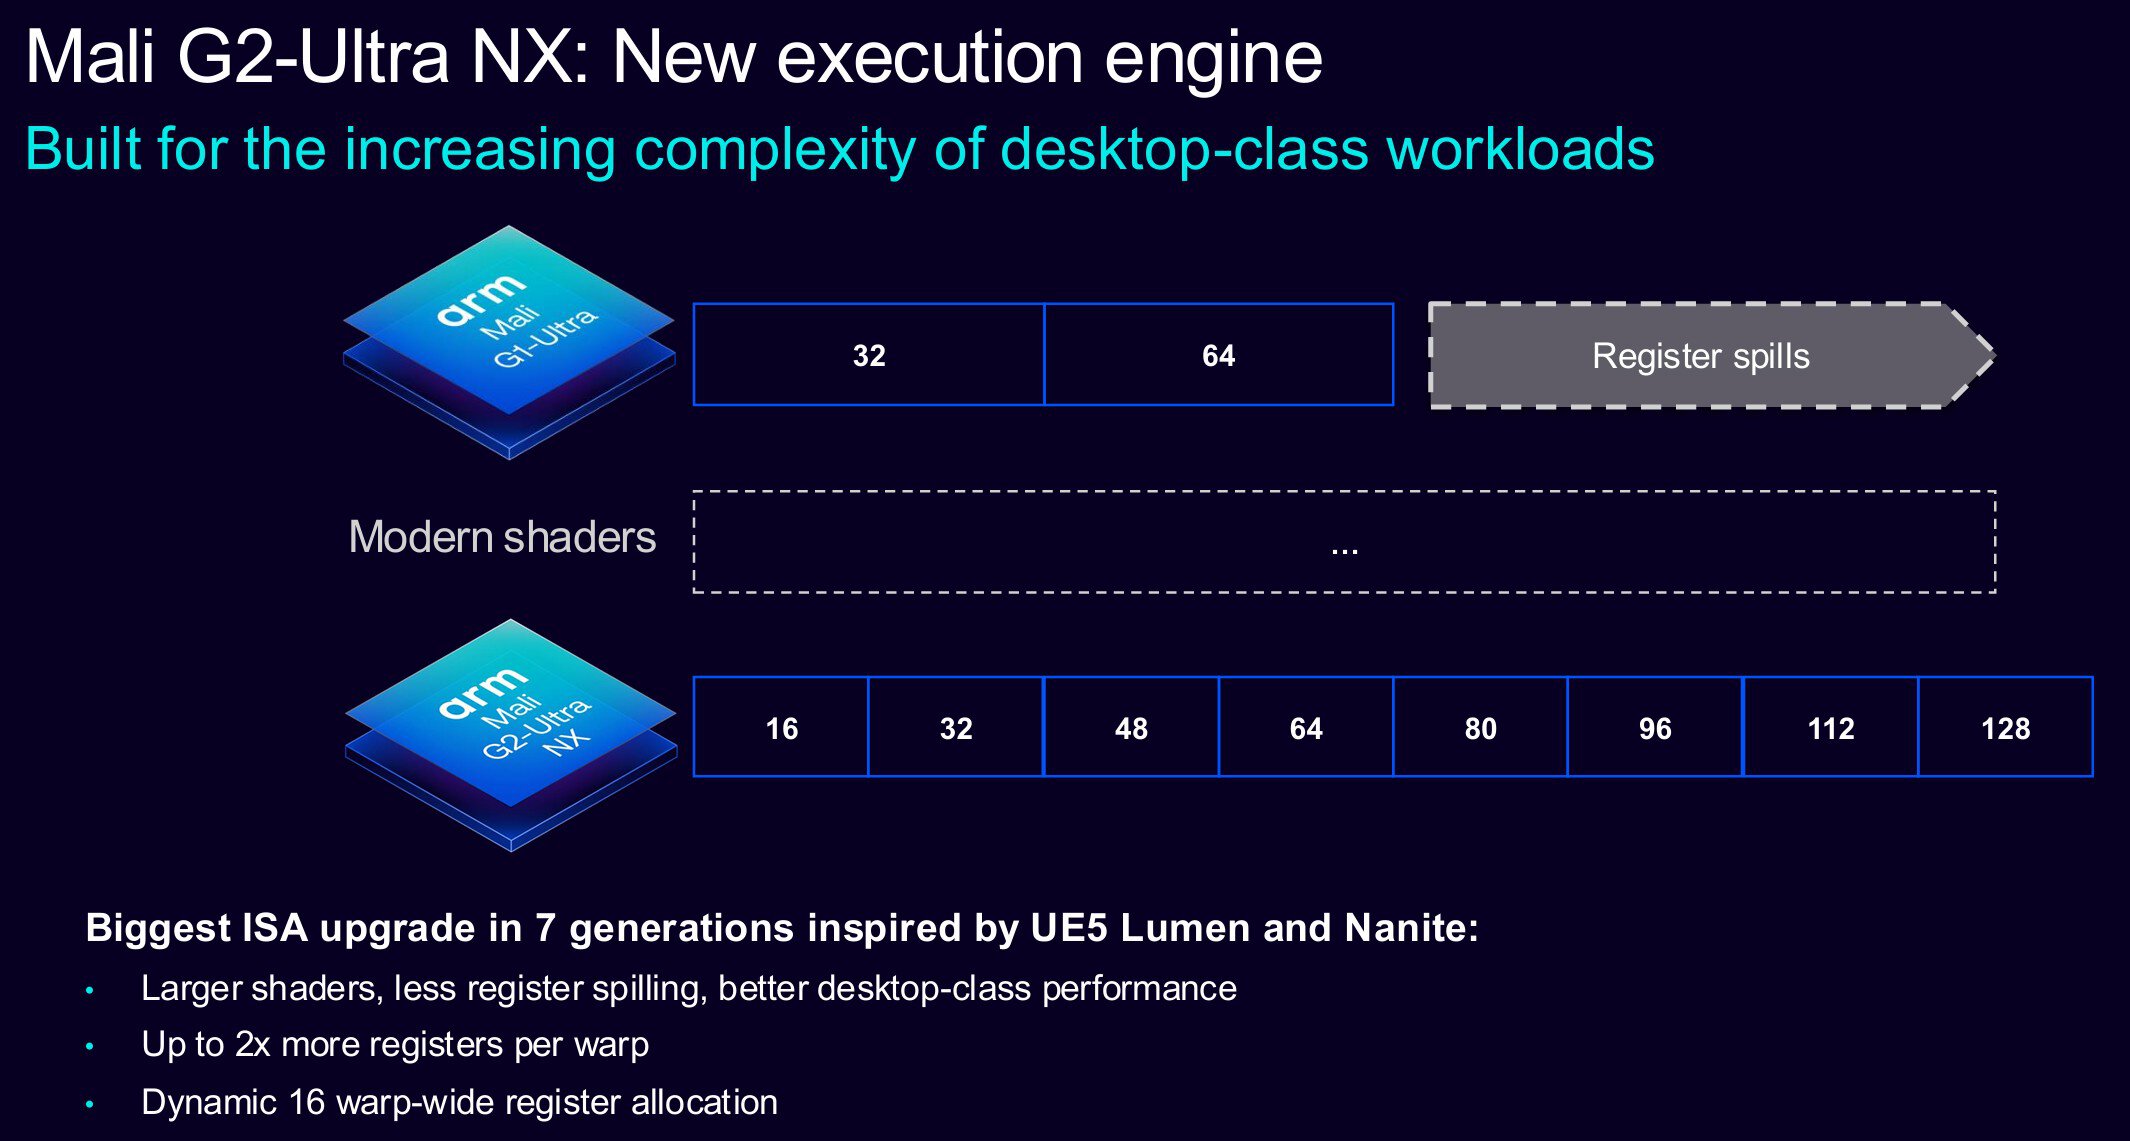
Исполнительные блоки были переработаны для поддержки крупных шейдеров настольного уровня: количество регистров на ворп удвоено (со 128 до 64), внедрено динамическое распределение (поддержка шагов от 16 до 128 регистров). Это позволяет таким технологиям, как Unreal Engine 5 Lumen и Nanite, работать без «вытеснения» регистров и сопутствующих падений производительности, вызванных обращением к DRAM. Кроме того, архитектура G2 получила третье поколение блока трассировки лучей с более компактным представлением треугольников (использование общих ребер снижает дублирование данных в кэше). Это снизило нагрузку на DRAM на 13%, устраняя «узкие места» и повышая энергоэффективность. Внедрение аппаратно-ускоренных карт непрозрачности (opacity micromaps) сделало реализацию сцен с трассировкой лучей уровня настольных ПК на мобильных устройствах гораздо более осуществимой. В зависимости от бенчмарка, производительность трассировки лучей выросла на 18–24%.
NX: ИИ внутри графического процессора
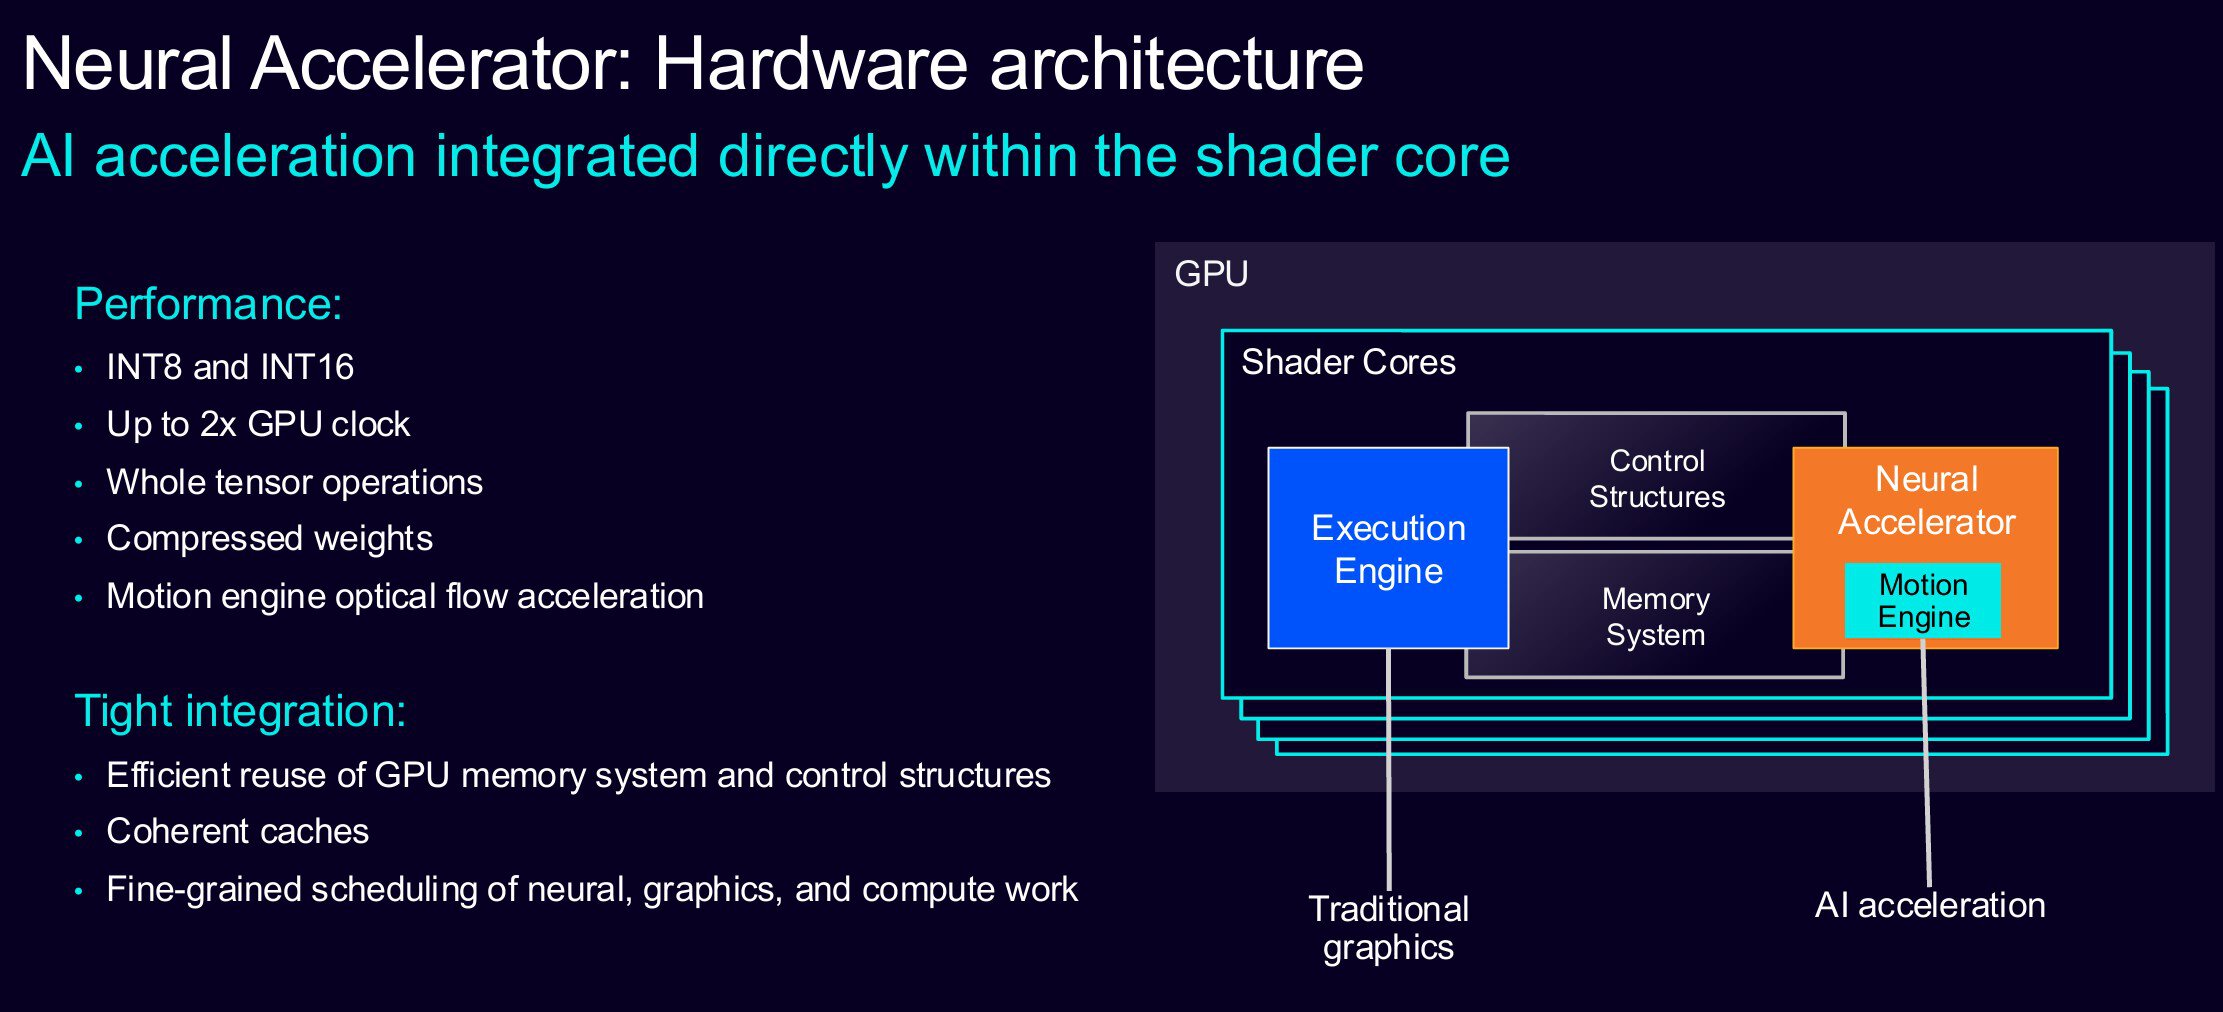
Главным анонсом Arm стало внедрение встроенной поддержки ИИ через новый нейронный ускоритель NX. Это плотно интегрированный аппаратный блок, размещенный внутри шейдерного ядра GPU для выполнения нейрографических задач при потреблении всего около 1 Вт. Ускоритель поддерживает операции INT8 и INT16, оснащен собственным блоком обработки движения, работает на частоте до 2x от основной частоты GPU при том же напряжении и разделяет память с подсистемой GPU для обеспечения когерентности.
Показатели впечатляют: демонстрация Neural Dawn на ускорителе NX показывает рост с 15 fps до стабильных 60 fps при энергопотреблении чуть более 2 Вт. Это четырехкратный прирост частоты кадров и эффективности при 70-процентном снижении трафика DRAM по сравнению с прошлогодним ядром G1-Ultra. Достигается это за счет двух этапов:
- Neural Super Sampling and Denoising (NSSD): апскейлинг с 540p до 1080p с одновременным шумоподавлением для трассировки лучей.
- Neural Frame Rate Upscaling (NRFU): удвоение частоты кадров с 30 до 60 fps.
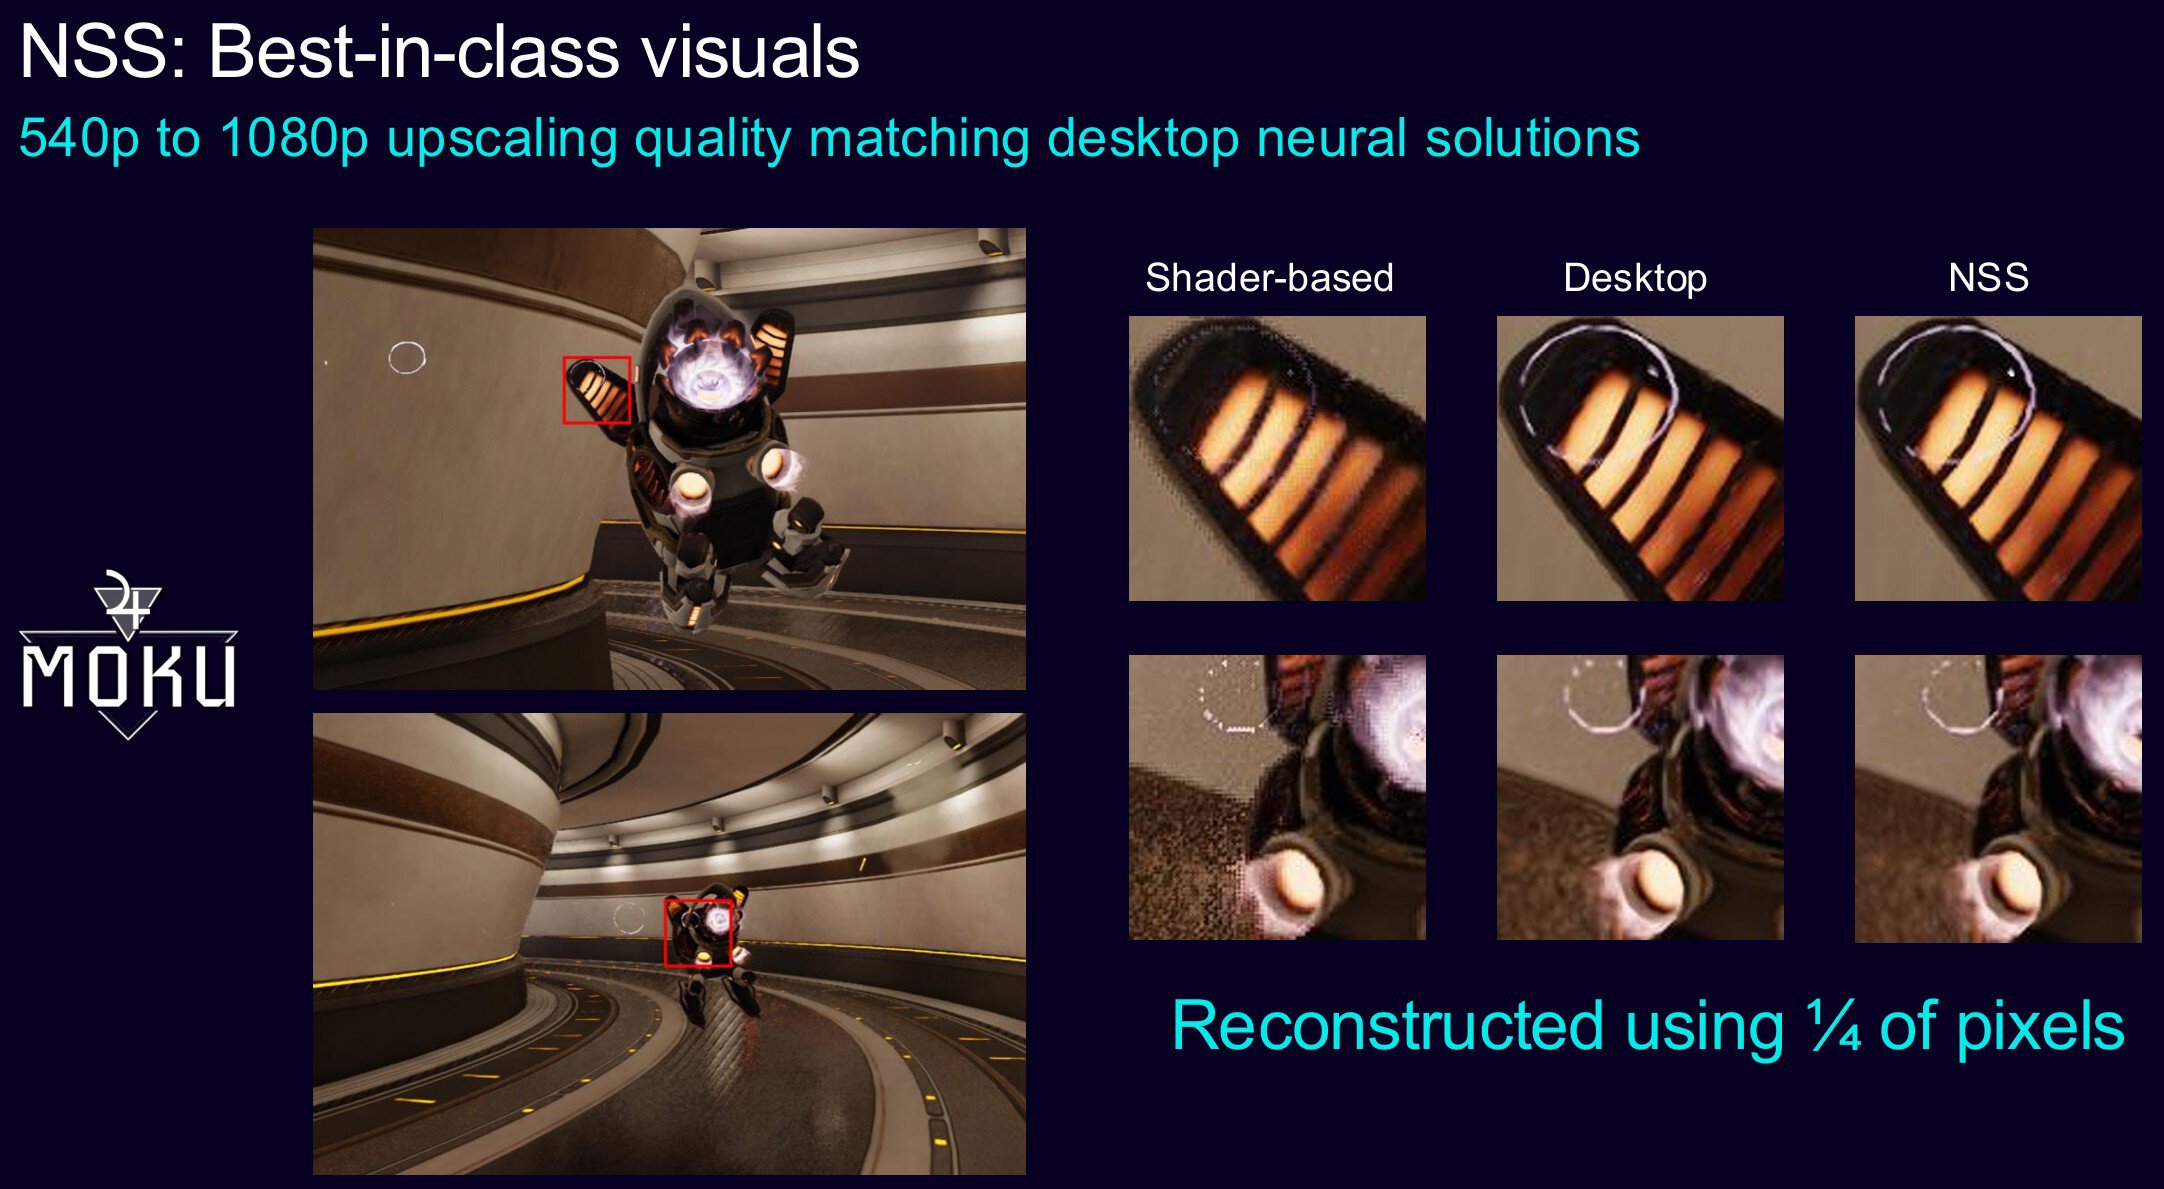
Arm утверждает, что итоговое изображение становится детализированнее, а плавность повышается при снижении общего энергопотребления. В отличие от стандартных алгоритмов вроде TAA, нейросетевой апскейлинг Arm обучается на реальных игровых данных, что позволяет восстанавливать мелкие детали, имея лишь четверть исходной информации. Технология схожа по идеологии с NVIDIA DLSS, AMD FSR и Intel XeSS 2, включая использование истории кадров и встроенного антиалиасинга для устранения джиттера и «гостинга». Вопросы латентности и возможных артефактов при такой обработке остаются открытыми, так как Arm пока не предоставила подробностей.
Технологии нейронного апскейлинга и новая сегментация графики Arm
Технология NSSD (NSS with denoise) представляет собой улучшенную версию метода, который выполняет шумоподавление результатов трассировки лучей непосредственно в составе конвейера масштабирования. В свою очередь, Neural Frame Rate Upscaling (NRFU) позволяет увеличить исходную частоту кадров до двух раз, однако реализация этого процесса значительно сложнее, так как требует избегать появления визуальных артефактов, отвлекающих пользователя.
Для создания нового промежуточного кадра алгоритм использует данные о глубине и векторы движения из двух пар кадров. При этом аппаратное обеспечение ускоряет оценку «оптического потока» (optical flow) сверх значений, предоставляемых игровым движком, и передает все эти данные в нейронную сеть. Хотя карты глубины и векторы движения обычно предоставляет игровой движок, архитектура G2 теперь включает собственный движок движения, который определяет направление движения между кадрами, используя метод, схожий с принципами работы движков кодирования видео.
Статус разработки и совместимость
Три нейронные модели Arm находятся на разных стадиях разработки. NSS была представлена в прошлом году, а NRFU выпущена только что. Обе доступны разработчикам через платформу Hugging Face. Технология NSSD находится на стадии раннего доступа, а ее полноценное внедрение ожидается в 2026 году. Для работы всех трех решений потребуется графический процессор с поддержкой функций NX, поэтому они не обладают обратной совместимостью с прошлогодней серией Mali G1.
Arm стремится сделать графику с поддержкой ИИ максимально доступной на своей платформе, обеспечивая поддержку Vulkan ML для широкого спектра приложений и разрешая хранение и распространение собственных моделей для каждой отдельной игры. Покажет ли это достаточную эффективность для привлечения партнеров к использованию ИИ-апскейлинга и трассировки лучей в мобильных играх следующего поколения — покажет время.
Новая структура конфигураций Mali
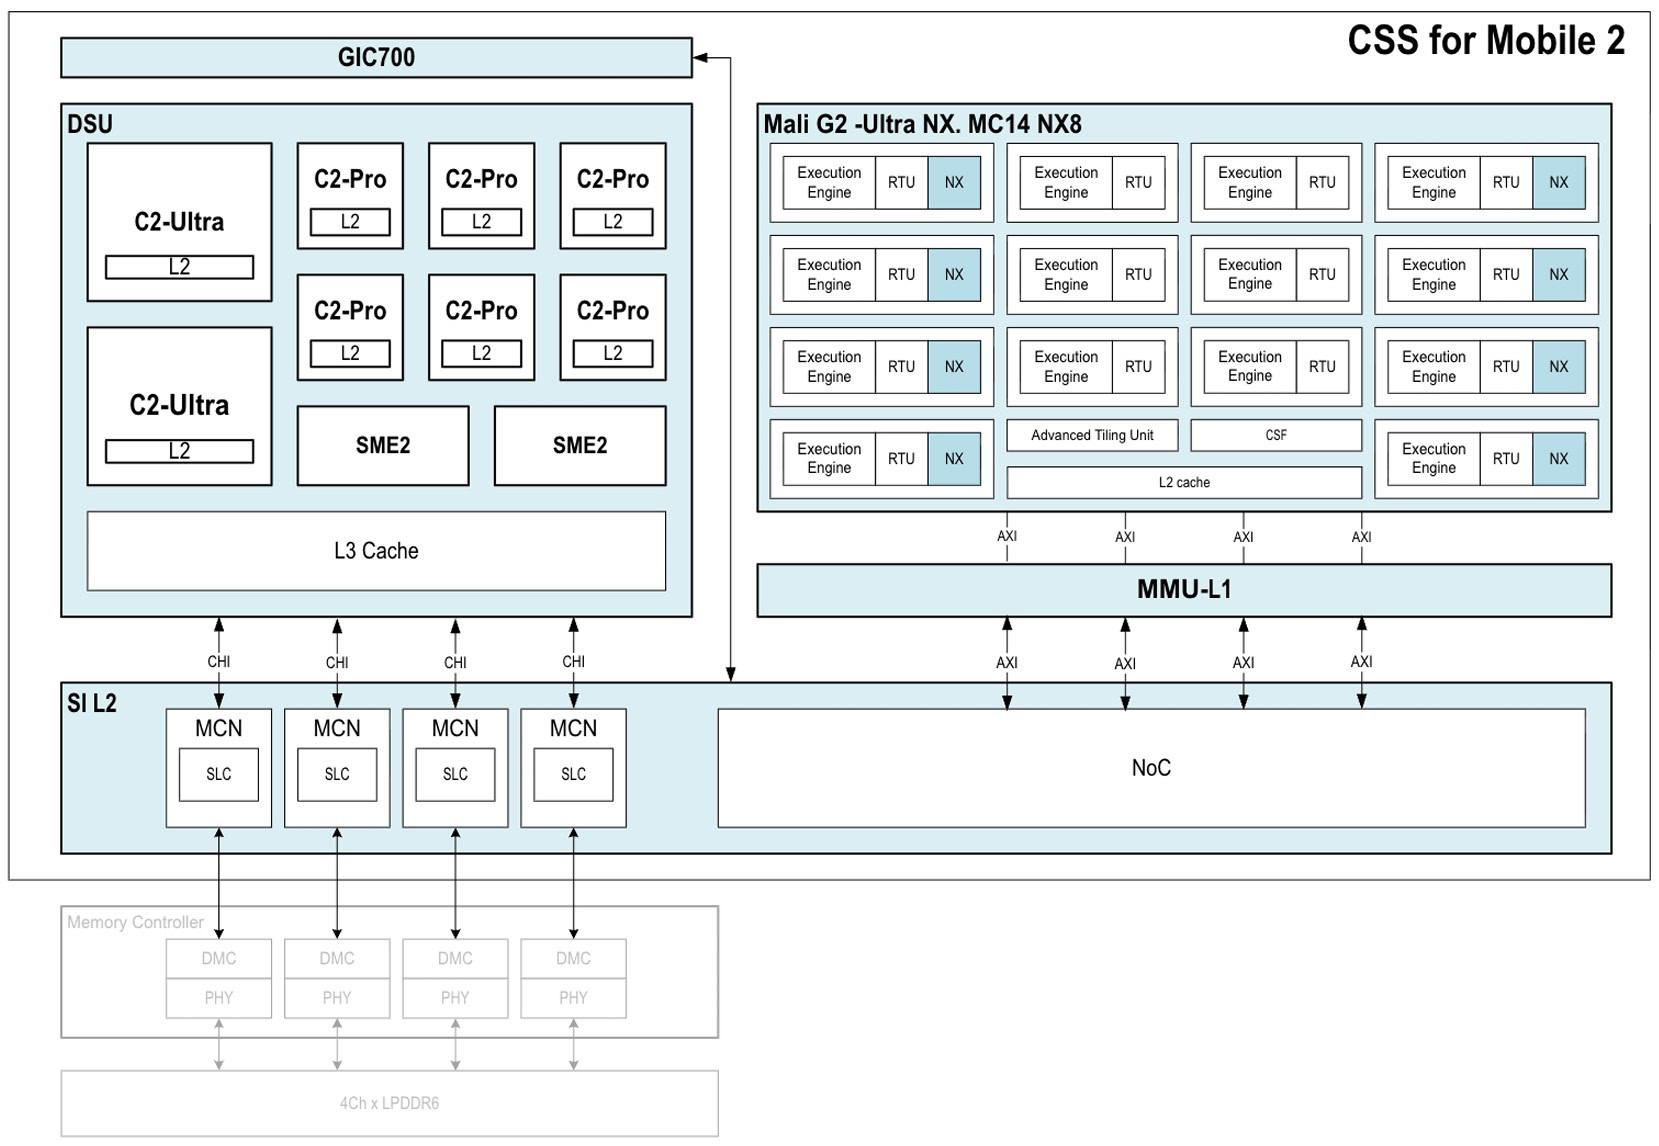
Разнообразие конфигураций Mali стало еще шире и заметно усложнилось. Линейка Ultra по-прежнему предлагает самое высокое количество ядер — от 10 до 24 шейдерных ядер, что позволяет масштабировать производительность до уровня ноутбуков. К бренду Ultra добавляется приставка NX, если процессор содержит как минимум одно ядро NX; также существует возможность включения поддержки трассировки лучей, хотя это не влияет на схему именования.
Средний сегмент G2-Premium включает от шести до девяти шейдерных ядер с опциональным брендингом NX при наличии хотя бы одного такого ядра и опциональной поддержкой трассировки лучей. Наконец, бюджетный сегмент Pro предназначен для конфигураций с пятью ядрами и менее, также с возможностью добавления ИИ-ускорения. Всего существует пять групп конфигураций: G2-Ultra NX, G2-Premium NX, G2-Premium, G2-Pro NX и G2-Pro, внутри которых возможны дополнительные вариации.
Вероятно, для премиальных смартфонов будут использоваться версии с примерно 12 ядрами, очевидно, с половиной ядер NX и поддержкой трассировки лучей. Внедрение «фейковых кадров» на мобильные устройства вызывает споры, и существует риск, что разработчики начнут полагаться на ИИ для компенсации отсутствия традиционной оптимизации, пытаясь быстрее вывести продукты на рынок. Тем не менее, мобильный сегмент может выиграть от ИИ-рендеринга гораздо больше, чем десктопы или консоли, из-за более строгих ограничений по энергопотреблению при высококачественном рендеринге. Если заявления Arm о том, что игры будут выглядеть так же хорошо, работая при этом более плавно, а время автономной работы увеличится, окажутся правдой, то это станет серьезным шагом вперед.
Особое внимание стоит уделить архитектурным особенностям, которые позволяют GPU G2-Ultra работать с тяжелыми задачами. Увеличение объема регистров до 128 на ворп стало ключевым фактором, позволившим избежать «вытеснения» (spilling) данных в DRAM. Именно этот аппаратный запас прочности делает возможным корректный запуск современных графических технологий, таких как Unreal Engine 5 Lumen и Nanite, без просадок производительности, которые ранее были неизбежны при нехватке внутренней памяти шейдерных блоков.
В части технологий трассировки лучей, представленных в третьем поколении блоков Arm, значимый вклад в эффективность вносит новый метод представления геометрии треугольников. Используя общие ребра (shared edges), архитектура минимизирует дублирование данных, что позволяет размещать в кэше значительно больше геометрических примитивов, чем раньше. Это прямо влияет на пропускную способность и общую энергоэффективность графического конвейера.
Интеграция нейронного ускорителя NX также имеет свои нюансы в плане системной архитектуры. Важной особенностью является то, что этот блок работает на частоте, которая может достигать двукратного значения от основной частоты GPU, при этом сохраняя идентичное напряжение питания. Разделение памяти с остальной частью подсистемы GPU обеспечивает необходимую когерентность данных, что критически важно для передачи векторов движения и карт глубины без возникновения задержек, которые могли бы критически повлиять на качество итогового изображения при генерации промежуточных кадров.
Что касается программной реализации, стоит подчеркнуть, что Arm делает ставку на экосистему разработчиков, предоставляя поддержку Vulkan ML. Это не просто маркетинговый ход: возможность хранения и поставки индивидуальных весов нейронных моделей вместе с конкретной игрой дает студиям гибкость в настройке качества апскейлинга. В условиях жестких мобильных энергобюджетов это решение может стать инструментом для продления времени автономной работы устройства, предоставляя пользователю выбор между классическим рендерингом и ИИ-ускорением, которое минимизирует нагрузку на GPU при сохранении высокой плавности картинки.








