Современные локальные языковые модели значительно прогрессировали и во многих ежедневных задачах способны заменить облачные аналоги. Однако при необходимости глубоких рассуждений или работе с большими объемами данных они все еще уступают облачным решениям. Чтобы не переключаться между разными сервисами в процессе работы, была разработана гибридная система с интеграцией облачного резервного варианта.
Компоненты гибридной ИИ-архитектуры
Система базируется на трех ключевых элементах. Первый — это локальная среда: в данном случае используется Ollama с моделями Qwen 3.x или Gemma 4, запускаемыми на видеокарте 5070 Ti. Второй компонент — сервис Claude, к которому происходит обращение при нехватке вычислительных мощностей или ограниченности контекстного окна локального ПК. Третий слой служит связующим звеном, позволяющим управлять обоими типами моделей.
Важно отметить, что переключение между локальной и облачной моделями реализовано вручную, а не автоматически. Это продиктовано соображениями безопасности и конфиденциальности, так как пользователь хочет самостоятельно контролировать, какая информация передается сторонним сервисам. Для автоматизации процесса можно настроить маршрутизатор, который будет направлять запросы к Claude на основе длины промпта или заполнения контекстного окна.
Преимущества локального использования моделей
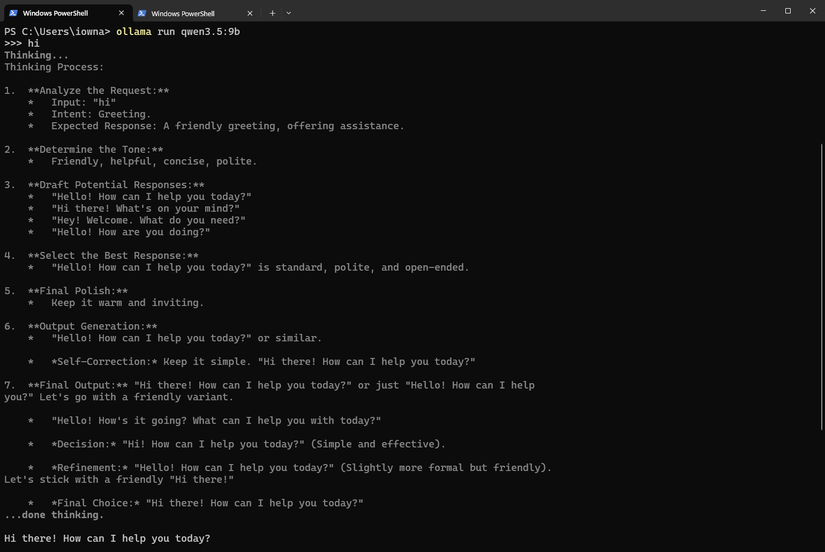
Большая часть рабочих процессов, таких как обработка данных, краткое резюмирование документации или генерация небольших фрагментов кода, легко выполняется на локальном оборудовании. Особую эффективность показала модель Qwen 3.8. Несмотря на критику за излишнюю «задумчивость», именно эта особенность позволяет модели демонстрировать высокие результаты при крайне малом размере.
Локальный подход обеспечивает ряд практических выгод:
- Конфиденциальность: все данные остаются на устройстве.
- Отсутствие затрат: за исключением расходов на электроэнергию, запуск модели не требует оплаты API или подписки.
- Автономность: система продолжает функционировать при отсутствии интернет-соединения.
При тестировании Qwen 3.8 на симулированных медицинских данных, реальных налоговых документах и рабочих материалах модель показала высокую точность, редко допуская галлюцинации или ошибки при извлечении значений из таблиц.
Ограничения локальных моделей и роль облачных решений
Несмотря на развитие технологий, существуют задачи, с которыми модели параметрами около 27 млрд не справляются. К ним относятся проекты, требующие исключительно длинного контекстного окна, глубоких рассуждений или масштабного рефакторинга кода. В таких случаях локальные модели либо начинают допускать критические ошибки, либо полностью исчерпывают доступную память. Для подобных сложных работ требуется использовать мощные облачные решения, такие как Claude.
Инструкция по настройке гибридной системы
Для создания подобной конфигурации потребуется следующее ПО:
- Ollama или Llama.cpp;
- локальная модель (например, из линейки Qwen 3.x или Gemma 4);
- интерфейс, такой как Jan;
- API-ключ от выбранного облачного провайдера.
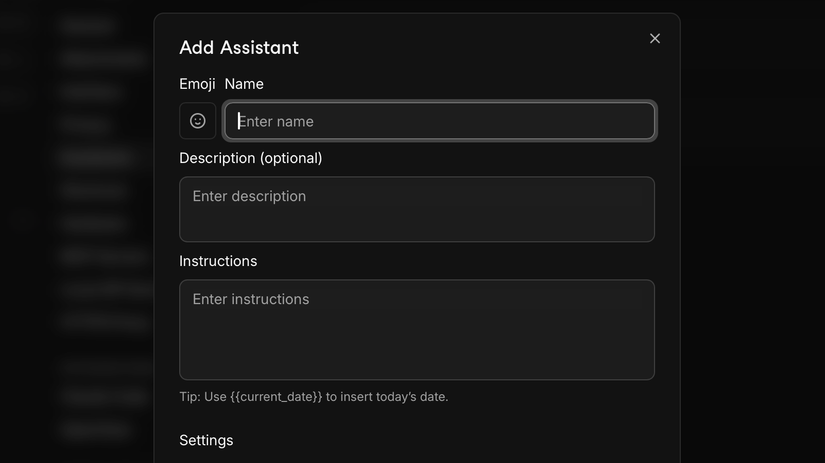
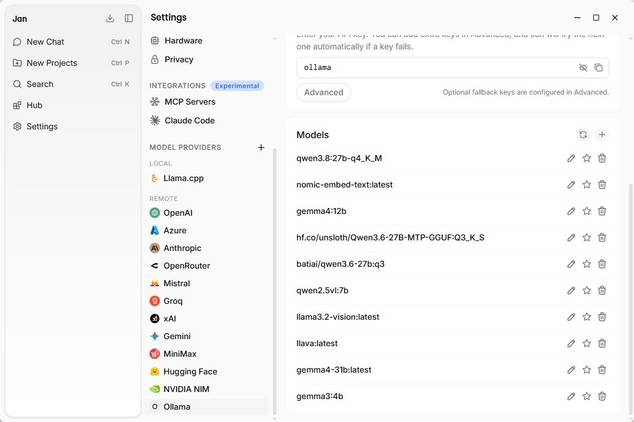
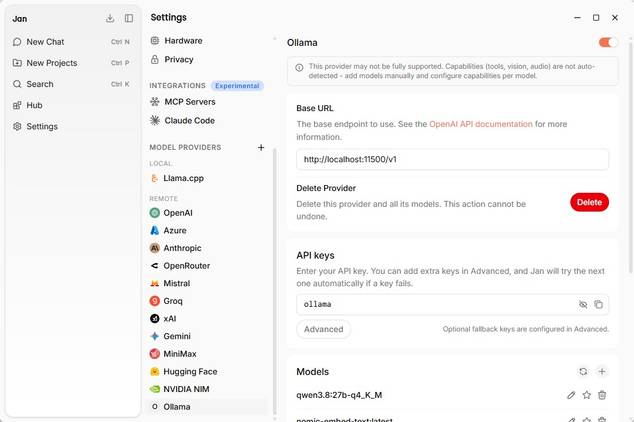
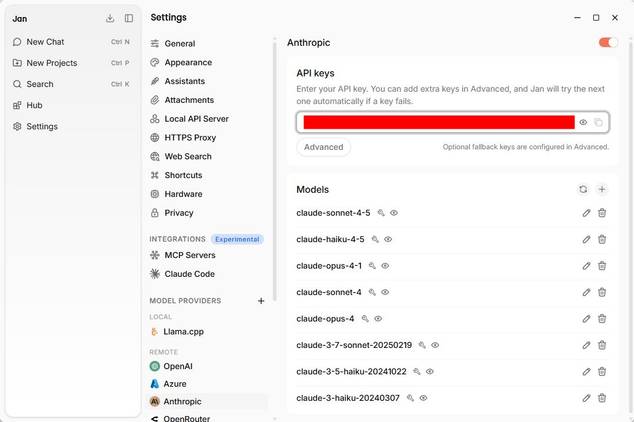
Первым этапом необходимо установить Ollama и загрузить выбранную модель. Затем в приложении Jan нужно указать адрес локального экземпляра Ollama. При настройке важно добавить /v1 к адресу: вместо http://localhost:11434 следует вводить http://localhost:11434/v1, иначе программа не сможет считать данные. После успешного подключения остается добавить API-ключ Anthropic в настройках Jan. При использовании платных API рекомендуется установить лимит ежемесячных расходов в консоли Anthropic, чтобы избежать неожиданных счетов за интенсивные сессии рассуждений.
Почему ручное управление важнее автоматики
Хотя идея автоматической маршрутизации запросов к облачной модели выглядит привлекательно, в текущей конфигурации намеренно выбран ручной путь управления. Это связано с тем, что API-доступ через сторонние приложения, такие как Jan, технически отличается от стандартной подписки, используемой в браузере или официальном приложении Claude. Установка «связующего слоя», работающего в ручном режиме, дает пользователю полный контроль над тем, какие именно данные отправляются на внешние серверы. Это критически важный аспект безопасности для профессиональной среды, где утечка конфиденциальных документов или фрагментов проприетарного кода недопустима.
Если же приоритетом является удобство, а не строгий контроль, можно настроить роутер, который будет делегировать выполнение задач облаку по заданным критериям: например, при превышении определенного количества токенов в промпте, при достижении лимита локального контекстного окна или при обнаружении специфических маркеров сложности задачи.
Экономика использования локальных LLM
Один из часто упускаемых из виду плюсов локального подхода — это отсутствие скрытых издержек. При работе с облачными API каждый запрос к модели тарифицируется, что делает массовые операции или итеративный поиск решений ощутимо дорогими. В случае с локальным запуском модели (например, при 15 последовательных запросах к Qwen 3.8 для уточнения данных) вы не платите ничего, кроме стоимости потребленной электроэнергии. Это позволяет проводить «мозговые штурмы» с ИИ, не задумываясь о расходе бюджета на API-токены.
Пределы возможностей 27-миллиардных моделей
Необходимо понимать, что существует четкая граница компетенций. Модель с 27 миллиардами параметров, работающая на потребительской видеокарте уровня 5070 Ti, физически ограничена объемом своих «знаний о мире». Она не может конкурировать с облачными гигантами, обладающими триллионами параметров, когда вопрос касается глубины эрудиции или обладания специфическими узкопрофильными данными. В таких сценариях попытка заставить локальную модель работать «на пределе» приводит к тому, что она начинает либо катастрофически галлюцинировать, либо просто останавливает генерацию из-за исчерпания контекстного окна. В этих ситуациях обращение к облаку становится необходимостью, а не выбором, однако важно сохранять осторожность и «рациональность» в выборе того, что именно вы отправляете через API, так как каждый такой запрос является платным.
Эволюция локального ИИ
Сравнение текущего состояния технологий с ситуацией двухлетней давности показывает стремительный прогресс. Еще недавно локальные агенты для написания кода разочаровывали своими результатами, выдавая неработоспособные фрагменты. Сегодня же связка локальной модели и современного оборудования позволяет генерировать чистый, аккуратный код на Python, который можно сразу интегрировать в проект. Кроме того, локальные модели стали гораздо увереннее справляться с задачами компьютерного зрения: например, описывать содержимое скриншотов или извлекать структурированную информацию из сложных технических спецификаций. Несмотря на то что для самых тяжелых проблем все еще требуется мощь Claude, список задач, которые считались «неподъемными» для локального ПК, сокращается с каждым месяцем.