ASUS ExpertCenter Pro ET900N G3: первый взгляд и конструктивные особенности
ASUS ExpertCenter Pro ET900N G3 — это вторая протестированная нами станция на базе DGX Station GB300, однако первая, попавшая к нам в лабораторию для непосредственного тестирования (работа с MSI XpertStation WS300 велась удаленно). Аппаратная часть устройства полностью идентична той, что установлена в MSI WS300: это суперчип NVIDIA Grace Blackwell Ultra Desktop с 72 ядрами Grace, графическим процессором B300, 252 ГБ памяти HBM3e, 496 ГБ LPDDR5X и сетевым адаптером ConnectX-8 SuperNIC с двумя портами 400GbE.
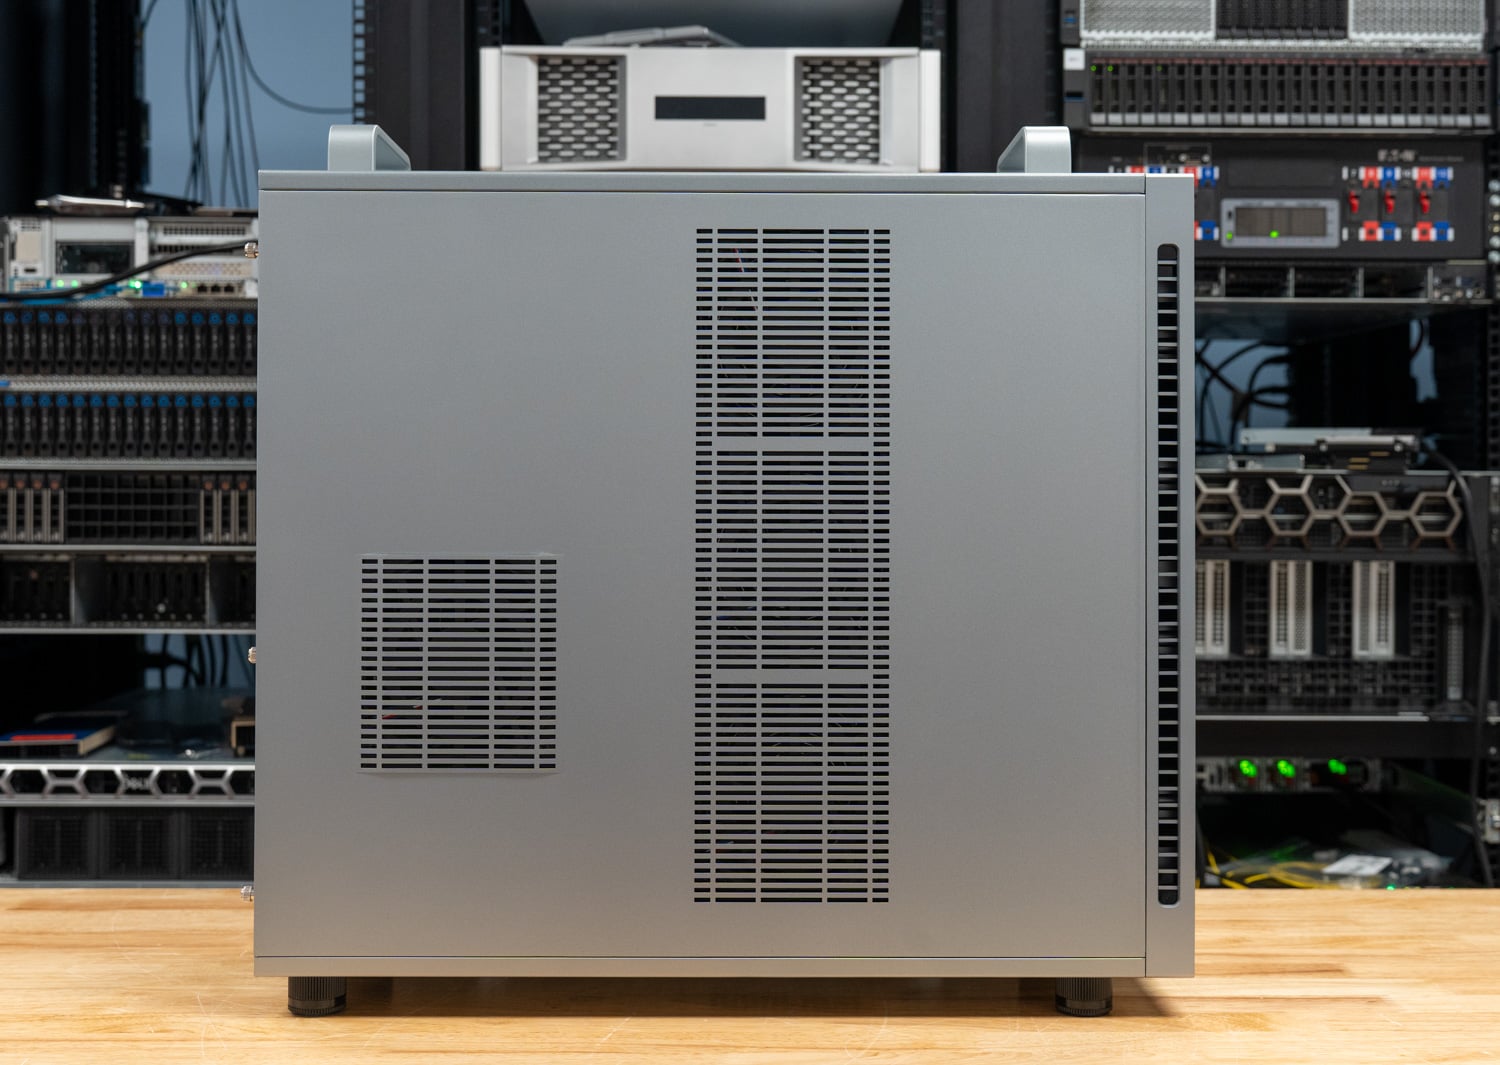
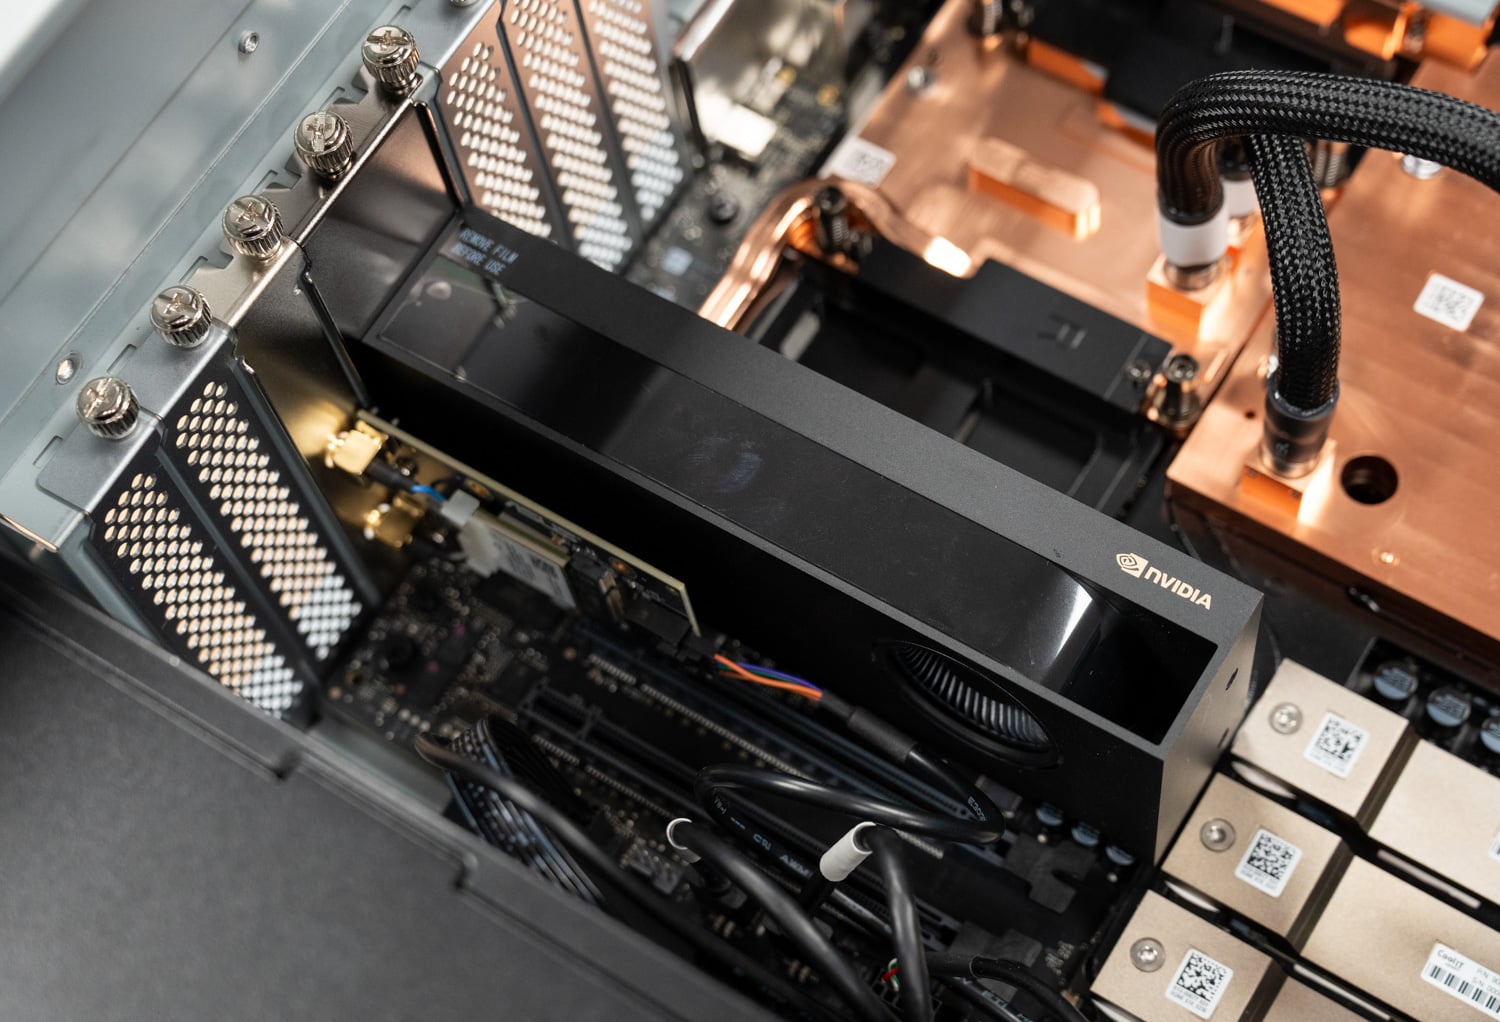
ASUS разместила эту платформу в корпусе типа «башня», адаптированном для размещения под столом, добавив ряд уникальных решений, отсутствующих в WS300: две рукоятки для переноски на верхней панели, специальный вентилятор, направленный на отсеки оптики ConnectX-8, и блок питания мощностью 1600 Вт с сертификатом 80 PLUS Titanium. Для проведения недельных испытаний, включающих бенчмаркинг, фотосъемку и физическую проверку компонентов, в систему была установлена видеокарта RTX PRO 2000.
В то время как обзоры аппаратной платформы, включая спецификации B300, Grace, NVLink-C2C, технологии MIG и предназначение DGX Station, уже освещены в материале по WS300, данный обзор фокусируется на конструкторских решениях ASUS и стабильности производительности относительно первой протестированной нами башни на базе GB300.
Дизайн и конструкция
ASUS оформила ET900N G3 как бизнес-рабочую станцию: корпус из матового серебристого металла дополнен темной сетчатой передней панелью, хромированными элементами в верхней части и на основании, а также логотипом ASUS в нижней части фасада. Габариты устройства определяются архитектурой платформы и составляют 584 x 232 x 565 мм. Это делает станцию чуть выше, но уже, чем WS300 (529 мм в высоту, 570 мм в глубину и 246 мм в ширину). Вес в 27 кг исключает случайное перемещение, поэтому ASUS добавила две металлические рукоятки на верхнюю грань (спереди и сзади), позволяющие вдвоем переносить систему на стол или тележку, не рискуя повредить панели.
На передней панели вертикально расположены кнопка питания, два порта USB Type-A (10 Гбит/с), два порта USB Type-C (10 Гбит/с), порт USB 2.0, а также отдельные разъемы для микрофона и наушников. Боковая панель представляет собой большую вентилируемую пластину с перфорированным сектором для забора воздуха к радиатору и меньшей решеткой напротив системных вентиляторов. Окна и подсветка отсутствуют, что соответствует целевой аудитории.
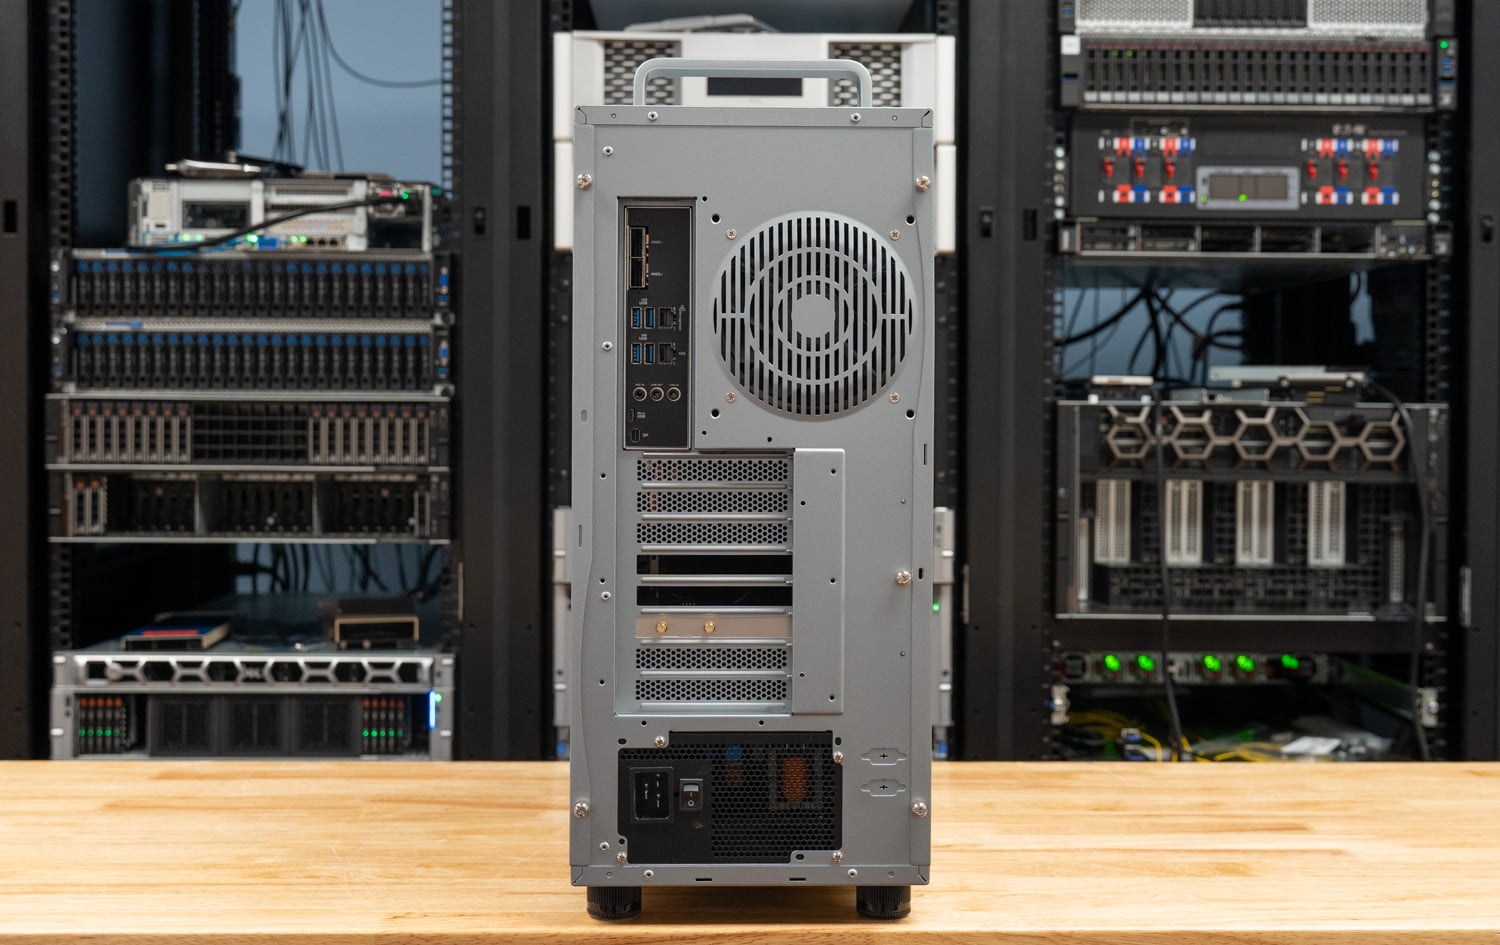
Задняя панель разделяет порты ввода-вывода рабочей станции и серверные интерфейсы. Верхний блок включает четыре порта USB Type-A (10 Гбит/с), разъемы 10GbE и 1GbE RJ45, три аудиоразъема, консольный порт BMC (Micro-USB) и Mini DisplayPort для настройки через BMC. Выше расположены два отсека QSFP112 для ConnectX-8, вытяжной вентилятор, три слота расширения и разъем питания C19 в нижней части. Mini DisplayPort, как и в случае с WS300, служит лишь для диагностики и первоначальной настройки; для повседневной работы требуется установка карты RTX PRO.
Внутреннее устройство
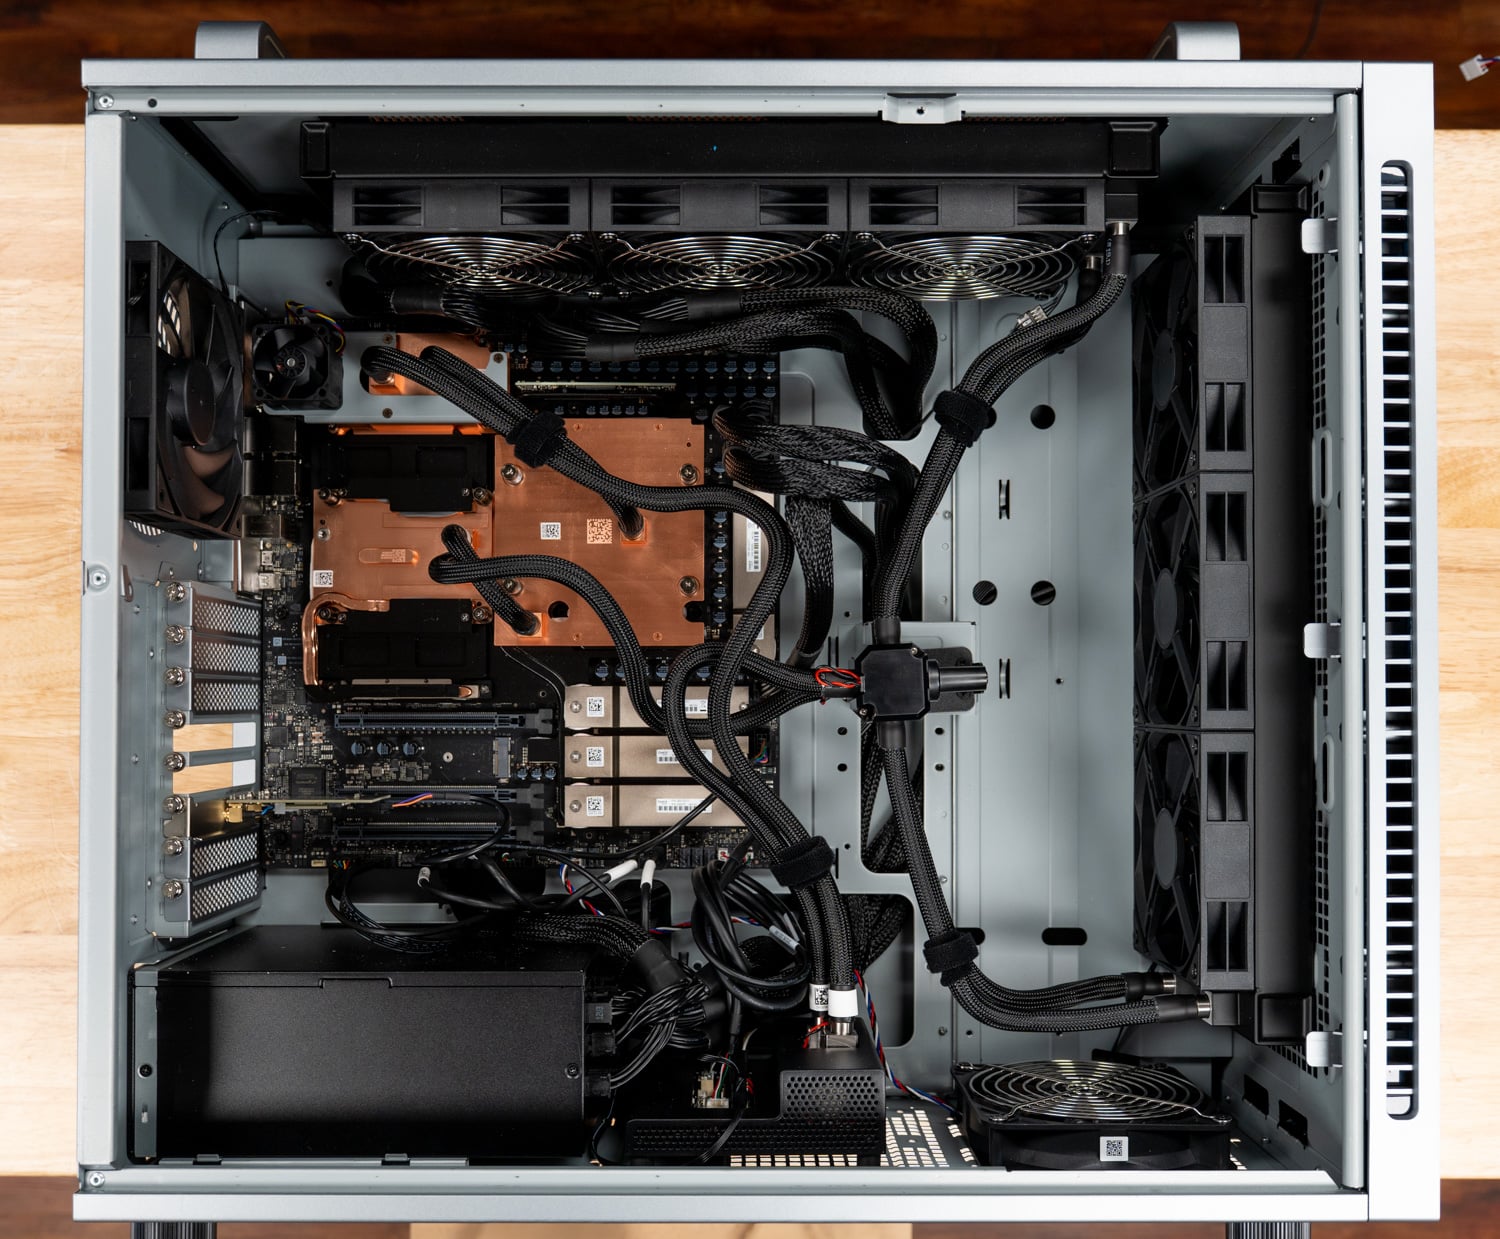
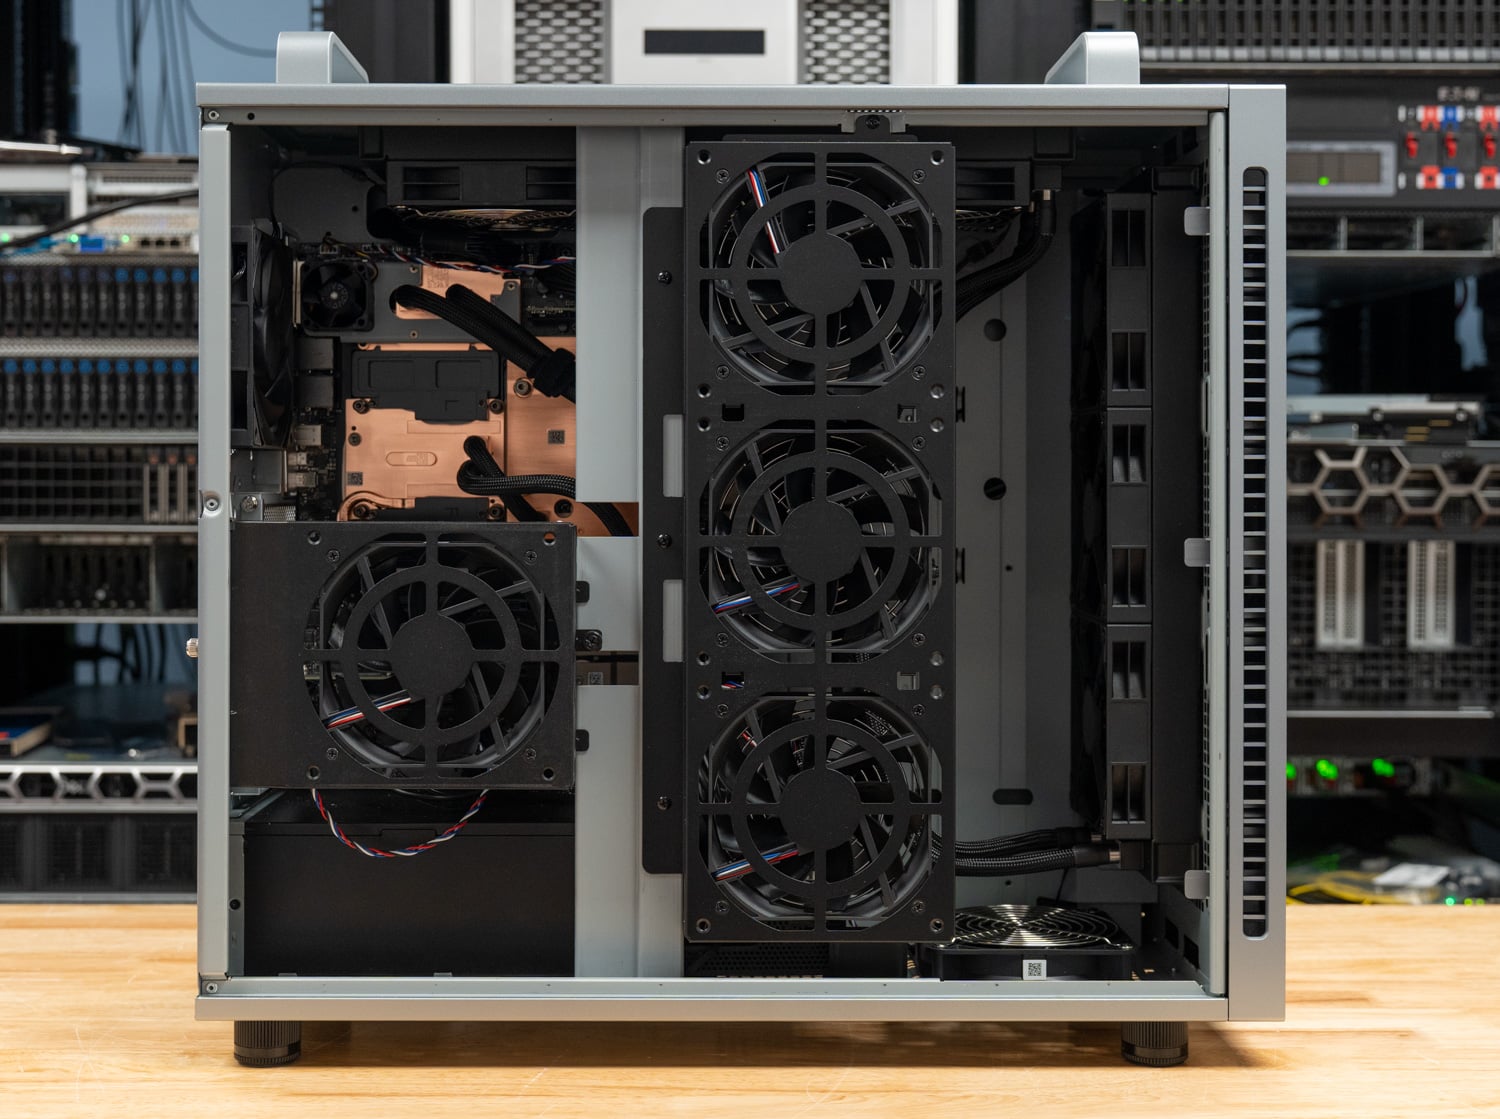
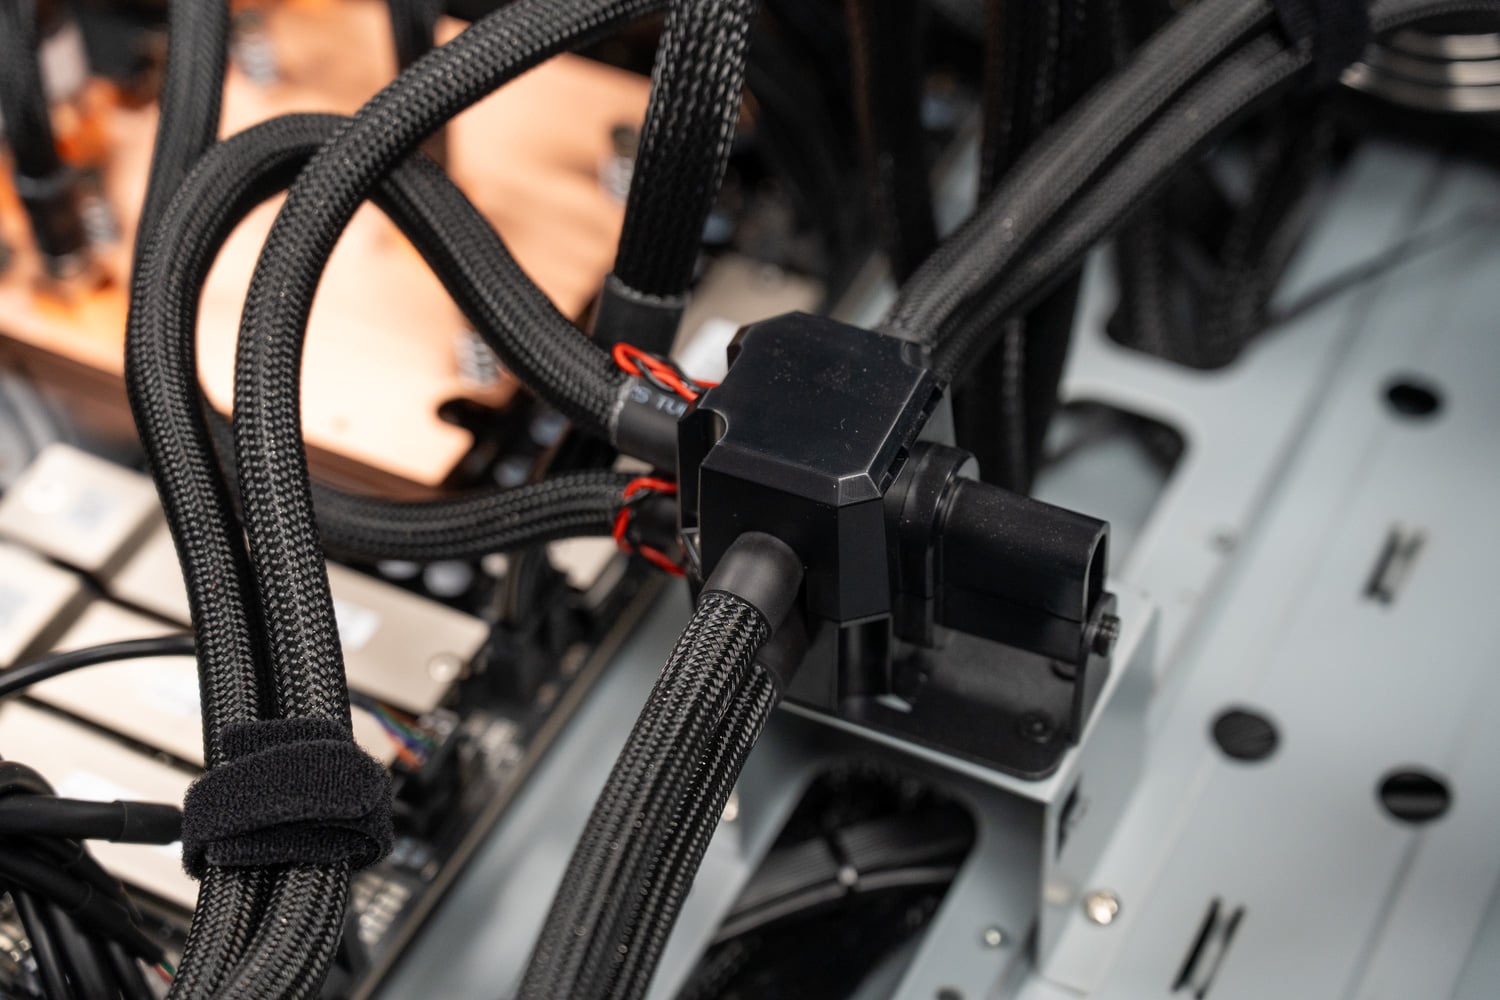
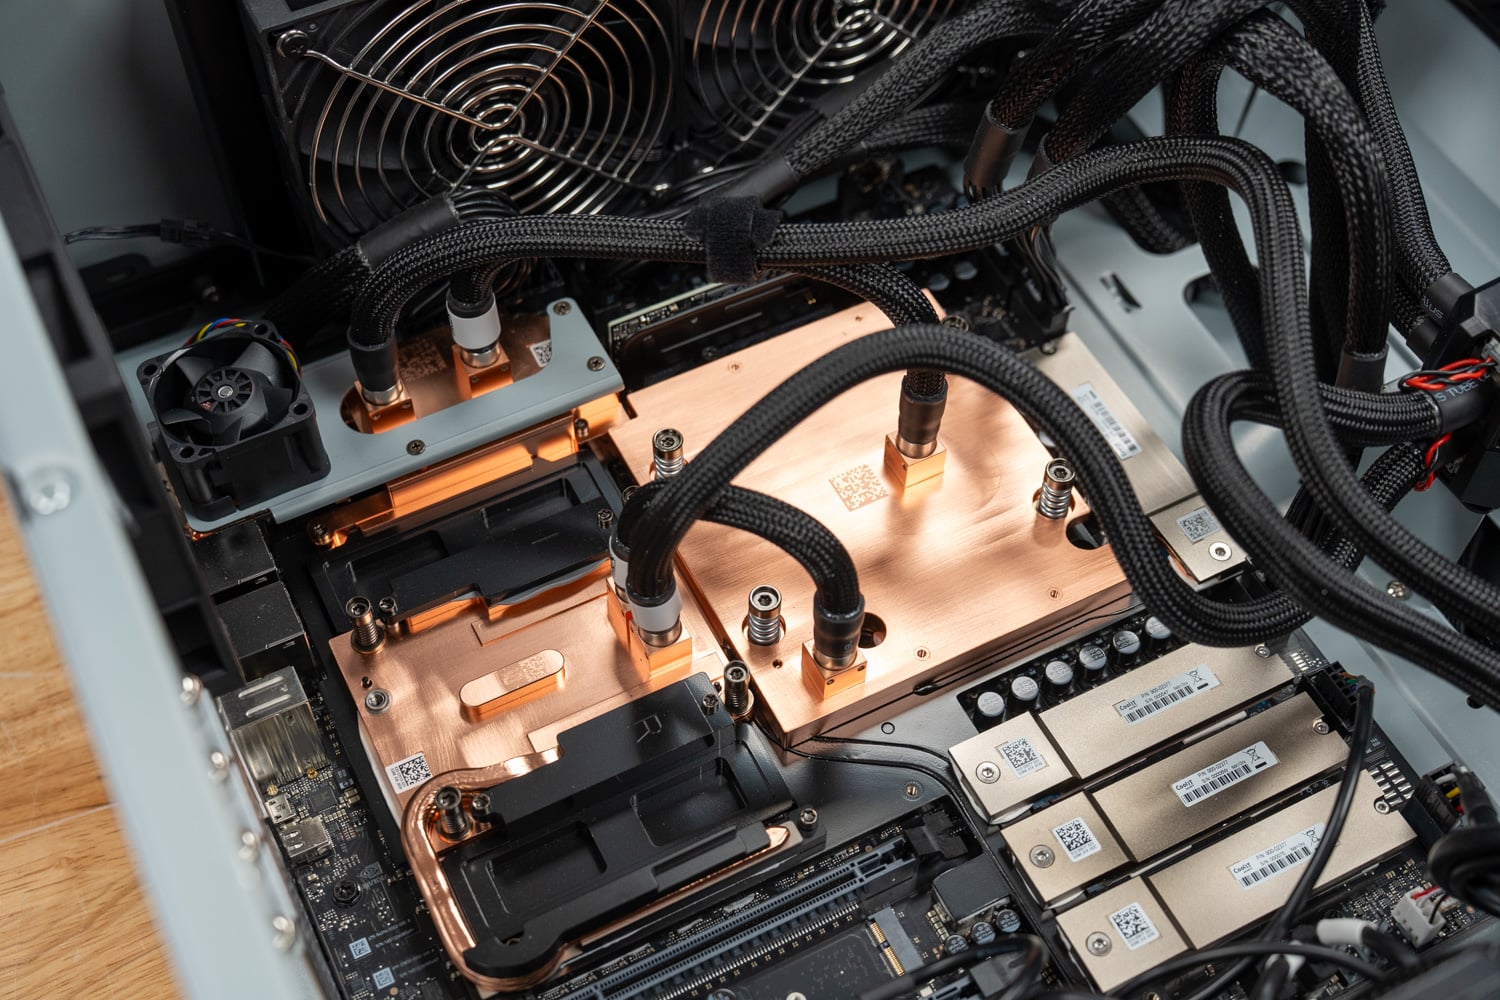
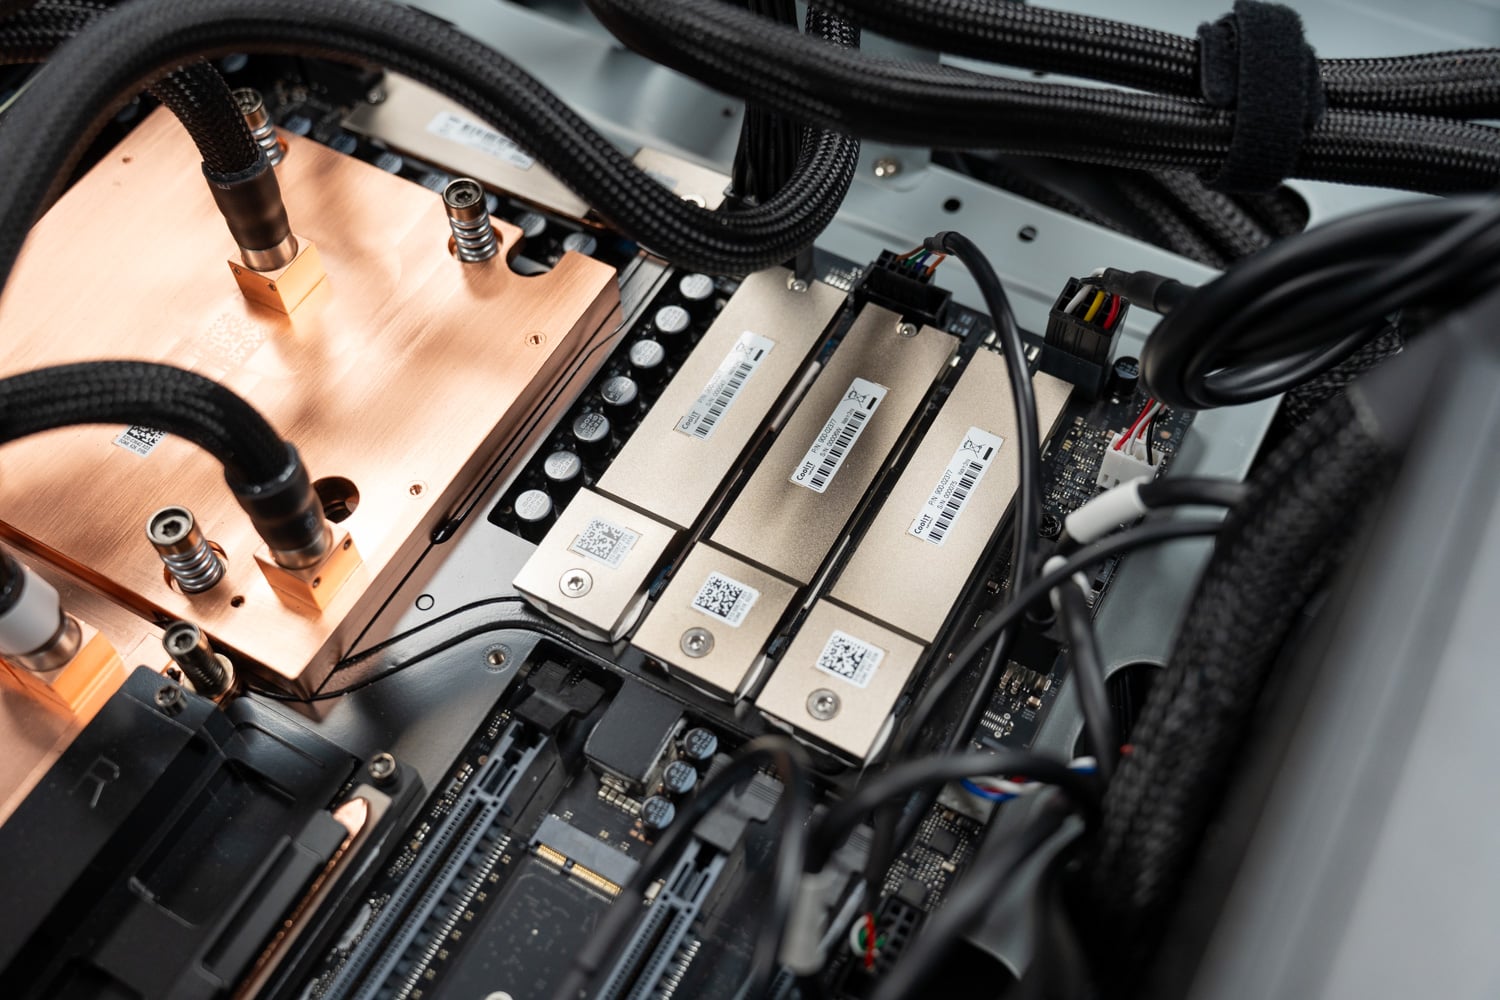
Внутренняя компоновка ET900N G3 близка к WS300, что закономерно из-за использования единой базовой платы NVIDIA. Суперчип GB300 охлаждается медным водоблоком, расположенным слева; рядом с ним находятся модули SOCAMM, а под третьим блоком — адаптер ConnectX-8. Оплетенные шланги соединяют водоблоки с распределительным коллектором на поперечине корпуса, откуда жидкость подается к радиаторам. Под суперчипом размещены три полноразмерных слота PCIe, в нижнем переднем углу находится блок питания, а кабели спрятаны под металлическим кожухом. Система охлаждения включает два радиатора (вертикальный за передней сеткой и верхний горизонтальный) с вентиляторами, а также тыловой корпусной вентилятор.
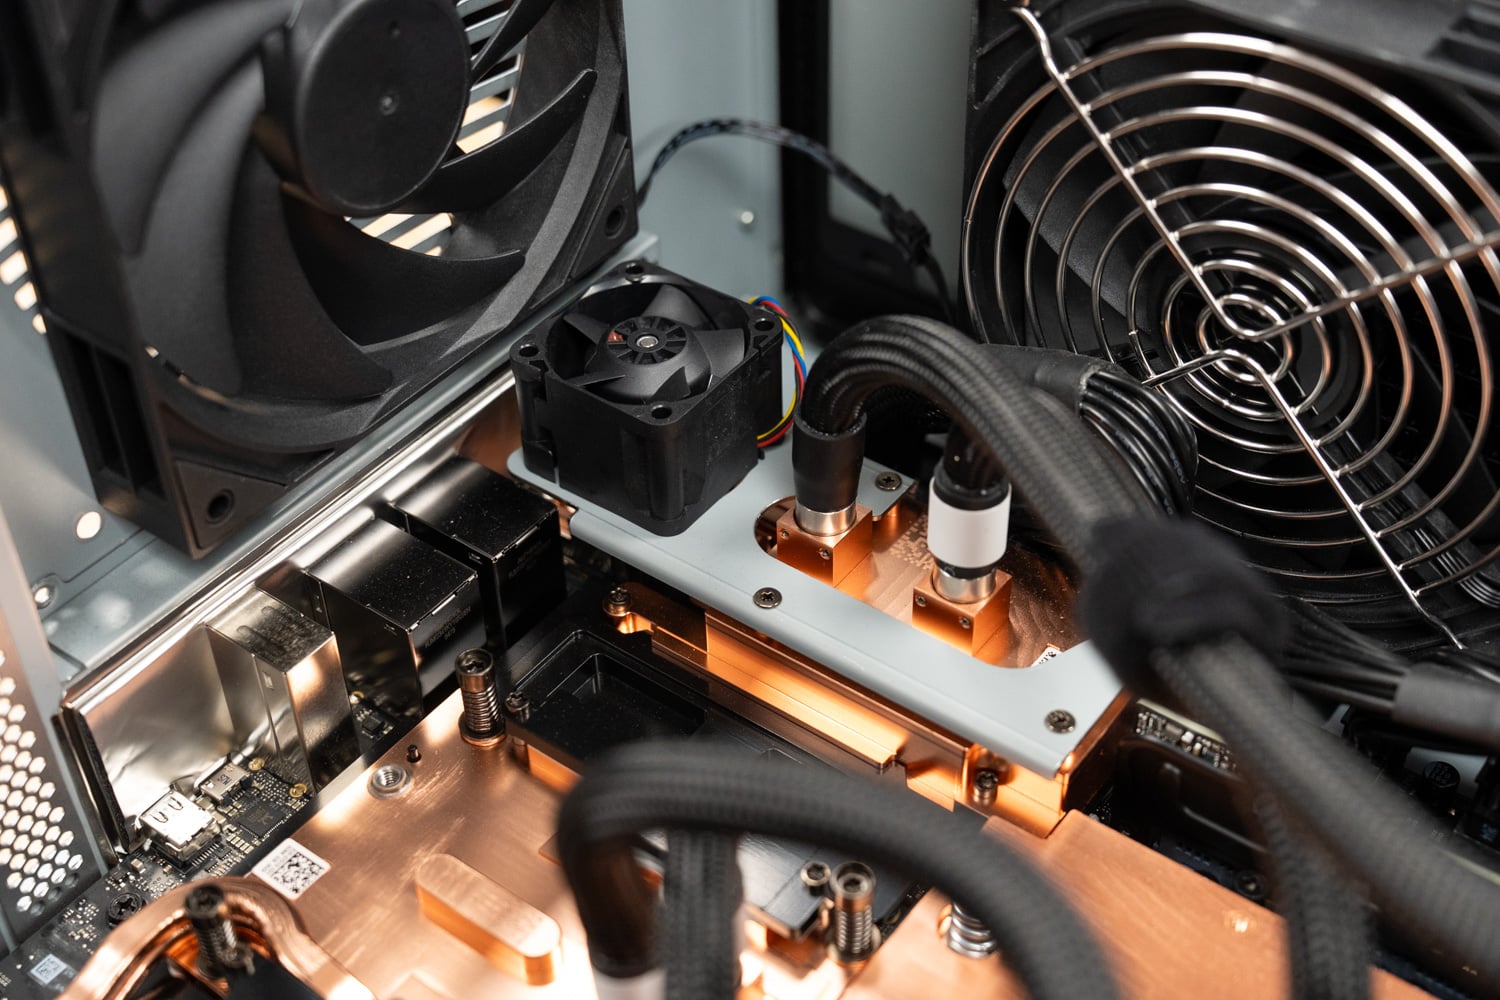
Вентилятор для оптических модулей
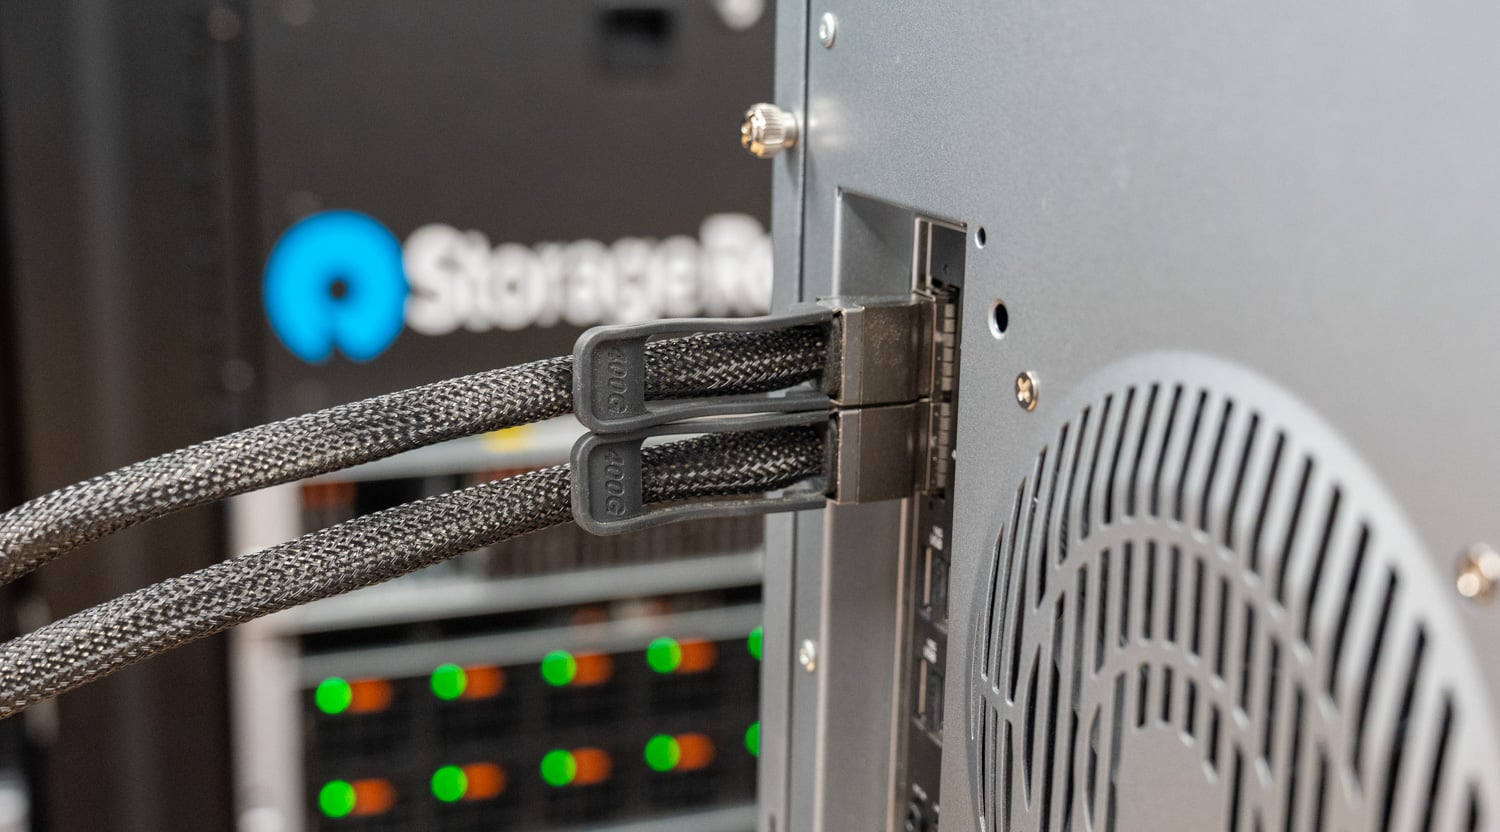
Уникальным элементом системы, отсутствующим в WS300, является небольшой вентилятор, установленный над водоблоком ConnectX-8 и направленный непосредственно на отсеки QSFP112. Жидкостный контур охлаждает сам чип SuperNIC, однако оптические трансиверы 400G генерируют значительный объем тепла, а их металлические отсеки контактируют с водоблоком лишь частично. Учитывая, что при длительных нагрузках адаптер ConnectX-8 и оптика могут сильно нагреваться, наличие выделенного воздушного потока является важным преимуществом для тех, кто планирует эксплуатировать ET900N G3 в оптоволоконных сетях в течение долгого времени. При использовании медных кабелей DAC (Direct Attach Copper), с помощью которых мы соединяли систему для кластерного анализа, потребность в этом вентиляторе снижается.
Система хранения, расширение и питание
ASUS поставляет ET900N G3 с одним NVMe-накопителем объемом 2 ТБ для операционной системы и программного стека NVIDIA, который устанавливается в один из двух слотов M.2 2280, подключенных к процессору Grace через интерфейс PCIe 5.0 x4. Вторая пара слотов, подключенная к интегрированному PCIe-коммутатору ConnectX-8, поставляется пустой.
Наш тестовый образец был укомплектован графической картой NVIDIA RTX PRO 2000 Blackwell в слоте PCIe 5.0 x16, что соответствует одной из конфигураций, заявленных ASUS. Карта обеспечивает вывод изображения, не потребляя значительной доли мощности системы GB300, и, по заявлению производителя, шасси поддерживает установку до одной карты RTX PRO Blackwell. Для проведения тестов производительности мы извлекли RTX PRO 2000, чтобы суперчип получил доступ ко всему бюджету мощности ускорителя (аналогично условиям тестирования WS300). Мы не проводили испытания с высокопроизводительными картами RTX PRO в данном корпусе; влияние таких конфигураций на общий бюджет мощности будет рассмотрено в предстоящем обзоре GB300 Station.
Система оснащена блоком питания стандарта ATX мощностью 1600 Вт с сертификатом 80 PLUS Titanium, что выше уровня Platinum, используемого в модели WS300. Стандарт Titanium требует 94% КПД при 50% нагрузке в сети 115 В (против 92% у Platinum) и является единственным уровнем, устанавливающим требования к КПД при 10% нагрузке. Таким образом, ET900N G3 должен потреблять на несколько десятков ватт меньше при полной нагрузке GB300. Бюджет мощности является общим: Grace, B300, насосы СЖО, вентиляторы, накопители и любые карты RTX PRO питаются от этих 1600 Вт. Служба NVIDIA vsloshd динамически перераспределяет лимиты между суперчипом и дискретным графическим ускорителем в зависимости от их текущего энергопотребления без жесткой фиксации для каждого из них. Политика управления питанием аналогична модели WS300. Для установки в Северной Америке по-прежнему требуется отдельная электрическая цепь на 20 А.
Сетевые возможности
Два порта QSFP112 контроллера ConnectX-8 служат для подключения ET900N G3 к остальной инфраструктуре: системам хранения данных, второй станции DGX или кластерной фабрике. В нашей лаборатории эти порты уже задействованы: ET900N G3 подключен ко второй станции GB300 через кабели 400G DAC для проведения глубокого анализа кластерного инференса, результаты которого будут опубликованы отдельно. Порт Marvell 10GbE предназначен для обычного трафика хоста, а порт Realtek 1GbE выделен для нужд BMC.
Примечания к тестированию
Все результаты в обзоре получены на предоставленном ASUS экземпляре с конфигурацией памяти 252 ГБ HBM3e и 496 ГБ LPDDR5X. Тестирование проводилось без установленной карты RTX PRO, чтобы суперчип GB300 имел полный бюджет мощности ускорителя, что соответствует условиям испытаний WS300. Программный стек, конфигурация vLLM, профили рабочих нагрузок и параметры параллелизма полностью идентичны тем, что использовались для WS300, что позволяет напрямую сравнивать две системы. Данный обзор сфокусирован исключительно на производительности; замеры энергопотребления и температурного режима на этом устройстве не проводились.
Мы использовали два профиля «живого» инференса vLLM, применяемых нами для всех локальных ИИ-систем: сбалансированная нагрузка (512 входных и 512 выходных токенов) и нагрузка с приоритетом префилла (8192 входных и 1024 выходных токена) с масштабированием от 1 до 128 параллельных потоков. Для моделей масштаба frontier мы проводим сравнение с сервером Dell PowerEdge XE7740, оснащенным двумя или четырьмя картами RTX PRO 6000 — ближайшим альтернативным решением в рамках одного шасси. Для менее требовательных моделей сравнение проводится с одной картой RTX PRO 6000 в том же XE7740, одной H200 NVL в Dell PowerEdge R770 и GB10 DGX Spark (в лице Acer Veriton GN100, использовавшегося в обзоре WS300). Значения для ET900N G3 приведены из журналов выполнения тестов; показатели сравниваемых систем взяты из наших графиков.
Производительность инференса: модели Frontier на когерентном пуле памяти
Основное назначение GB300 — запуск моделей, выходящих за пределы лимита HBM3e (252 ГБ) чипа B300. Мы начали тестирование с четырех чекпоинтов: DeepSeek V4 Flash и MiniMax M2.7 помещаются в HBM с запасом; MiniMax M3 едва помещается, вытесняя часть экспертов в память Grace; GLM-5.2 разгружает примерно половину весов. На графиках представлены данные по ближайшей альтернативе: паре карт RTX PRO 6000 в PowerEdge XE7740 с выгрузкой экспертов в хост-память при необходимости.
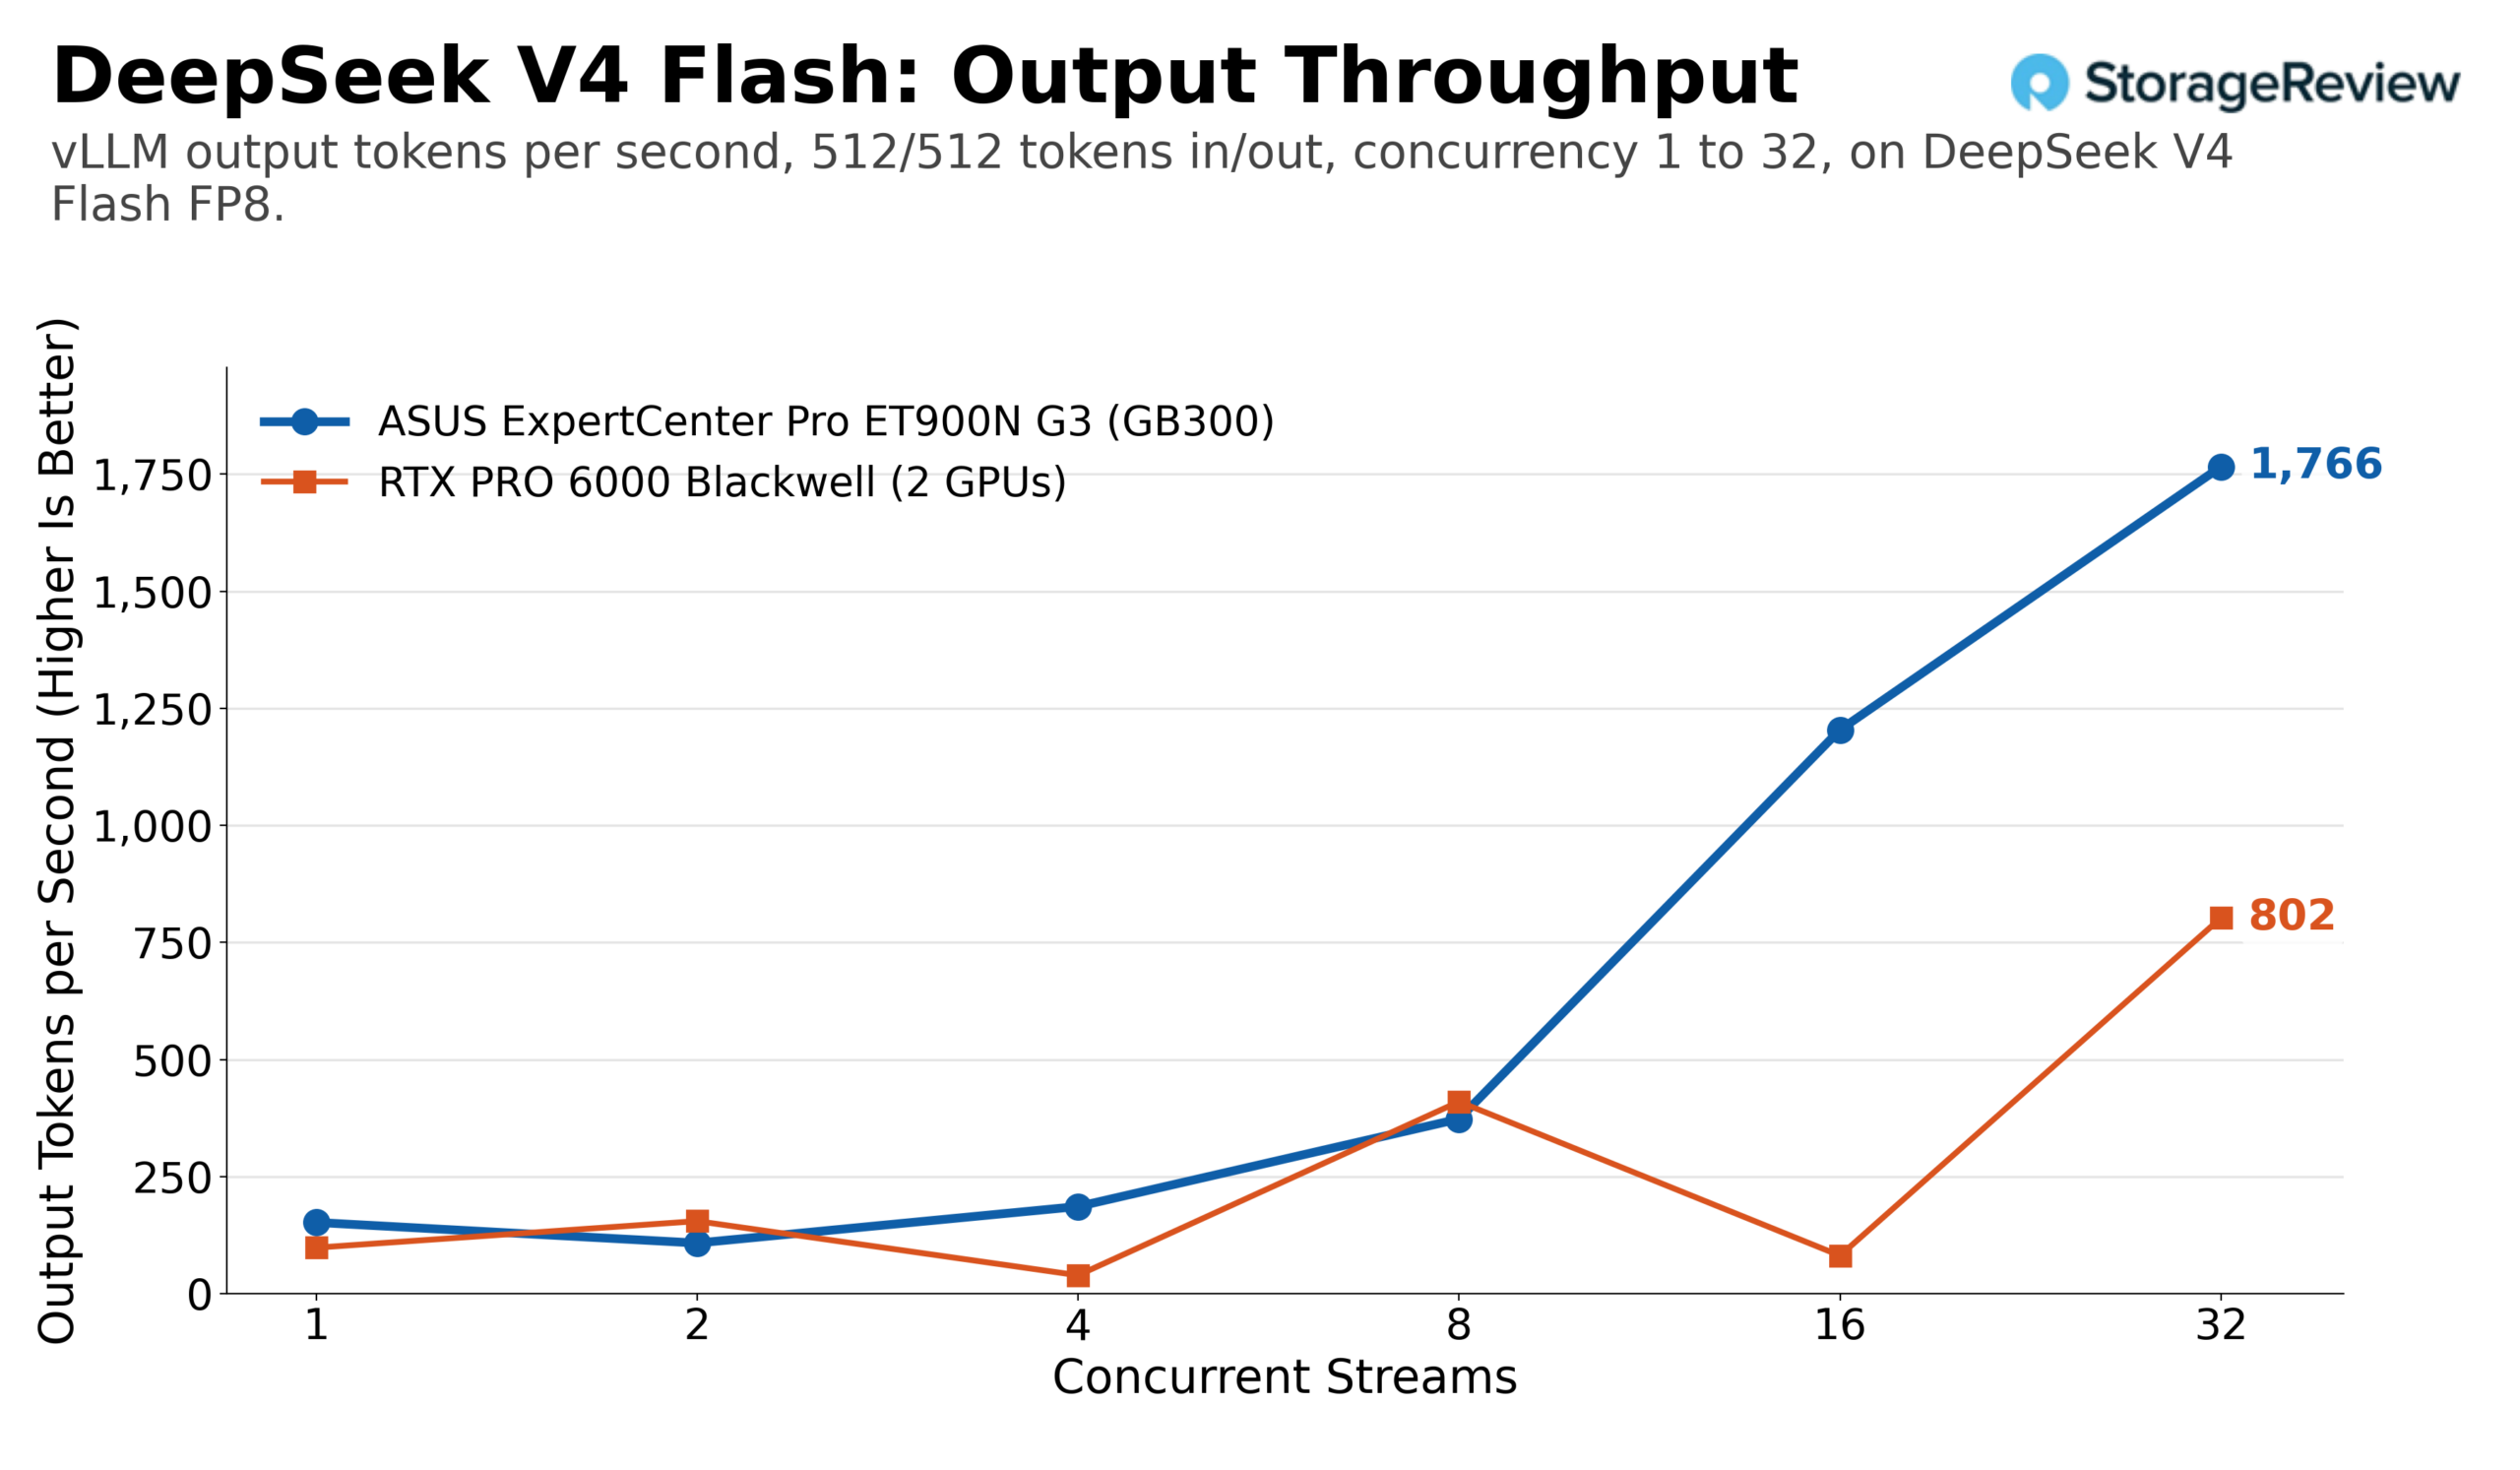
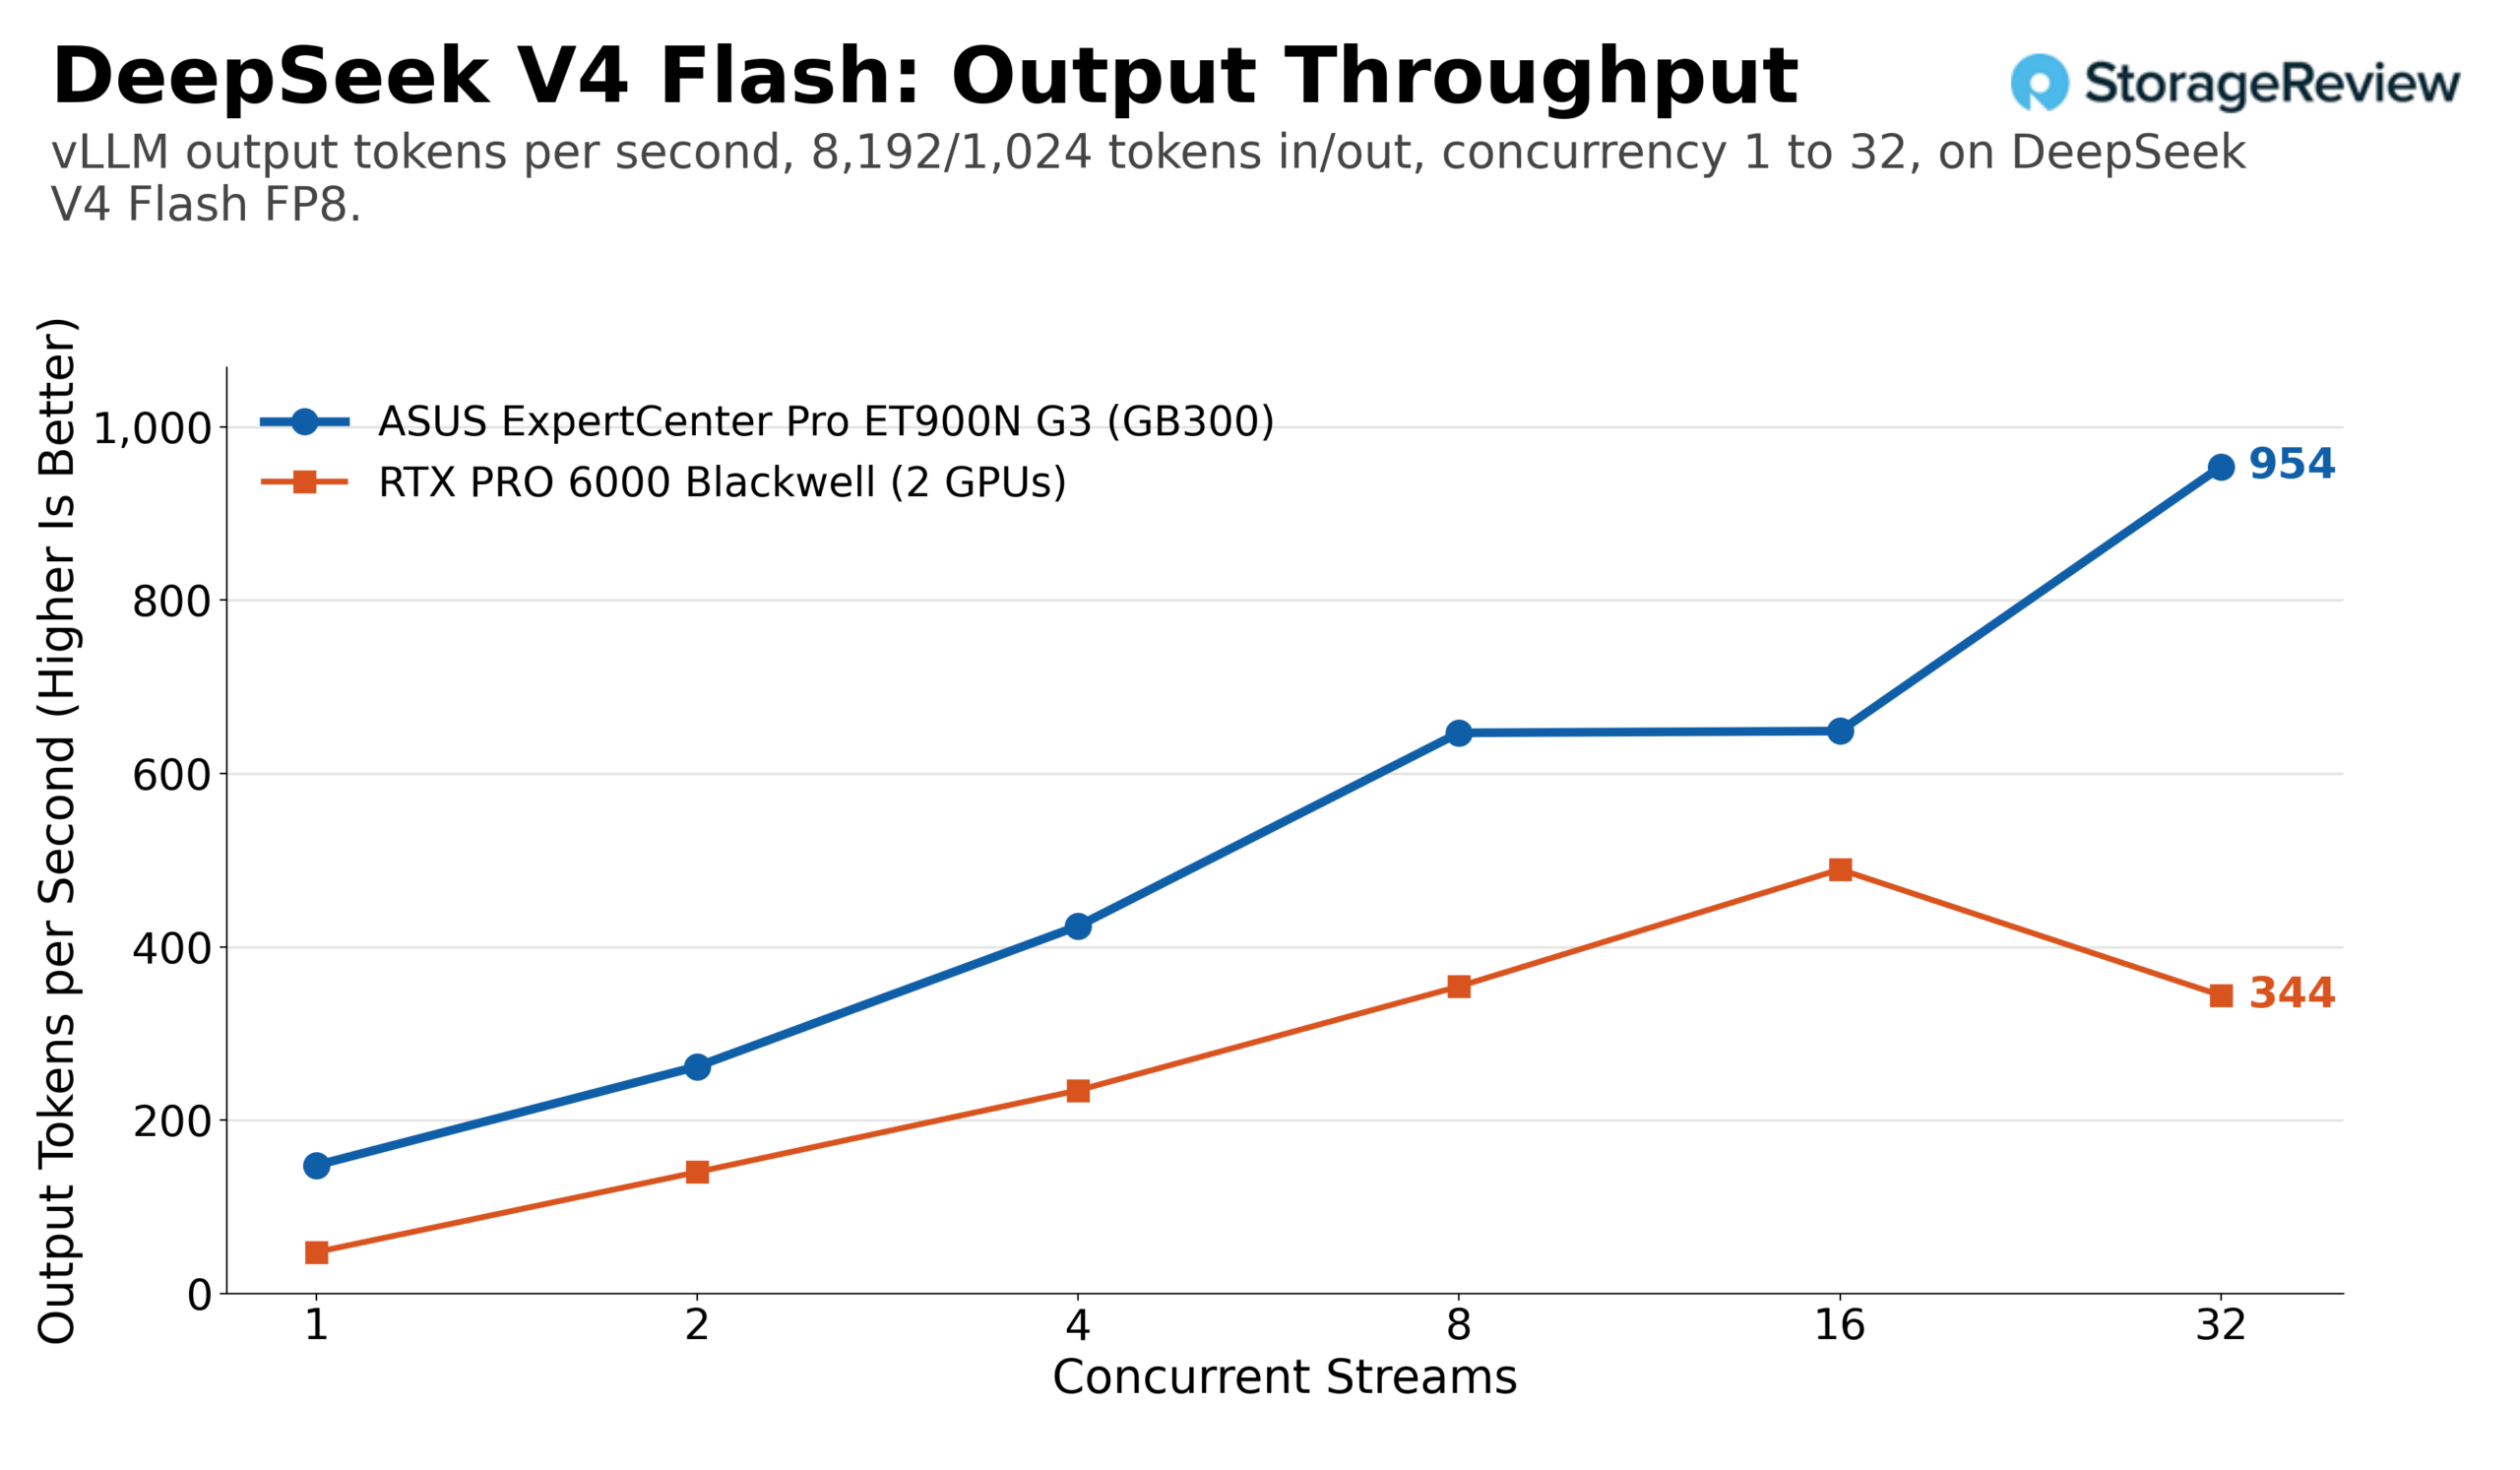
DeepSeek V4 Flash — самый простой случай: нативный чекпоинт FP8 объемом около 20 ГБ, который B300 обрабатывает без усилий. Скорость генерации токенов на сбалансированной нагрузке выросла со 152 токенов в секунду при 1 потоке до 1766 при 32 потоках, достигнув суммарной пропускной способности 3532 токена в секунду. В профиле с тяжелым префиллом ET900N G3 показал рост со 148 до 954 выходных токенов в секунду при итоговом показателе в 8587 токенов. Пара карт RTX PRO 6000 достигла пика около 800 выходных токенов в секунду на сбалансированной нагрузке и около 490 на длинных промптах с неравномерной кривой при низкой параллельности.
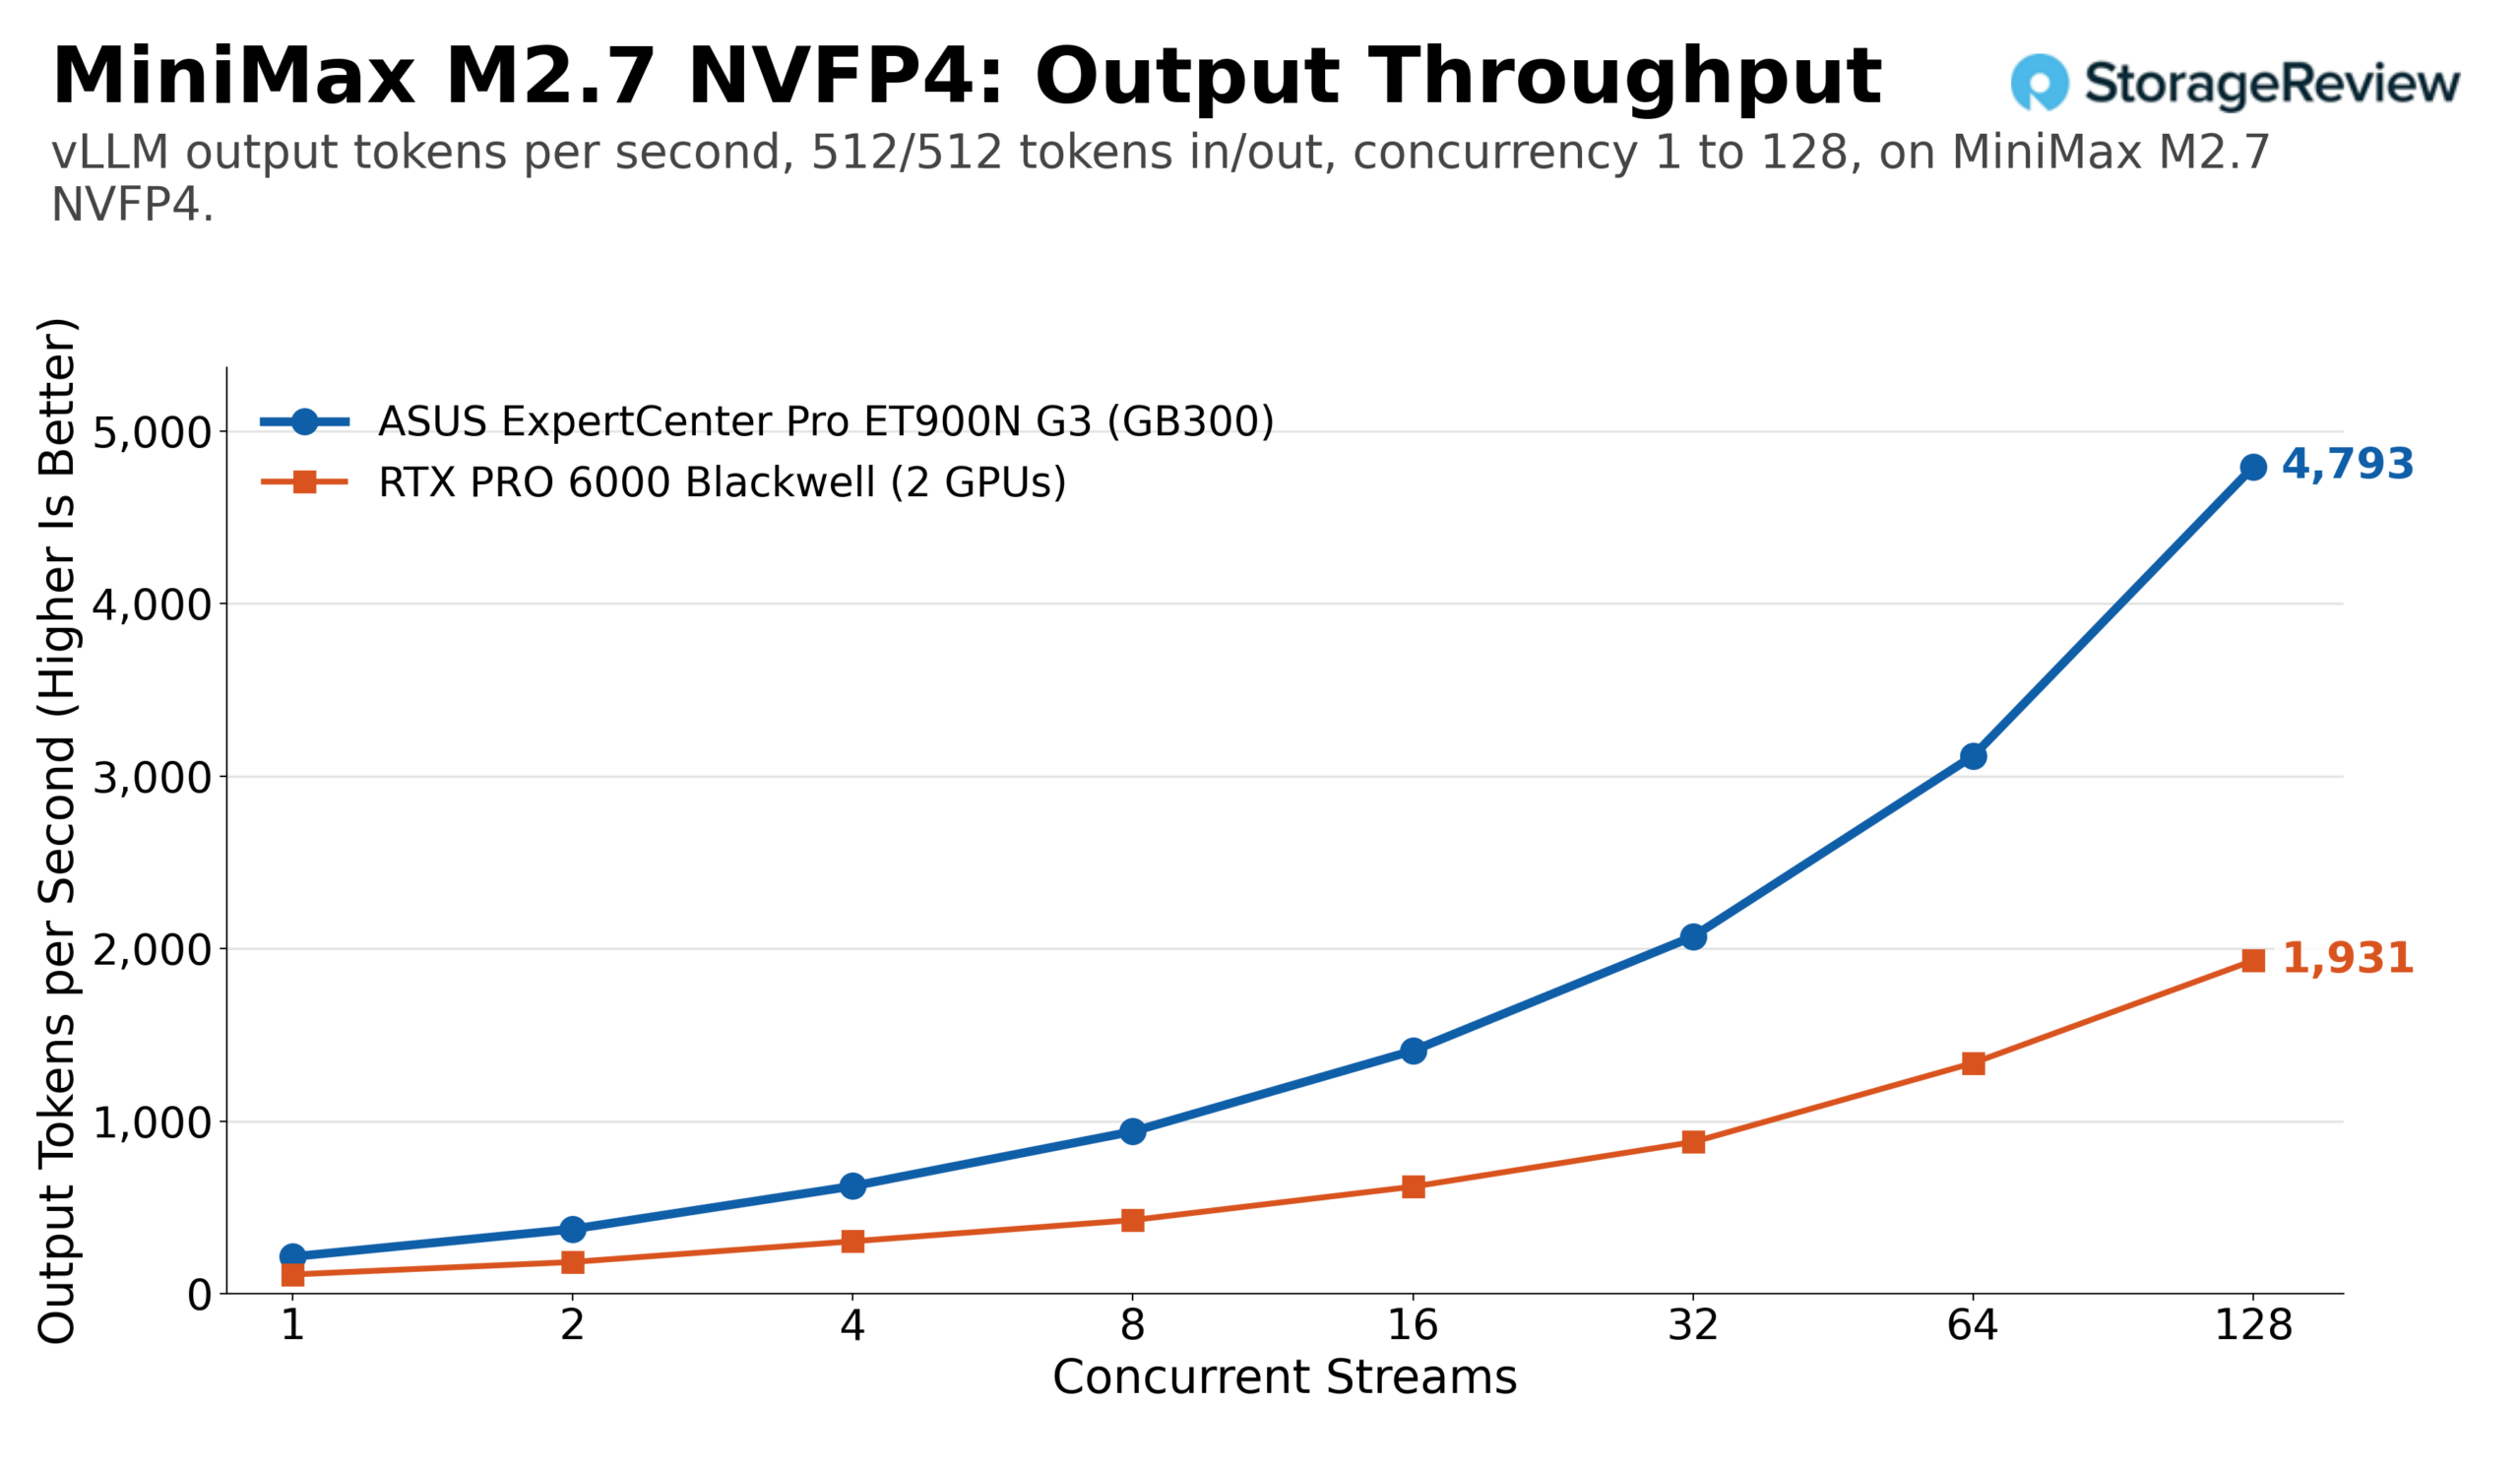
Модель MiniMax M2.7 в квантовании NVIDIA NVFP4 занимает около 125 ГБ HBM и показала наилучшее масштабирование из всех четырех вариантов. На сбалансированной нагрузке скорость выросла с 214 выходных токенов в секунду на одном потоке до 4793 на 128 потоках, а суммарная пропускная способность достигла 9586 токенов в секунду.
Производительность систем при работе с крупными моделями и масштабирование
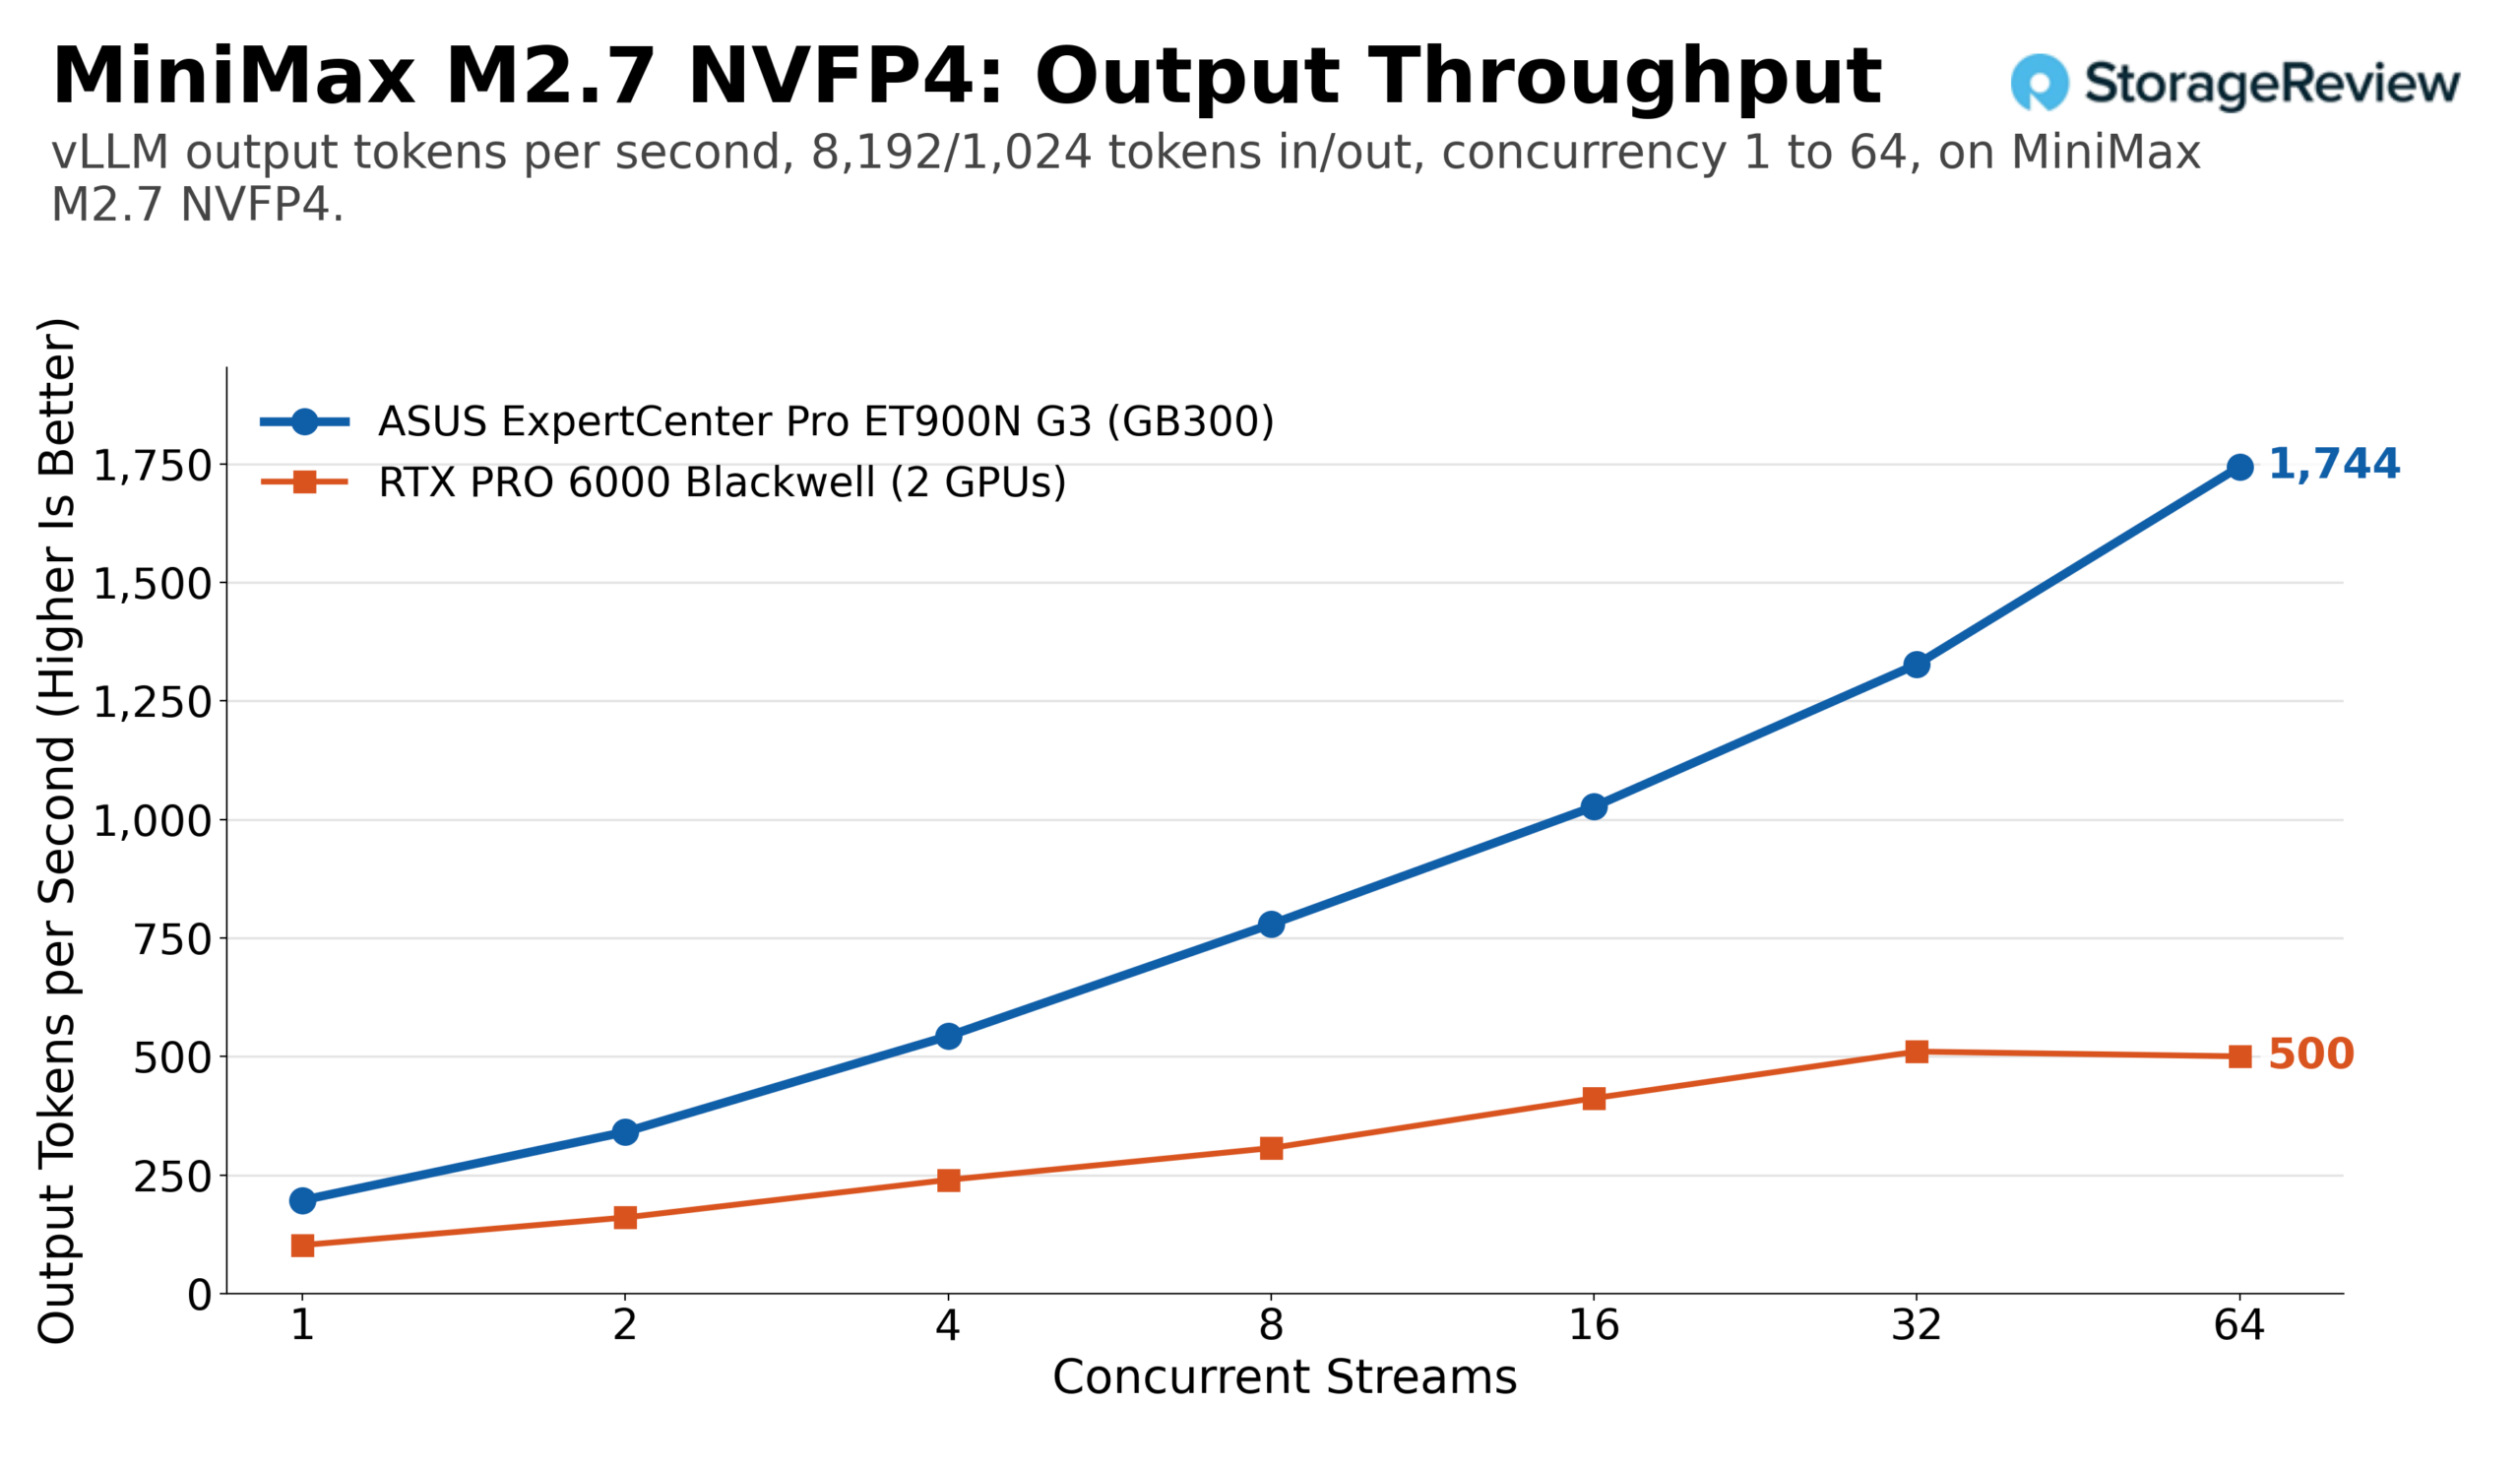
В режиме с интенсивной предварительной генерацией (prefill-heavy) система достигла показателей в 1744 токена в секунду для вывода и 15 700 токенов в секунду суммарно при 64 потоках. Конфигурация с двумя картами RTX PRO 6000 продемонстрировала схожую динамику при вдвое меньшей высоте корпуса, достигая пика около 1930 токенов в секунду для вывода на равной нагрузке и около 510 токенов для длинных промптов.
Работа с MiniMax M3
Модель MiniMax M3 демонстрирует работу в условиях предельного заполнения памяти. Контрольная точка NVFP4 весит менее 252 ГБ, однако среда исполнения и KV-кэш требуют дополнительного места, поэтому часть экспертов размещается в памяти Grace, а каждый шаг декодирования, затрагивающий их, проходит через соединение NVLink-C2C.
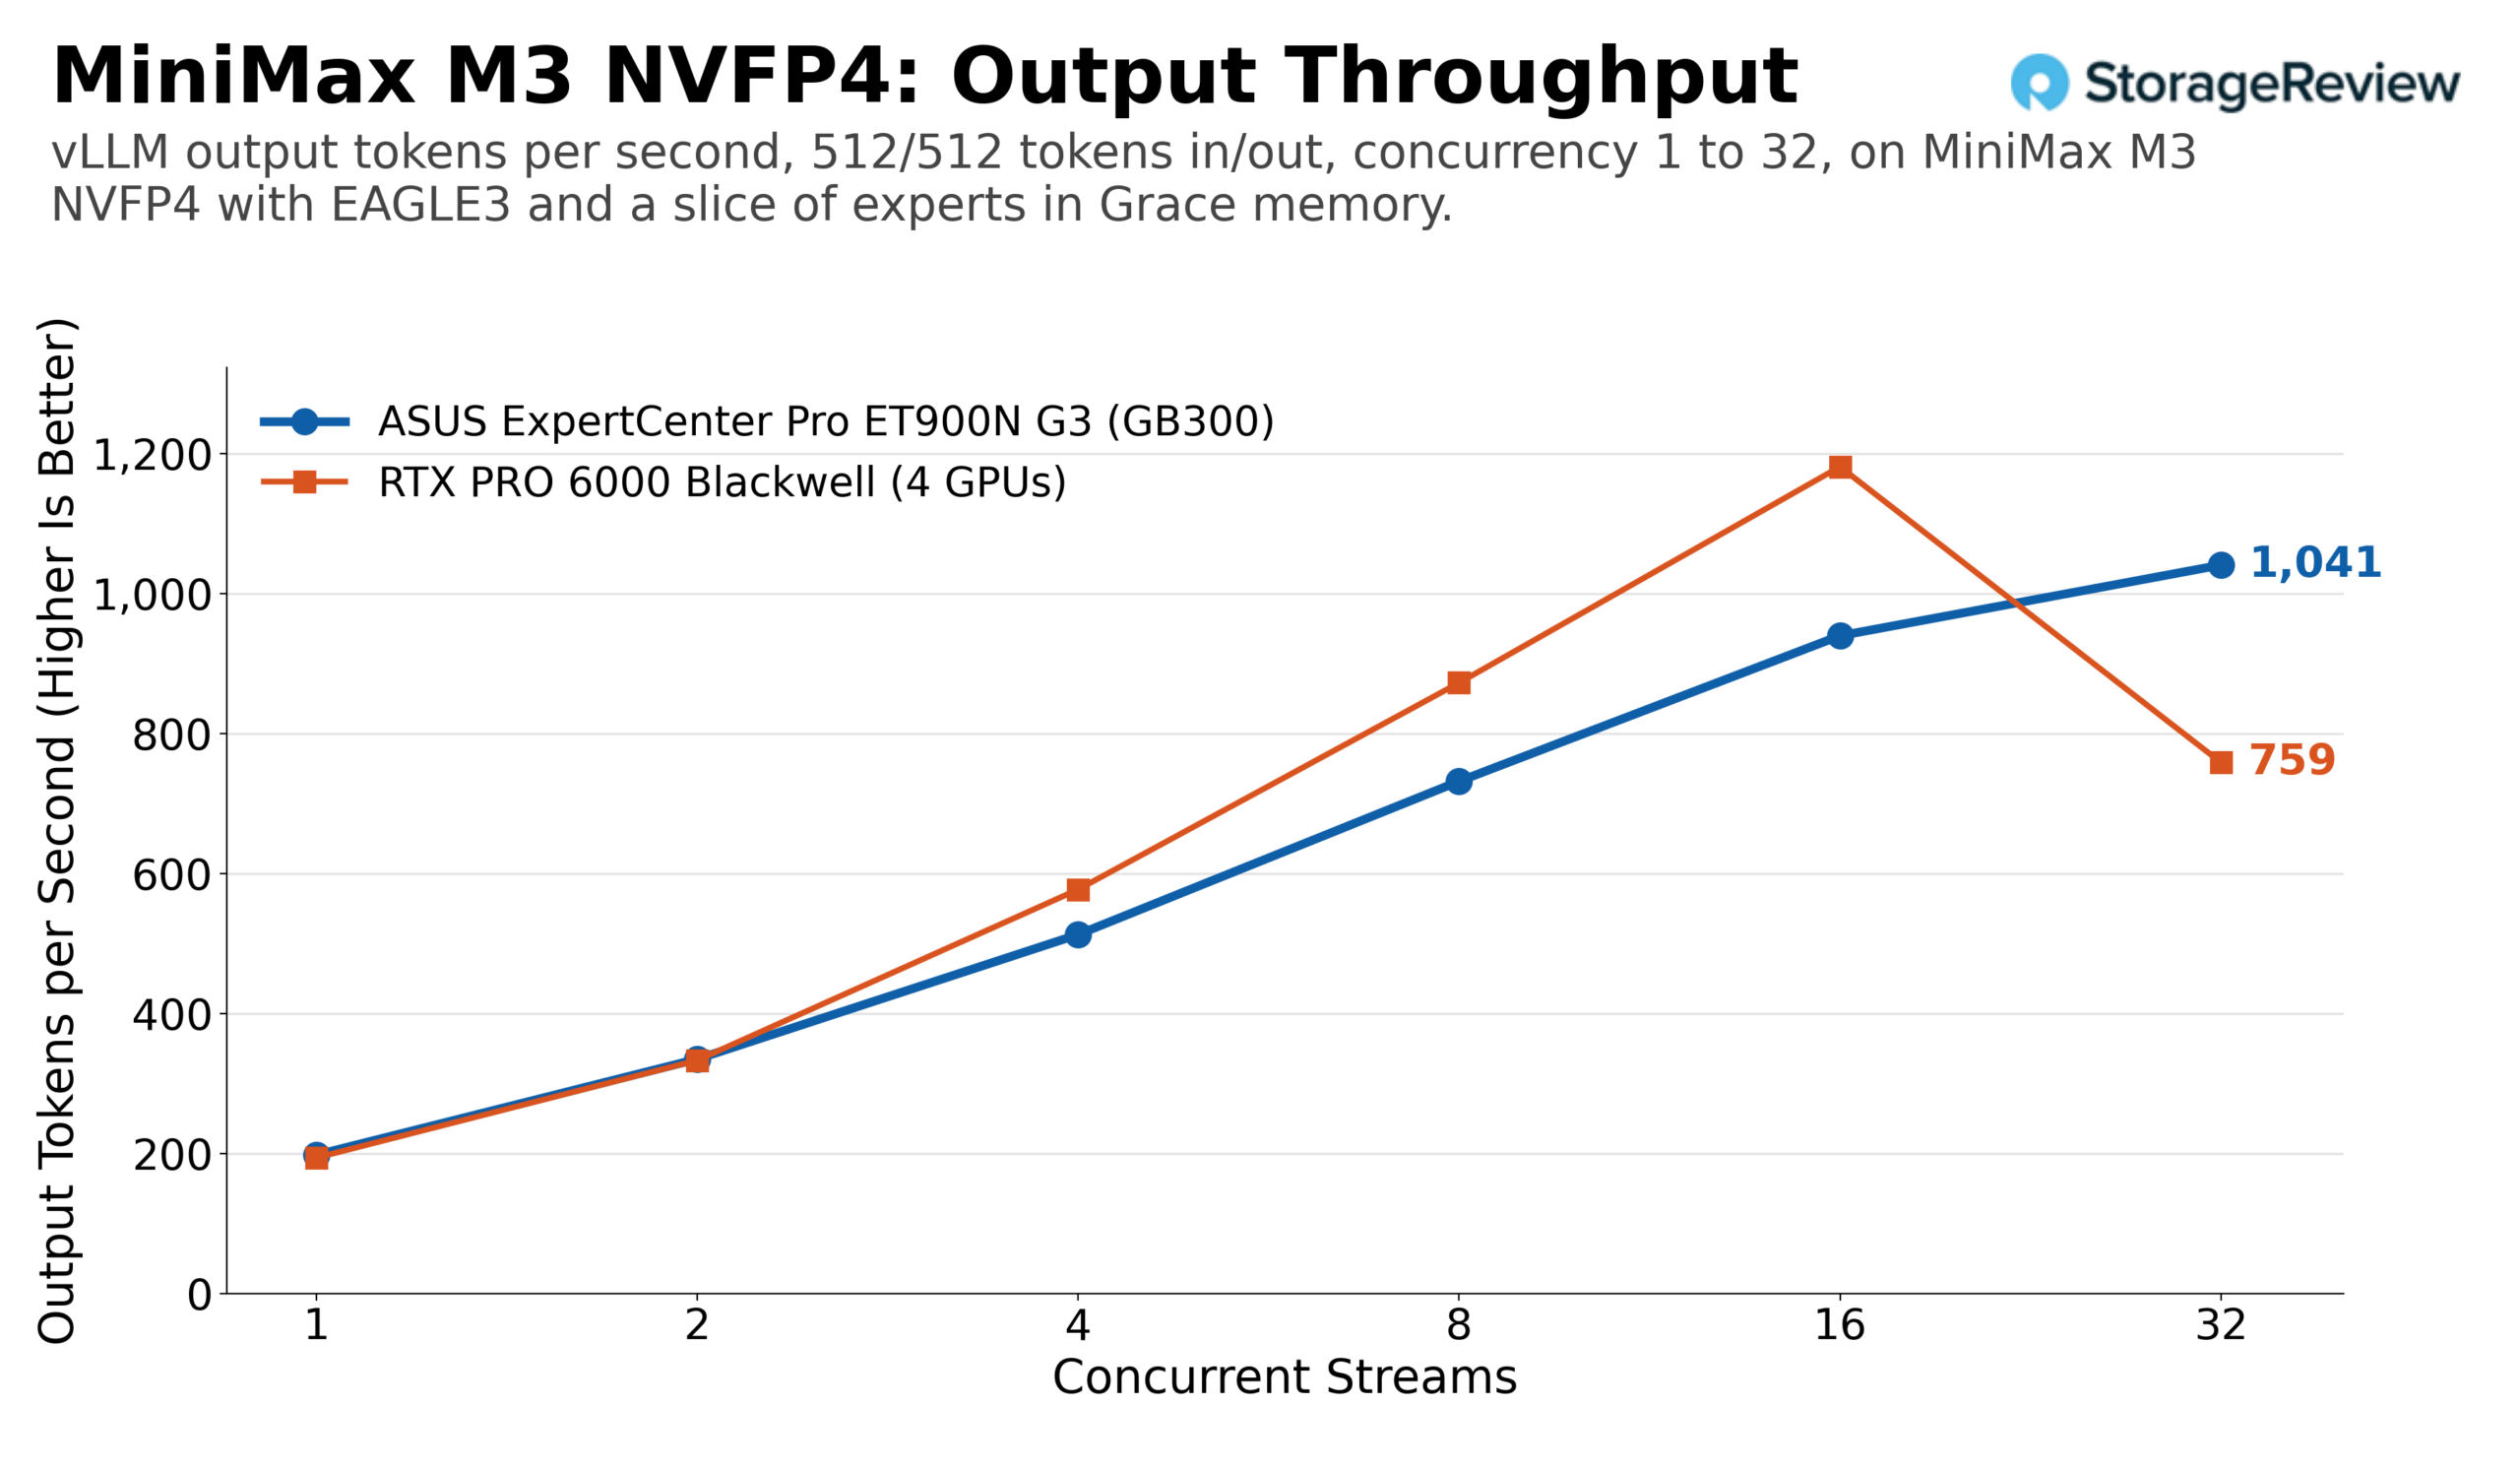
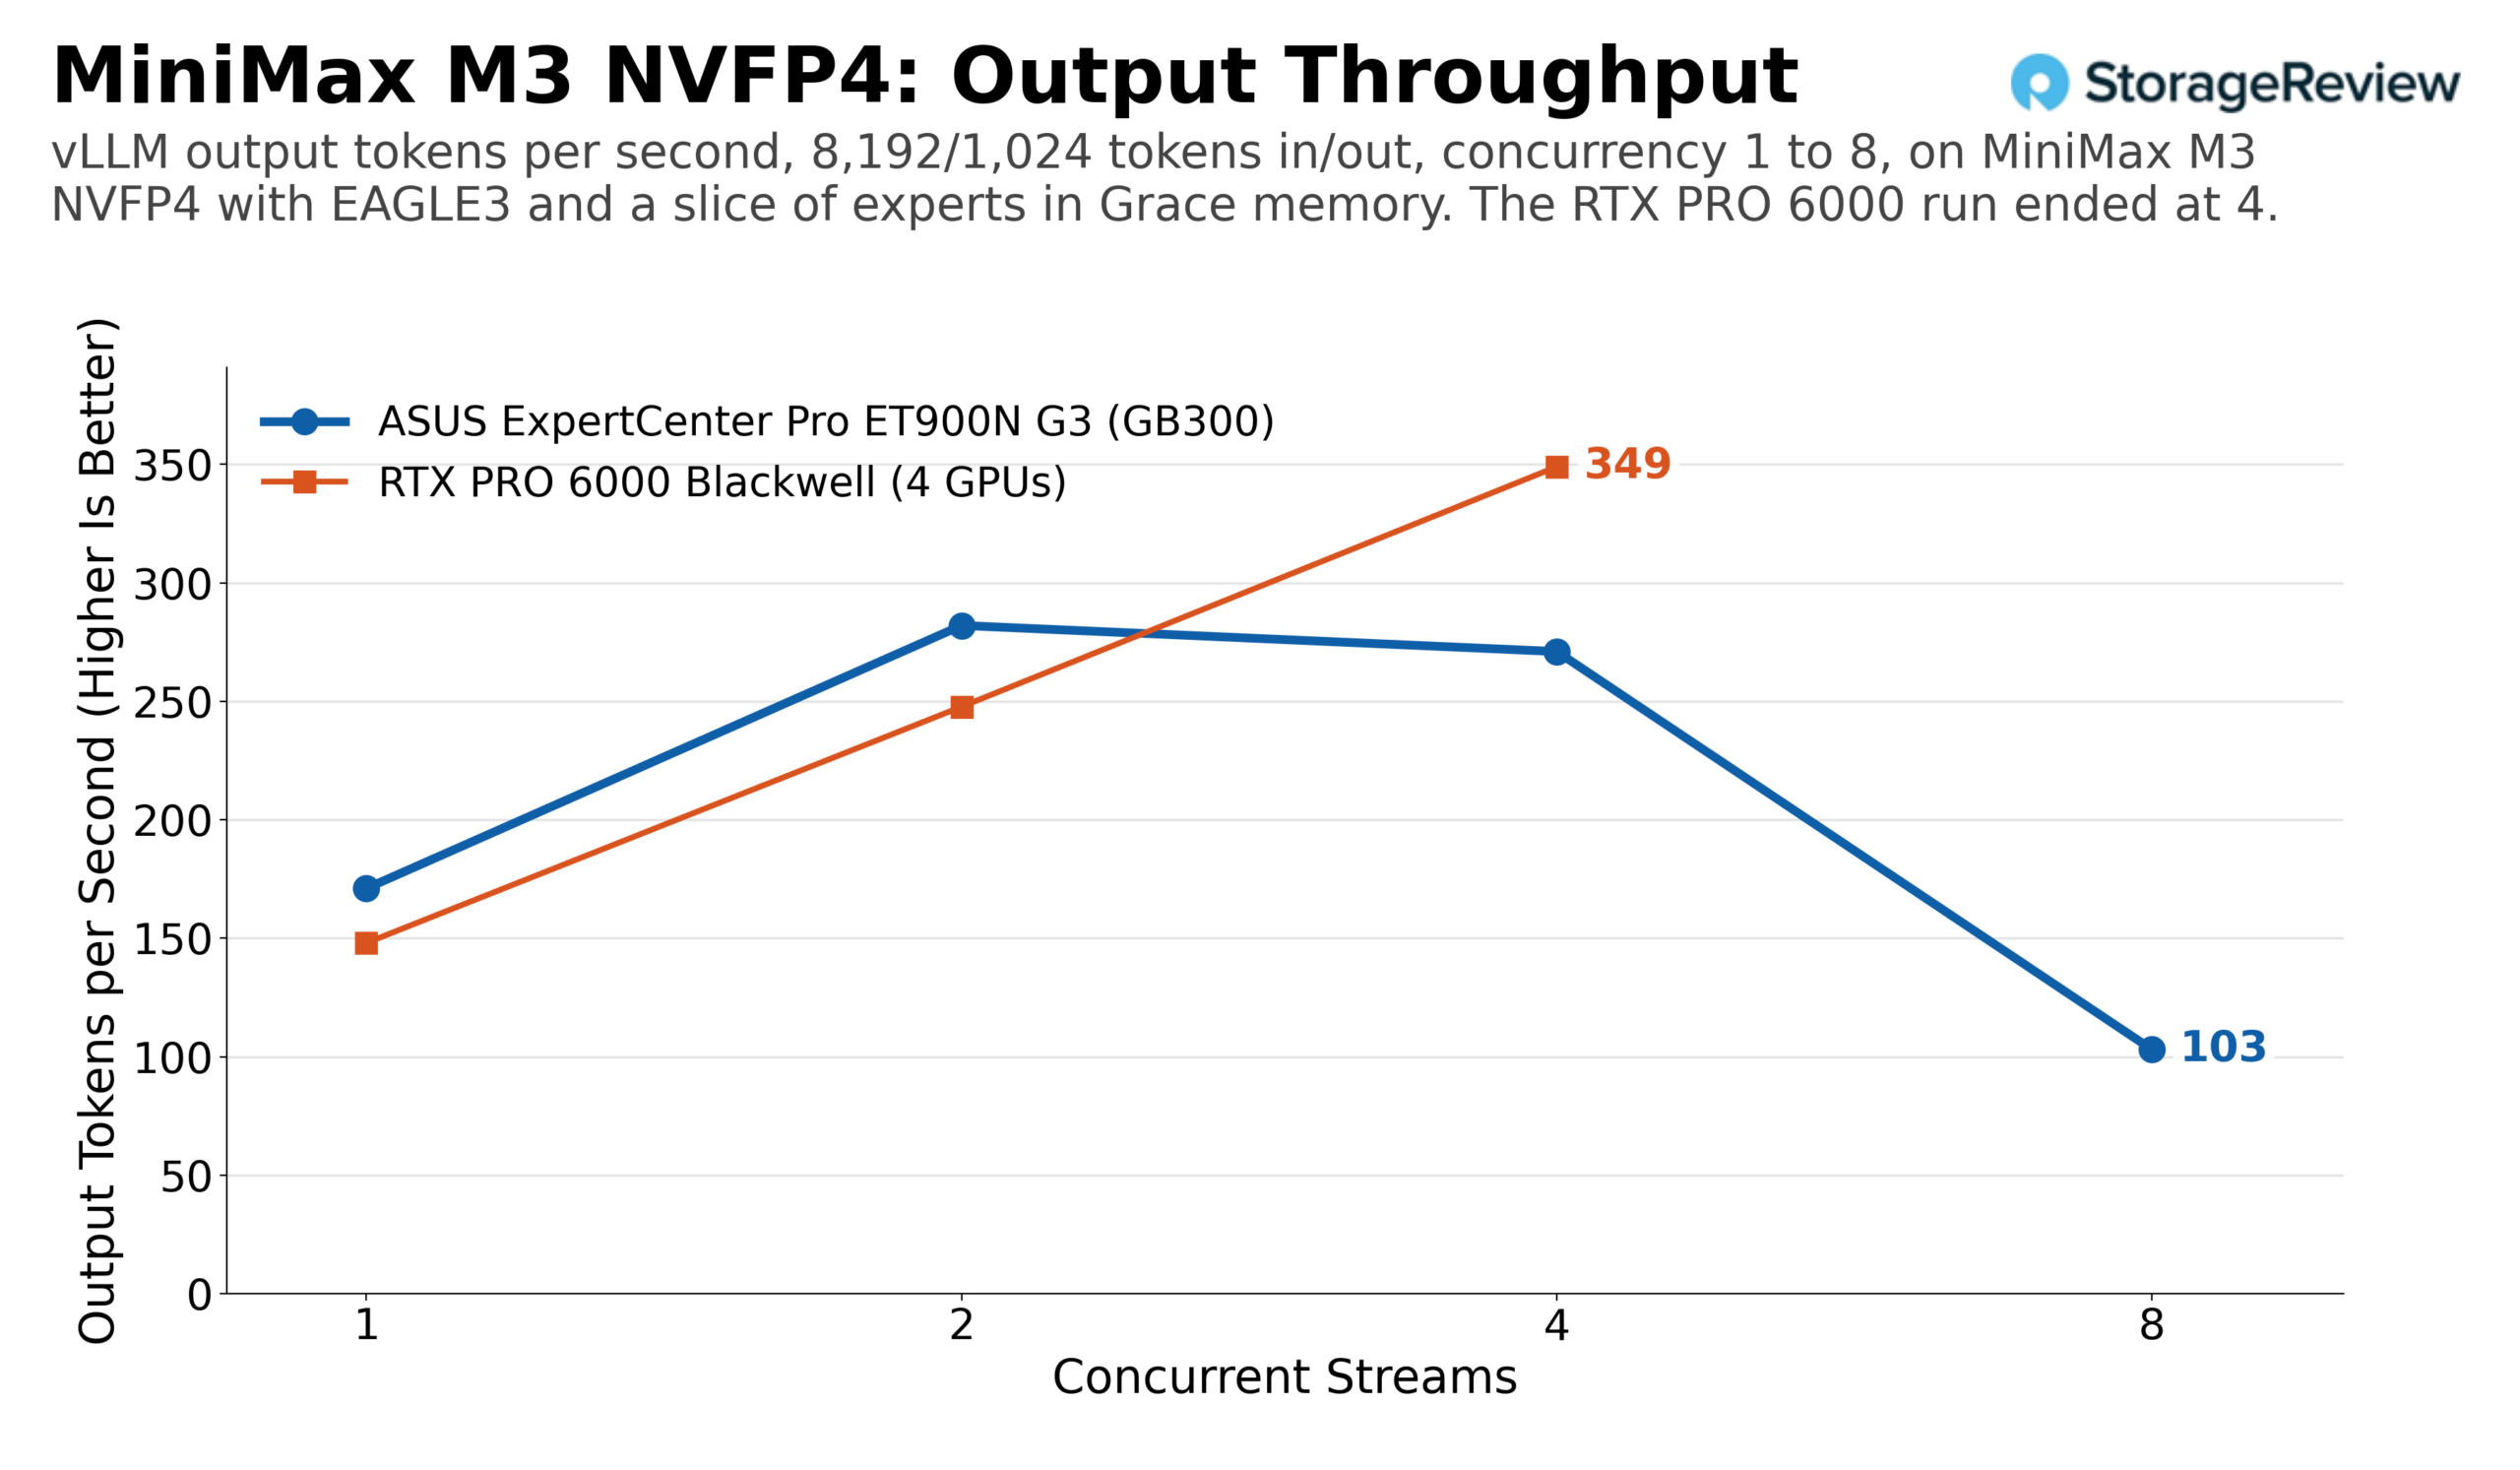
С использованием спекулятивного декодирования EAGLE3 система ET900N G3 на равной нагрузке достигла 1041 токена в секунду при 32 потоках. В профиле с интенсивной предварительной генерацией результат составил 282 токена при двух потоках, 271 токен при четырех и упал до 103 токенов при восьми потоках по мере того, как длинные промпты поглощали оставшийся кэш.
Четыре карты RTX PRO 6000 с тем же спекулятивным декодером удерживали производительность до восьми потоков, вырвавшись вперед при 16 потоках с показателем около 1180 токенов в секунду, после чего опустились до 760 токенов при 32 потоках. На профиле с интенсивной предварительной генерацией сборка из четырех карт удерживала около 349 токенов в секунду при четырех потоках против 271 токена у станции. Модель, занимающая объем памяти на грани HBM, является единственным случаем в данном наборе, где 384 ГБ VRAM на четырех картах конкурируют с 252 ГБ HBM и выгрузкой в хост-память.
Особенности GLM-5.2 и сравнение систем
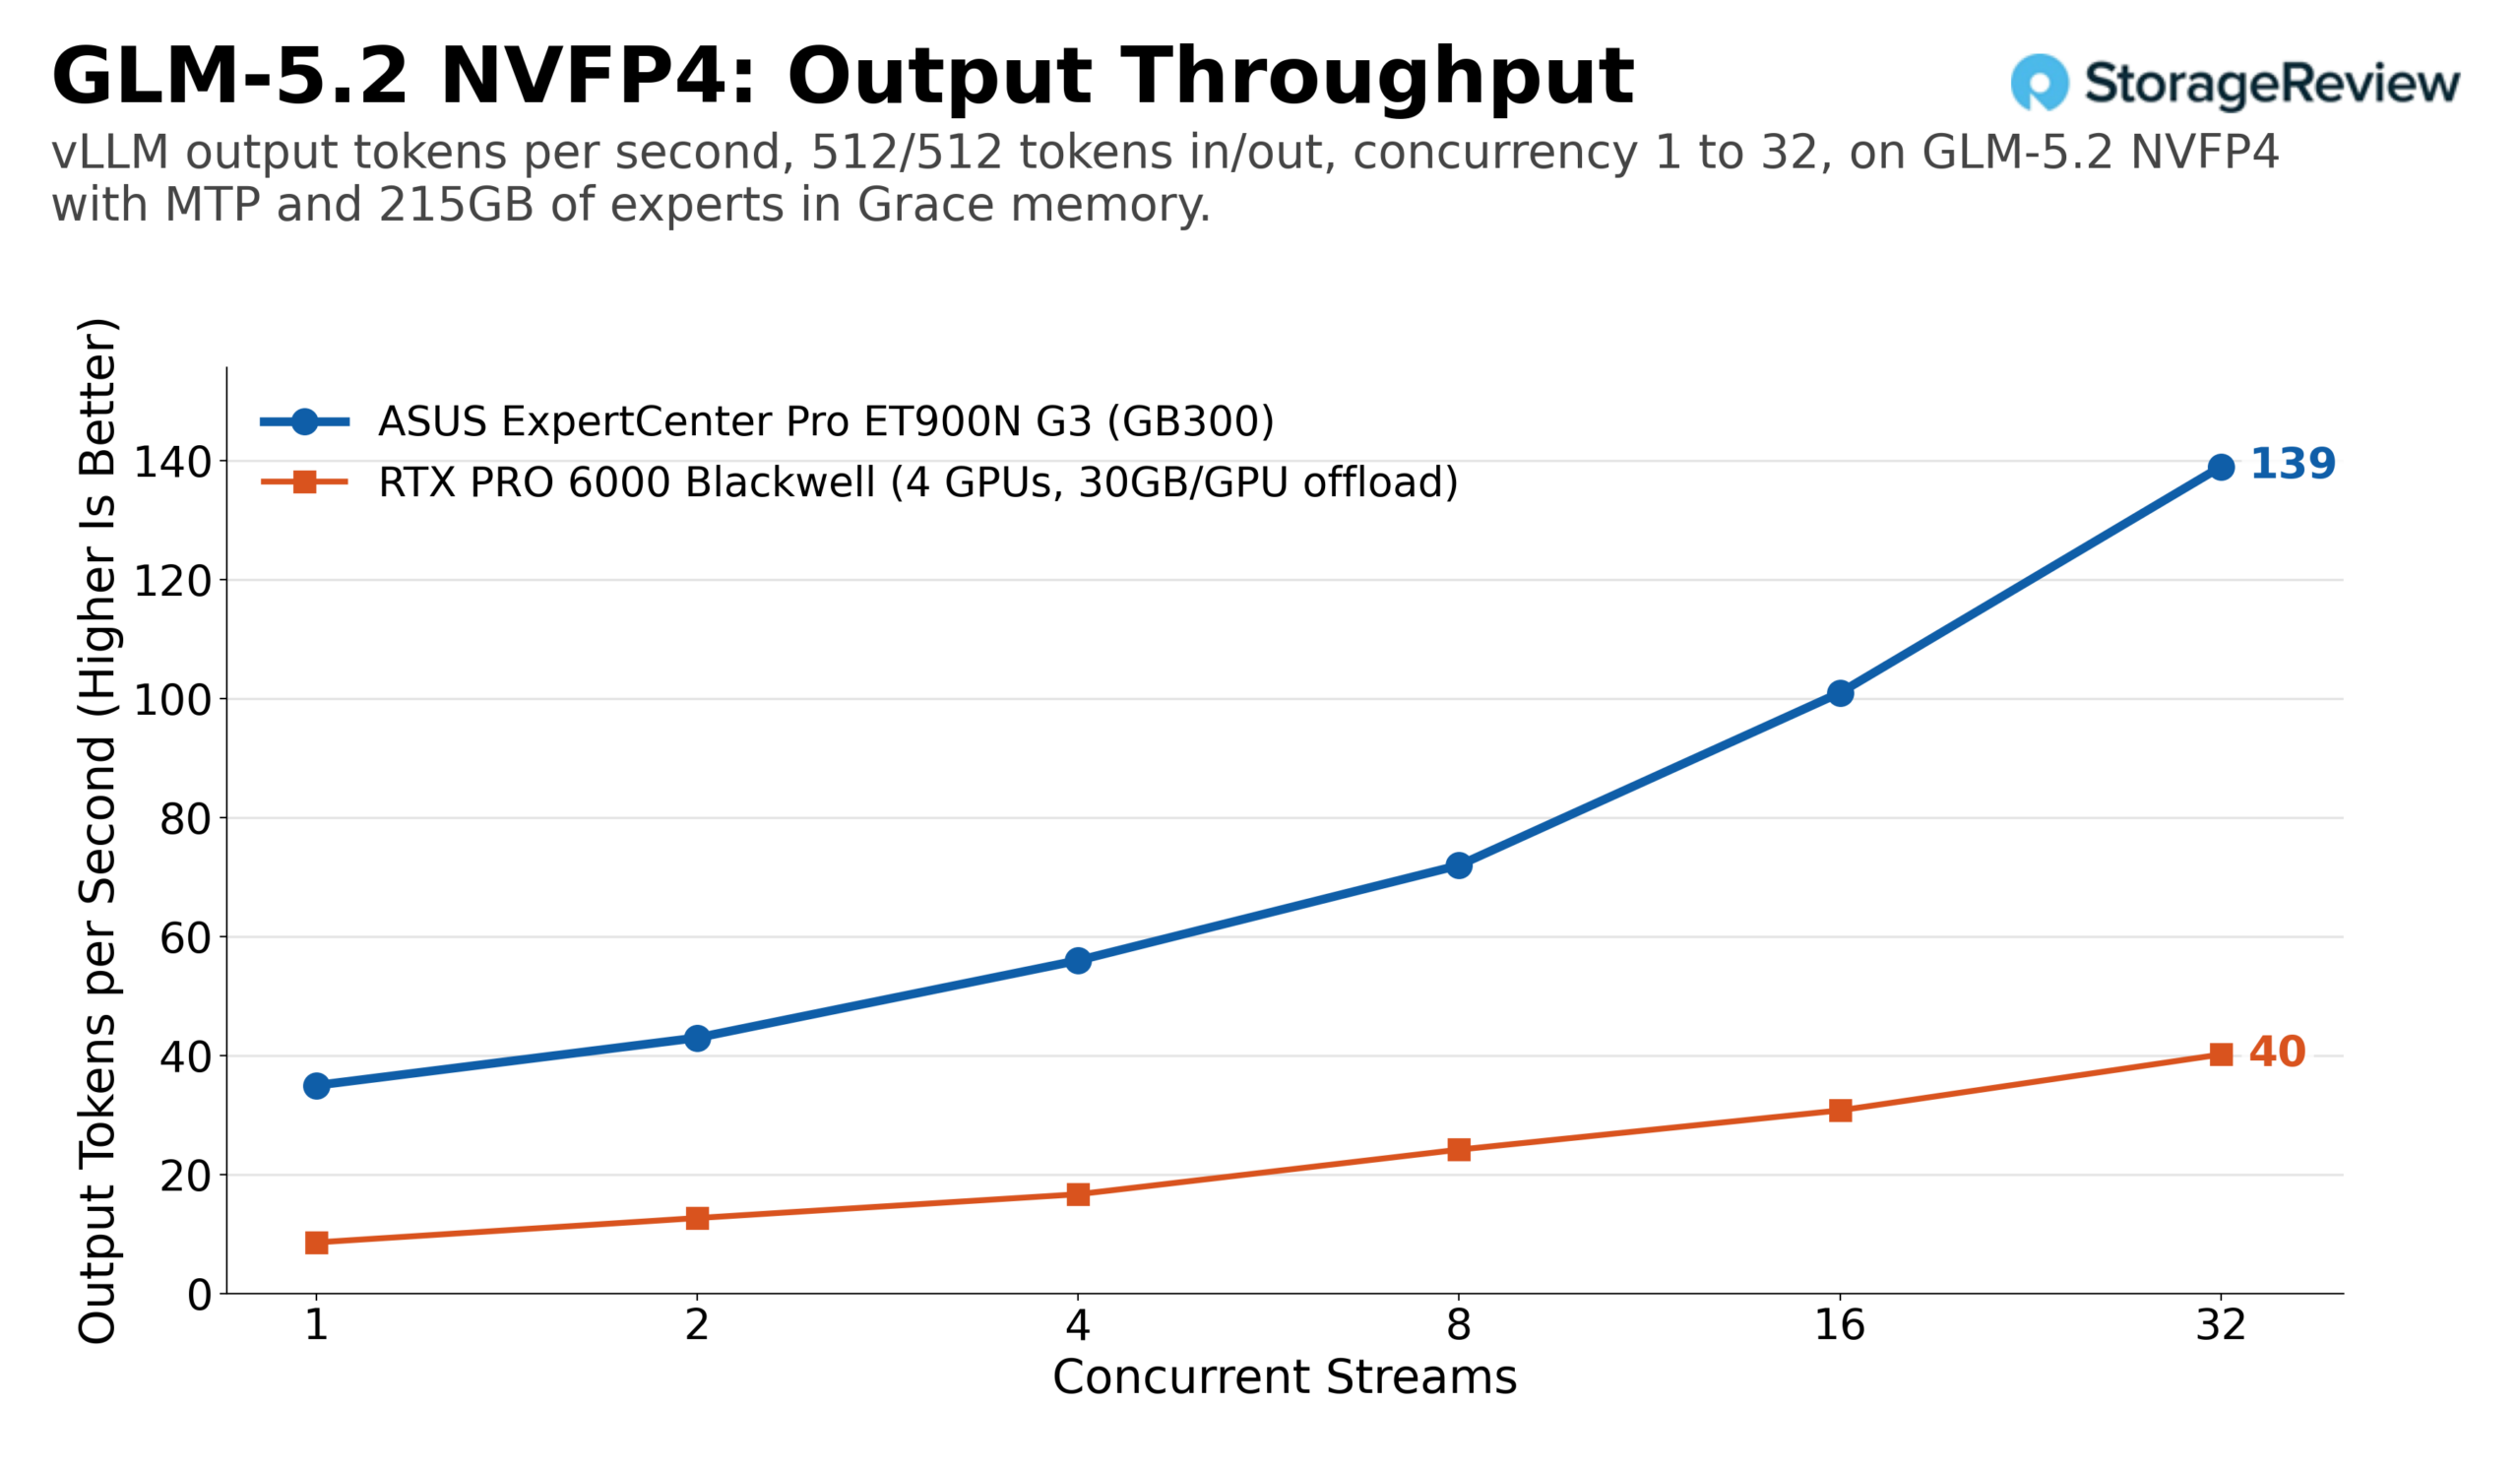
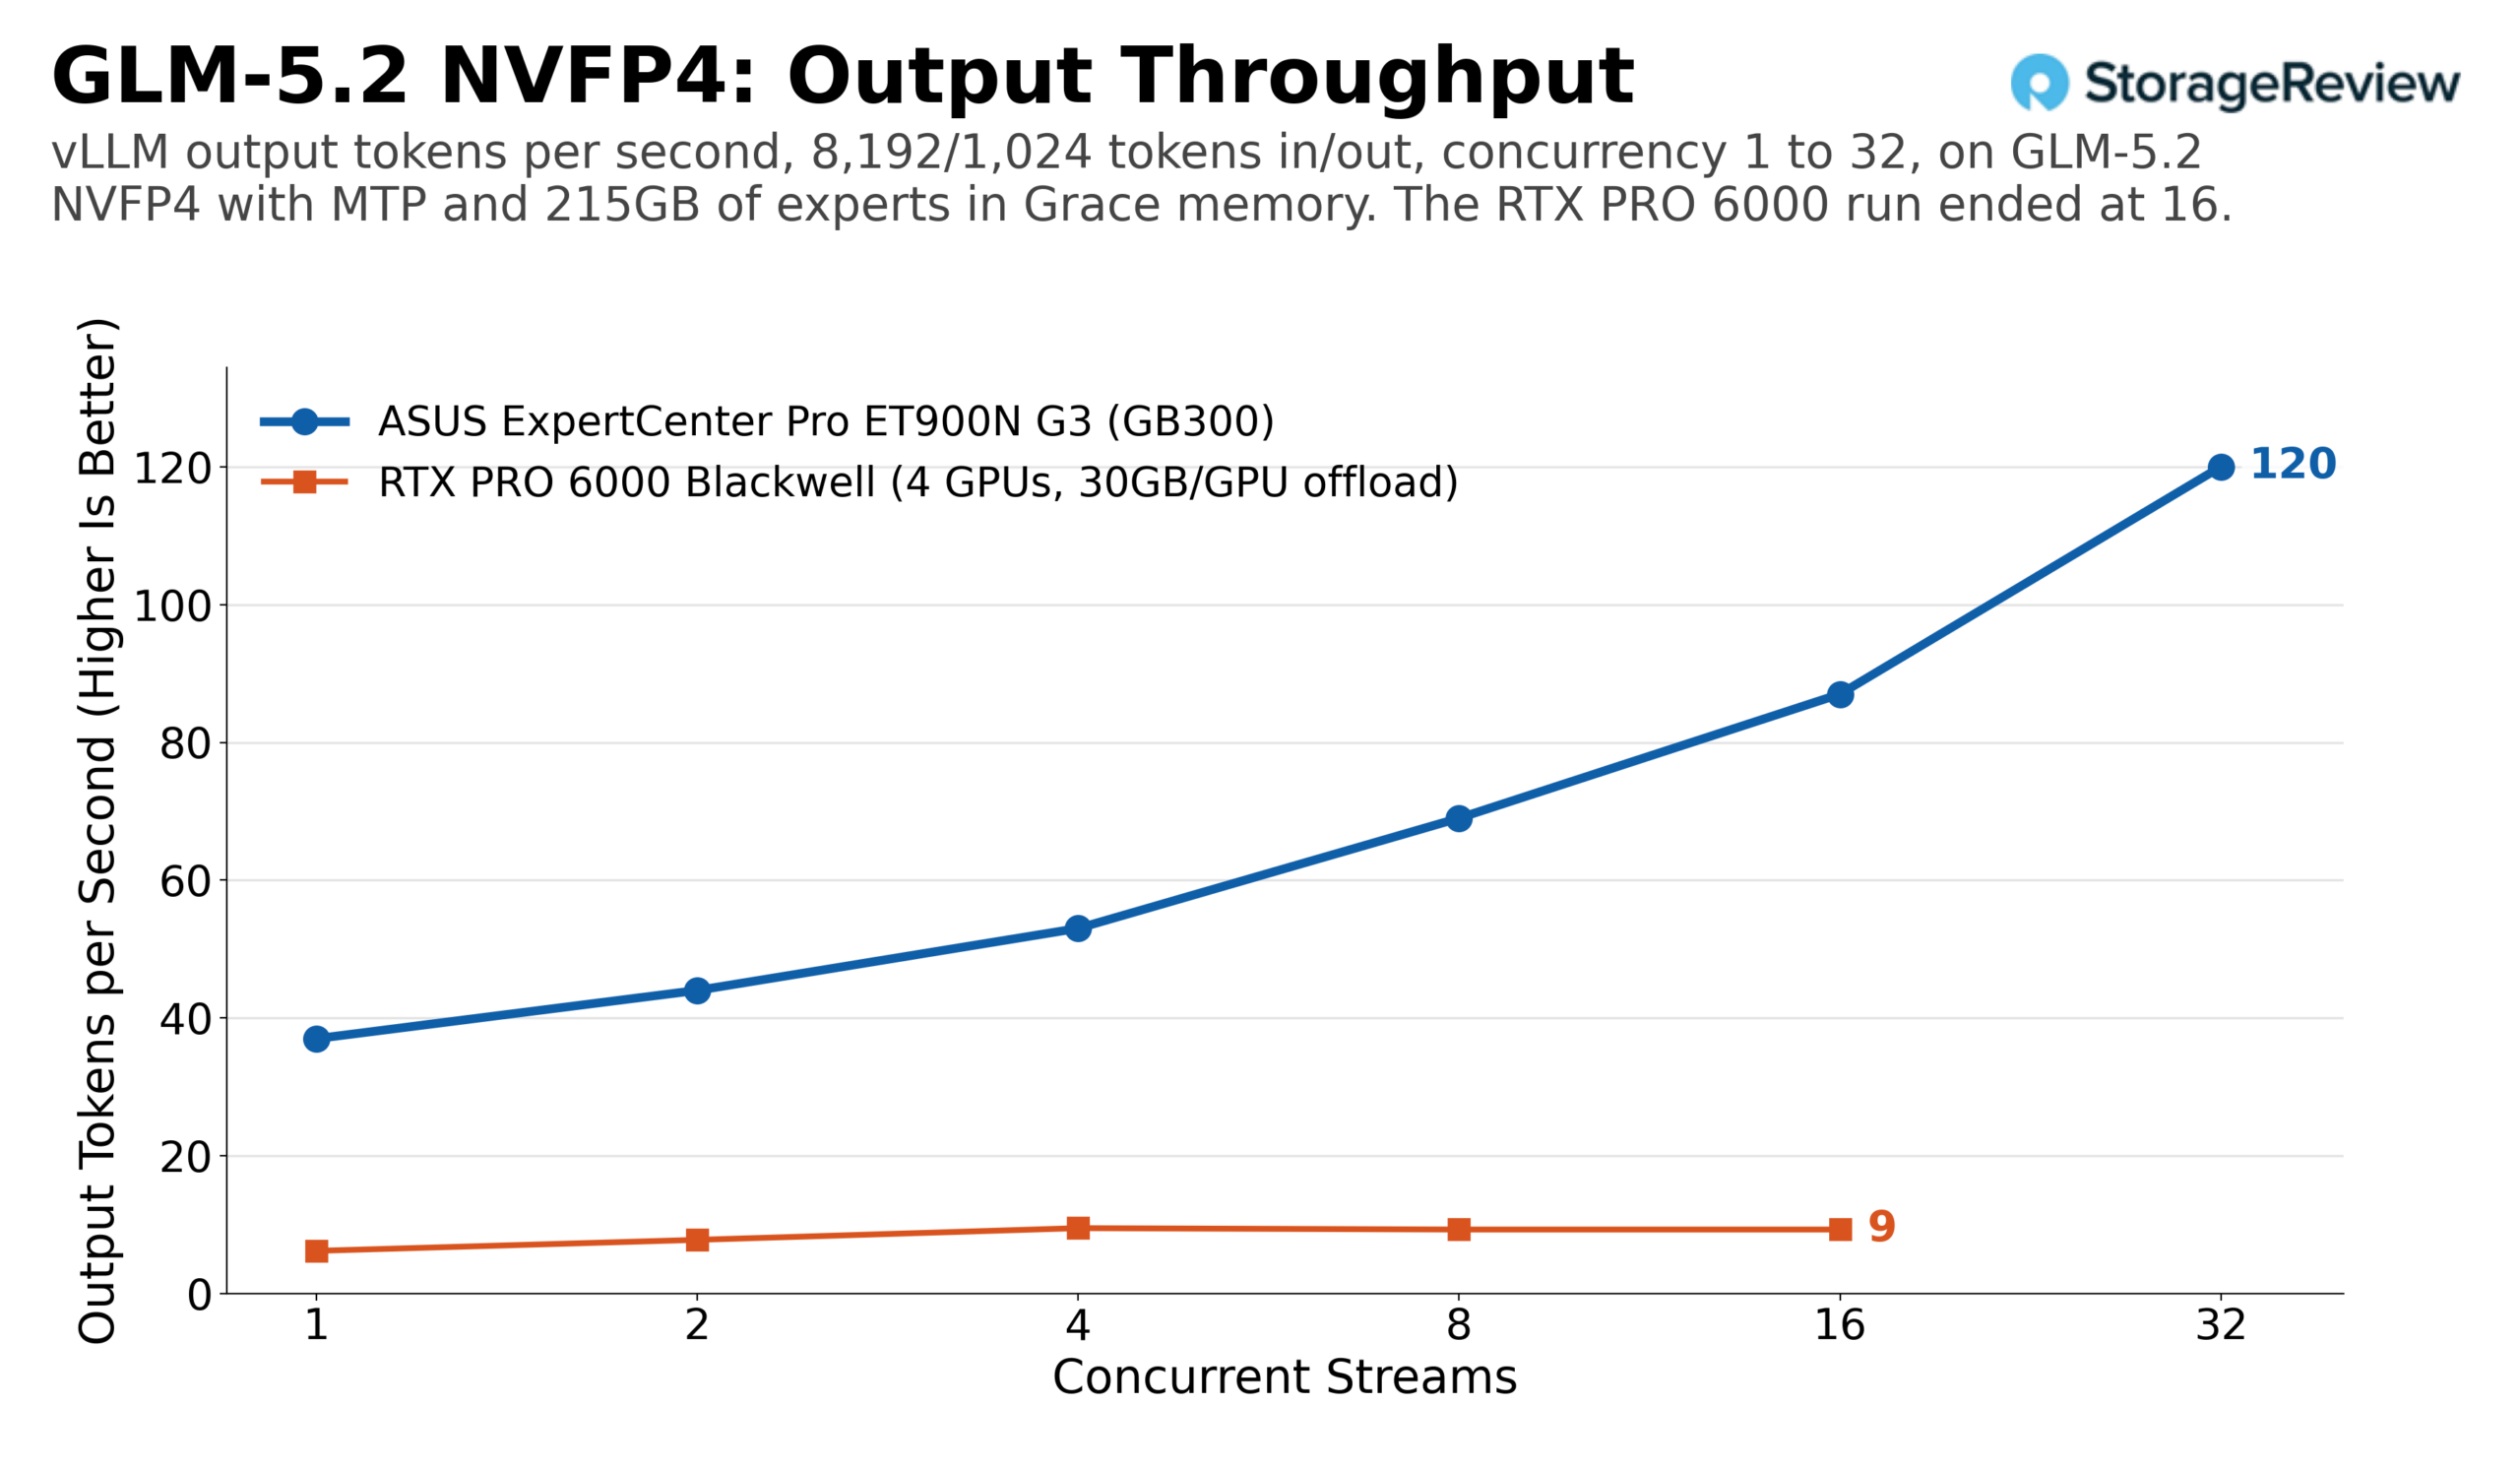
GLM-5.2 представляет собой сценарий использования, возможный только для единого пула памяти. Контрольная точка NVFP4 удерживает около 215 ГБ весов экспертов в памяти Grace при спекулятивном декодировании MTP. ET900N G3 обрабатывала ее со скоростью 35 токенов в секунду для одного потока и 139 токенов для 32 потоков на равной нагрузке, при этом общая пропускная способность достигала 277 токенов. На профиле с интенсивной предварительной генерацией при 32 потоках показатели достигли 120 токенов в секунду и 1079 токенов суммарно.
Четыре карты RTX PRO 6000, каждая из которых выгружала около 30 ГБ в хост-память, обеспечивали около 40 токенов в секунду при 32 потоках, снижаясь до 9–10 токенов на длинных промптах начиная с четырех потоков. Ни одна из систем не делает работу с моделью объемом 433 ГБ быстрой, однако пропускная способность LPDDR5X в 396 ГБ/с и соединение NVLink-C2C в 900 ГБ/с у GB300 позволяют продолжать масштабирование там, где возможности PCIe-подключенной хост-памяти четырех карт исчерпываются.
При сопоставлении с MSI WS300 результаты ET900N G3 на пограничных моделях расходятся не более чем на 1%: 1766 токенов в секунду на DeepSeek V4 Flash при 32 потоках на обеих башнях, 4793 против 4801 на MiniMax M2.7 при 128 потоках, 1041 на MiniMax M3 при 32 потоках и 139 на GLM-5.2 при 32 потоках.
Общие тесты производительности
Во второй половине бенчмарков используются модели, достаточно малые для всех систем: GPT-OSS-20B и 120B в нативном формате MXFP4; Llama 3.1 8B в BF16 и FP8; Mistral Small 24B в BF16 и FP8; Qwen3 Coder 30B в BF16 и FP8. В сравнение включена одна карта H200 NVL (141 ГБ) от NVIDIA, представляющая собой ускоритель для дата-центров предыдущего поколения.
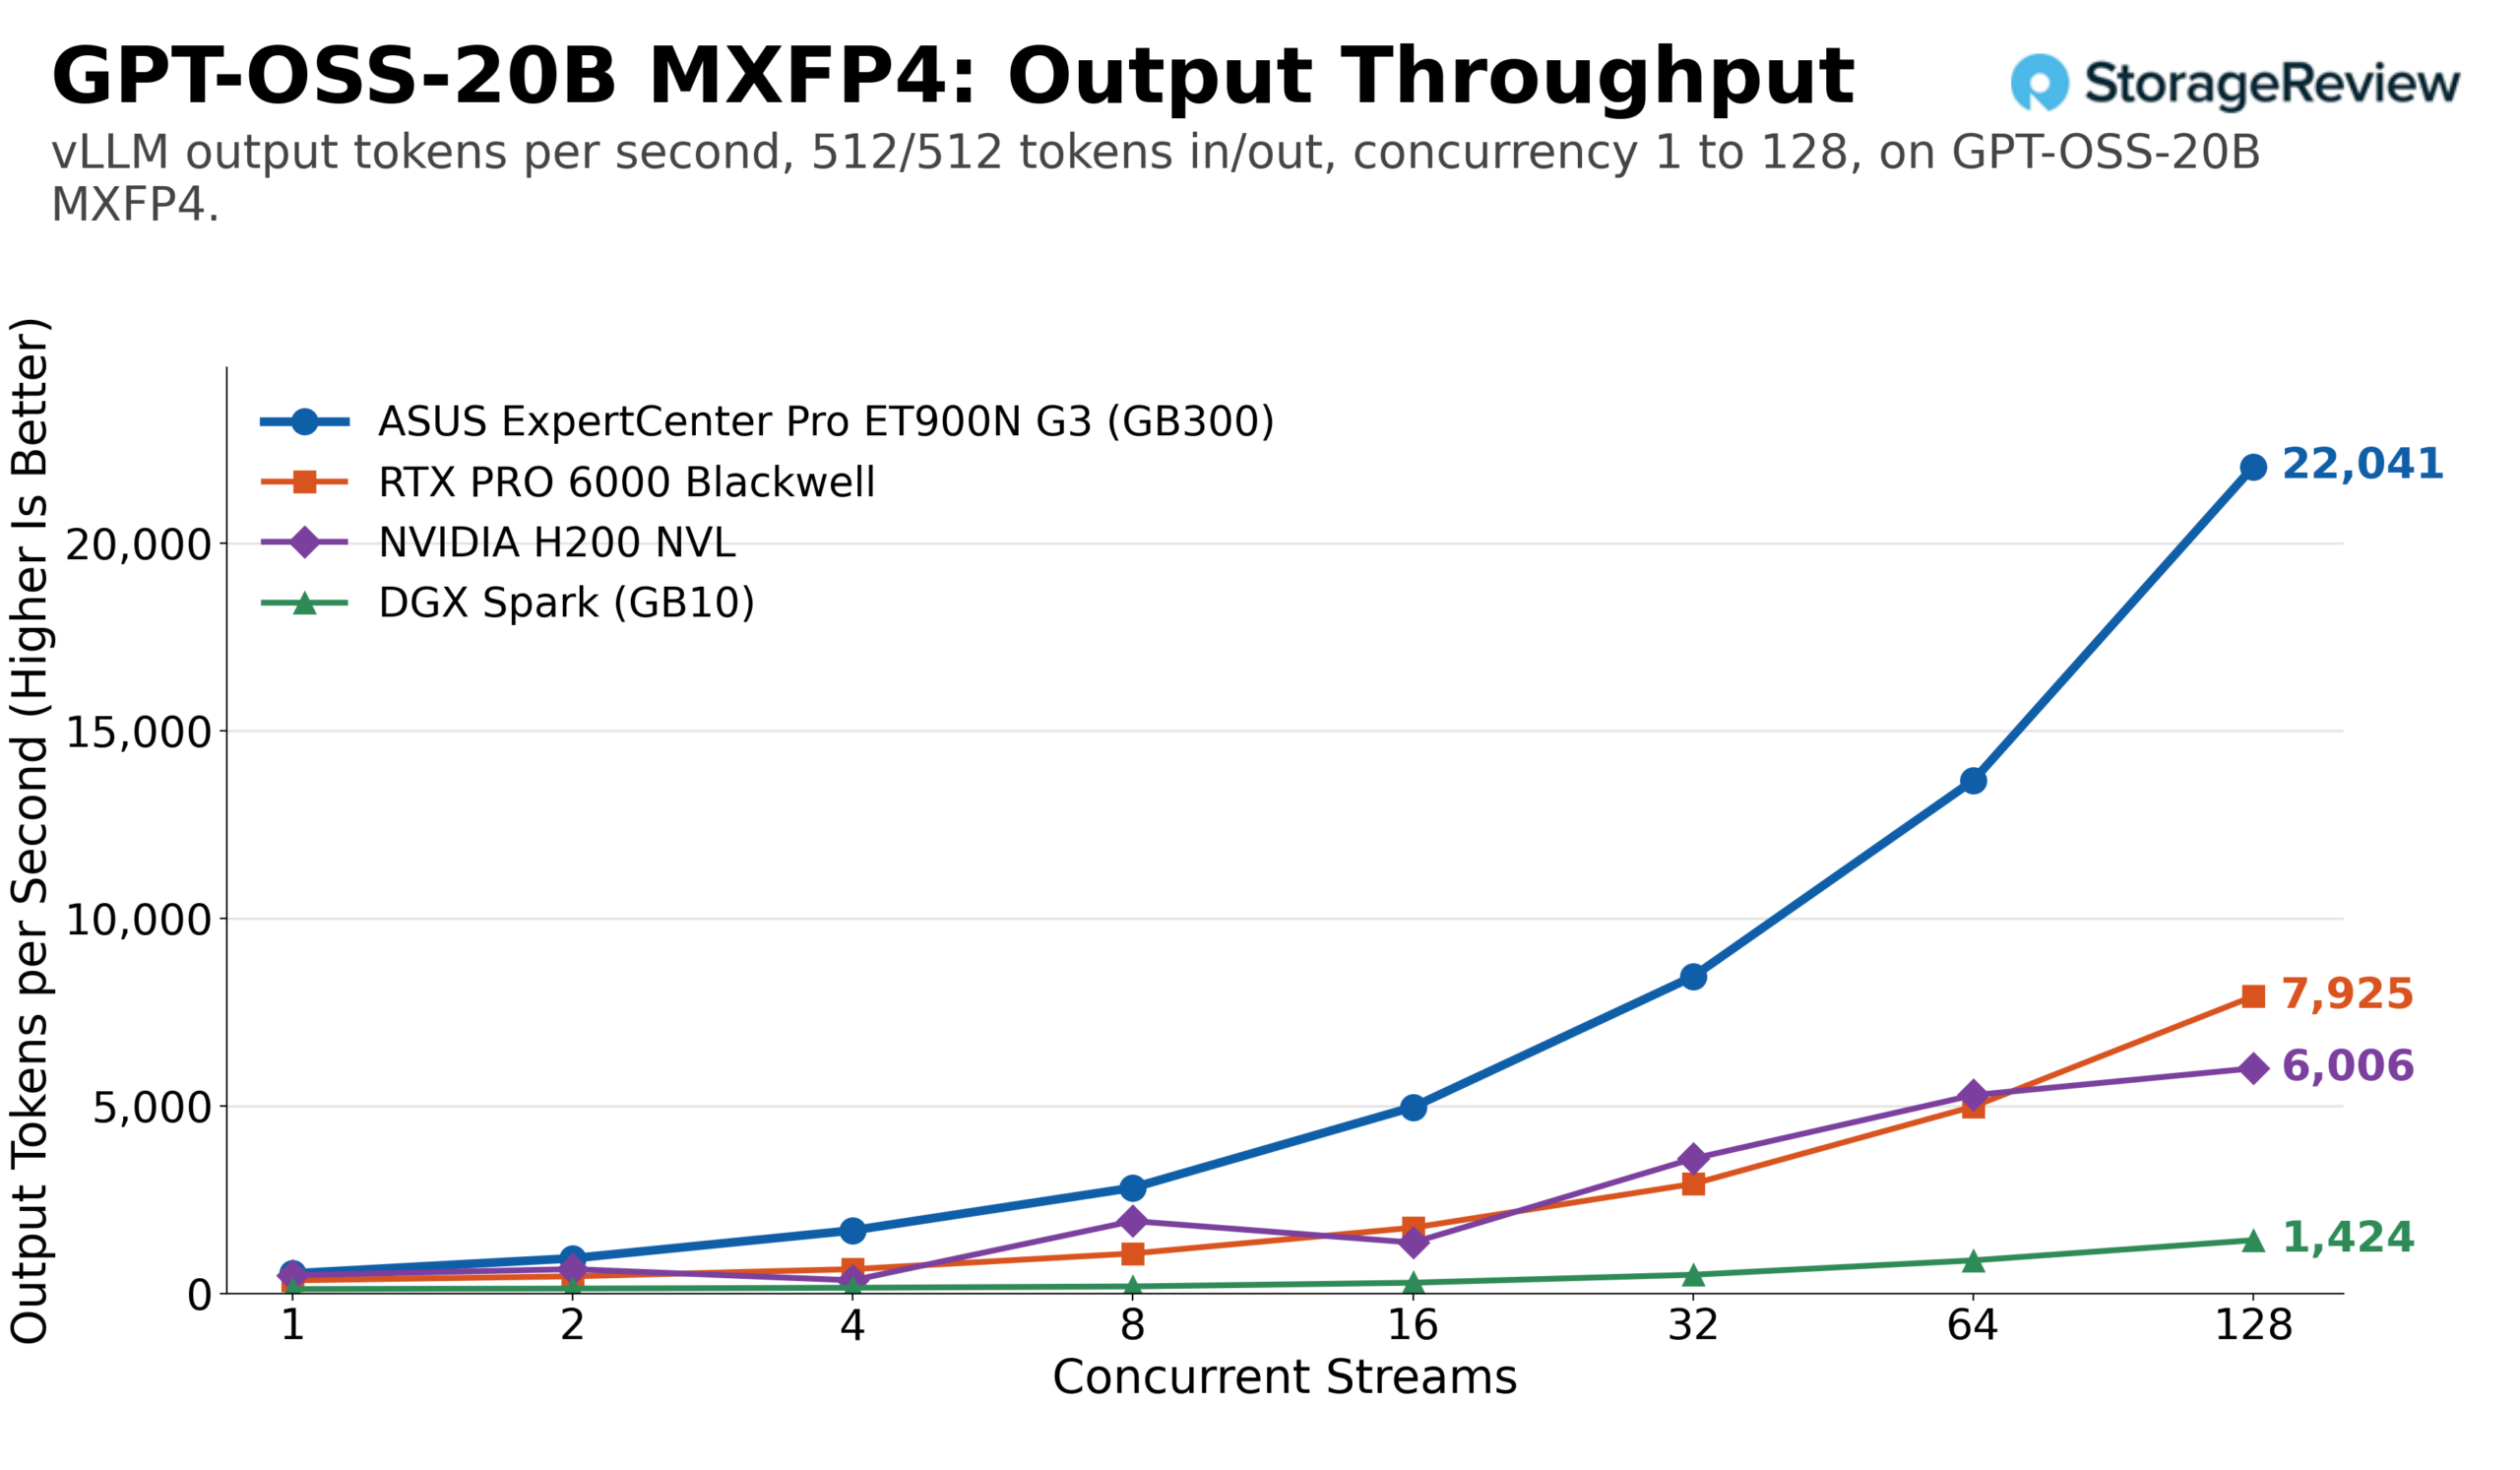
GPT-OSS-20B
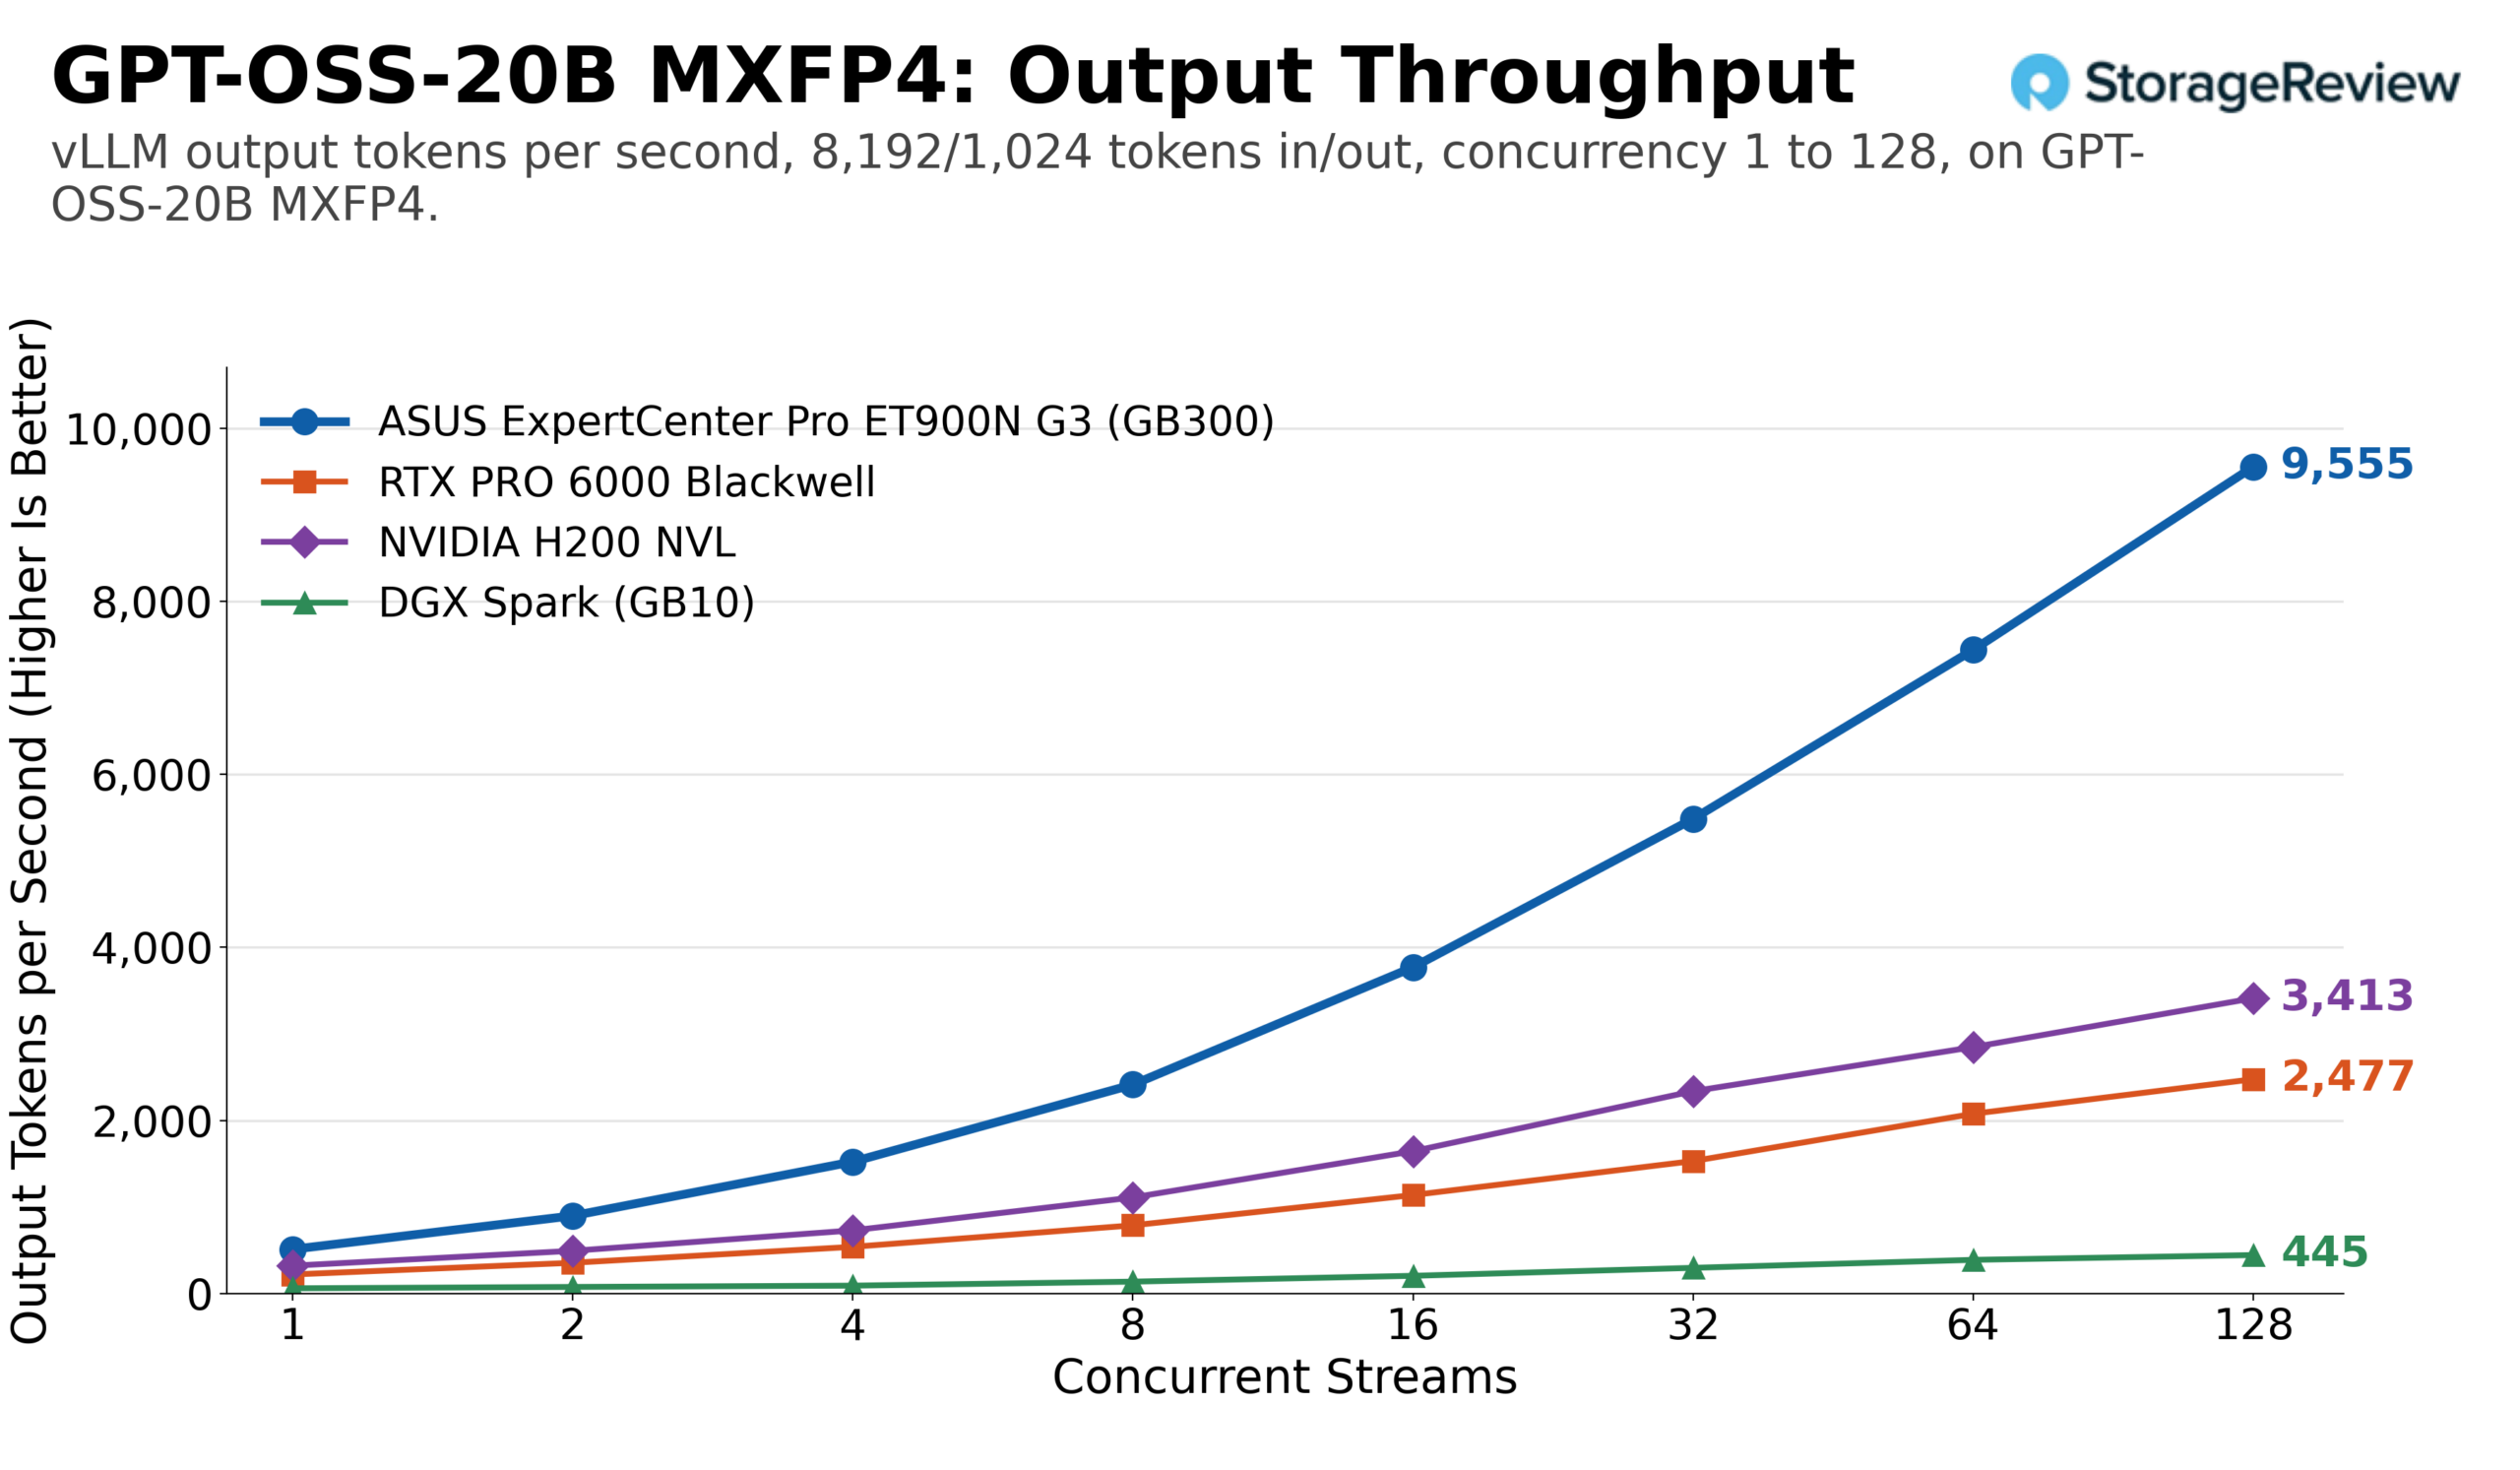
GPT-OSS-20B — самый легкий тест, где ET900N G3 на равной нагрузке масштабировалась до 22 041 токена в секунду при 128 потоках (или 44 082 суммарно) против 7920 у RTX PRO 6000, 6010 у H200 NVL и 1420 у DGX Spark. В однопоточном режиме станция выдала 536 токенов в секунду по сравнению с 354 у карты, 489 у H200 и 120 у Spark. Профиль с интенсивной предварительной генерацией увеличил разрыв: 9555 токенов в секунду (85 994 суммарно) при 128 потоках у станции, около 2480 у RTX PRO 6000, 3410 у H200 NVL и 445 у Spark.
GPT-OSS-120B
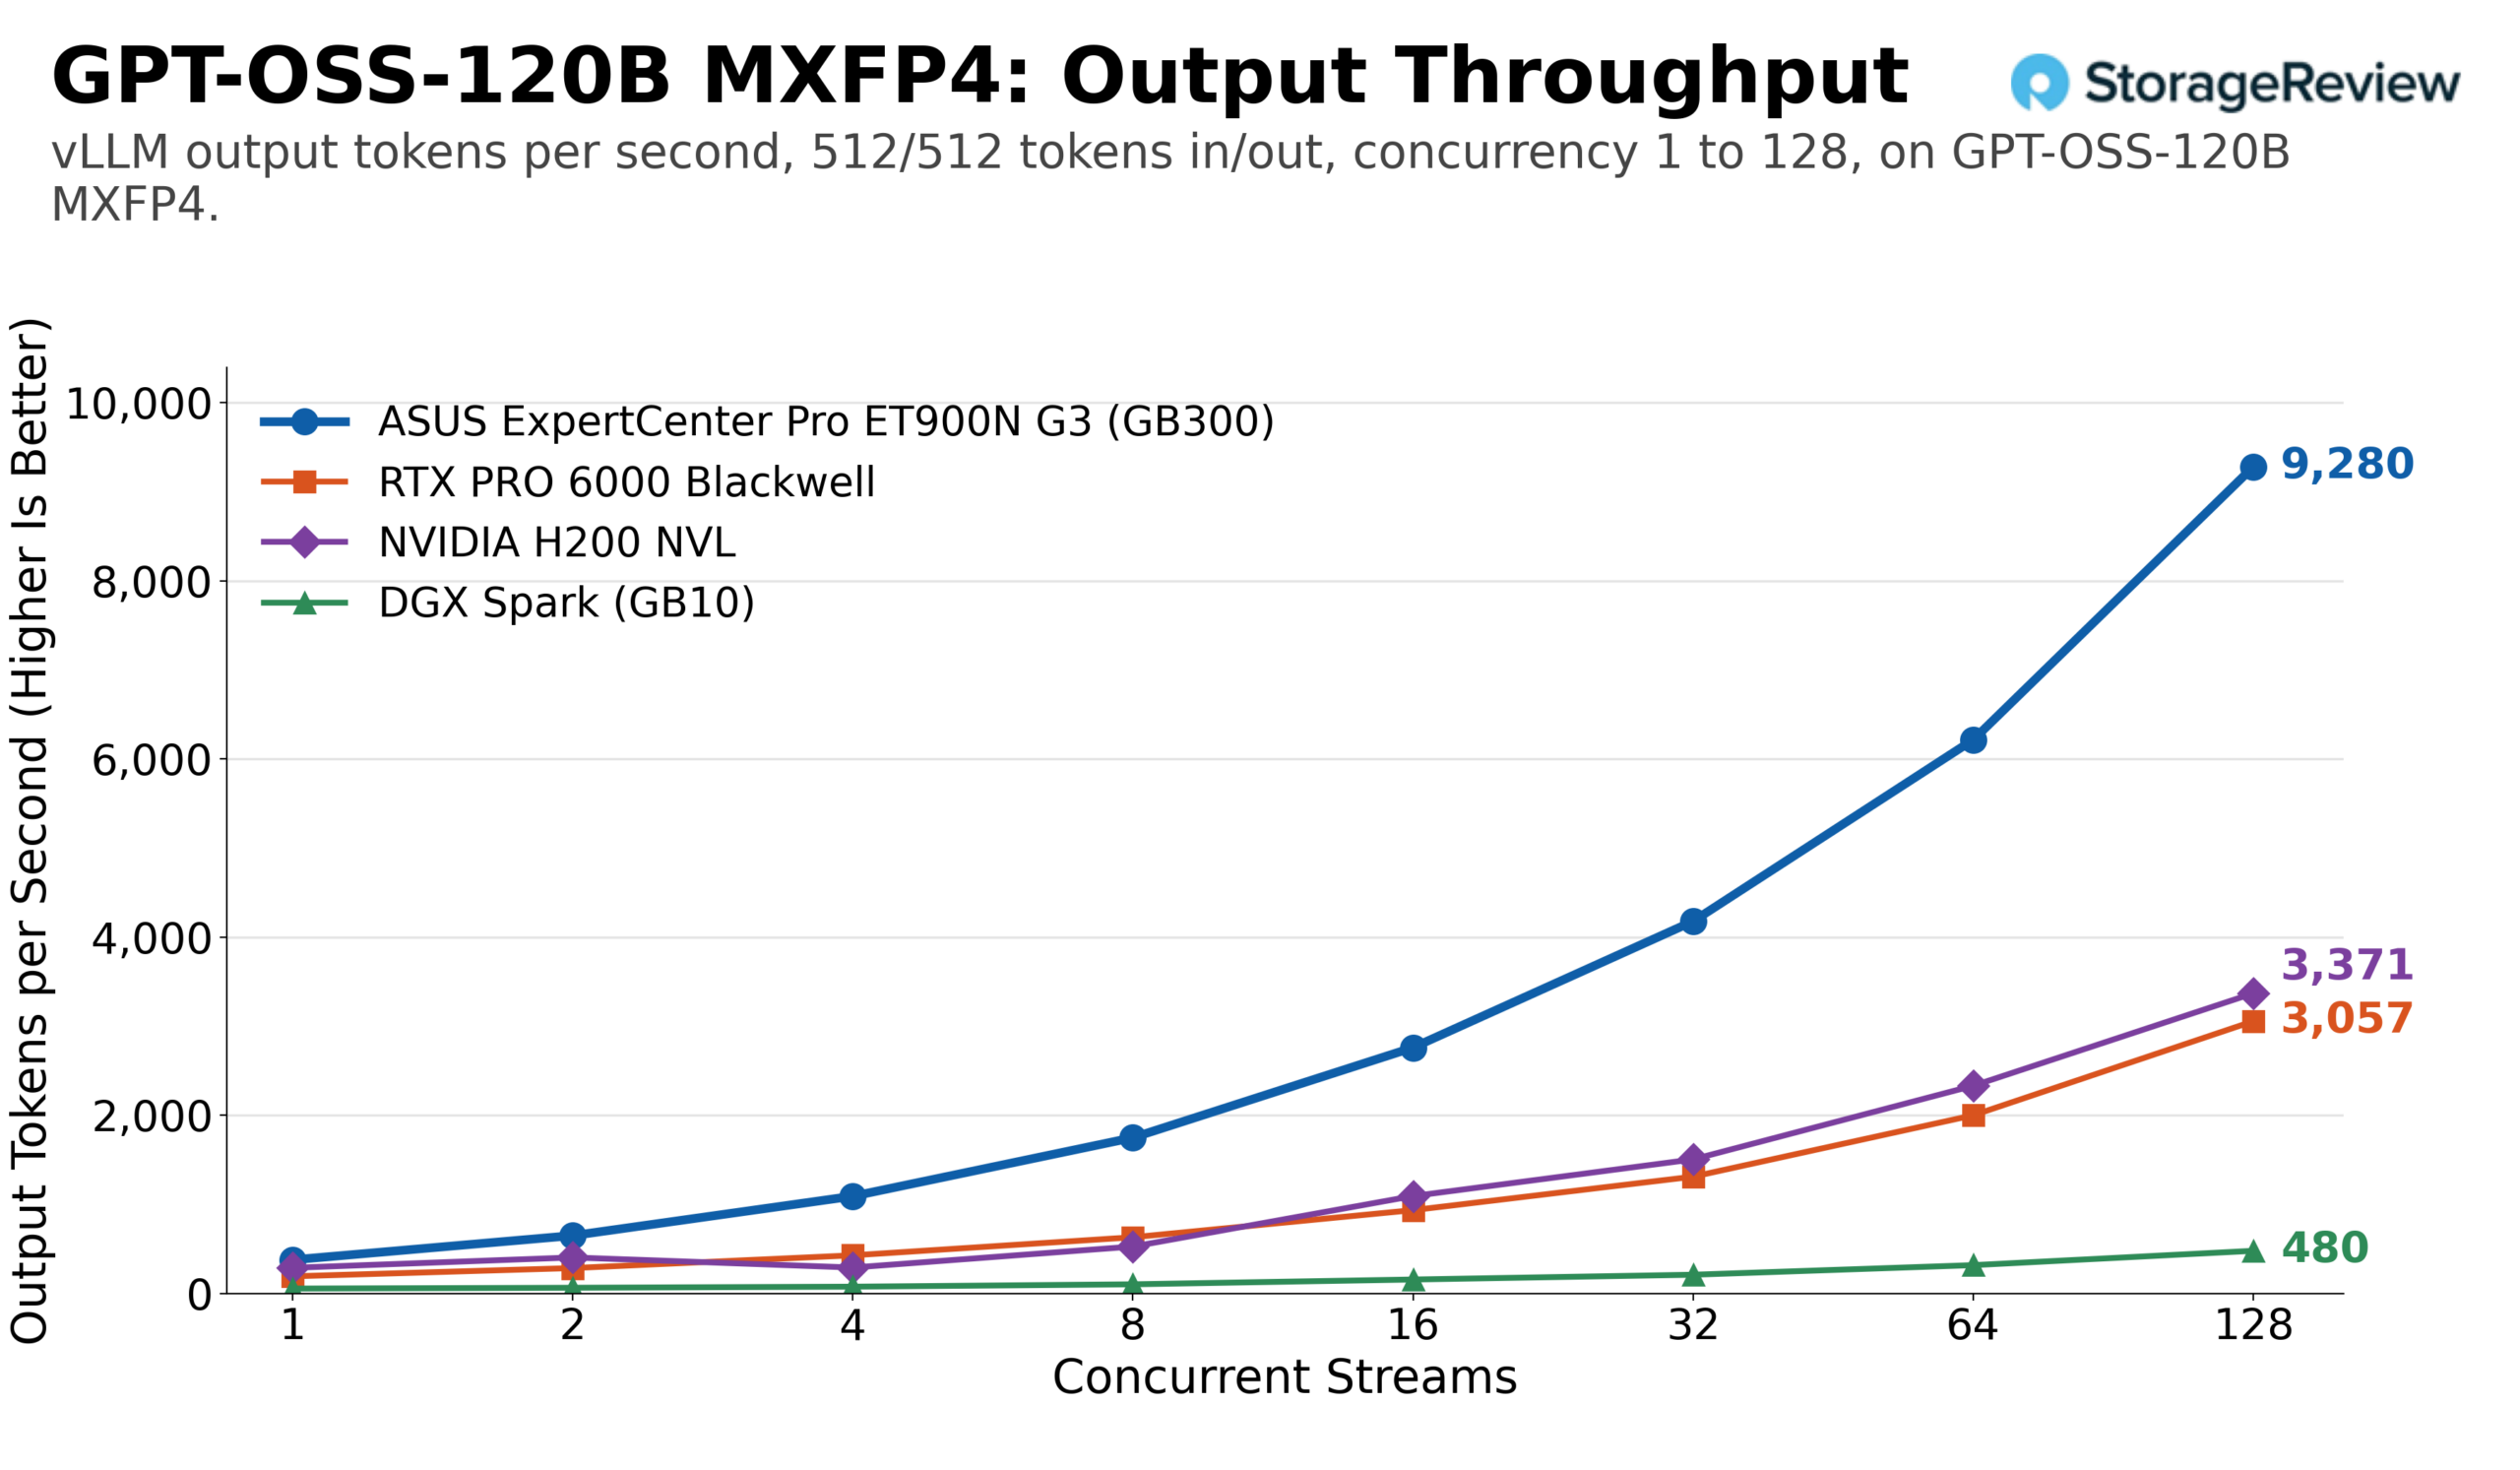
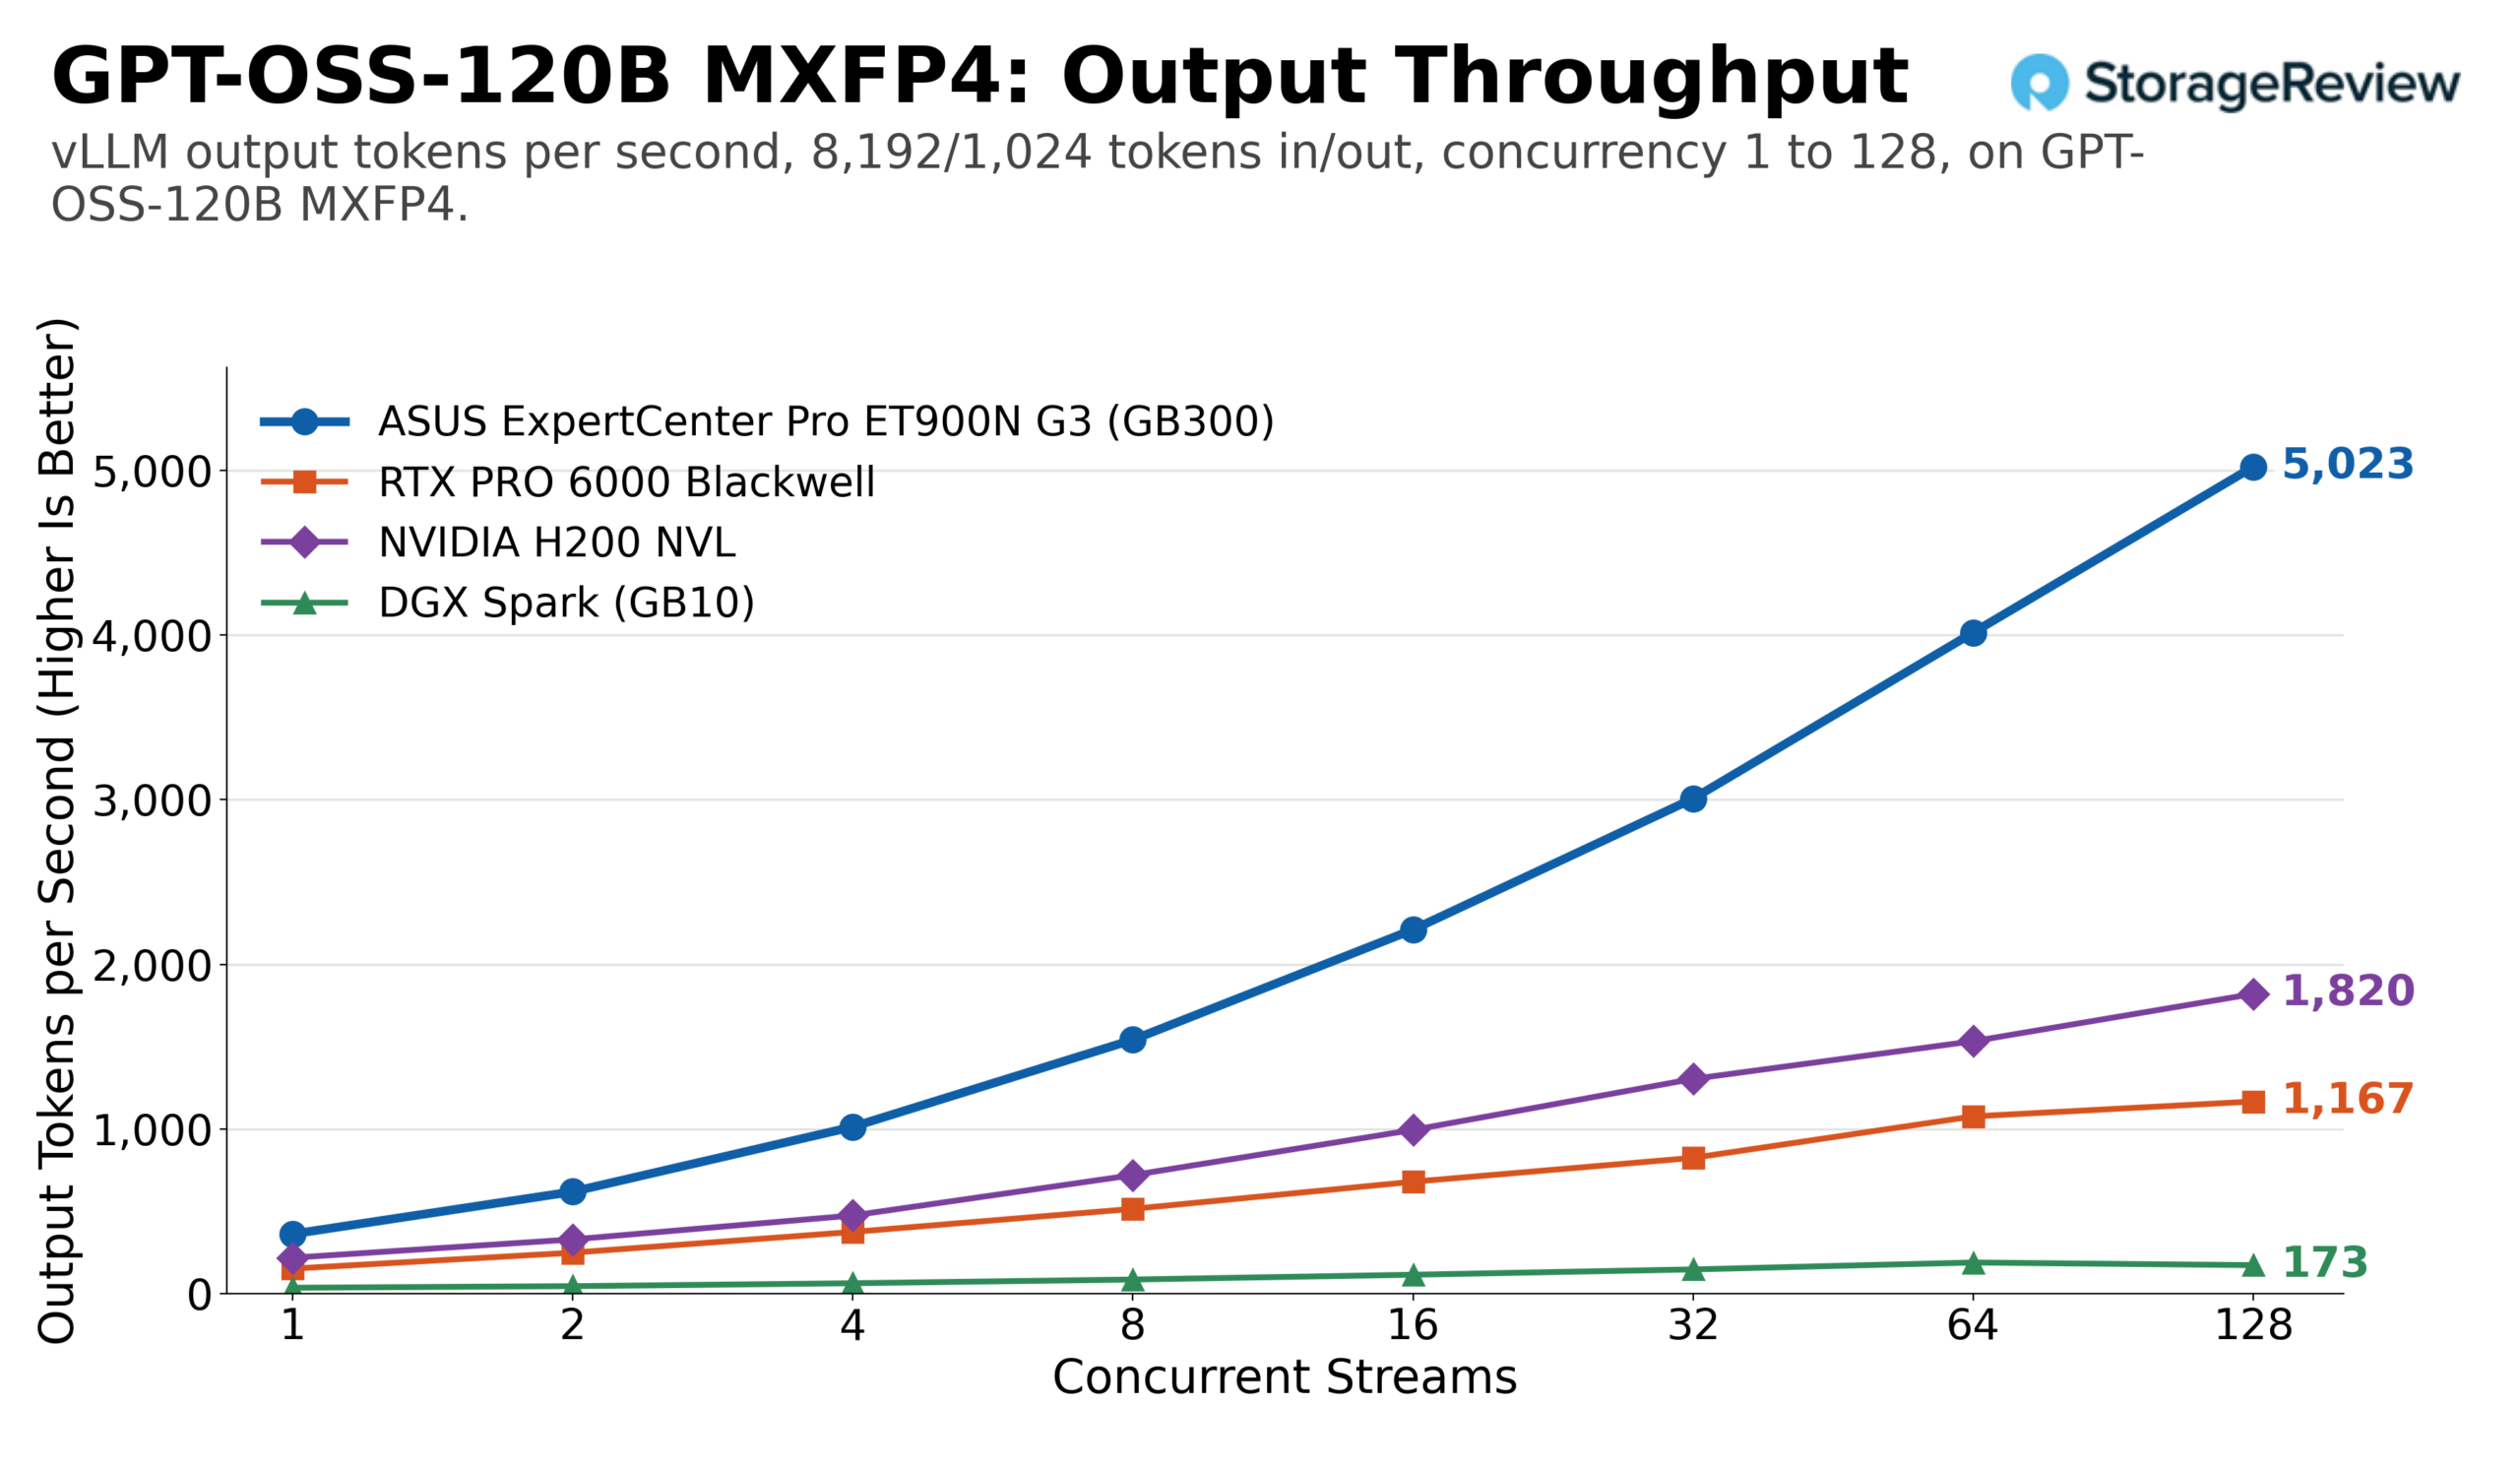
На модели GPT-OSS-120B объем памяти начинает определять расстановку сил. ET900N G3 достигла 9280 токенов в секунду на равной нагрузке при 128 потоках, что примерно в три раза выше показателей RTX PRO 6000 (3060), в 2,8 раза выше H200 NVL (3370) и более чем в 19 раз превышает показатели Spark (480). При длинных промптах малые системы быстро исчерпали запас KV-кэша: RTX PRO 6000 достигла максимума около 1170 токенов в секунду, H200 NVL — около 1820, в то время как станция продолжала рост до 128 потоков, завершив тест на 5023 токенах в секунду (45 205 суммарно).
Llama 3.1 8B и Mistral Small 24B
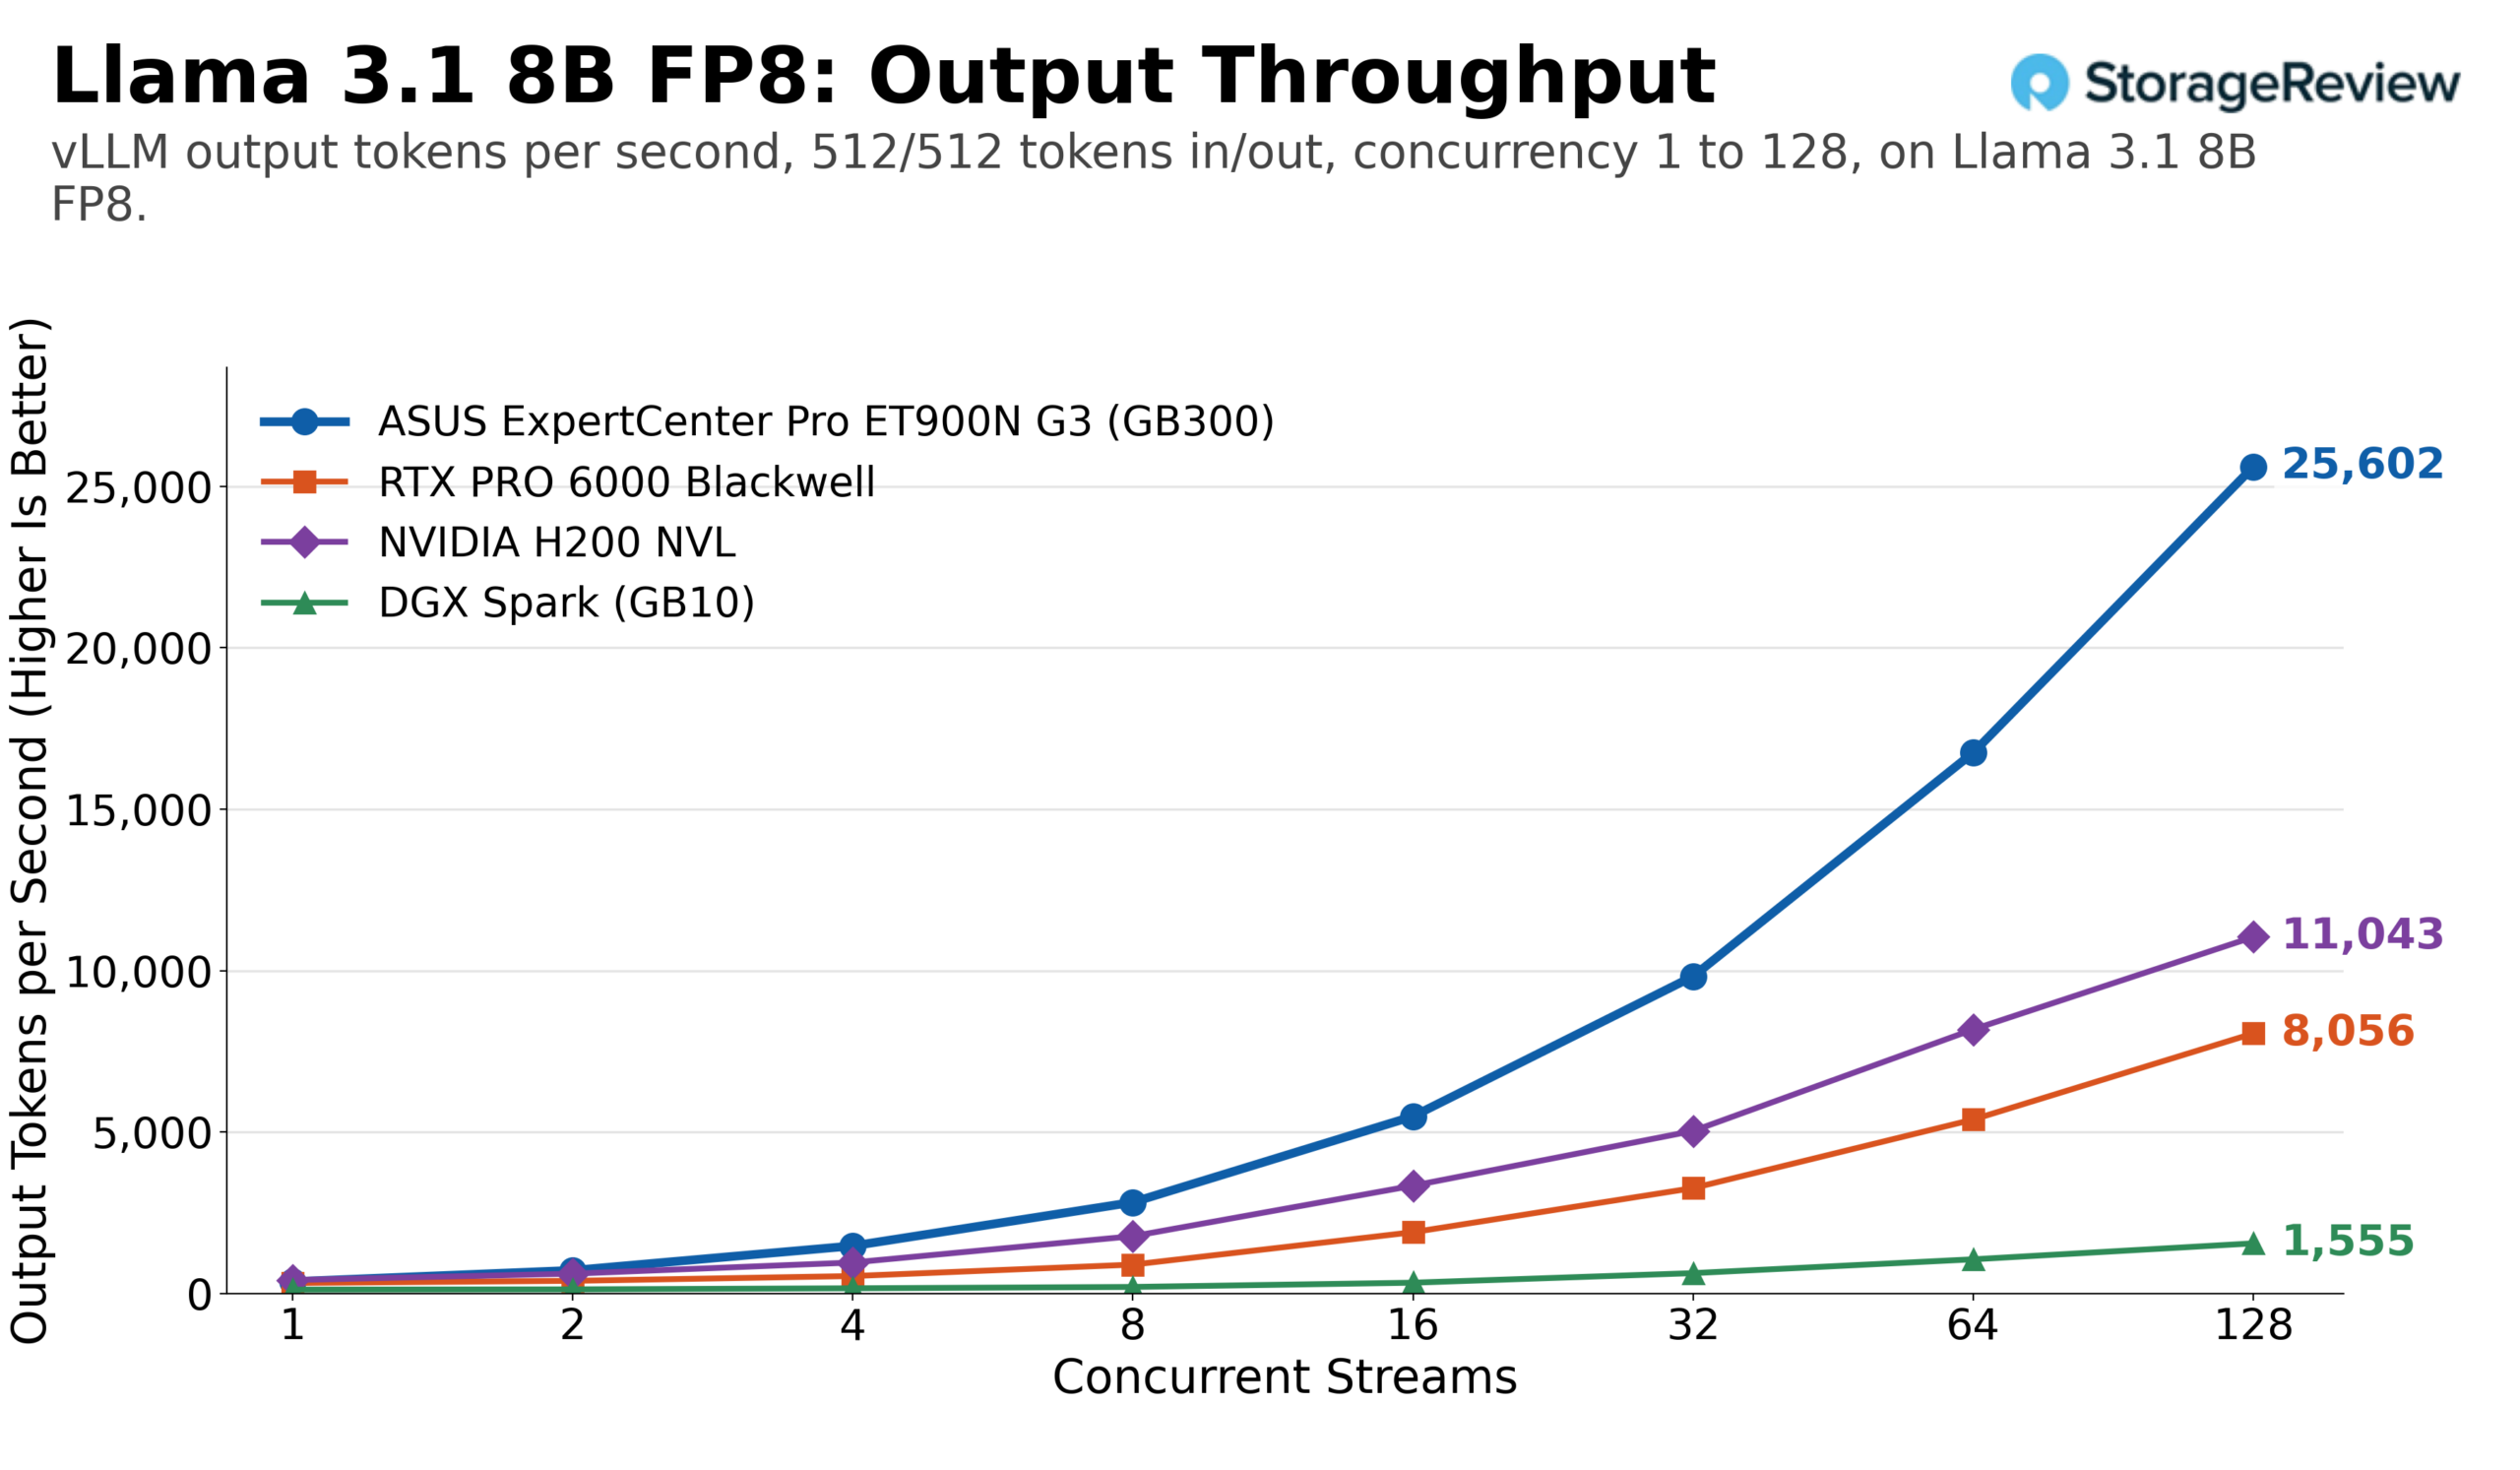
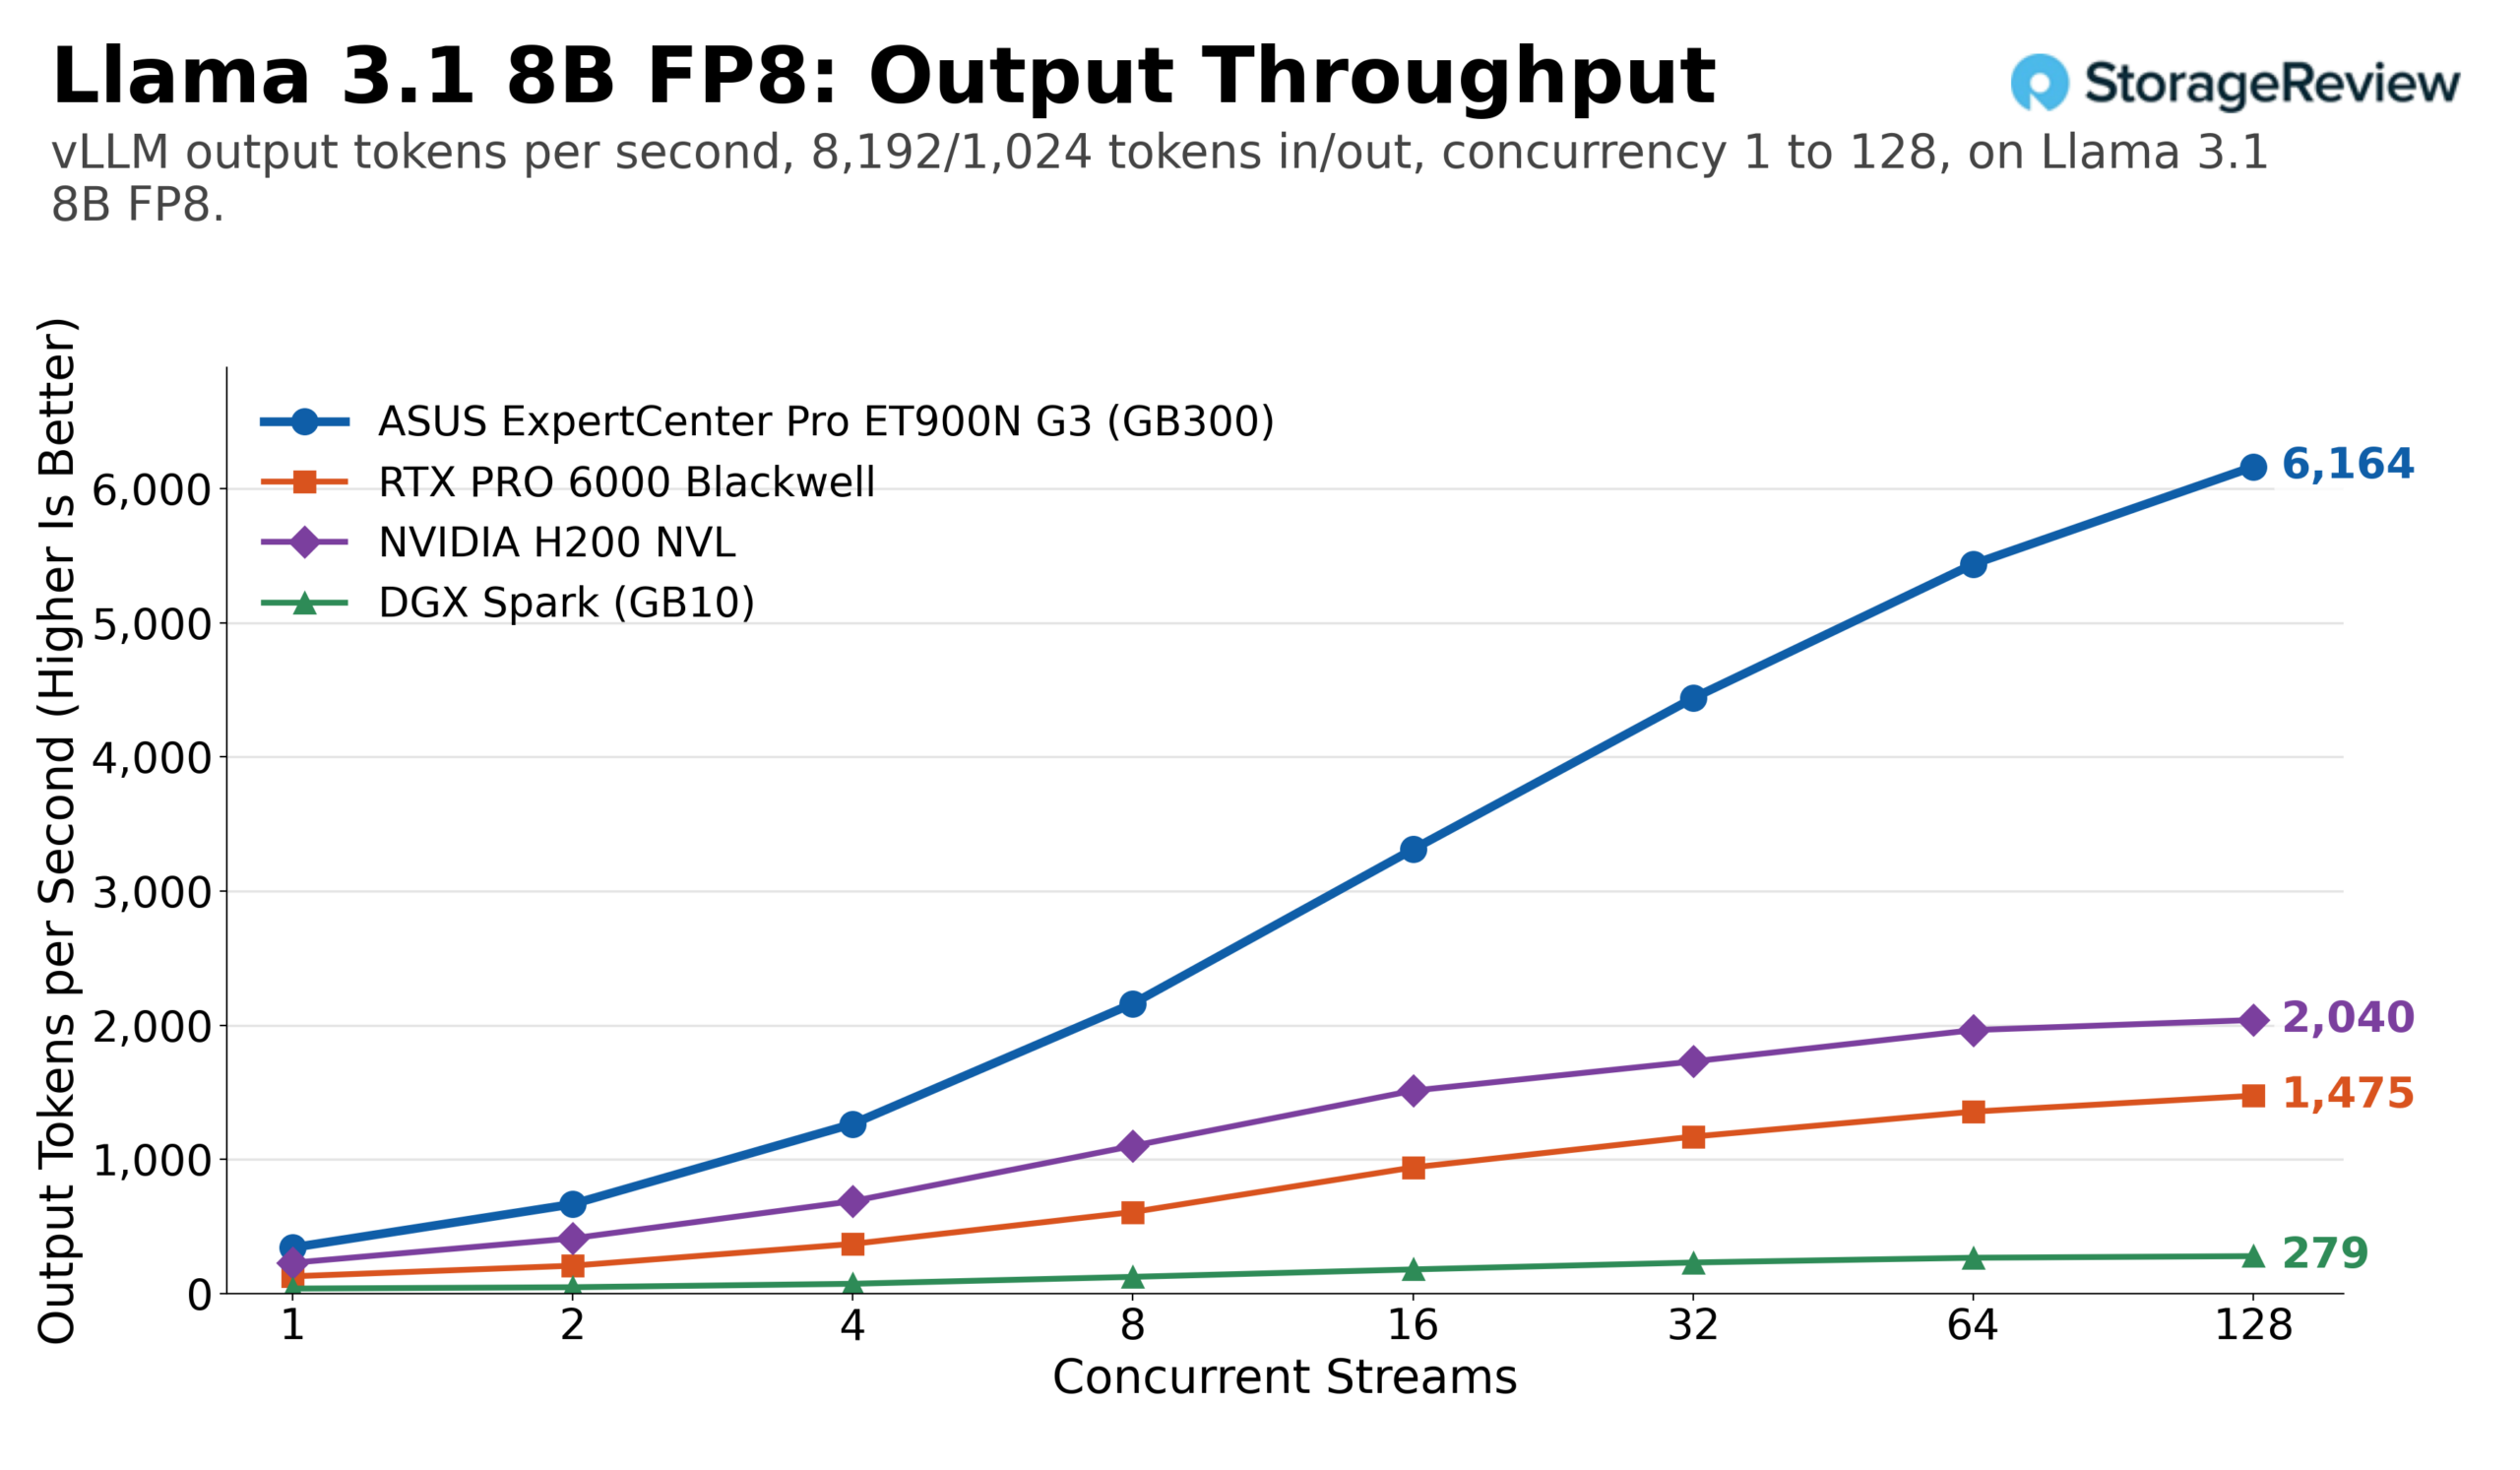
Модель Llama 3.1 8B в формате FP8 показала самые высокие абсолютные значения: ET900N G3 выдала 25 602 токена в секунду при 128 потоках на равной нагрузке (51 205 суммарно), против 8060 у RTX PRO 6000 и 11 040 у H200 NVL. Переход с BF16 на FP8 ускорил станцию примерно на 50% (с 17 074 до 25 602), RTX PRO 6000 — на 70%, а H200 NVL — на 37%. Профиль с интенсивной предварительной генерацией снизил показатели до 6164 токенов у станции, 1480 у карты и 2040 у H200.
Mistral Small 24B в формате FP8 продемонстрировала наибольшие коэффициенты разрыва: ET900N G3 достигла пика в 11 075 токенов в секунду на равной нагрузке, что в 3,4 раза быстрее RTX PRO 6000 (3240), в 2,4 раза быстрее H200 NVL (4610) и почти в 20 раз быстрее Spark (559).
Результаты тестирования и сравнение платформ
При использовании длинных промптов производительность RTX PRO 6000 достигала пиковых 32 потоков и около 480 токенов в секунду, после чего показатели снижались. H200 NVL в этих же условиях демонстрировала до 854 токенов в секунду, а станция достигала 2 302 токенов в секунду при 128 потоках.
В случае с моделью Qwen3 Coder 30B, представляющей собой смесь экспертов (MoE) с небольшим количеством активных параметров, разрыв при работе в один поток заметно сокращается. При выполнении одинаковой нагрузки в один поток RTX PRO 6000 выдавала около 232 выходных токенов в секунду, тогда как показатели станции составили 319 токенов, а H200 NVL — 308 токенов в секунду.
Использование пакетной обработки (batching) восстанавливает исходную расстановку сил: при 128 потоках ET900N G3 достигла 12 439 выходных токенов в секунду в формате FP8, что в 3,1 раза превышает показатель одной карты (3 990 токенов) и в 1,7 раза — результат H200 NVL (7 450 токенов). В профиле с высокой нагрузкой на префилл (prefill-heavy) станция достигла 3 837 выходных токенов в секунду, в то время как пиковые показатели RTX PRO 6000 составили около 880 токенов при 64 потоках, а H200 NVL — около 1 820 токенов в секунду.
При использовании общих моделей производительность ET900N G3 составила от 2,8 до 3,4 раза больше, чем у одиночной RTX PRO 6000, и от 1,7 до 3,7 раза больше, чем у H200 NVL при полной параллелизации. При этом отрыв от обоих решений увеличивался на длинных промптах по мере исчерпания запаса кэша KV.
Сравнение ASUS ET900N G3 и MSI WS300
Системы ET900N G3 и MSI XpertStation WS300 базируются на одинаковой материнской плате NVIDIA GB300 DGX Station, установленной в разные корпуса от OEM-производителей. Обе системы прошли через одни и те же 14 моделей, два типа рабочих нагрузок и одинаковые циклы тестирования параллелизации на одной и той же сборке vLLM.
В 24 из 28 пар «модель-нагрузка» разница в пиковой пропускной способности составила менее 2%, причем в большинстве случаев небольшое преимущество было на стороне WS300. Четыре пары вышли за пределы этого диапазона; три из них относятся к равной рабочей нагрузке: Llama 3.1 8B FP8 (отставание WS300 на 3,5%: 25 602 против 26 536 токенов в секунду), Qwen3 Coder 30B BF16 (отставание на 4,6%: 10 000 против 10 486 токенов) и Nemotron 3 Ultra 550B (отставание на 5,2%: 159 против 168 токенов). Также на длинных промптах Qwen3 Coder 30B BF16 показала отставание в 2,1%.
Поскольку каждая цифра получена в ходе единичного прогона, разрыв в 2–5% на трех моделях из 14 не позволяет сделать вывод о влиянии корпуса; данные лишь фиксируют наблюдаемый дельта-показатель. Модели, полагающиеся на когерентный пул памяти (MiniMax M3 и GLM-5.2), демонстрируют паритет или превосходство на обеих нагрузках. Это критически важный результат: путь разгрузки Grace в шасси ASUS работает так же эффективно, как и в MSI. Модели GPT-OSS-20B (наивысшая пропускная способность для плотных вычислений) и GLM-5.2 (кейс с выгрузкой) показывают практически полное совпадение графиков.
Выводы
ASUS ExpertCenter Pro ET900N G3 успешно подтверждает состоятельность эталонной платформы GB300. В 24 из 28 сравнений по 14 моделям пиковая пропускная способность vLLM находилась в пределах 2% от результатов MSI XpertStation WS300. Система обслуживала GLM-5.2 с 215 ГБ экспертных данных в памяти Grace со скоростями, недоступными для четырех карт RTX PRO 6000.
ASUS внесла практические улучшения: ручки для переноски делают 27-килограммовую башню удобной для транспортировки двумя людьми, вентилятор над корзинами QSFP112 решает проблему охлаждения при длительной работе 400G оптики, а блок питания класса Titanium экономит несколько ватт. Несмотря на общие реалии платформы (Arm-хост, питание от 20А цепи, вывод изображения только через BMC, общий бюджет 1600 Вт при установке большой карты), ASUS удалось создать качественную реализацию GB300 DGX Station.