Стартап TypeSafe AI меняет правила игры: почему чат-боты — тупиковая ветвь автоматизации
Последние пару лет индустрия искусственного интеллекта следовала привычному сценарию: новые модели становились крупнее, обучались лучше рассуждать, получали расширенные контекстные окна и более плавную манеру общения. Однако в этом месяце стартап TypeSafe AI пошел принципиально иным путем. Важно отметить, что основатель компании Диого Алмейда ранее работал в OpenAI, где занимался исследованиями обучения с подкреплением на основе отзывов людей (RLHF), которые превратили базовые языковые модели в ChatGPT. Стартап Алмейды провел два года в режиме секретности и недавно привлек 40 миллионов долларов инвестиций.
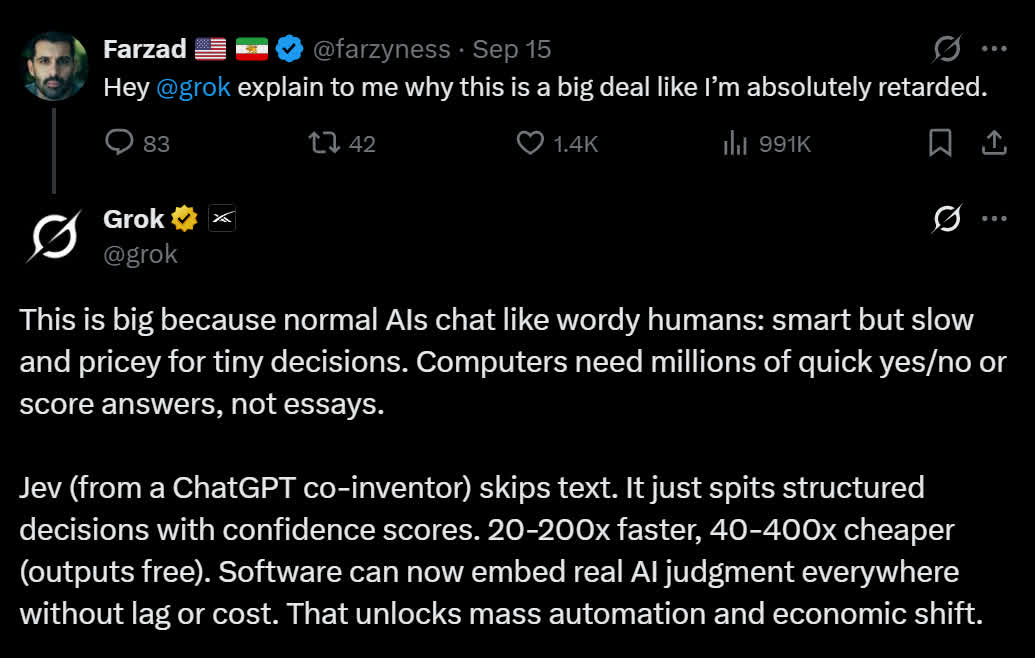
Сейчас компания представляет свою первую модель под названием Jev. В отличие от GPT и других чат-ботов, Jev не умеет писать электронные письма. У модели нет окна чата, и она не пытается давать пояснения к своим действиям. Ее ключевая функция — принятие быстрых решений: Jev справляется с задачей примерно за одну десятую секунды и за малую долю цента. Алмейда утверждает, что чат-интерфейс изначально не был подходящим инструментом для автоматизации.
Проблема «разговорчивых» компьютеров
В основе всех больших языковых моделей (LLM) лежит генерация текста: они создают контент по одному токену за раз, где каждое слово зависит от предыдущего. Это отлично работает, когда на другом конце линии находится человек. Однако с появлением ИИ-«агентов» такой подход становится неэффективным, так как «читателем» выступает другое программное обеспечение. В этом заключается главная дилемма текущего этапа развития ИИ: все большая доля взаимодействий происходит между программами, а не между человеком и машиной.
Софту не нужны абзацы текста. Программе требуется четкий ответ: «да» или «нет», число или категория. Сегодня разработчики, интегрирующие ИИ в приложения, задают модели вопрос и ждут, пока она напишет ответ. Затем этот текст необходимо разобрать, проверить и запустить процесс заново, если модель отклонилась от заданного формата. При этом каждое слово стоит денег, так как выходные токены обычно обходятся в несколько раз дороже входных.
Разработчик Матия Сошич наглядно продемонстрировал эту проблему. Если приложение запрашивает проверку счета на признаки мошенничества, LLM тратит более 8 секунд, чтобы написать предложение о том, что счет выглядит легитимным. Jev же отвечает за 0,1 секунды, выдавая три числа: 7% вероятности мошенничества, 88% — чисто, 5% — требуется проверка. Компания сознательно отказалась от генерации текста ради скорости — и в этом заключается суть их продукта.
Принципы работы Jev
Вместо промпта Jev получает «состояние» ситуации и набор предопределенных вопросов. Состояние может быть представлено билетом в службу поддержки, историей аккаунта пользователя или снимком игрового процесса. Предусмотрено три типа вопросов:
- Choice (Выбор): выбор одного варианта из 255 возможных.
- Score (Оценка): оценка чего-либо по шкале.
- Noul: фирменный термин TypeSafe для ответов типа «да/нет».
Каждый ответ сопровождается показателем вероятности, а все вопросы оцениваются одновременно в ходе одного параллельного прохода, а не последовательно, слово за словом. TypeSafe заявляет, что время отклика составляет от 70 до 500 миллисекунд, в то время как у передовых LLM этот показатель варьируется от 3 секунд до нескольких минут. Стоимость использования модели составляет 0,042 доллара за миллион входных токенов, при этом выходные токены бесплатны, так как генерации текста не происходит.
Инженер Паарангат Рай назвал Jev «ИИ-нативным оператором if». Традиционный код может помечать для проверки все транзакции свыше 10 000 долларов. С Jev правило меняется: если поведение выглядит подозрительным с уверенностью более 95%, отправить запрос человеку. Жестко заданный порог превращается в решение, основанное на суждении, а показатель уверенности определяет, когда к процессу подключается человек.
Почему это важно
Большая часть ИИ, с которым мы сталкиваемся ежедневно — это не чат-боты, а невидимый слой решений: спам-фильтры, маркеры мошенничества, маршрутизация обращений в поддержку и модерация контента. Компьютерам нужны миллионы быстрых суждений, а не эссе. Скорость меняет возможности ИИ-агентов. Каждый, кто видел, как ИИ-агент перемещается по веб-сайту, знает: каждый клик — это многосекундный запрос. Демонстрации TypeSafe подтверждают это: Jev играет в Doom со скоростью 10 решений в секунду (примерно 7 долларов в час), считывая текстовое описание состояния игры, а не пиксели.
В блиц-шахматном матче с участием сторонних систем Jev победил модель Fable 5.1 от Anthropic, несмотря на значительную нехватку материала: Fable просто тратила все время на «размышления». Модель OpenAI GPT-6 Astra поставила мат Jev на 18-м ходу. Это результат задержки, а не качества игры, но он наглядно показывает, что дает высокая скорость.
Наименее примечательным, но, возможно, самым важным вариантом использования является верификация. При таких ценах разработчик может проверять каждый вывод более крупной и «умной» модели, прежде чем он дойдет до пользователя или инициирует действие. Ранее такой надзор был слишком медленным и дорогим для массового внедрения.
Этическая дилемма и природа ответственности
Разработчик Алекс провел тестирование модели Jev на классической «проблеме вагонетки», повторив сценарий 100 раз: пять человек на основном пути и один на запасном. В каждом из 100 случаев Jev переводил стрелку, демонстрируя при этом 99-процентный уровень уверенности. В шутливой подписи к результатам эксперимента автор отметил, что доверил бы Jev свою жизнь. В ответ на это один из пользователей Hacker News резонно заметил, что аналогичный результат можно получить бесплатно и без подключения к сети с помощью простейшего оператора if из двух строк кода.
Это наблюдение подчеркивает важную особенность: последовательность принятия решений является ключевым преимуществом. В отличие от обычных чат-ботов, которые могут выдавать разные ответы на один и тот же вопрос при повторном запросе, Jev лишь выбирает из предложенных вариантов. Таким образом, ответственность за принятие решения фактически ложится на того, кто проектирует меню выбора и устанавливает порог уверенности для выполнения действия.
Анализ надежности и методология тестирования
Скептическое отношение к запуску Jev на ресурсе Hacker News имеет под собой веские основания. Утверждение о том, что модель «не может галлюцинировать», является весьма узким: Jev не способен выдать ответ, отсутствующий в предложенном списке, и не может «выдумать» чрезвычайно высокий уровень риска, если в опциях доступны только «низкий», «средний» и «высокий». Тем не менее, модель способна с высокой степенью уверенности выбрать неверный вариант.
Что касается производительности, то бенчмарки были предоставлены самой компанией TypeSafe, которая предпочла не использовать публичные рейтинговые таблицы. Внутренние тесты оценивали модели на основе совпадения их ответов с усредненными результатами GPT-6 Astra и Fable 5.1, а не на основе верифицированных эталонных данных. Согласно этим замерам, общий показатель согласия Jev составил около 67,8% против 74,1% у GPT-5.6 Sol. В сфере обслуживания клиентов модель показала результат 76% (против 78,3%), а в задачах по обработке счетов значительно отстала — 61,8% против 79,1%.
Заявленные показатели — ускорение в 193,6 раза и экономия затрат в 444,6 раза — базируются на этих же тестах. Как отмечает Сарвагья Кулшрештха, сама TypeSafe признает, что эти цифры отражают верхний предел реальных преимуществ. Несмотря на ограниченность, независимые тесты показывают обнадеживающие результаты:
- В ходе одного из первых экспериментов было обработано 777 суждений из архива писателя менее чем за 0,7 секунды при затратах около четверти цента.
- В другом испытании Jev выявил 6 из 7 намеренно внедренных ошибок в тексте, в то время как Fable 5.1 обнаружил все 7. При этом Jev работал примерно в 25 раз быстрее и был в 580 раз дешевле.
Данный компромисс в качестве для многих задач представляется незначительным. Среди прочих ограничений — текущая версия раннего доступа Jev работает исключительно с текстом и структурированными данными, не поддерживая изображения. Кроме того, TypeSafe до сих пор не опубликовала статью об архитектуре модели или количестве её параметров.
Философия «парадокса Джевонса» и будущее ИИ
Название модели несет в себе её фундаментальную концепцию. В 1865 году экономист Уильям Стэнли Джевонс заметил, что повышение эффективности паровых двигателей не привело к сокращению потребления угля. Напротив, уголь стал настолько дешевым, что его начали использовать повсеместно, и общий объем потребления резко возрос. TypeSafe делает ставку на то, что каждое десятикратное снижение стоимости принятия ИИ-решений откроет гораздо больше сценариев использования, чем удастся сэкономить.
Хотя успех этой стратегии не гарантирован, Jev нацелен не на индивидуальных пользователей, а на миллиарды мелких, рутинных решений, которые ежедневно принимает программное обеспечение и которые не оправдывают использование дорогих вызовов LLM. По словам Куна Чена, здесь прослеживается связь с прорывом 2017 года: тогда архитектура Transformer победила, отказавшись от последовательной обработки в пользу параллельного внимания, что в итоге легло в основу современных чат-ботов. Jev, в свою очередь, отказывается от генерации текста — того, что сделало предыдущие модели популярными, — ради достижения максимальной скорости. Возможно, долгосрочное будущее ИИ-индустрии заключается не в использовании одного гигантского универсального ИИ, а в сочетании «медленных» интеллектуальных моделей для сложных задач и быстрых, дешевых «решателей» для всего остального.