Как оптимизировать потребление токенов в Claude Code и сократить пустой контекст
В постоянных поисках способов выжать максимум из подписки на Claude Code без упирания в лимиты автор ранее экспериментировал с настройкой усилия (effort setting). Снижение параметра с High до Medium сократило расход выходных токенов на 45% в пяти различных тесках без заметного падения качества результатов. После этого возник вопрос о том, что еще можно оптимизировать, но на этот раз не во время работы модели, а до отправки каких-либо пользовательских запросов.
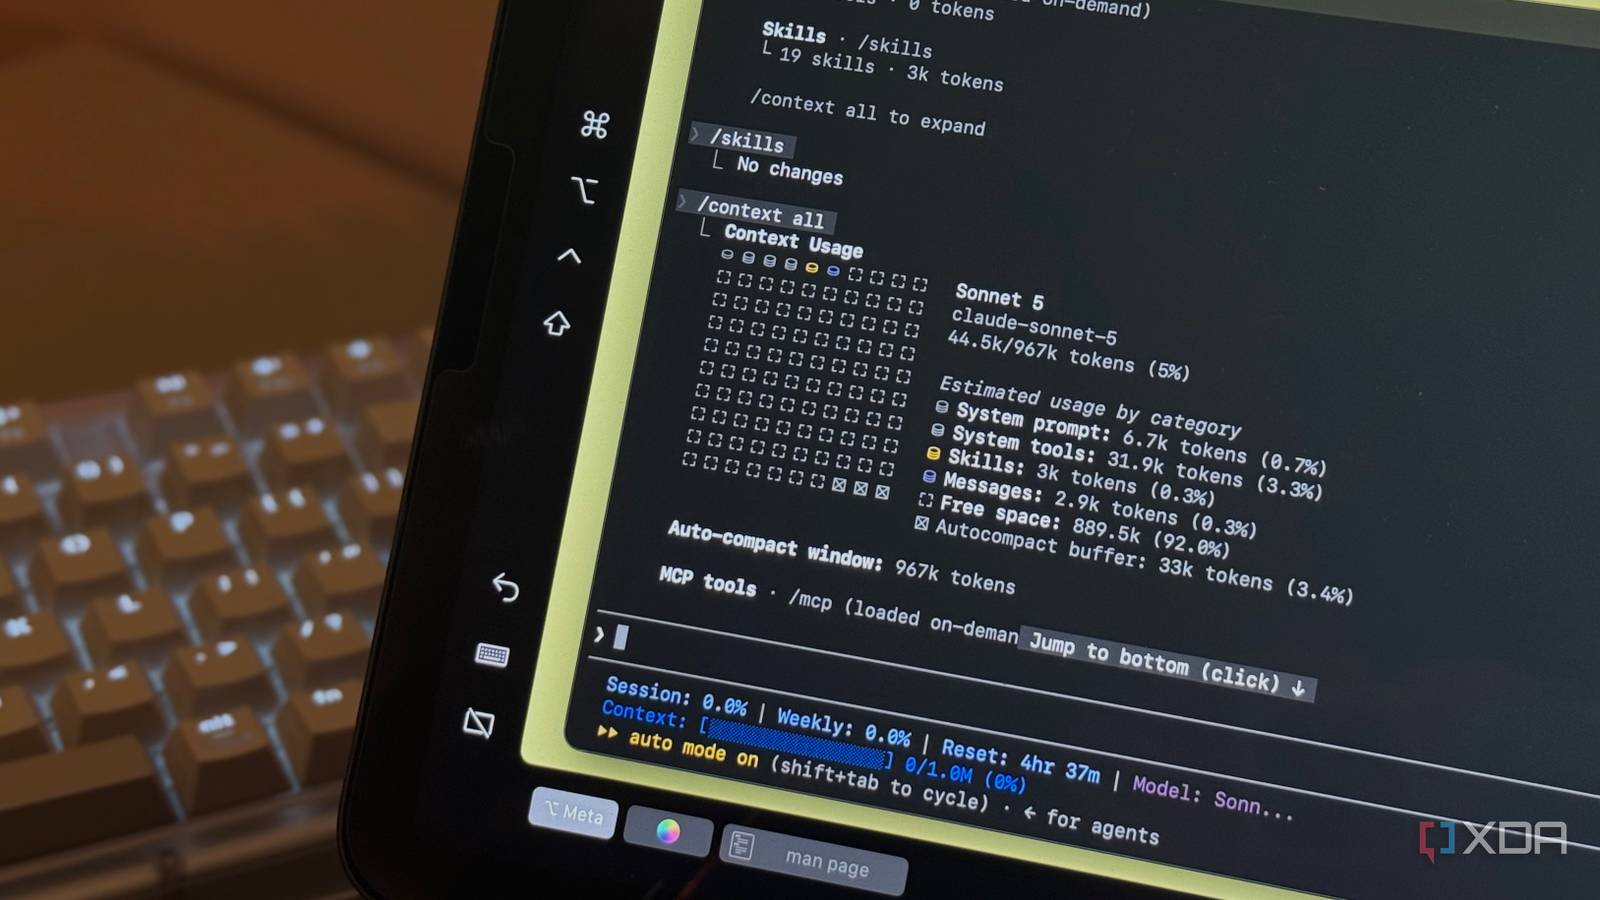
Объем таких фоновых затрат составил 51 000 токенов, что оказалось значительно больше ожидаемого, и заставило автора попытаться вернуть как можно больше этого пространства.
Как работает контекстное окно языковой модели
Контекстное окно представляет собой рабочую память большой языковой модели (LLM) для текущей сессии. В нем должно помещаться все, что нужно отслеживать в процессе работы: отправляемые промпты, генерируемые ответы, прочитанные файлы и информация, подтягиваемая инструментами. Чем больше становится работающий контекст, тем больше информации Claude вынужден переносить по мере продолжения беседы.
В случае с Claude Code контекстное окно не начинается с нуля. Перед вводом первого промпта утилита уже загружает необходимую для функционирования информацию, включая системный промпт, встроенные инструменты, описания навыков, пользовательских агентов и любые другие инструкции или контекст, добавляемые автоматически.
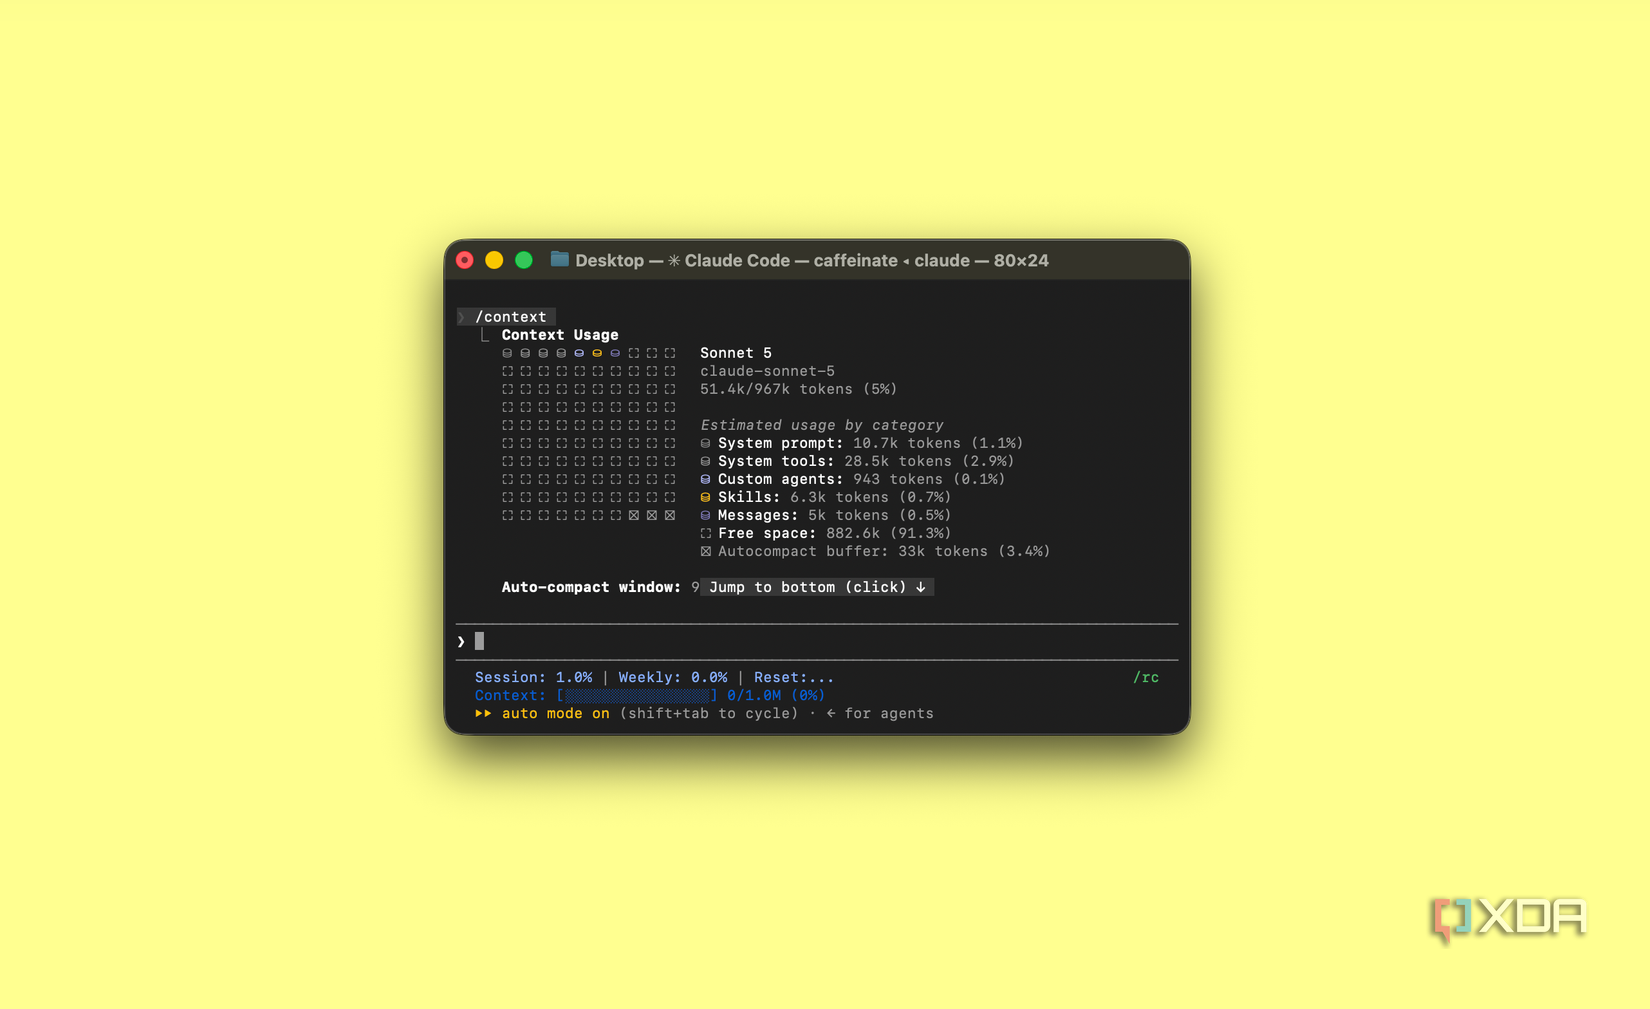
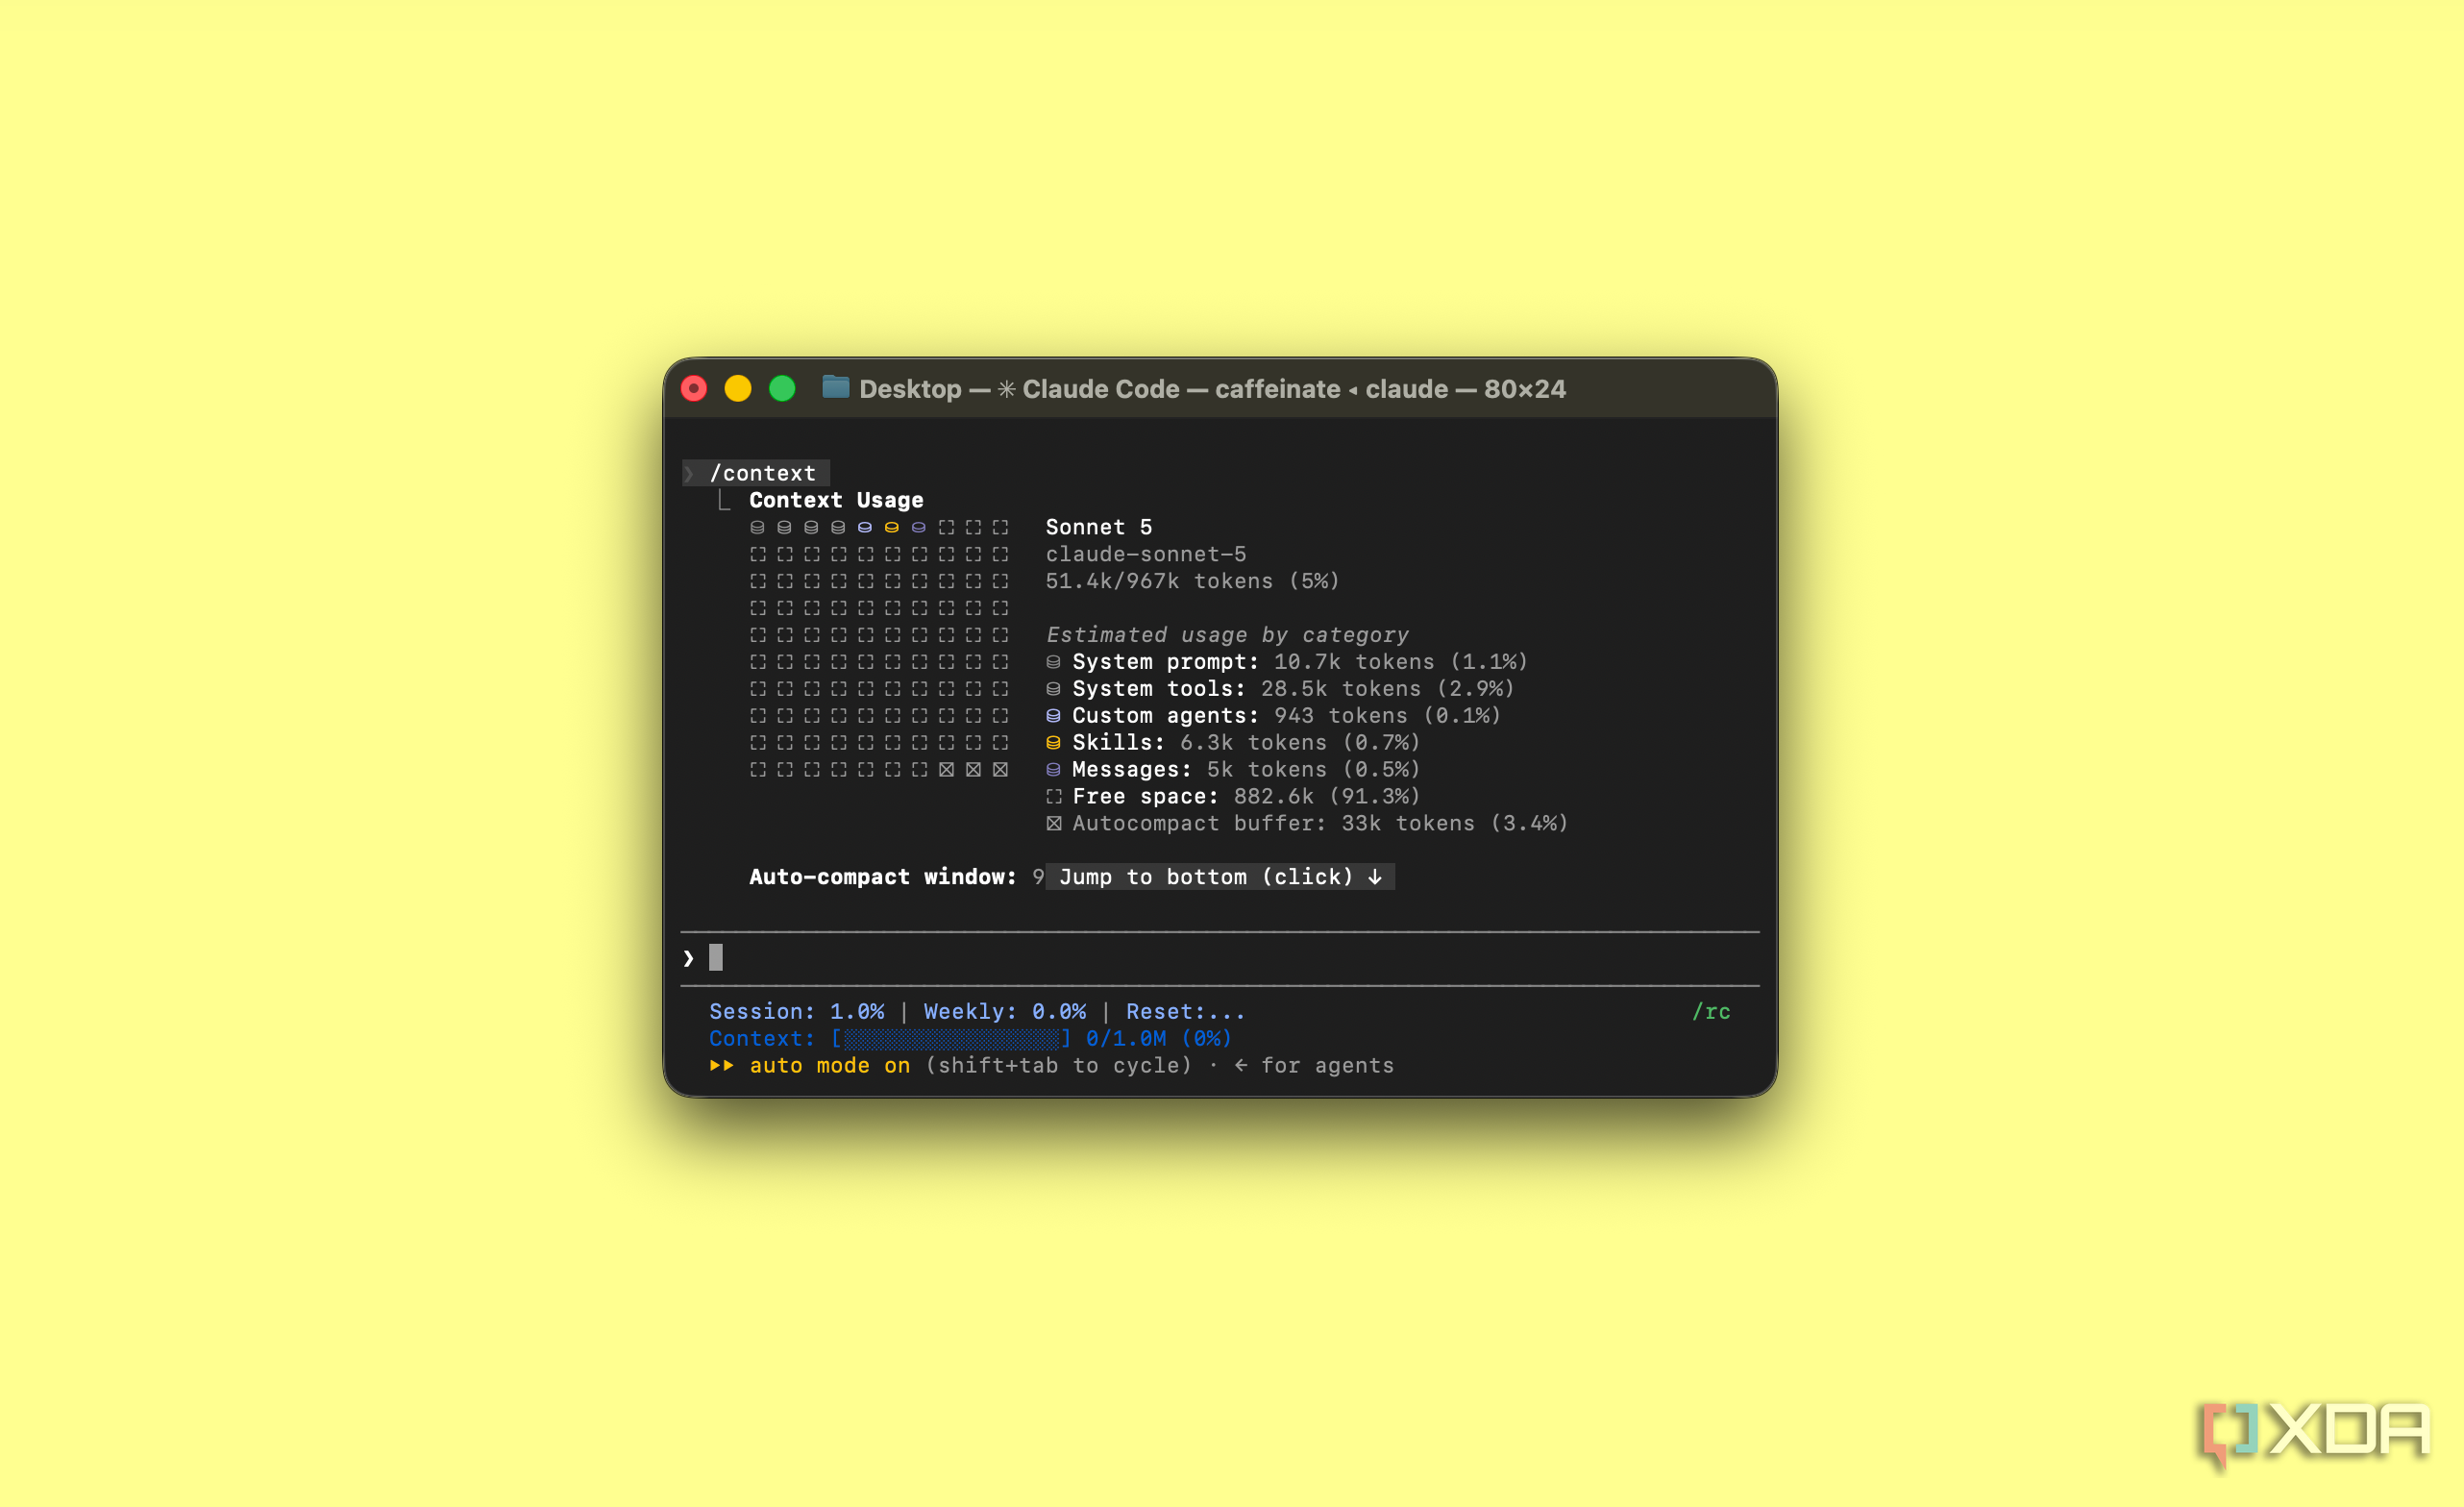
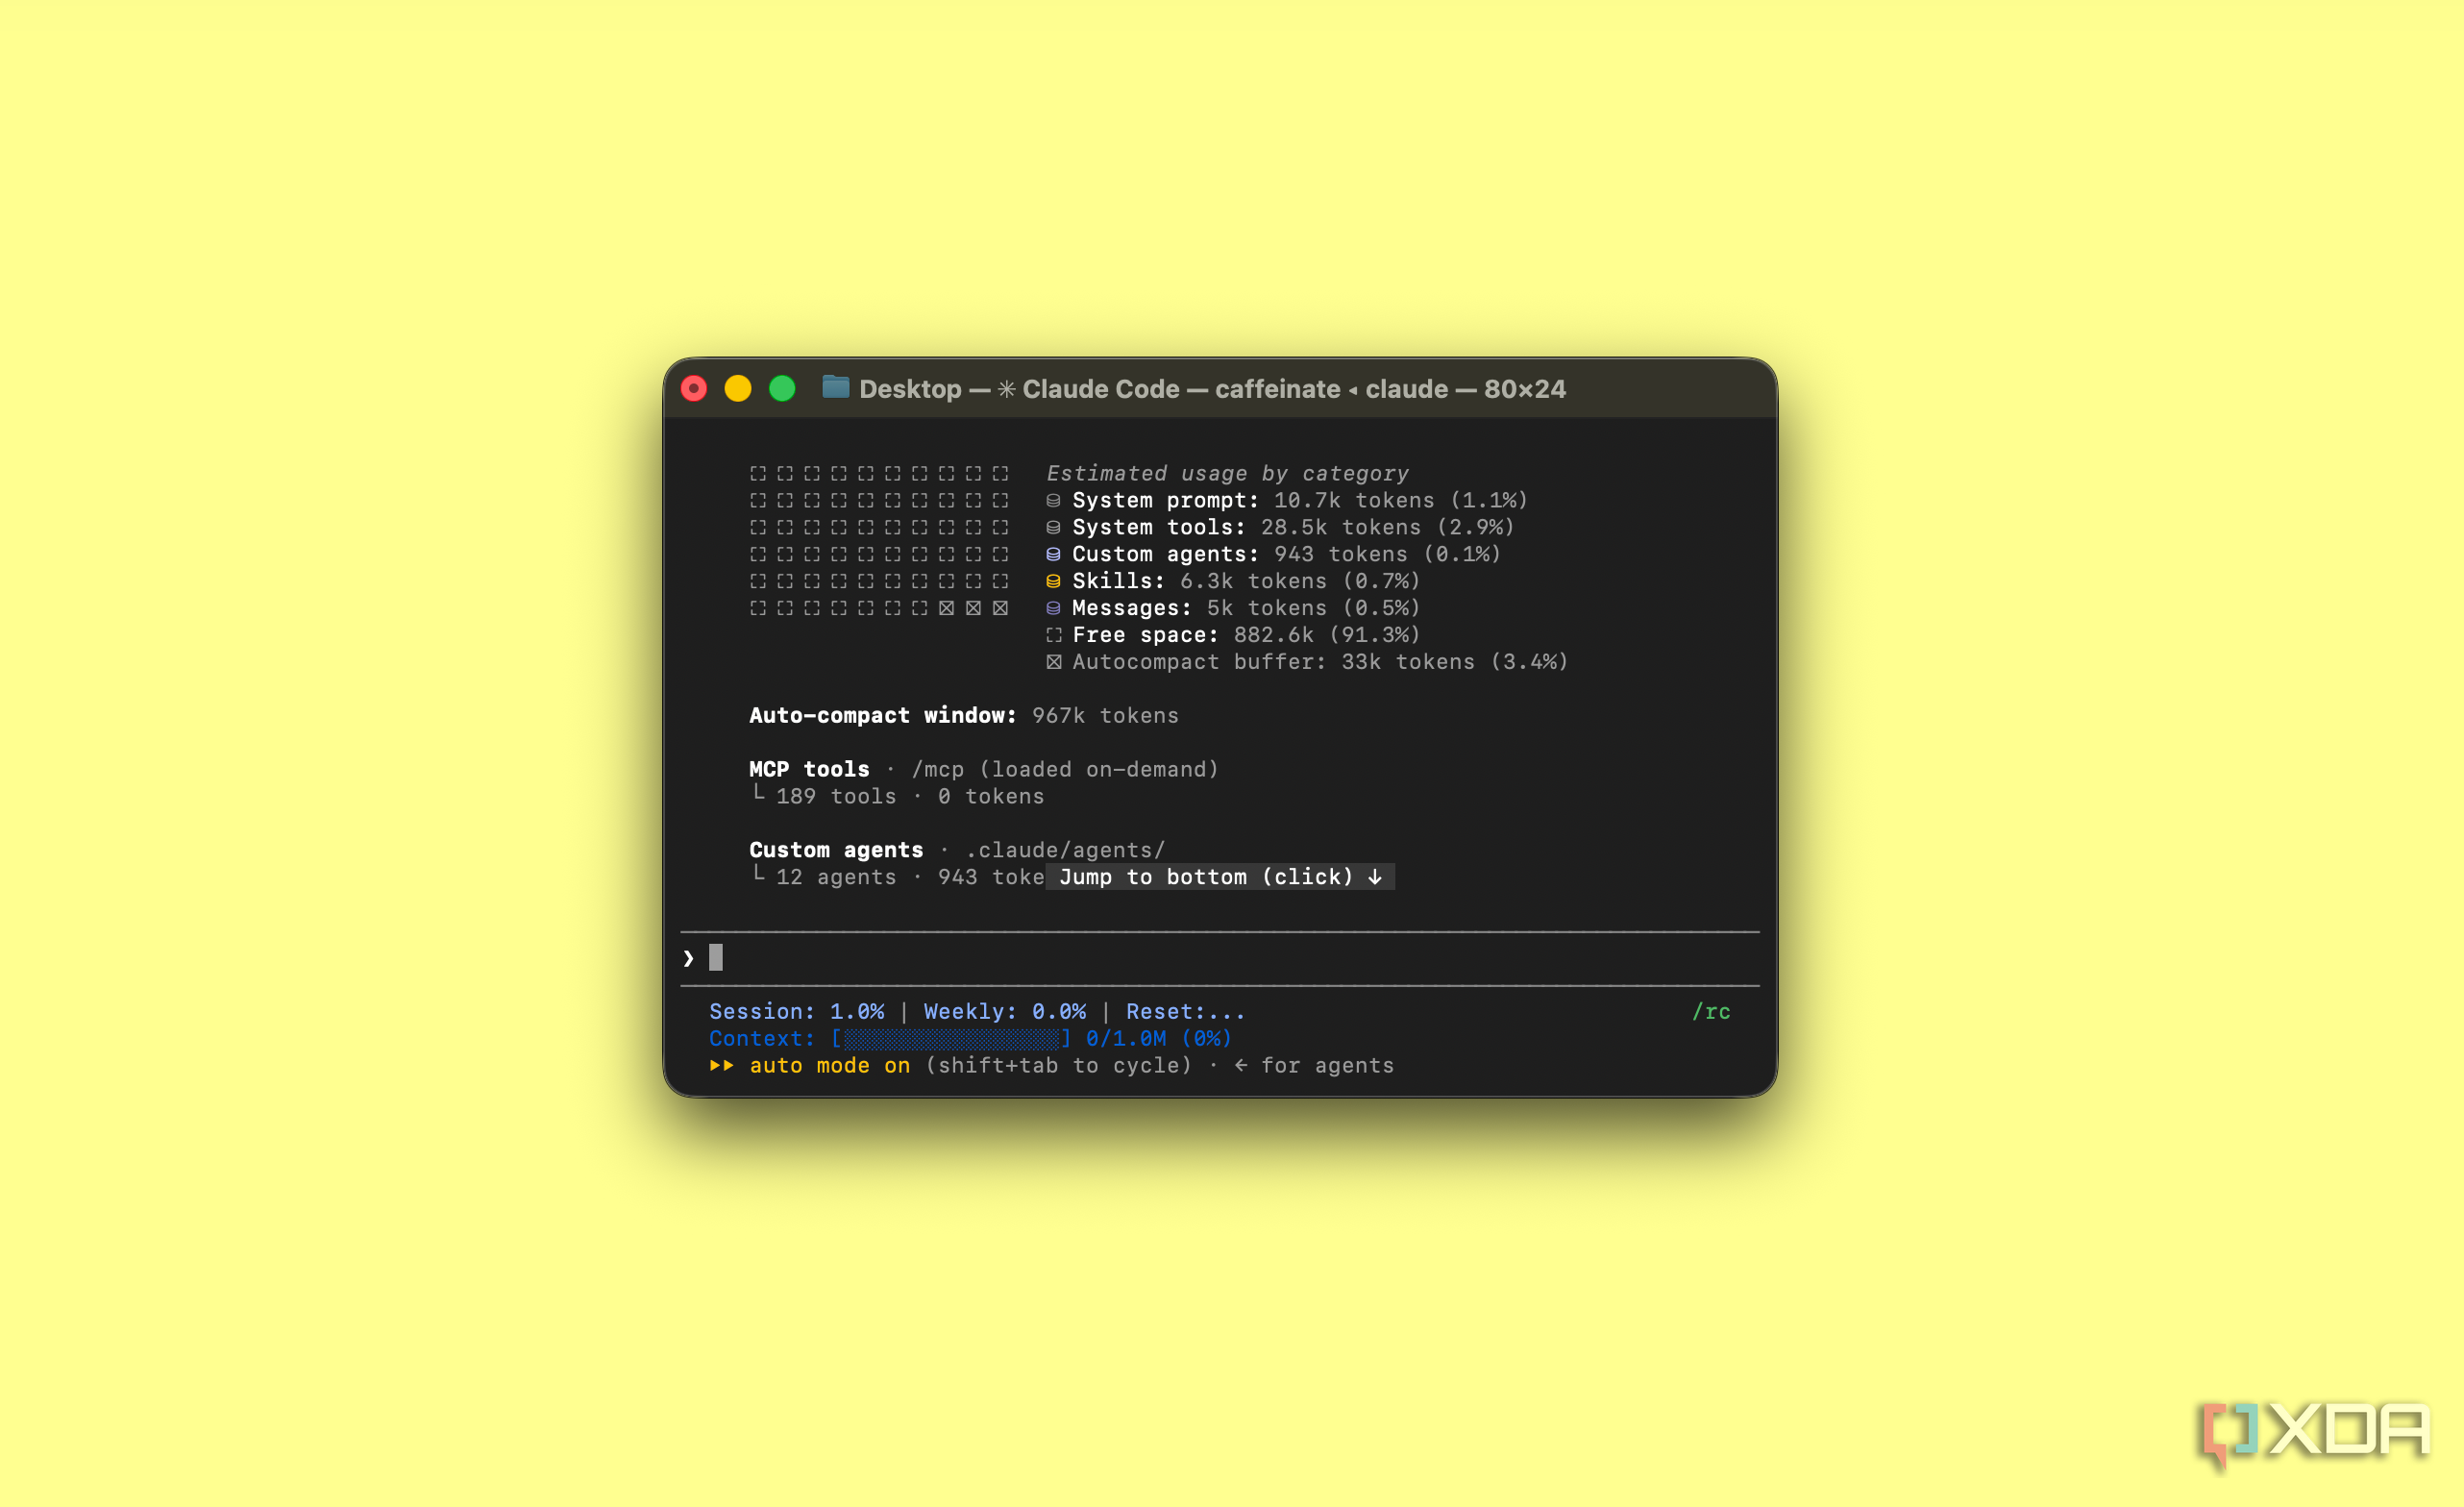
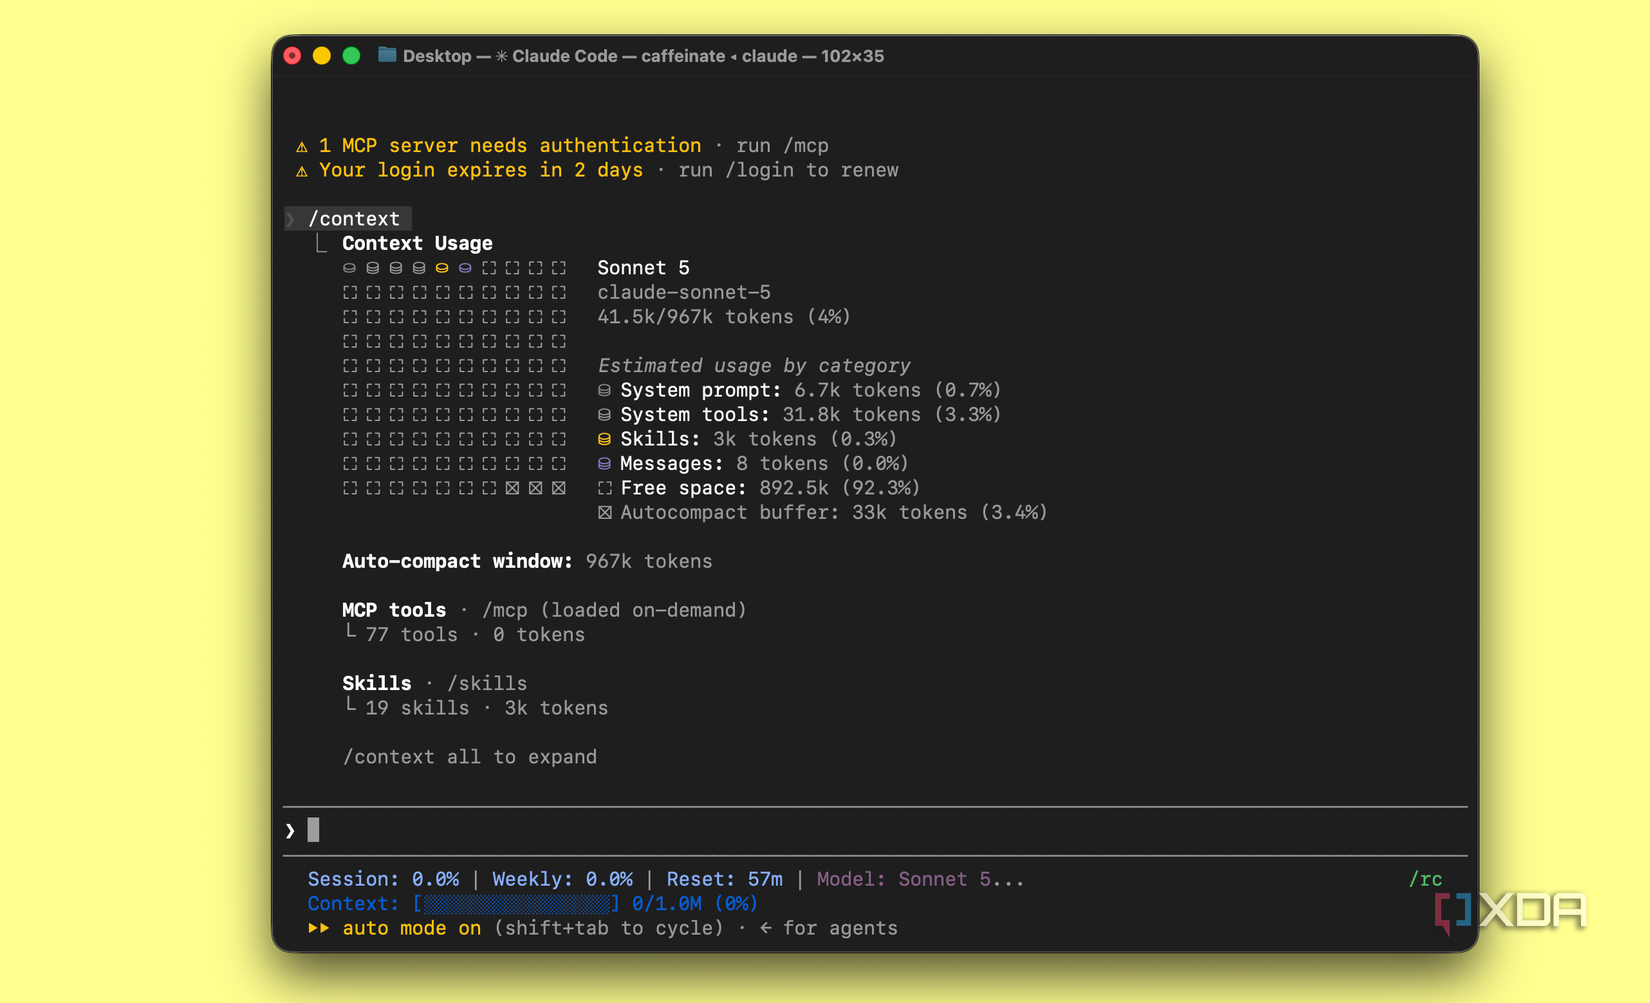
После открытия совершенно новой сессии Claude Code и запуска команды /context, которая дает детальную разбивку содержимого контекстного окна, выяснилось, что до ввода каких-либо задач для Claude уже были заняты 51 400 токенов.
Проблема избыточного веса плагинов и аддонов
Подобные проблемы возникали и ранее: например, серверы MCP (Model Context Protocol) могли поглощать абсурдный объем контекста до начала сессии. Однако разработчики Claude Code в основном решили эту проблему с помощью функции Tool Search, которая удерживает определения инструментов MCP вне контекста до тех пор, пока они действительно не понадобятся. На этот раз виновниками оказались не серверы MCP.
Анализ категорий использования токенов
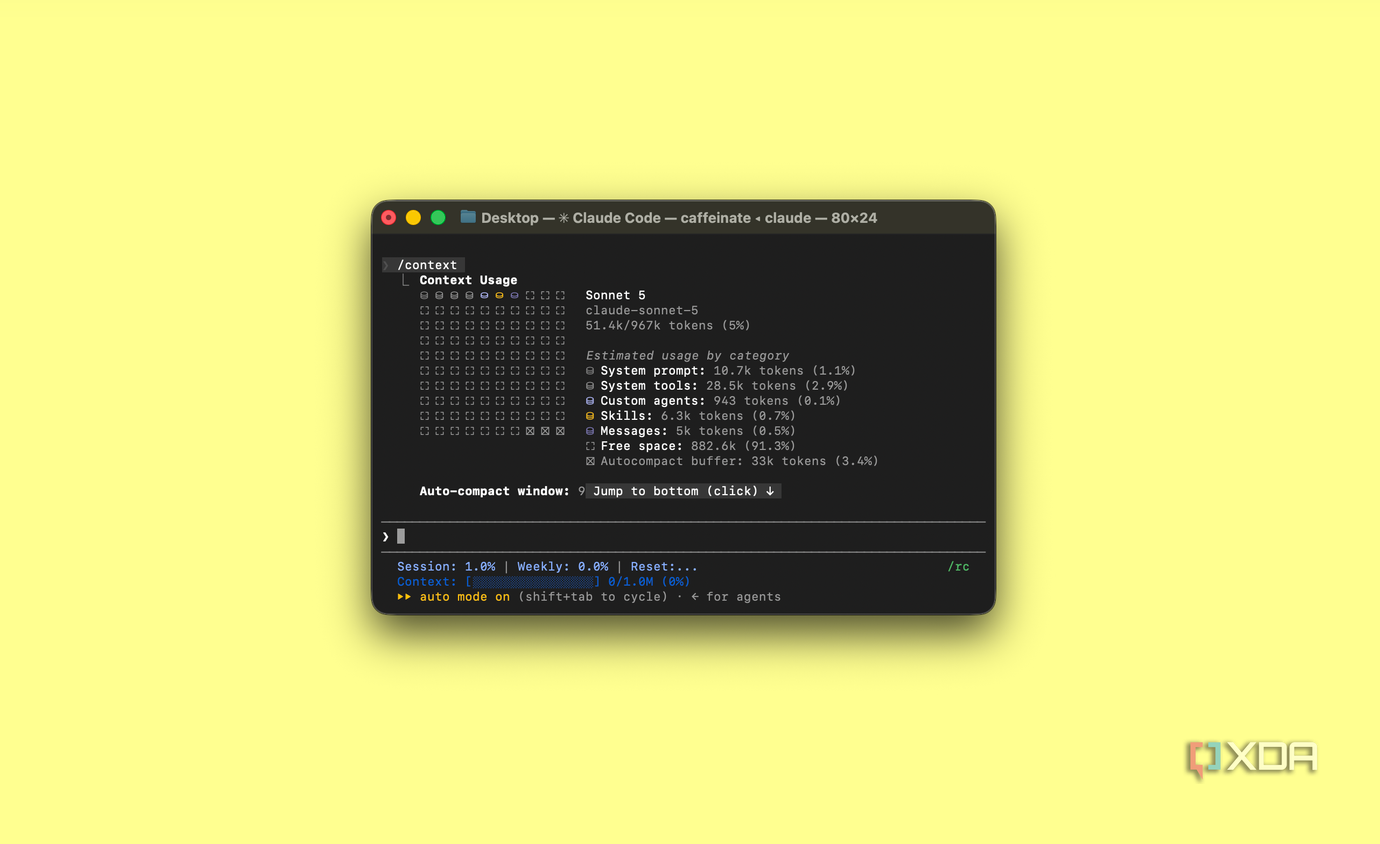
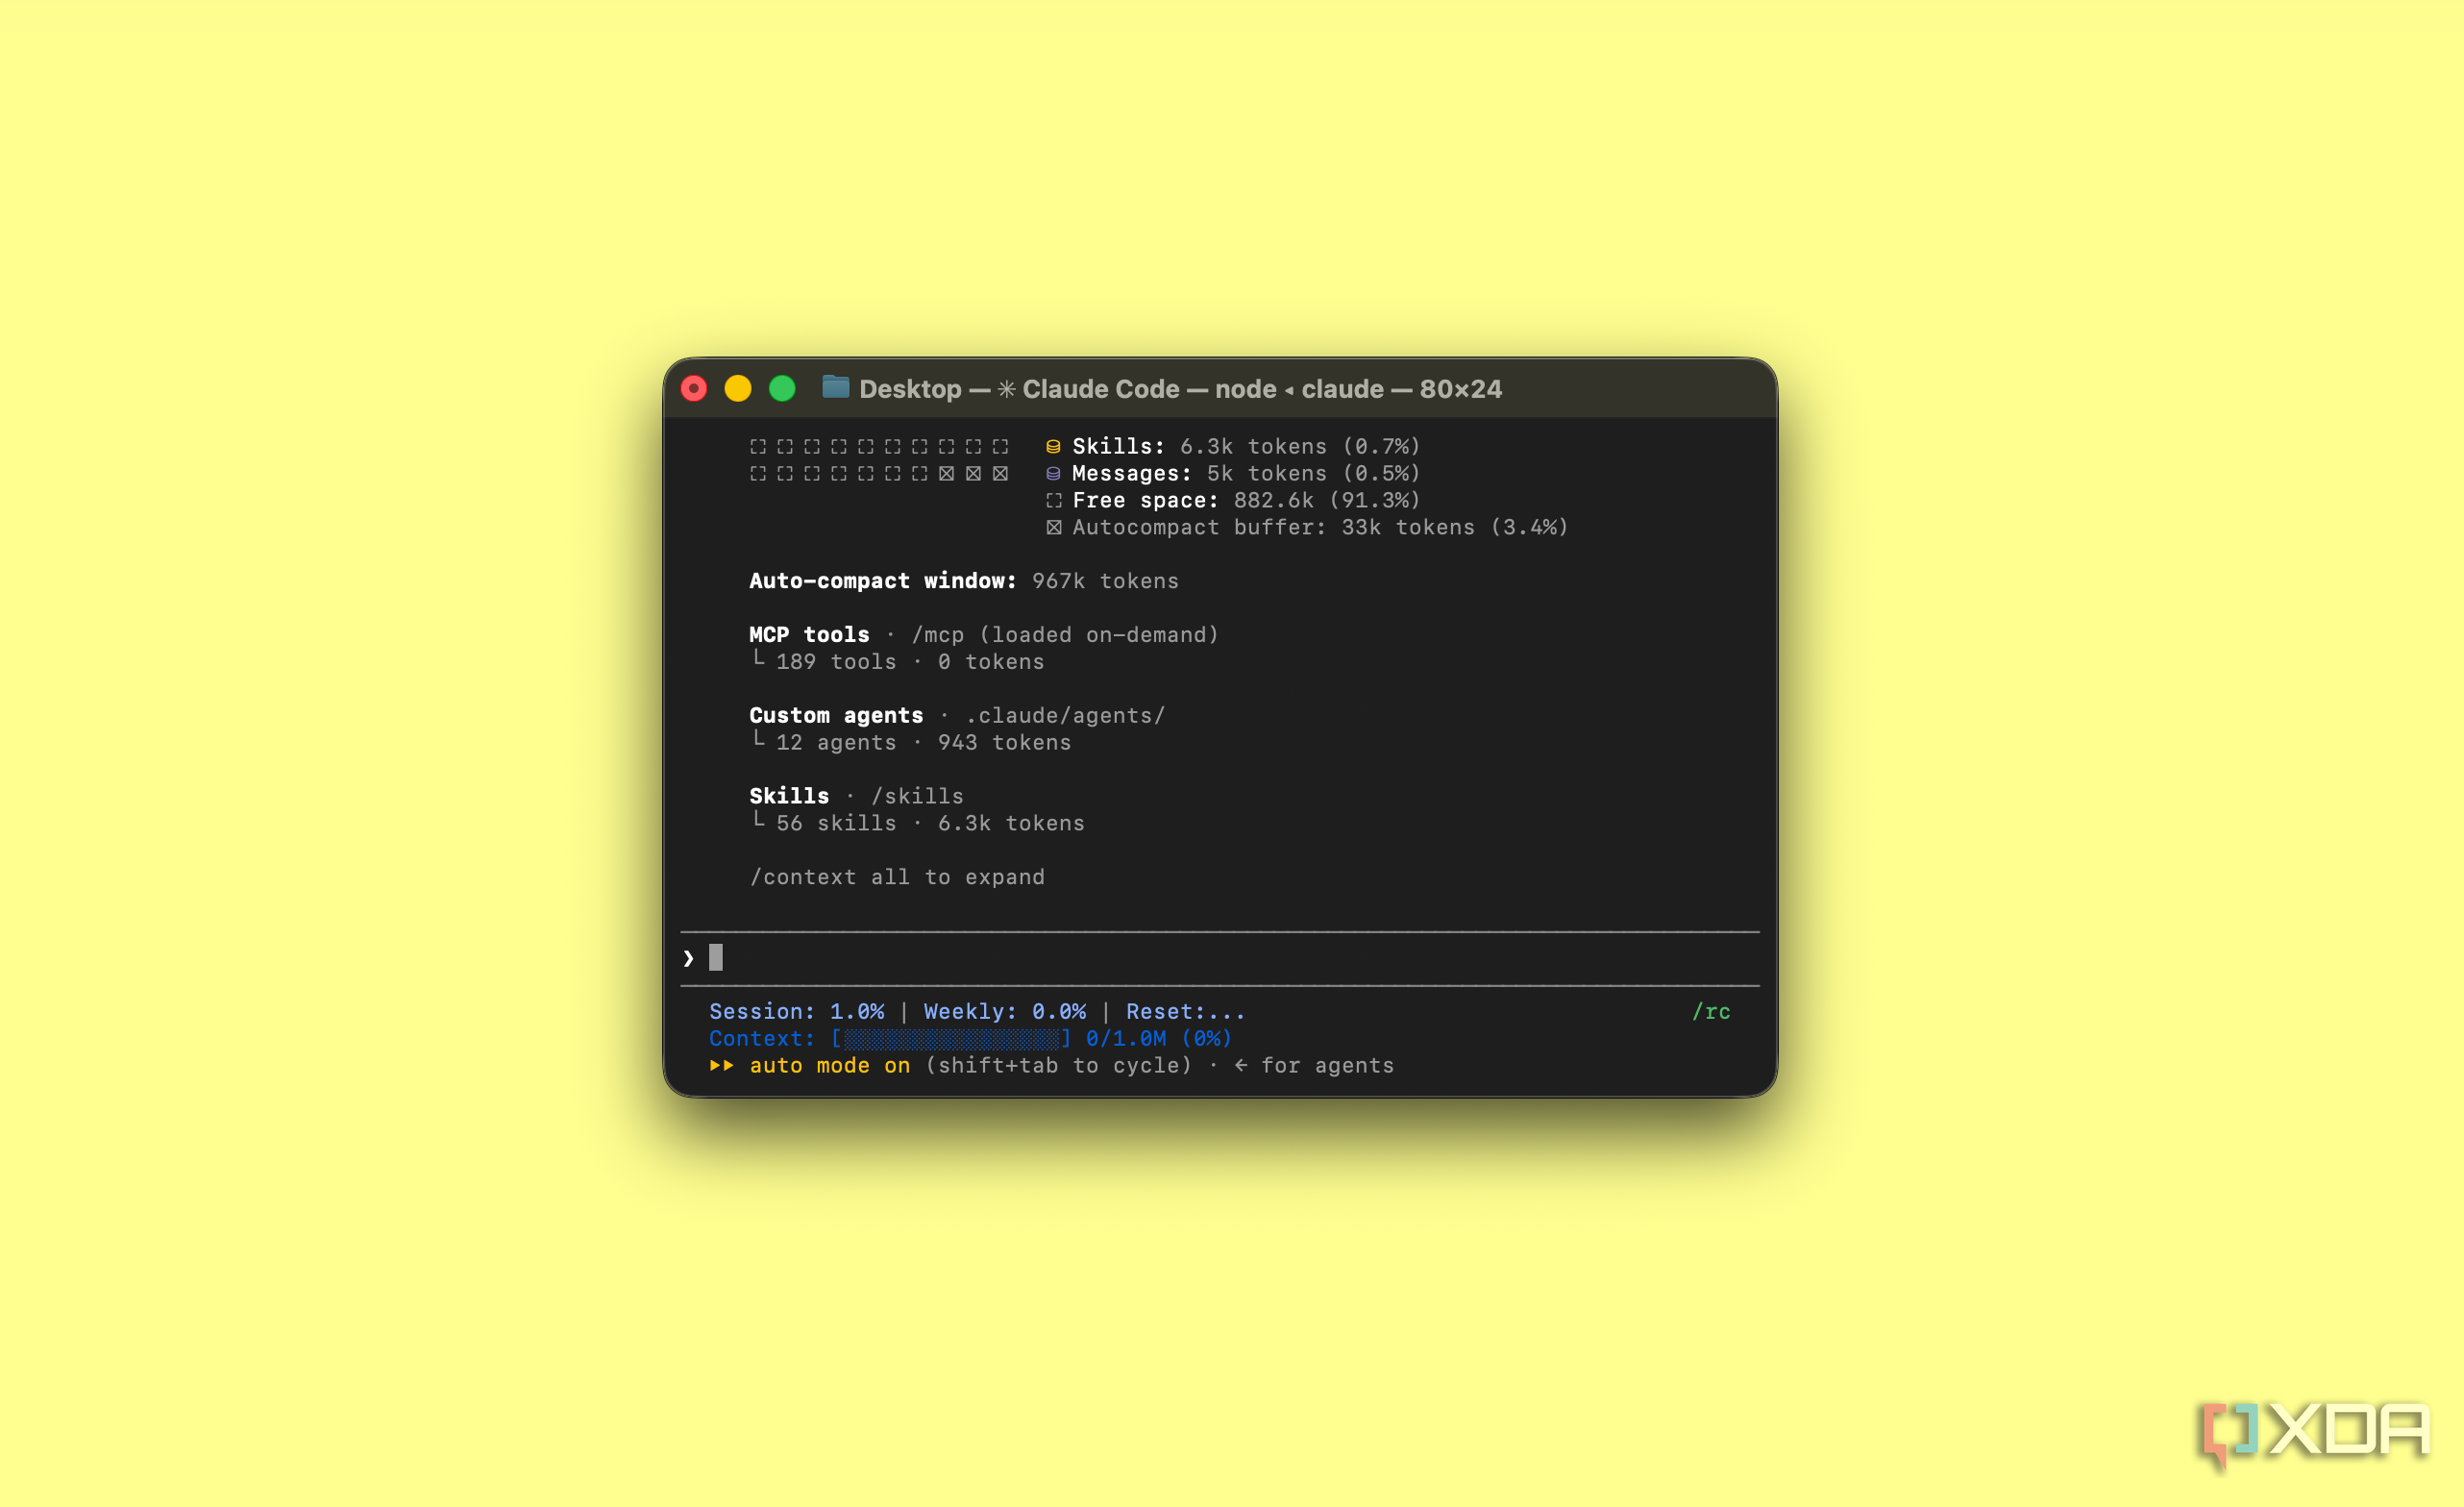
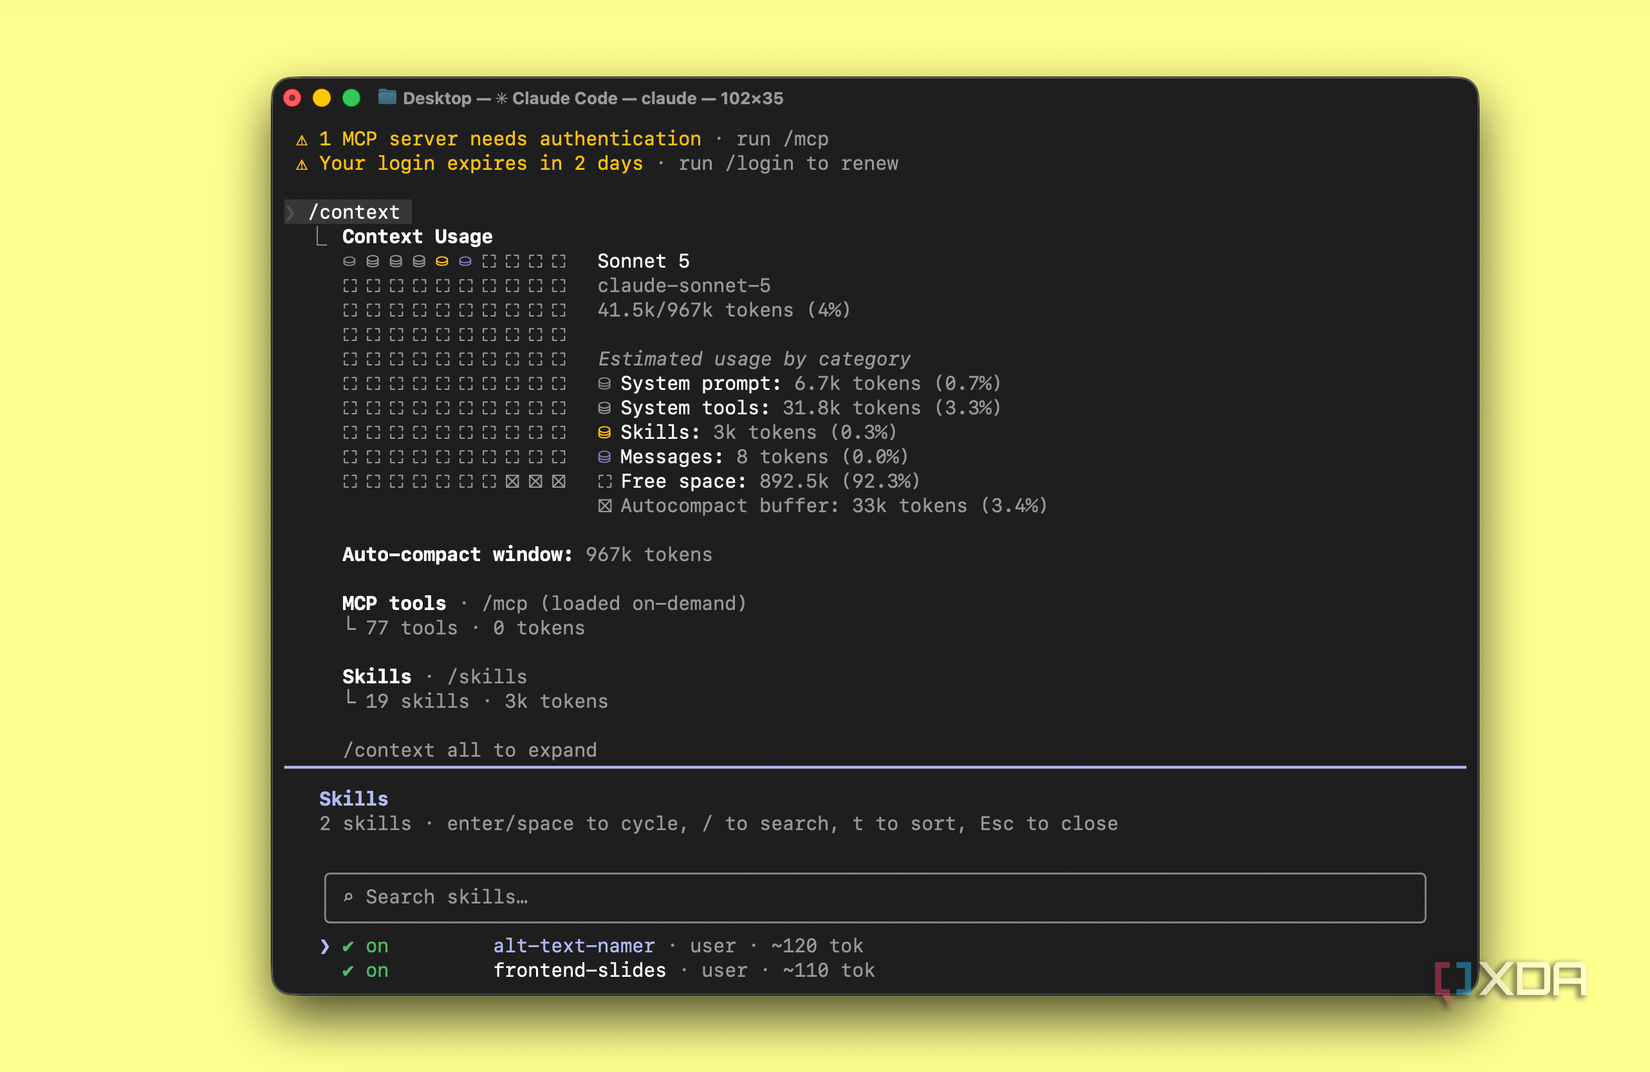
Команда /context показывает точное распределение пространства по категориям: системный промпт, системные инструменты, навыки, пользовательские агенты и сообщения, загруженные до ввода полезных данных. Часть этого объема является неизбежной стоимостью работы самого Claude Code, подобно тому, как iOS занимает значительную часть хранилища iPhone еще до установки сторонних приложений. Системный промпт в тестовой сессии отвечал за 10 700 токенов, а системные инструменты — еще за 28 500 токенов, и удалить их нельзя.
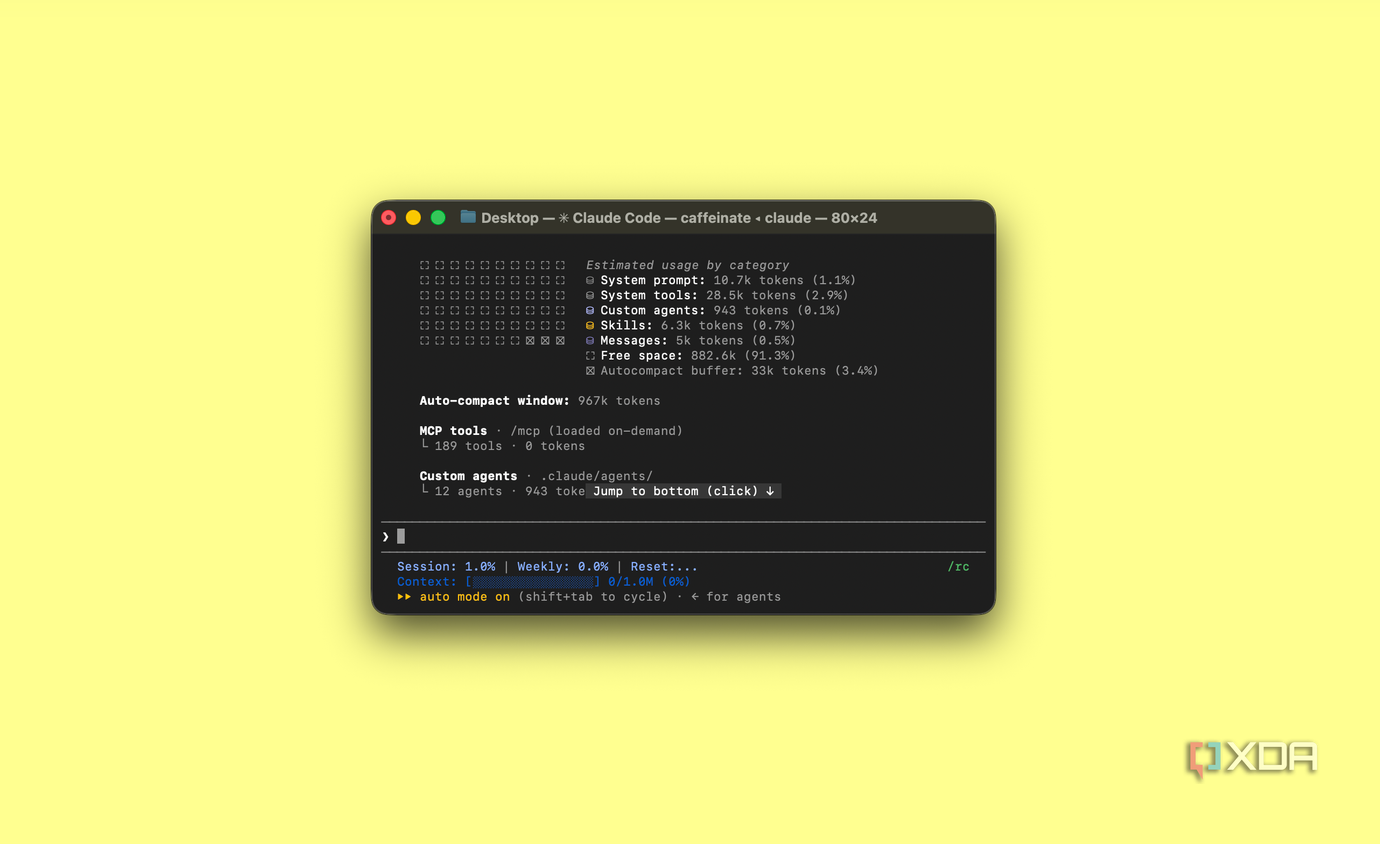
Более интересным и подконтрольным компонентом оказалось то, что было установлено пользователем самостоятельно.
Влияние сторонних плагинов
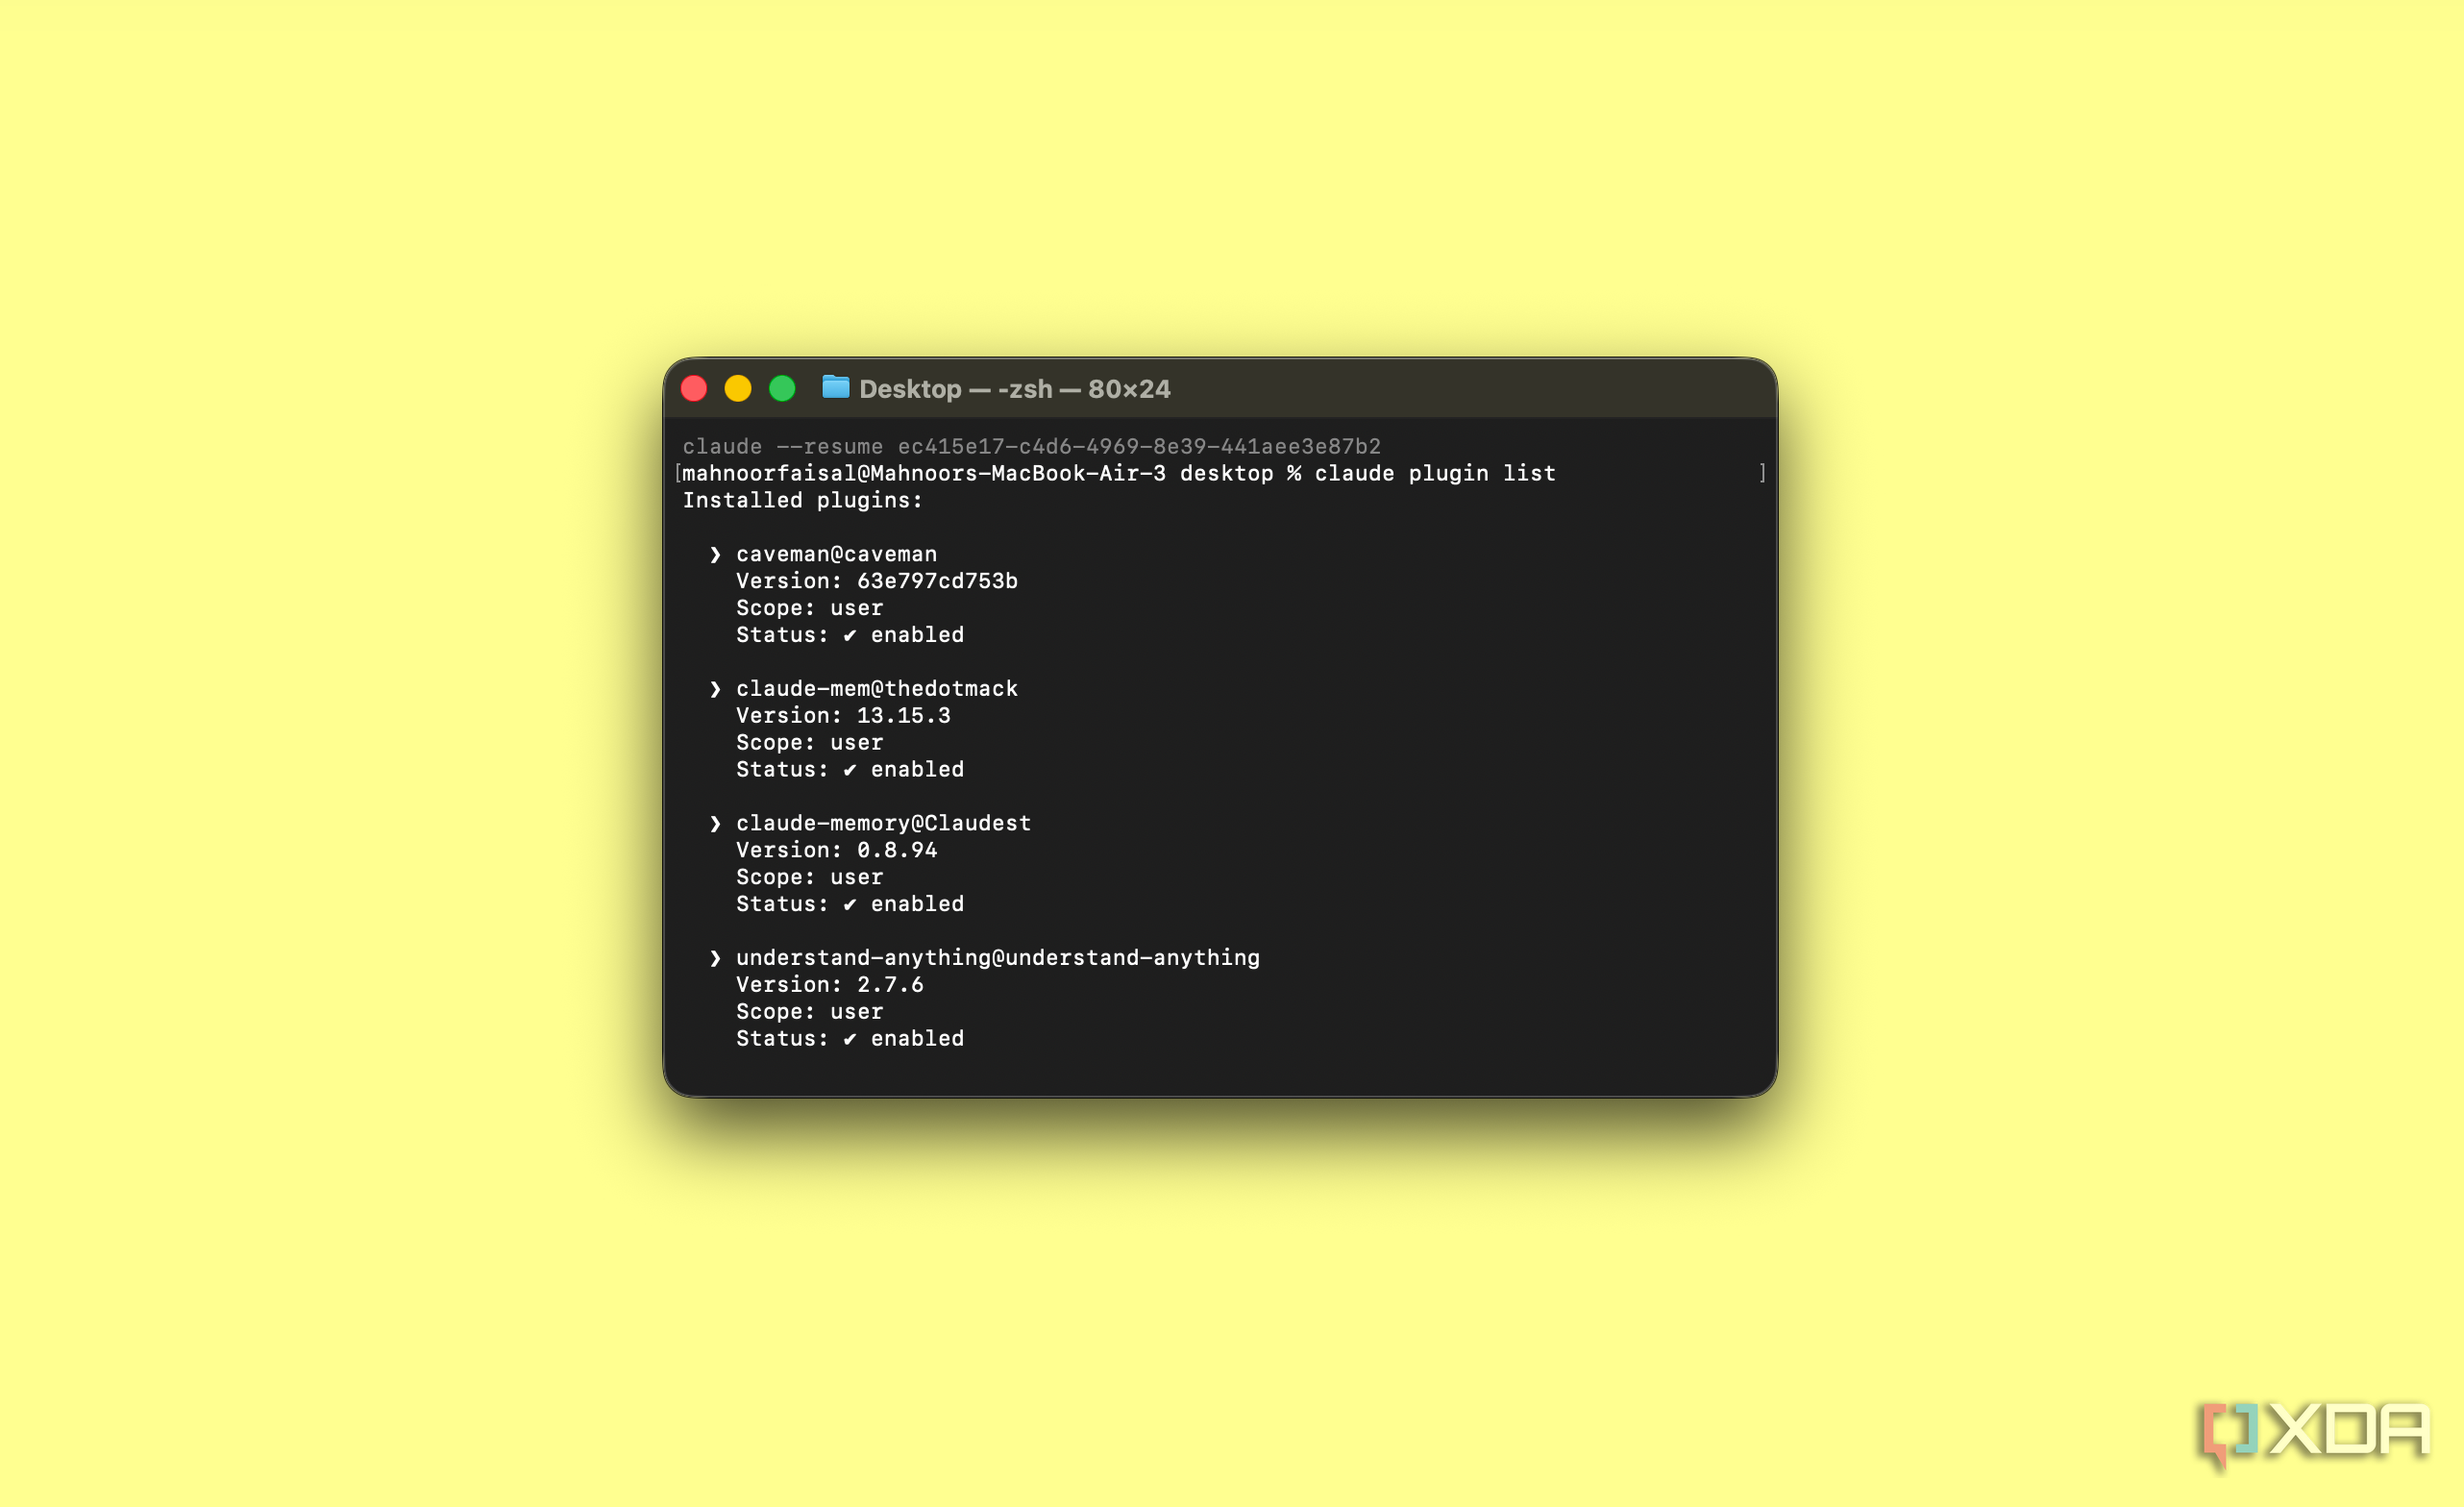
Из-за специфики работы автор часто скачивает множество плагинов, навыков, агентов и других дополнений для тестирования их возможностей, но редко возвращается для уборки. На момент проведения теста были включены четыре сторонних плагина:
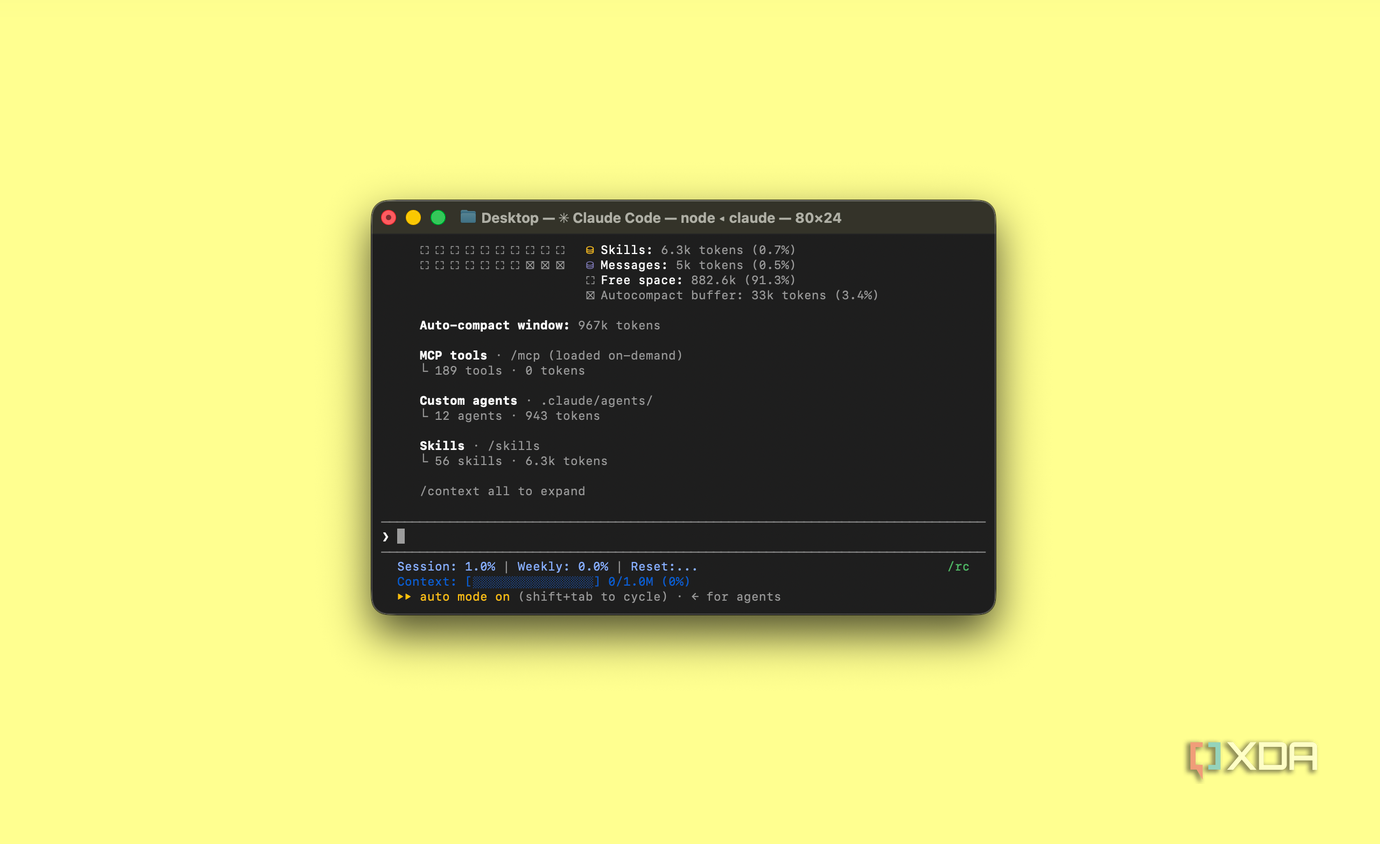
- Caveman
- claude-mem
- claude-memory
- understand-anything
В совокупности они добавляли в Claude Code десятки навыков и пользовательских агентов, а некоторые автоматически внедряли информацию в новые сессии. Отключение всех четырех плагинов проверялось поочередно с открытием новой сессии Claude Code и запуском команды /context после каждого изменения.
К моменту отключения всех четырех дополнений стартовый контекст снизился с 51 400 до 45 600 токенов. При этом:
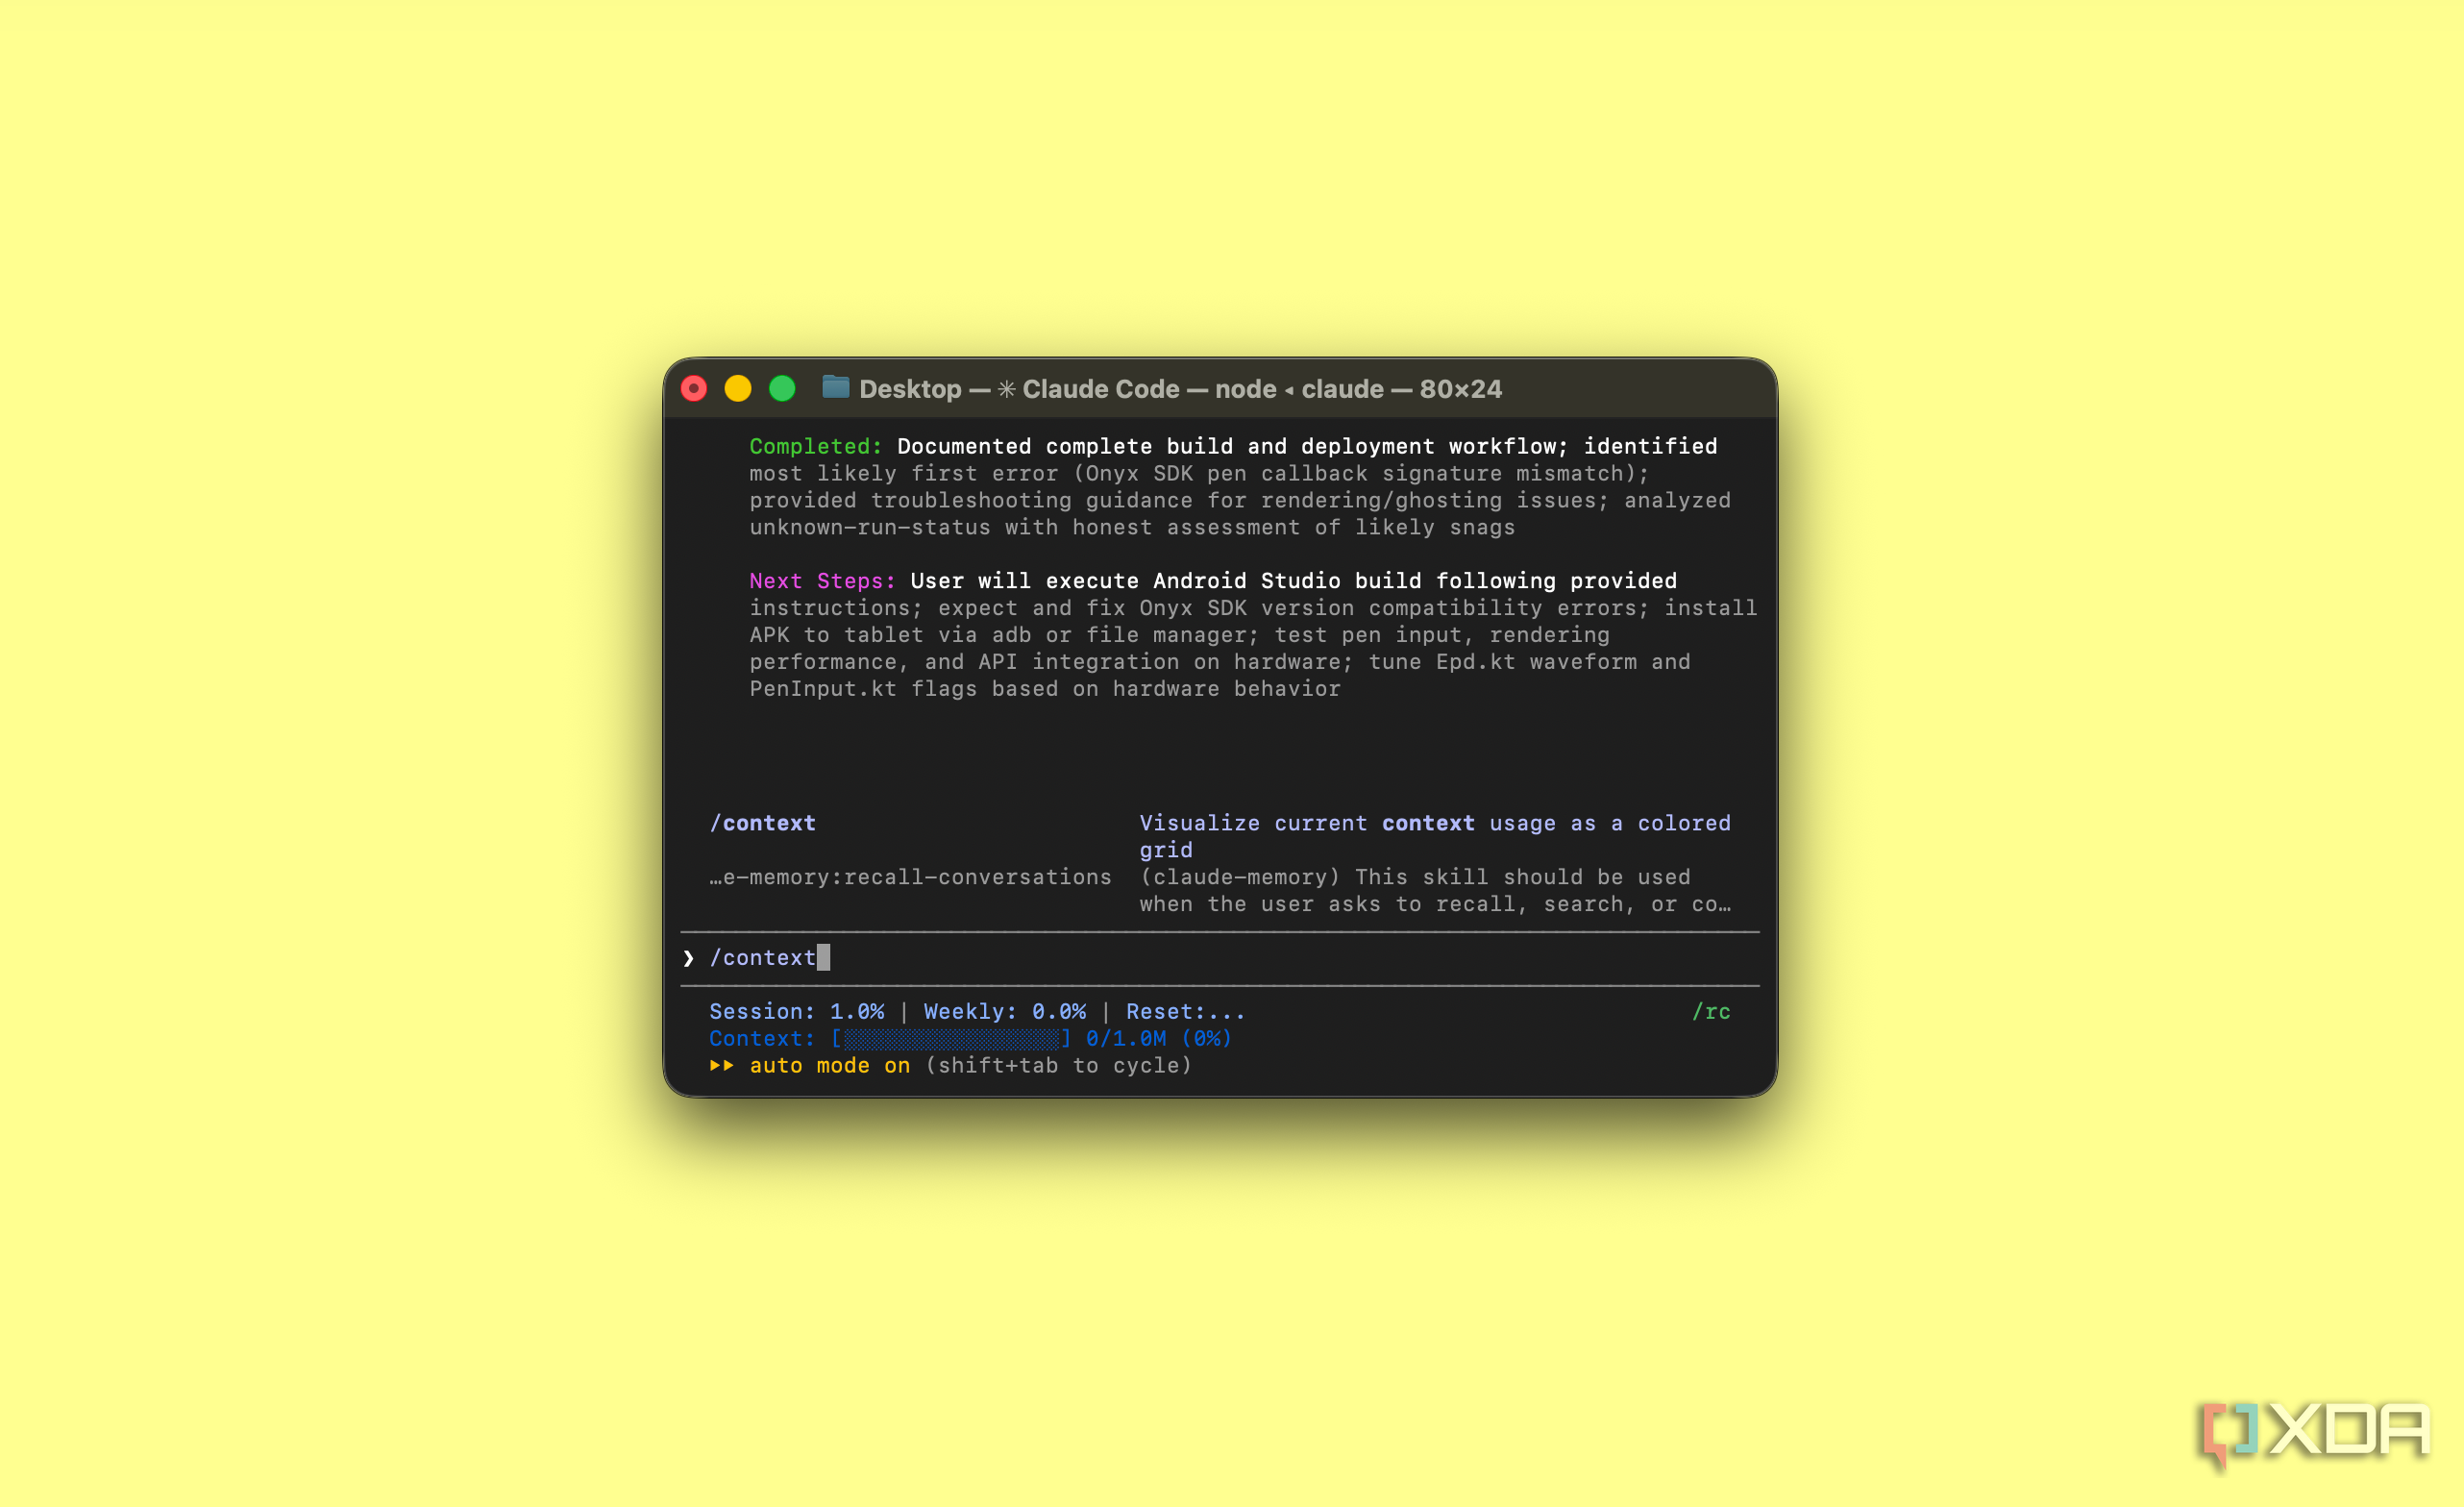
- навыки сократились с примерно 6 300 токенов до 3 200;
- пользовательские агенты уменьшились с 943 токенов до всего 74;
- категория сообщений (Messages) упала с примерно 5 000 токенов практически до нуля из-за того, что некоторые плагины автоматически внедряли собственный контекст в свежие сессии.
Анализ влияния скиллов и автопамяти на стартовый контекст Claude Code
После их отключения Claude Code фактически начинал работу с чистой беседы заново! Отдельного внимания заслуживала и категория скиллов. В тот момент у меня было установлено три собственных скилла: alt-text-namer, codebase-to-course и frontend-slides. Поскольку первый и последний я использую регулярно, у меня не было интереса удалять полезные элементы своей настройки только ради того, чтобы число выглядело лучше. Я лишь временно убрал codebase-to-course и провел тест снова.
Разница оказалась мизерной. Мой стартовый контекст изменился с 45 600 токенов примерно до 45 500, в то время как категория скиллов уменьшилась примерно с 3 200 токенов до 3 000. Это дало четкое понимание, что мои собственные скиллы не являются реальной проблемой. Большая часть раздувания объема, связанного со скиллами, которую я удалил ранее, исходила от плагинов, привносивших с собой десятки дополнительных навыков. Два пользовательских навыка, которые я действительно хотел сохранить, едва оказывали заметное влияние.
Влияние функции автоматической памяти на объем контекста
Самая большая экономия по отдельности пришлась на память. Оказывается, запоминание всего подряд не дается бесплатно! Ирония заключалась в том, что много стартового контекста мне вернули плагины, связанные с памятью. Однако это было не то место, откуда пришлась самая большая единовременная экономия. Внезапно я вспомнил, что Anthropic добавила в Claude Code функцию автопамяти (auto-memory), которая позволяет переносить полезную информацию между сеансами без необходимости поддерживать ее вручную. Поскольку память загружается в новый сеанс автоматически, я решил, что стоит протестировать, во сколько токенов на самом деле обходится это удобство.
Прежде чем возлагать вину на автопамять, я сначала проверил более очевидные места. В меню /memory Claude Code отображал как пользовательские, так и проектные инструкции, но мой пользовательский файл CLAUDE.md был абсолютно пустым, а в папке, из которой я проводил тестирование, даже не было проектного файла CLAUDE.md. Другими словами, ничто из этого не могло объяснить увиденное. Поэтому я снова запустил Claude Code с отключенной автопамятью и сразу выполнил команду /context.
Мой стартовый контекст сократился примерно с 45 500 токенов до 41 500. Поскольку разница в 4 000 токенов показалась достаточно большой, чтобы не полагаться на единственный запуск, я повторил тот же самый тест. Второй сеанс стартовал с отметки в 41 400 токенов. Еще больше меня удивило то, откуда именно исчезли эти токены. Моя категория скиллов осталась на уровне примерно 3 000 токенов, в то время как системный промпт уменьшился примерно с 10 700 токенов до 6 700. Таким образом, по крайней мере в моей версии и с моей настройкой, одно лишь включение автопамяти расходовало примерно еще 4 000 токенов стартового контекста.
Практические выводы и итоговая экономия токенов
Я бы не стал рекомендовать абсолютно всем навсегда отключать автопамять. В отличие от старых плагинов, которые я установил для тестирования и забыл о них, память — это функция, от которой я действительно получаю пользу. Тем не менее, осознание ее стоимости сделало компромисс гораздо более понятным. Если я начинаю короткую, самодостаточную задачу, где мне не нужно, чтобы Claude помнил что-либо из предыдущих сеансов, я предпочитаю, чтобы эти дополнительные токены были доступны для стоящей передо мной работы.
В конечном итоге к концу этого процесса я сократил свой стартовый контекст с 51 400 токенов примерно до 41 400! Это составляет почти 10 000 возвращенных токенов еще до того, как я ввел хотя бы один реальный промпт. Мало того, что уменьшение стартового контекста оставляет больше доступного пространства окна контекста для актуального текста, Claude также вынужден носить с собой меньше ненужной информации по мере продолжения сеанса.
Вышесказанное имеет значение и для использования, поскольку весь этот контекст приходится обрабатывать заново на последующих этапах. В конечном итоге это означает, что вы начнете замечать свои лимиты использования чуть позже, чем иначе, особенно в течение более долгих сеансов, где этот дополнительный контекст продолжал бы переноситься дальше.
Помимо экспериментов со вспомогательными плагинами и функцией автоматической памяти, автор также обратил внимание на общие затраты токенов в рамках одной сессии. На протяжении пяти различных тестов снижение параметра усилия (effort setting) с уровня High до Medium позволило сократить расход выходных токенов на 45% без какого-либо заметного ухудшения качества получаемых результатов.
Важно учитывать, что вся лишняя информация, занимающая стартовый контекст, не просто отнимает свободное пространство в самом начале работы. Весь этот объем контекста неизбежно приходится обрабатывать заново на каждом последующем этапе диалога. Из-за этого очистка стартового контекста помогает отодвинуть момент наступления лимитов использования, что особенно заметно во время продолжительных сеансов, где избыточные данные продолжали бы накапливаться и переноситься от сообщения к сообщению.