Современные локальные языковые модели демонстрируют впечатляющие возможности рассуждения. Более ранние опасения насчет их неэффективности постепенно отступают на второй план, особенно с появлением архитектур Mixture-of-Experts. Хотя для тяжелых задач принято задействовать мощные ПК и домашние серверы, обычные мобильные устройства тоже способны справляться с компактными ИИ-моделями. В качестве очередного эксперимента старый смартфон Poco M6 Pro был перепрофилирован под локальный сервер искусственного интеллекта для выполнения несложных повседневных задач.
Установка движка инференса через Termux
Для реализации этой идеи потребовалось подобрать максимально легкий инструмент инференса, способный работать в условиях ограниченных ресурсов мобильного устройства. Популярные графические приложения вроде MLC Chat, AnythingLLM Mobile или PocketPal AI обладают удобным интерфейсом, но могут избыточно нагружать систему. В итоге выбор пал на минималистичный инструментарий на базе Termux и движок llama.cpp.
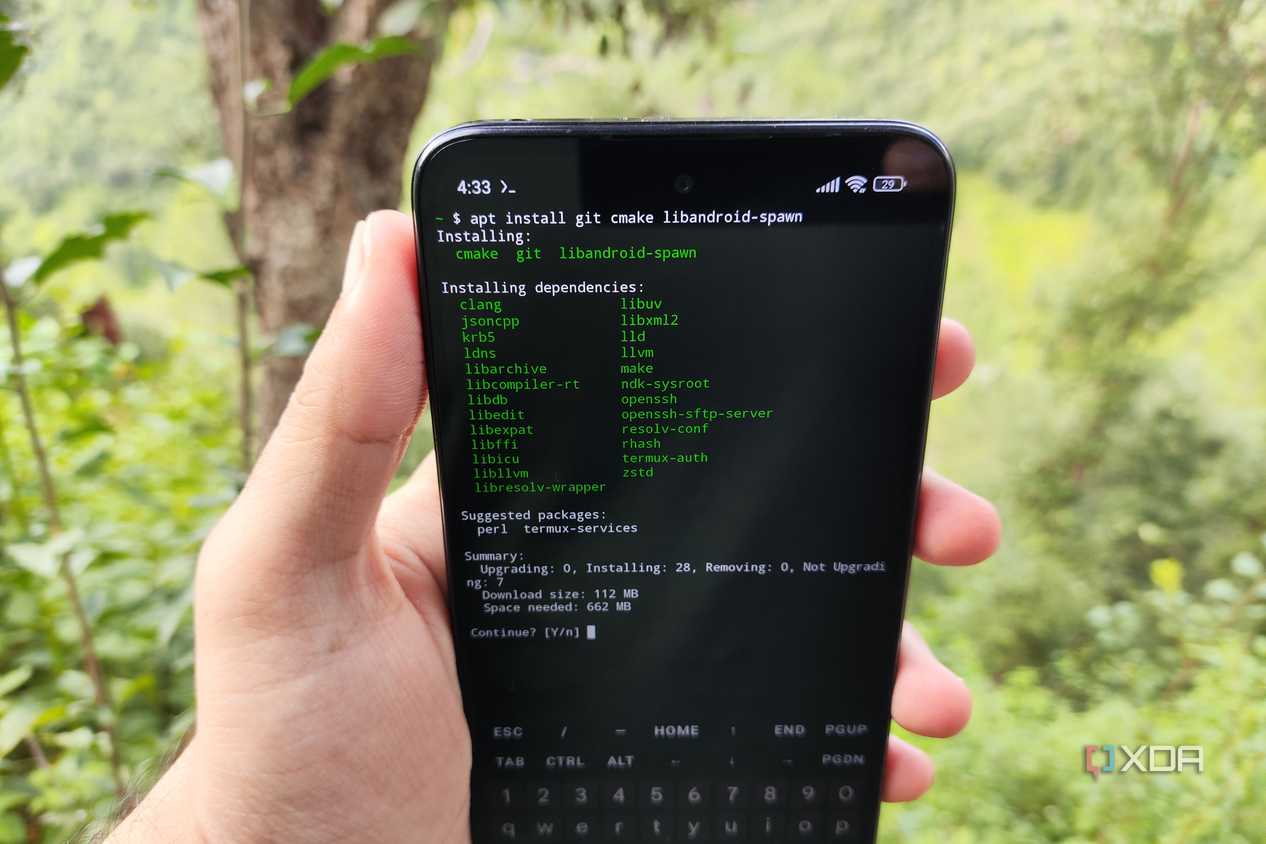
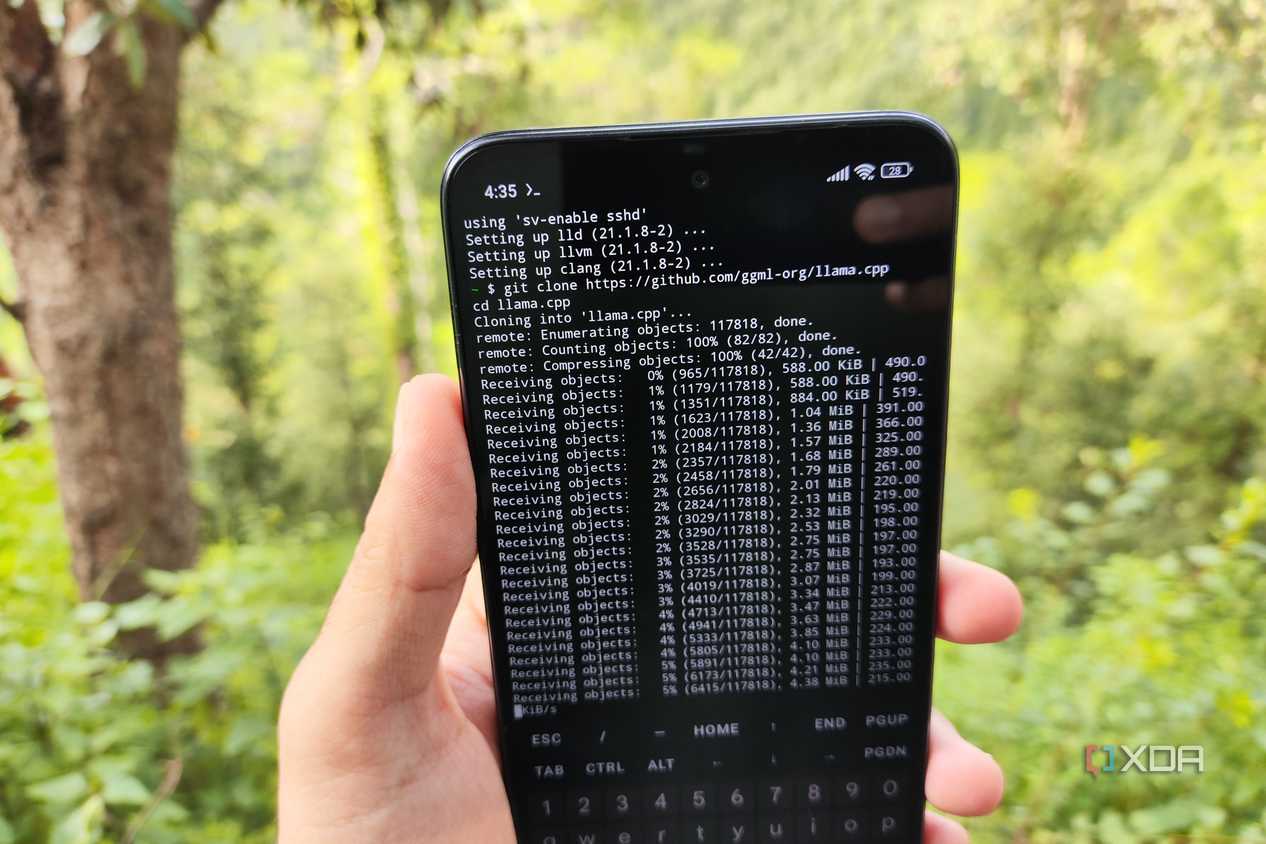
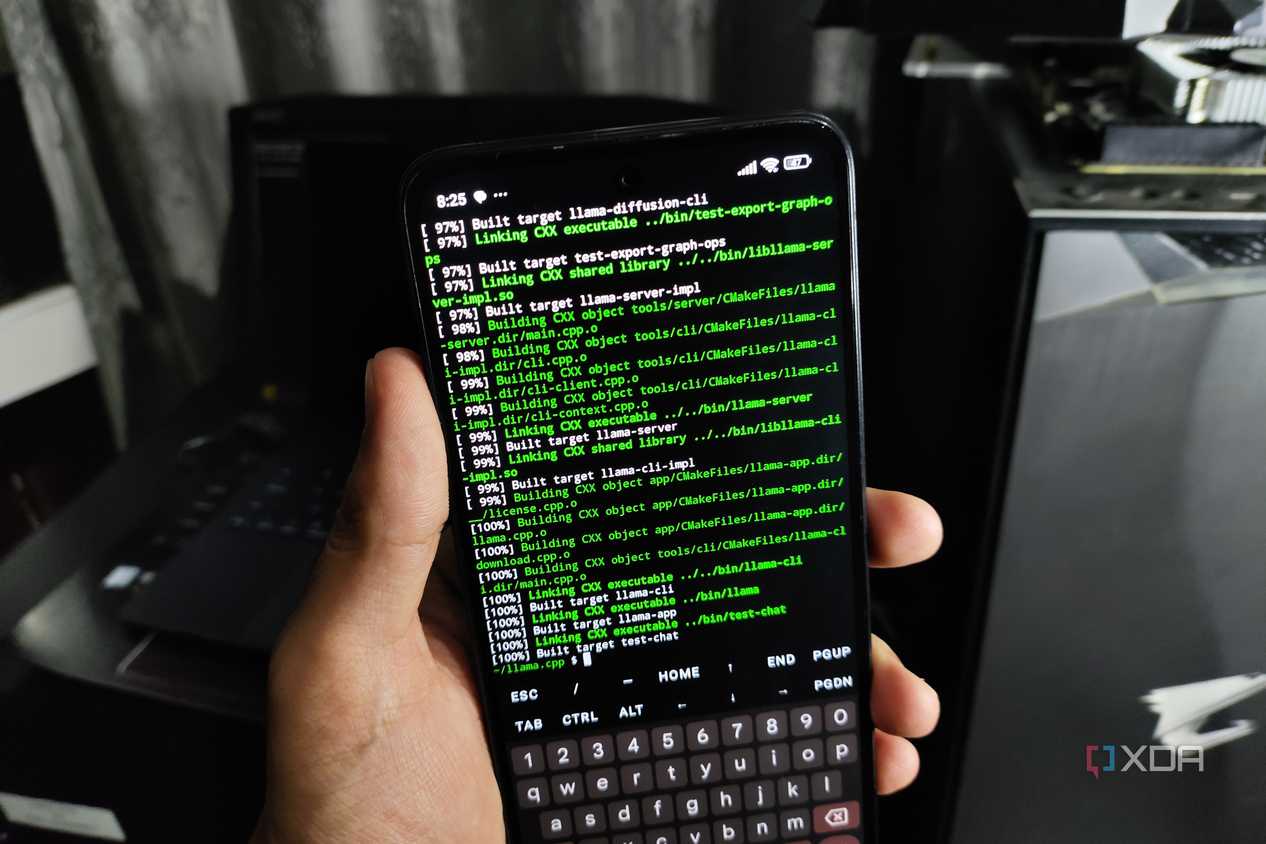
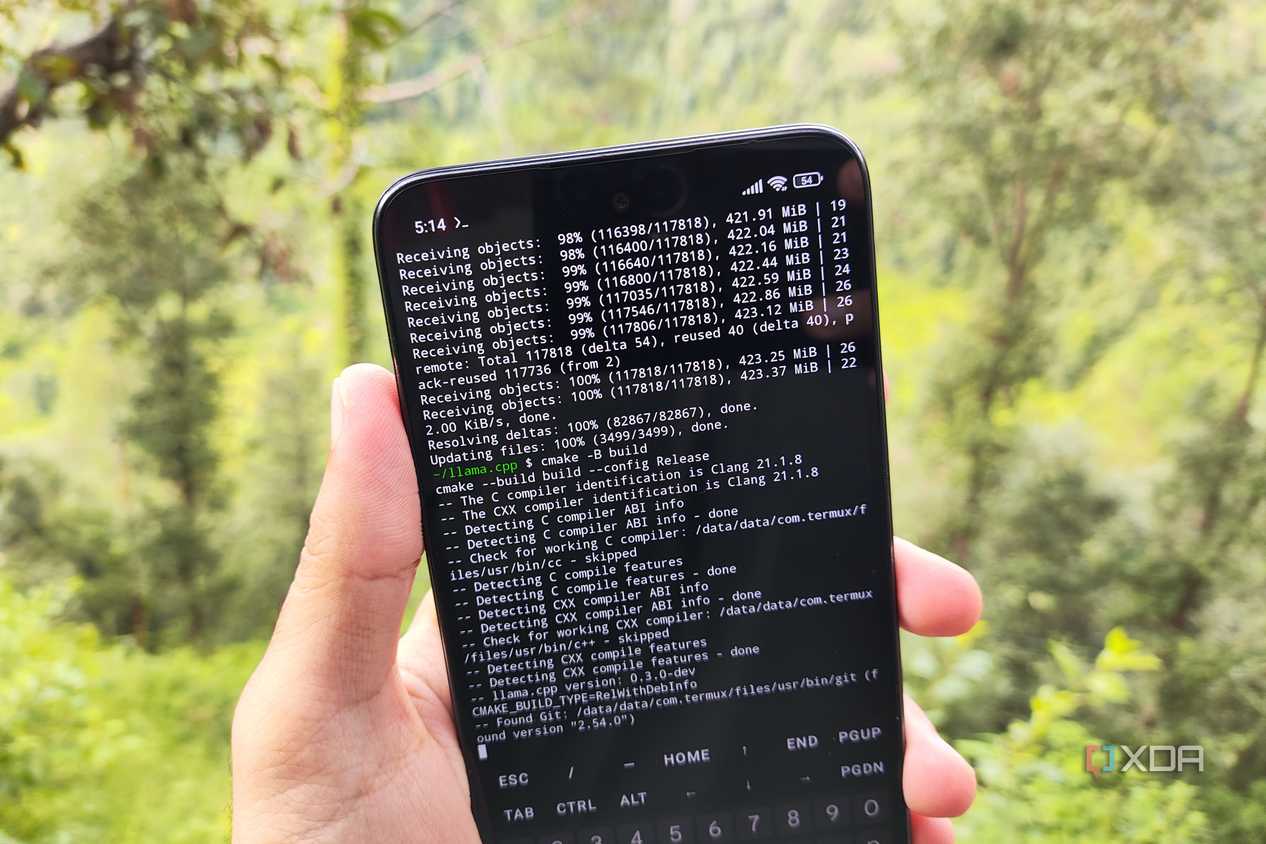
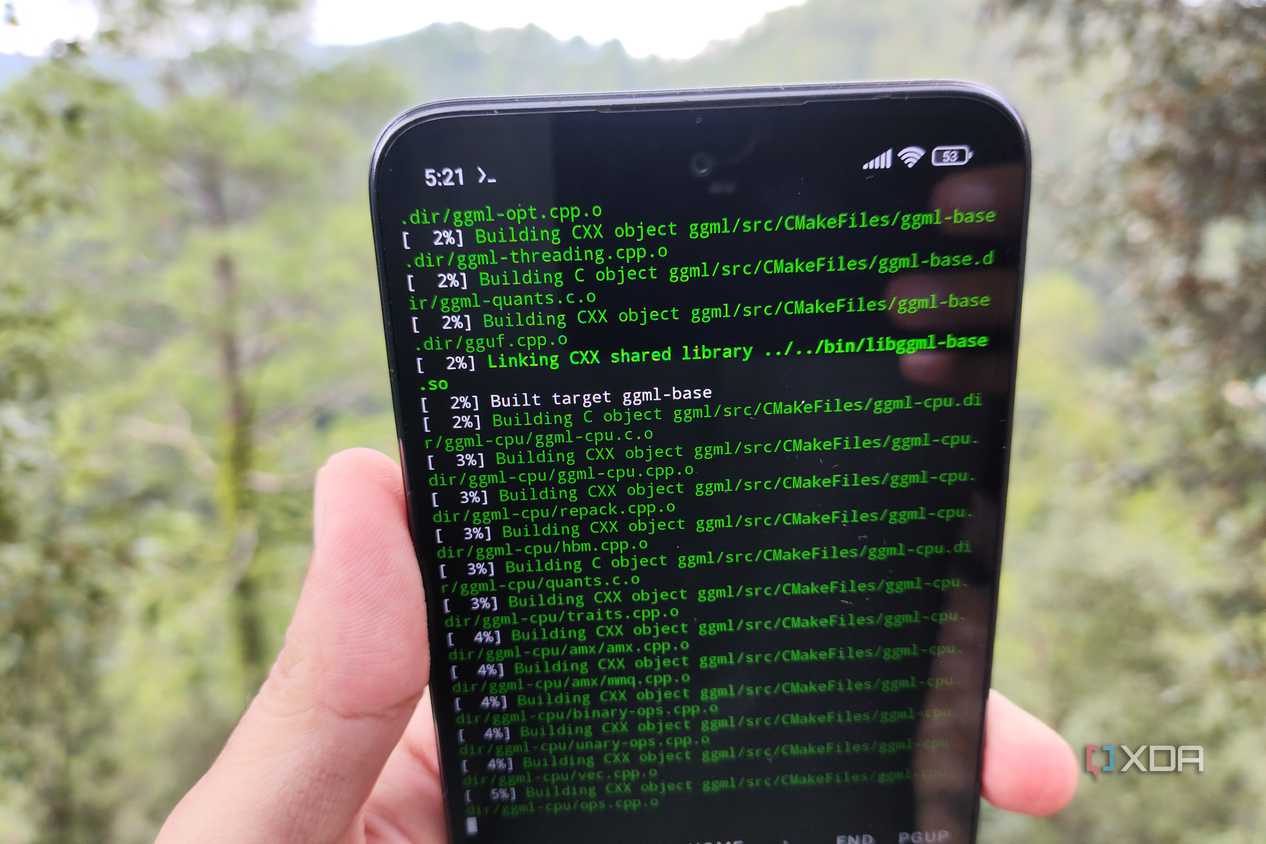
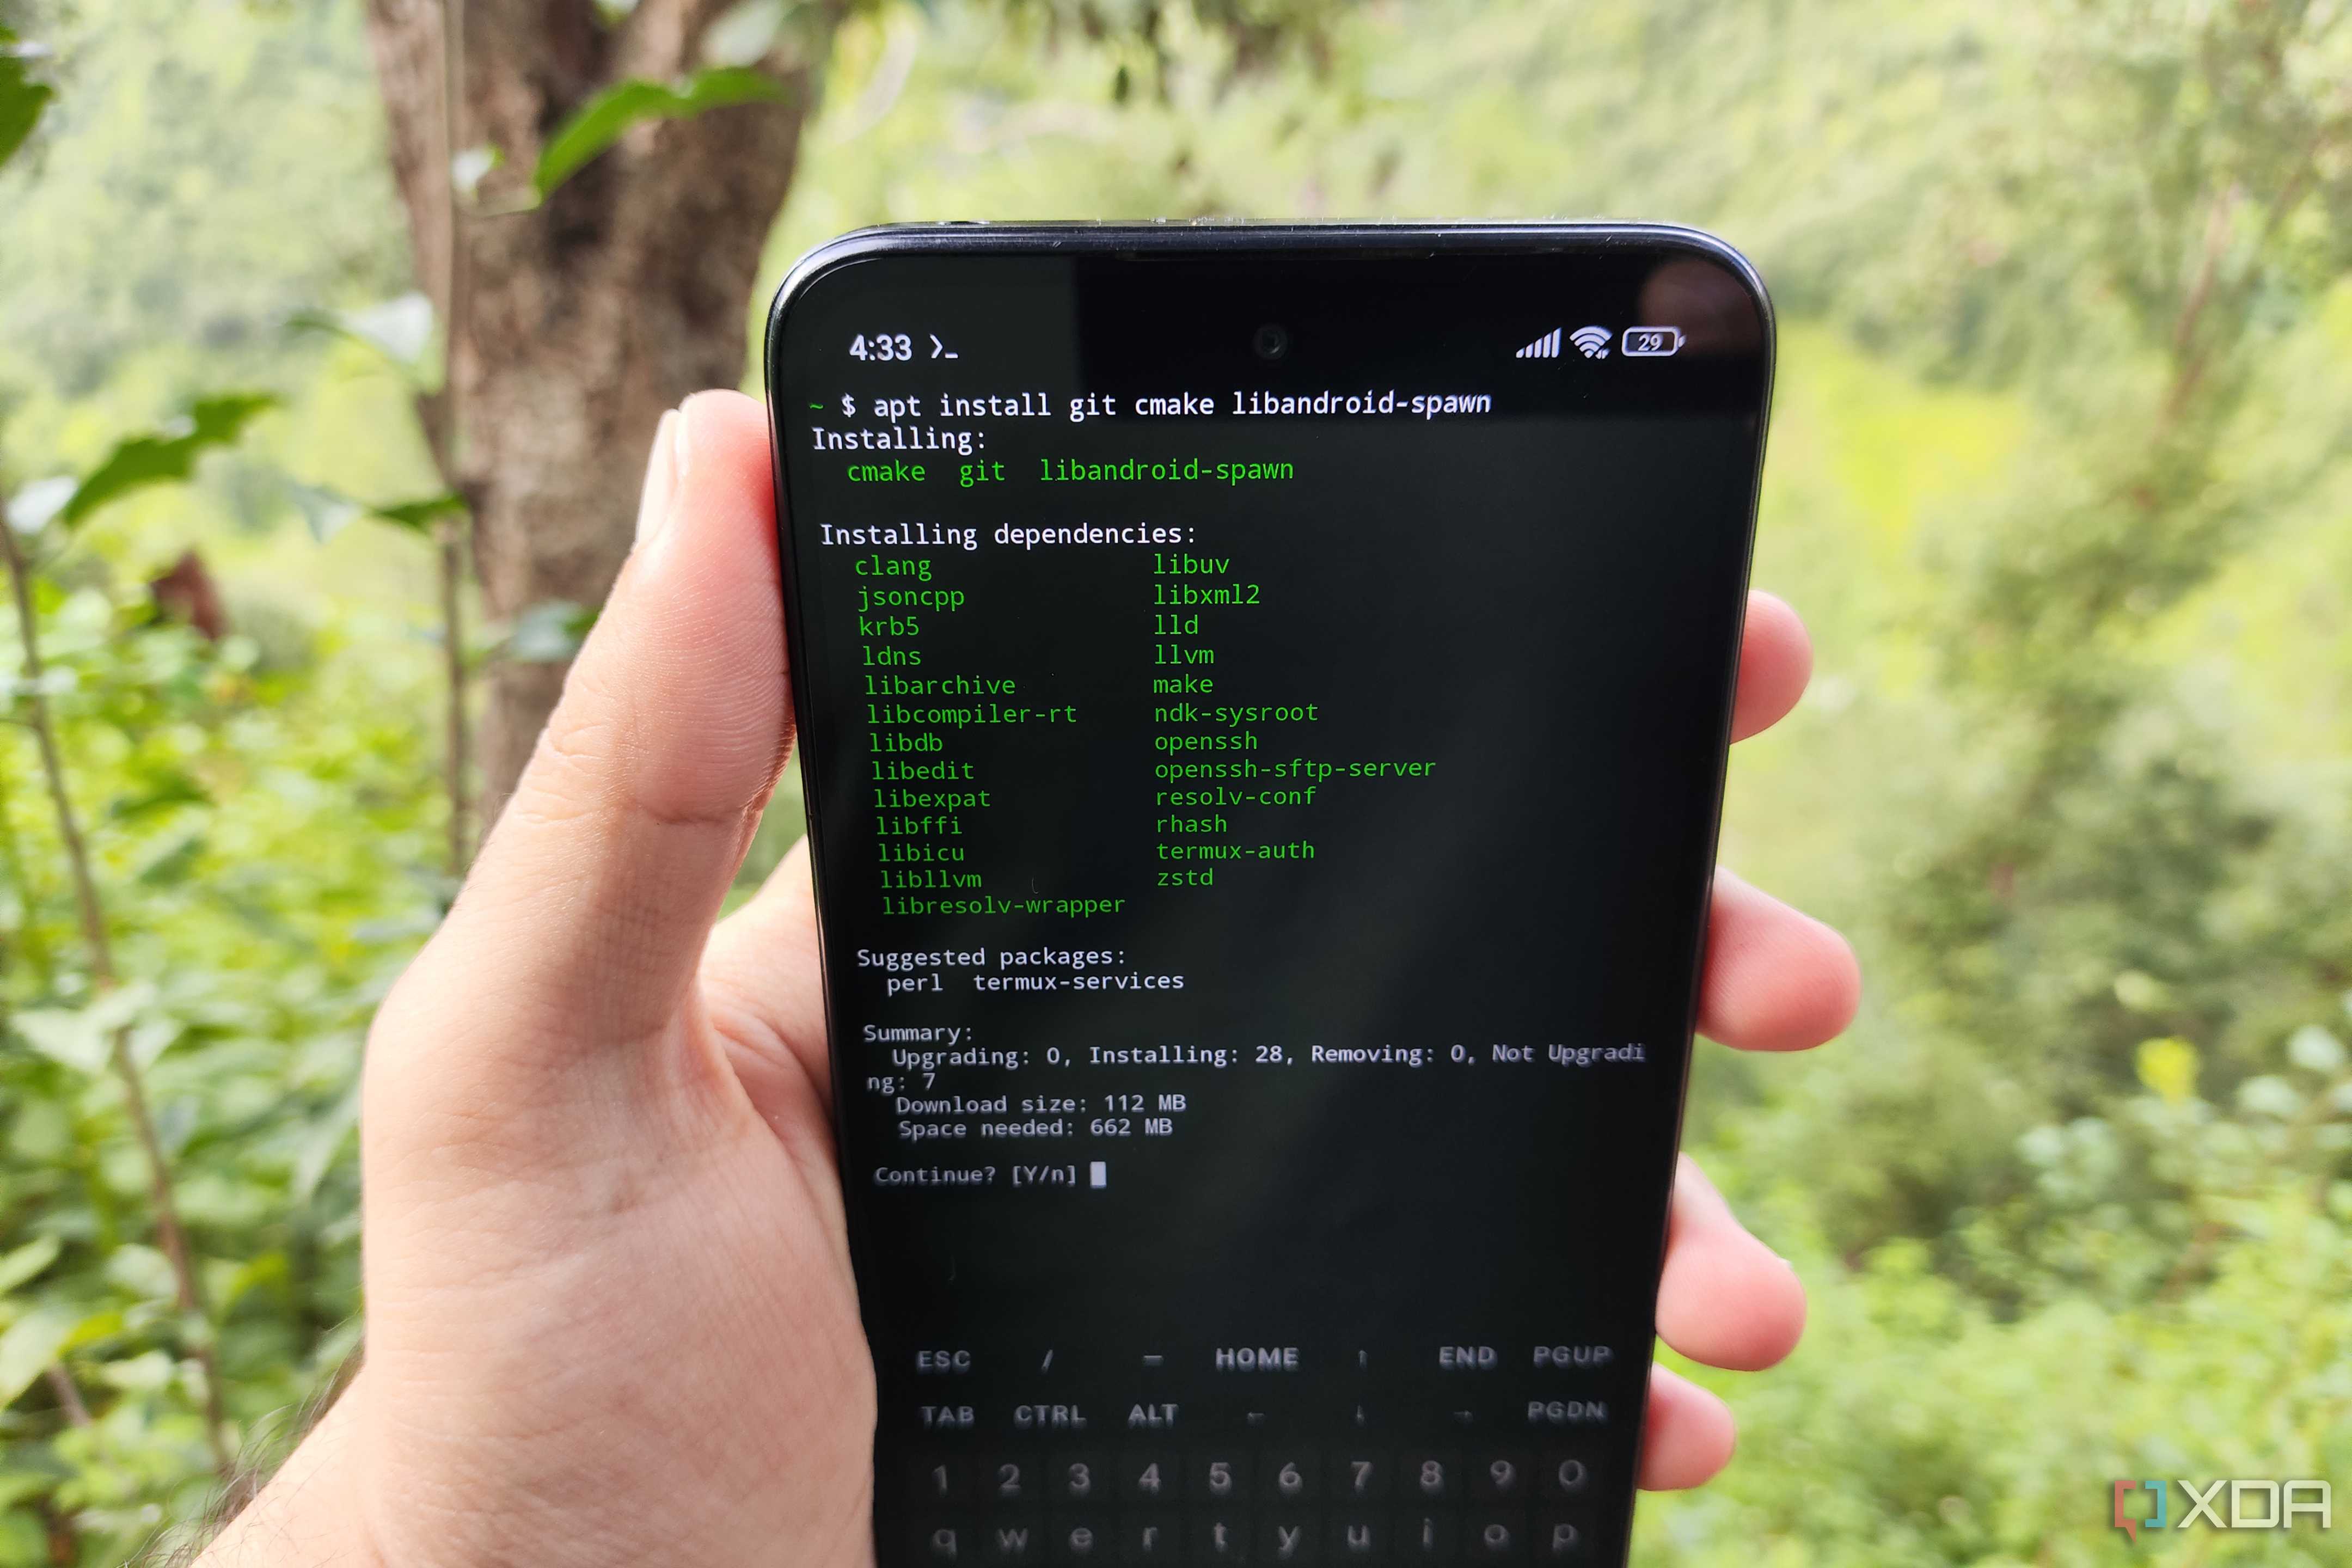
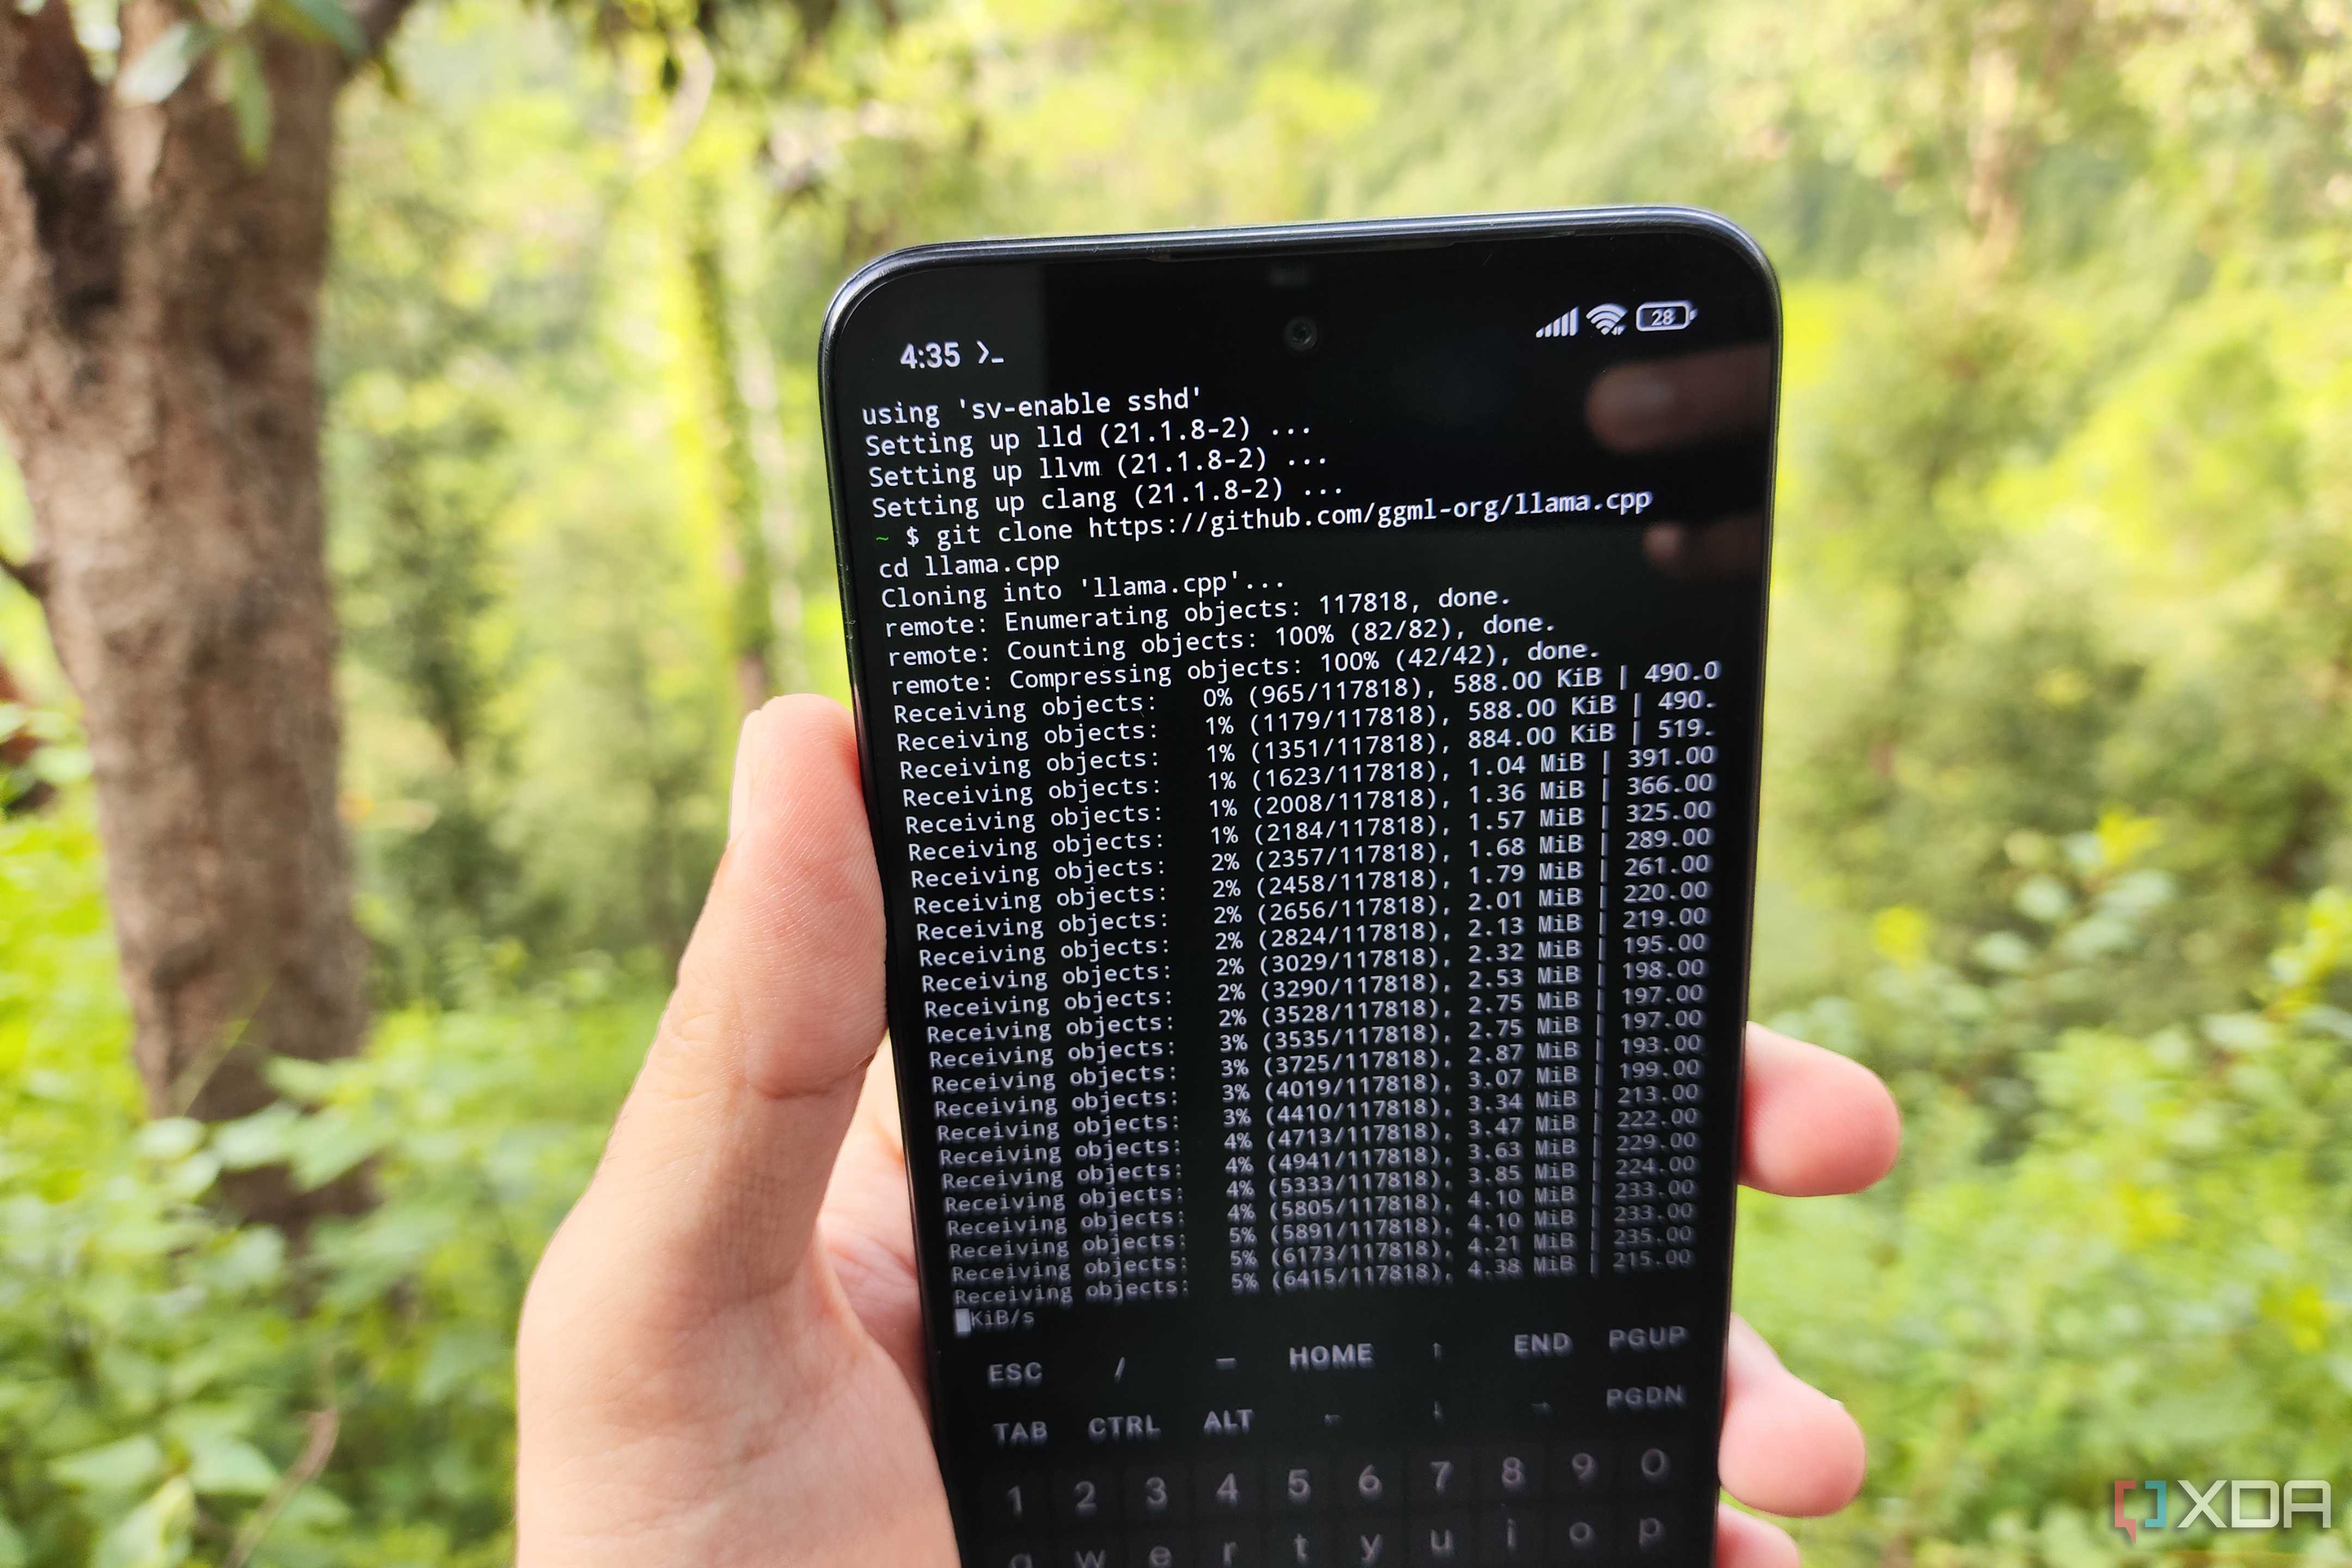
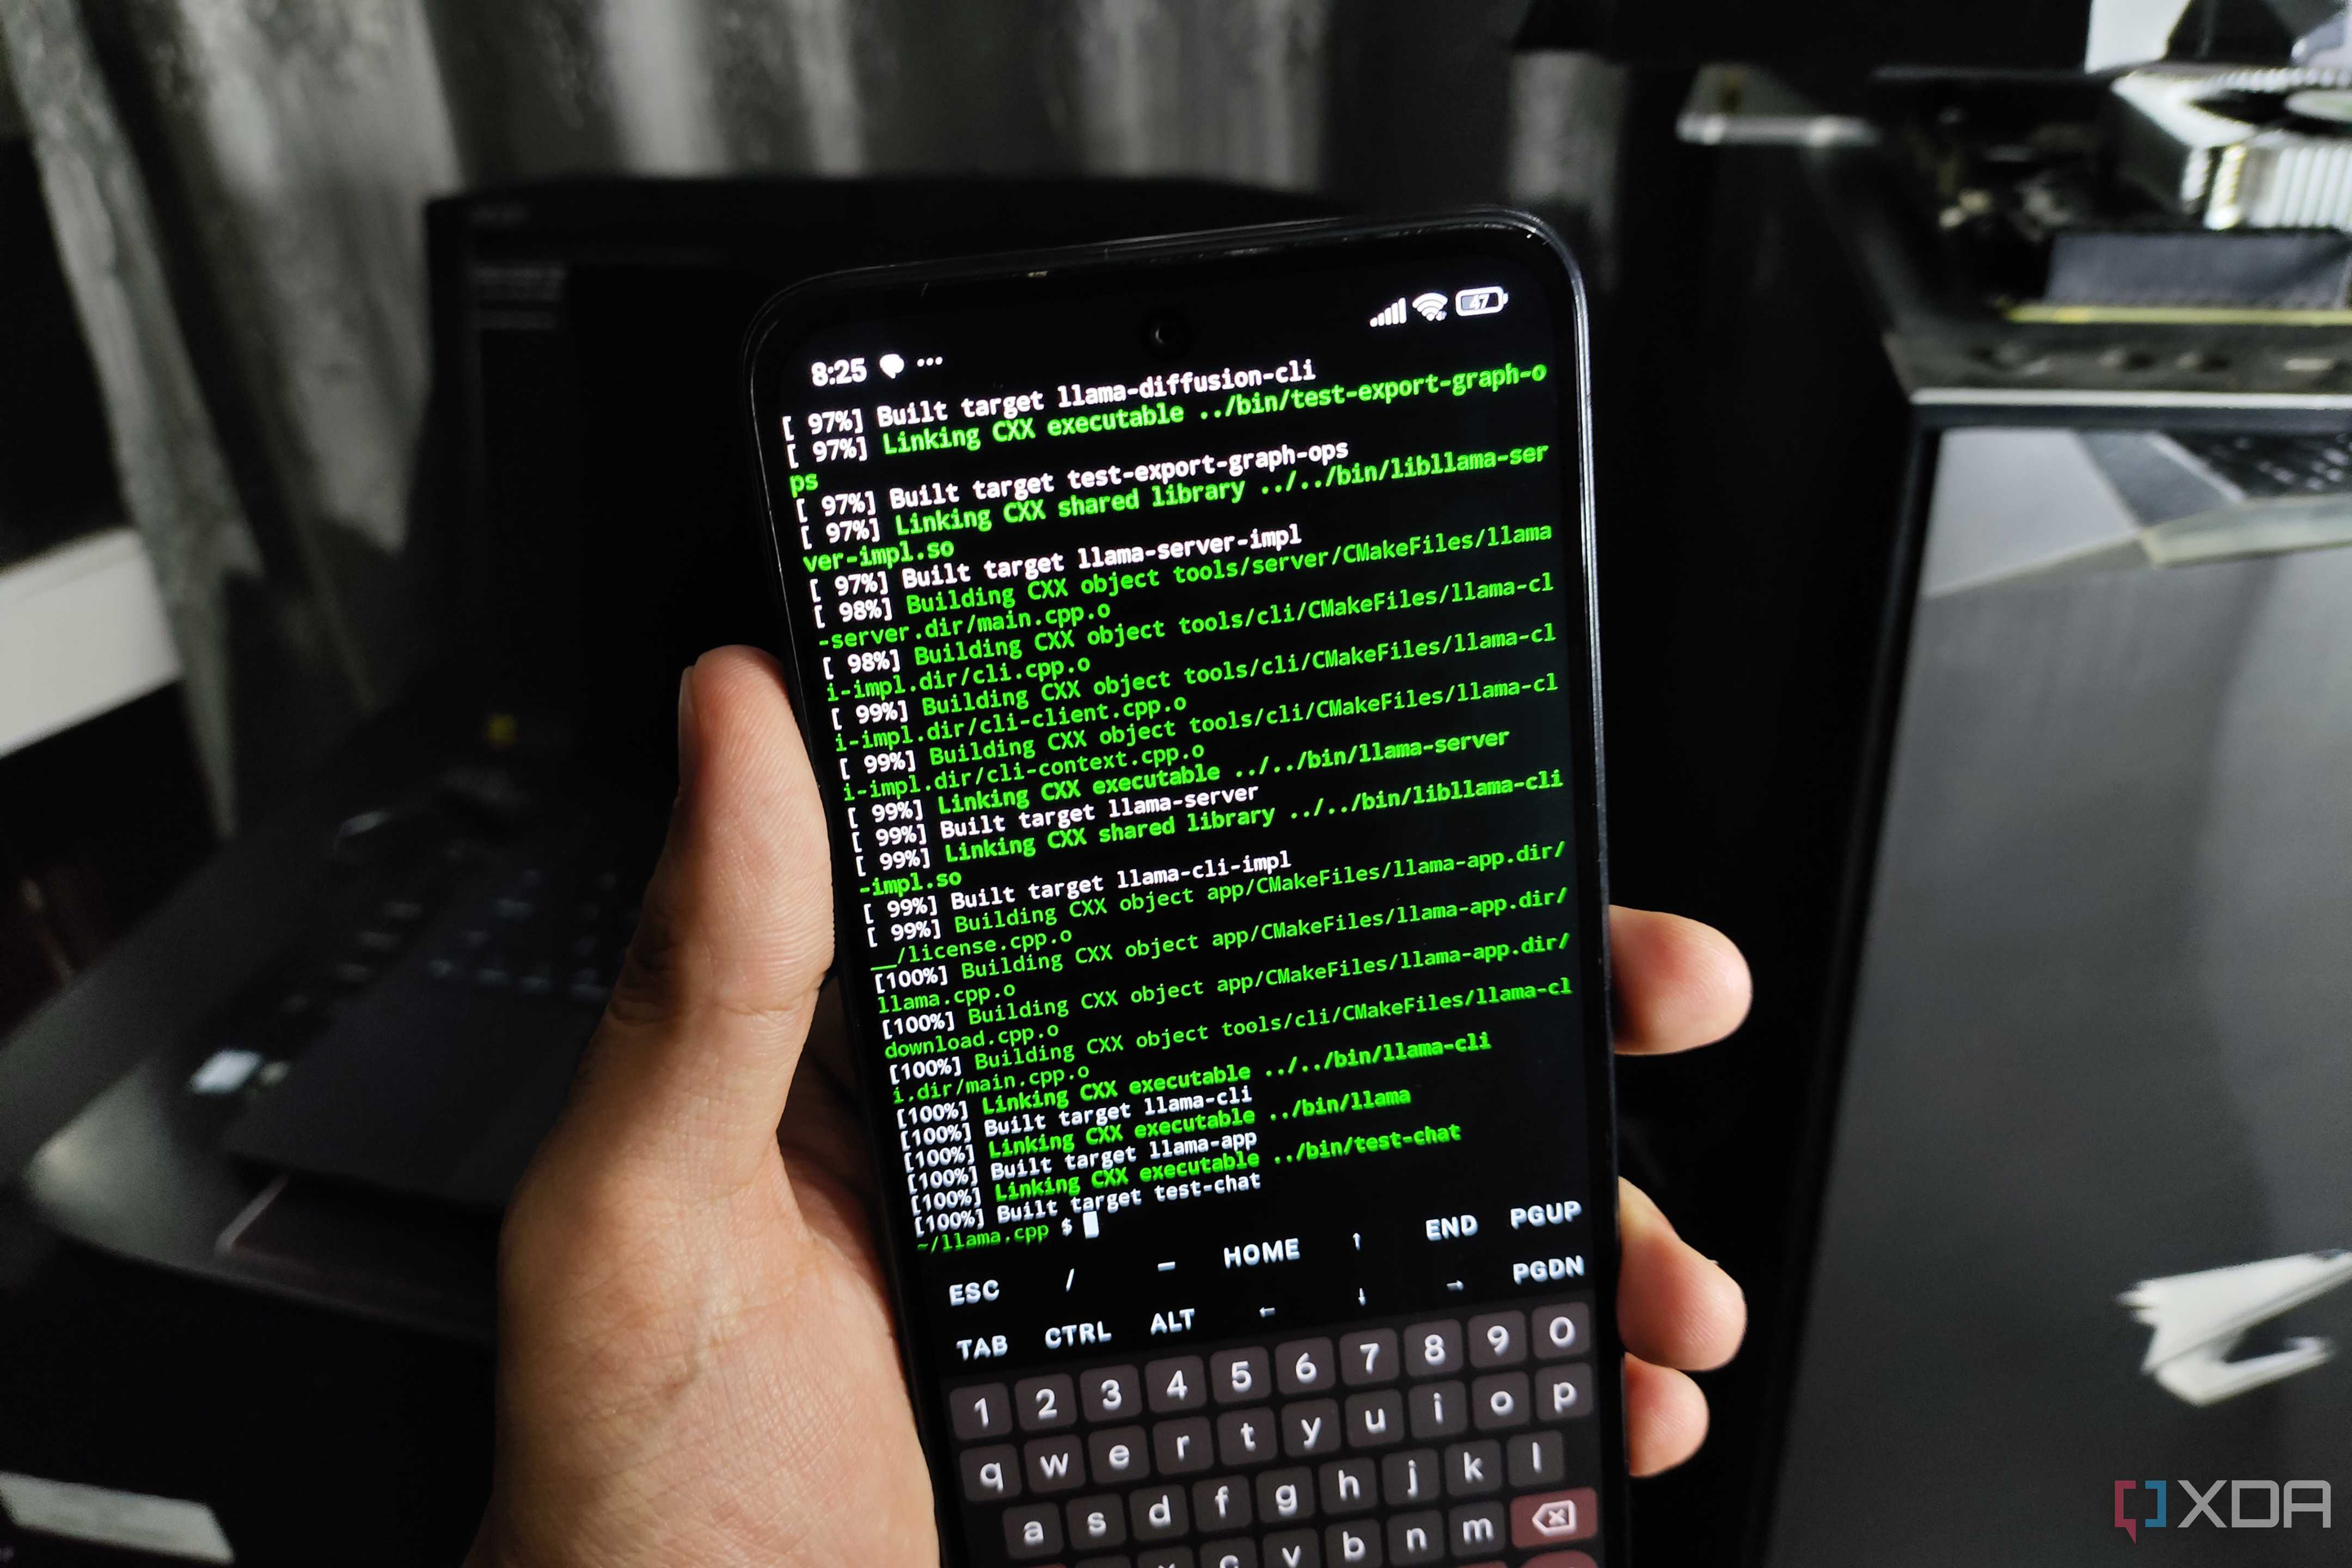
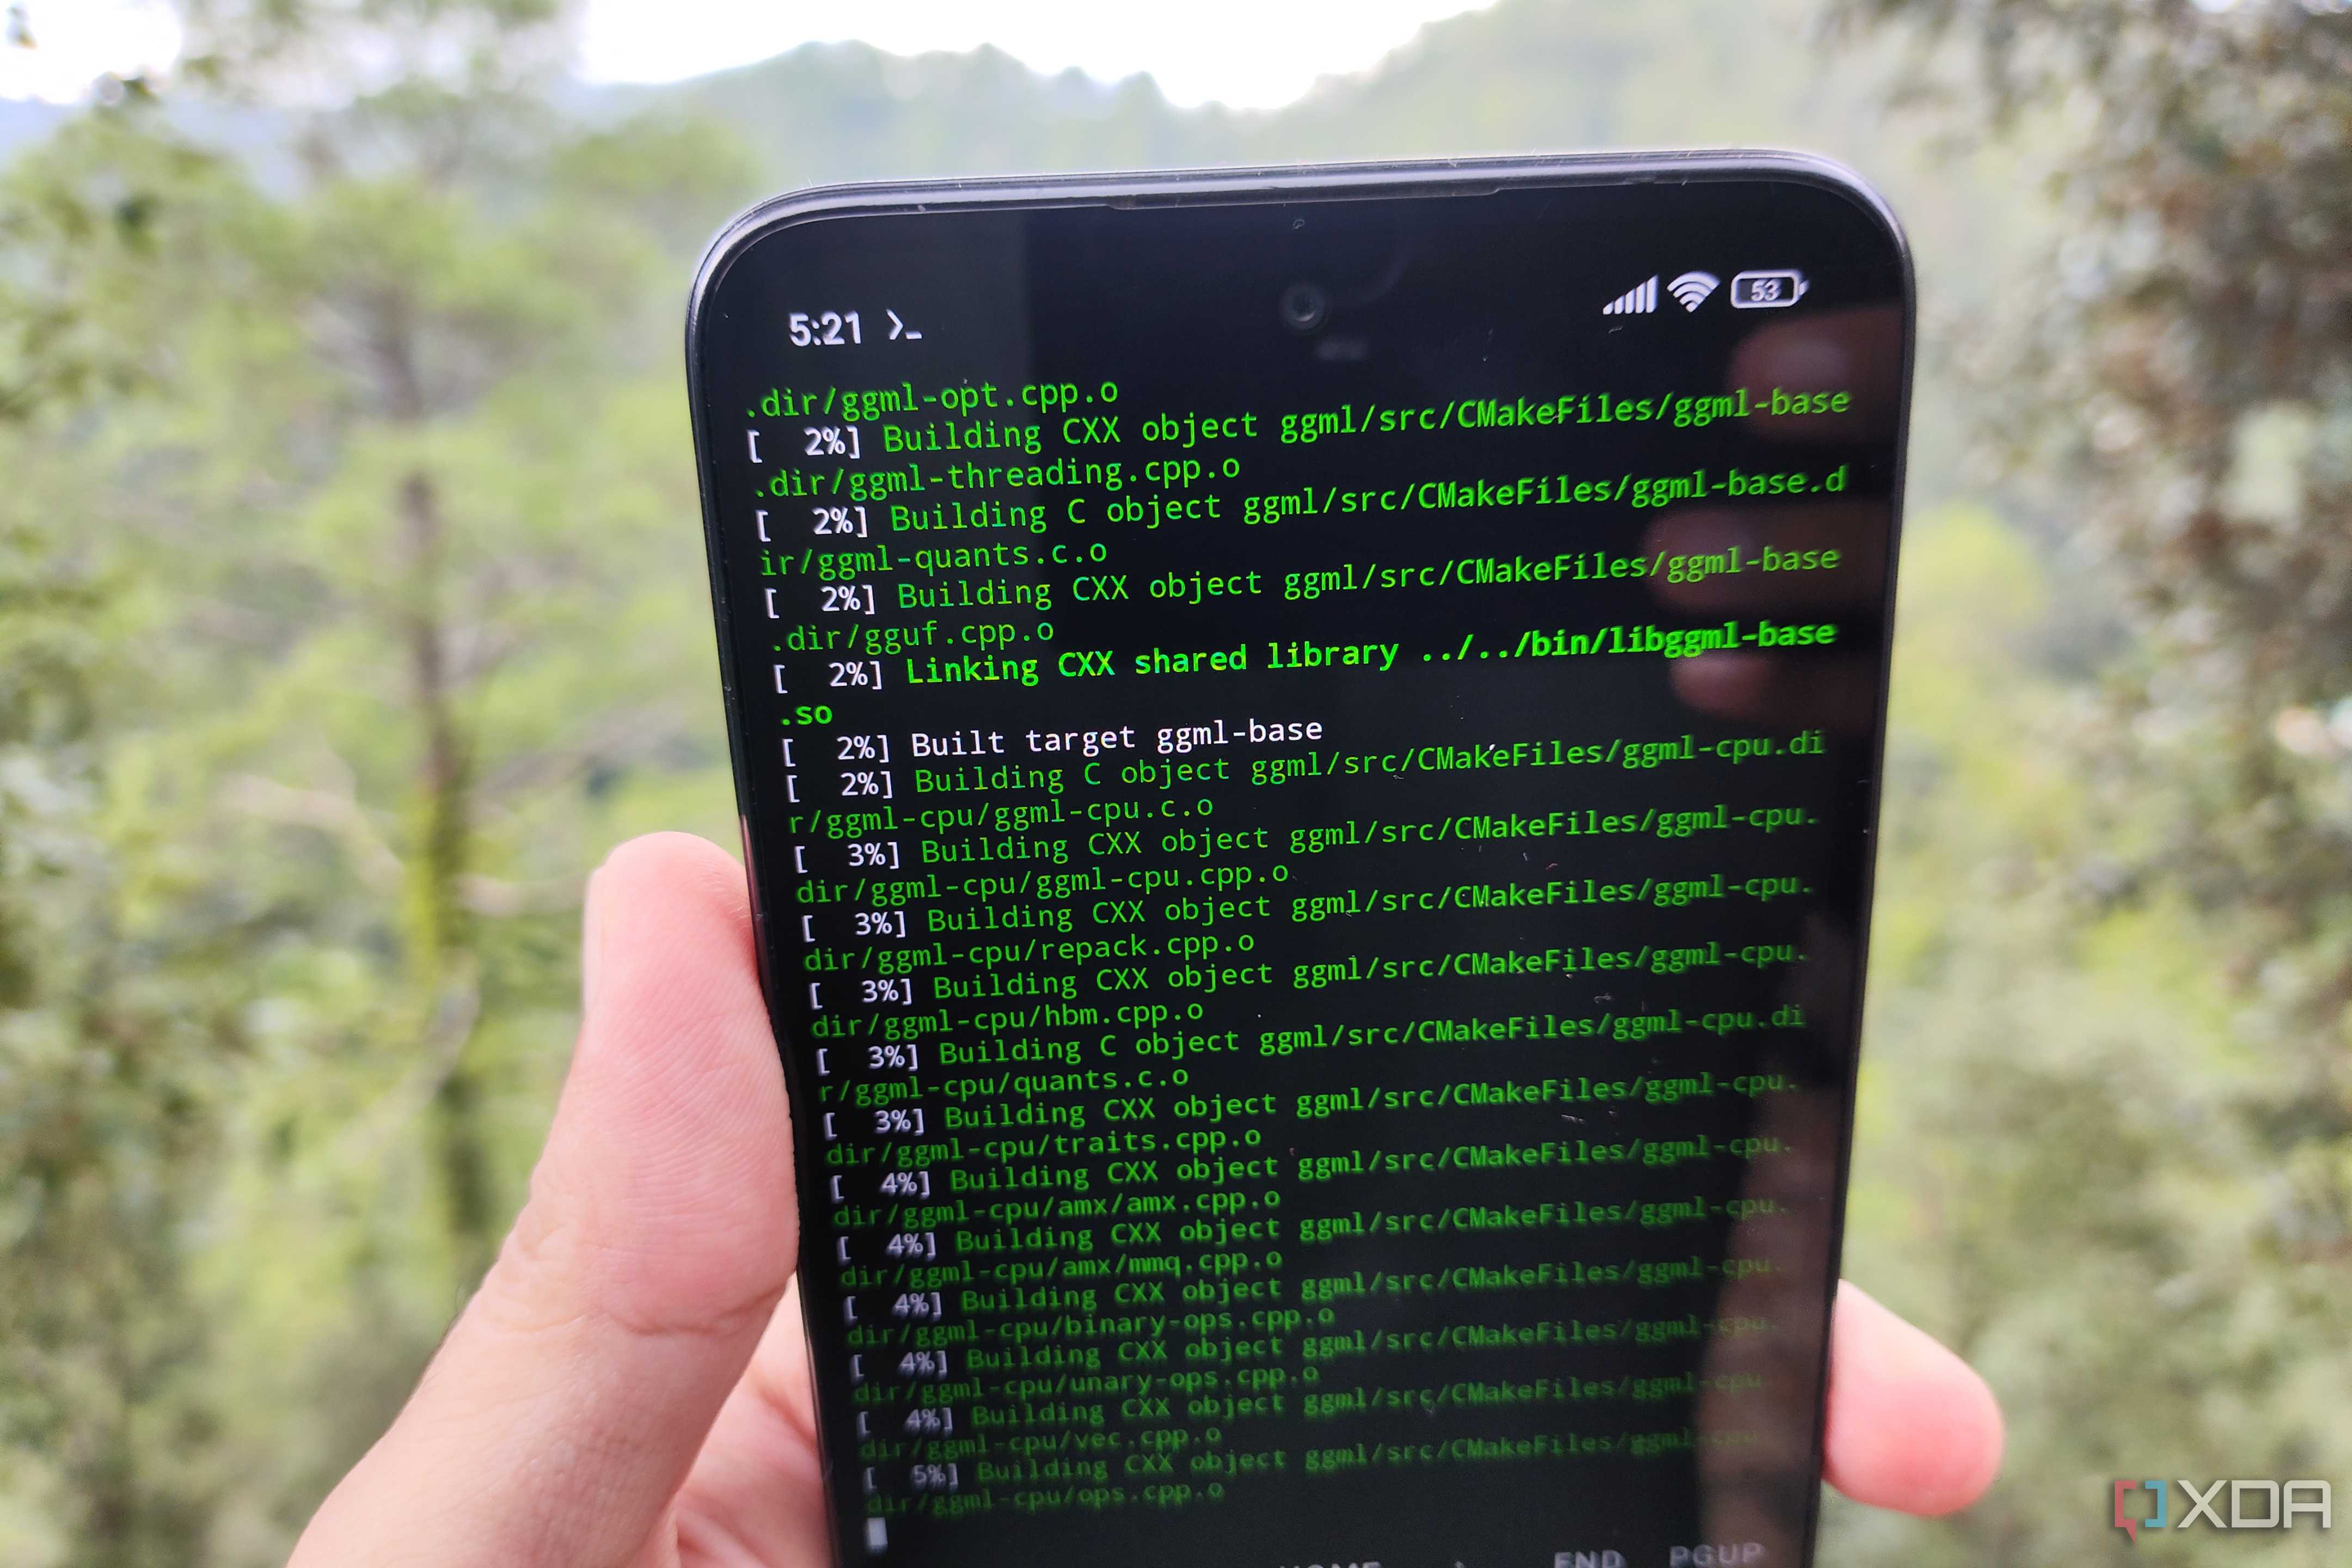
Процесс подготовки начался с установки необходимых зависимостей в среде Termux с помощью команды apt install git cmake libandroid-spawn. После этого был загружен исходный код репозитория через git clone https://github.com/ggml-org/llama.cpp с последующим переходом в созданную директорию. Первая попытка компиляции стандартными средствами показала, что телефон тратит на эту задачу слишком много времени. Процесс удалось существенно ускорить, задействовав параллельный режим сборки с помощью команды cmake —build build —config Release -j 8, что позволило подготовить сервер примерно за 45 минут.
Запуск модели Gemma 4 E2B и ее возможности
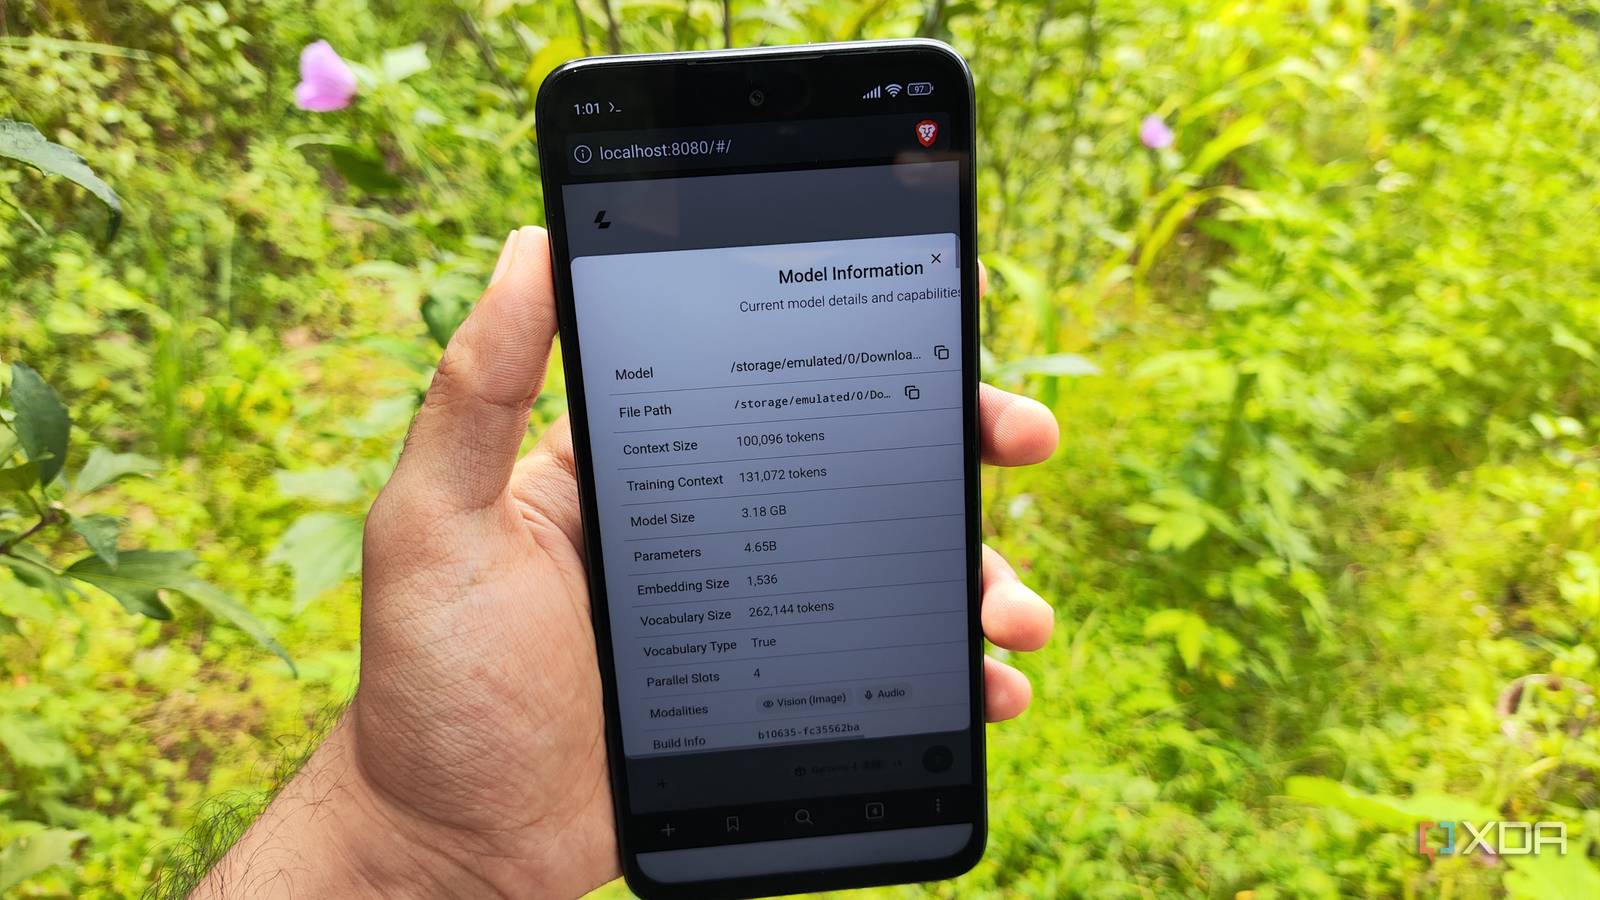
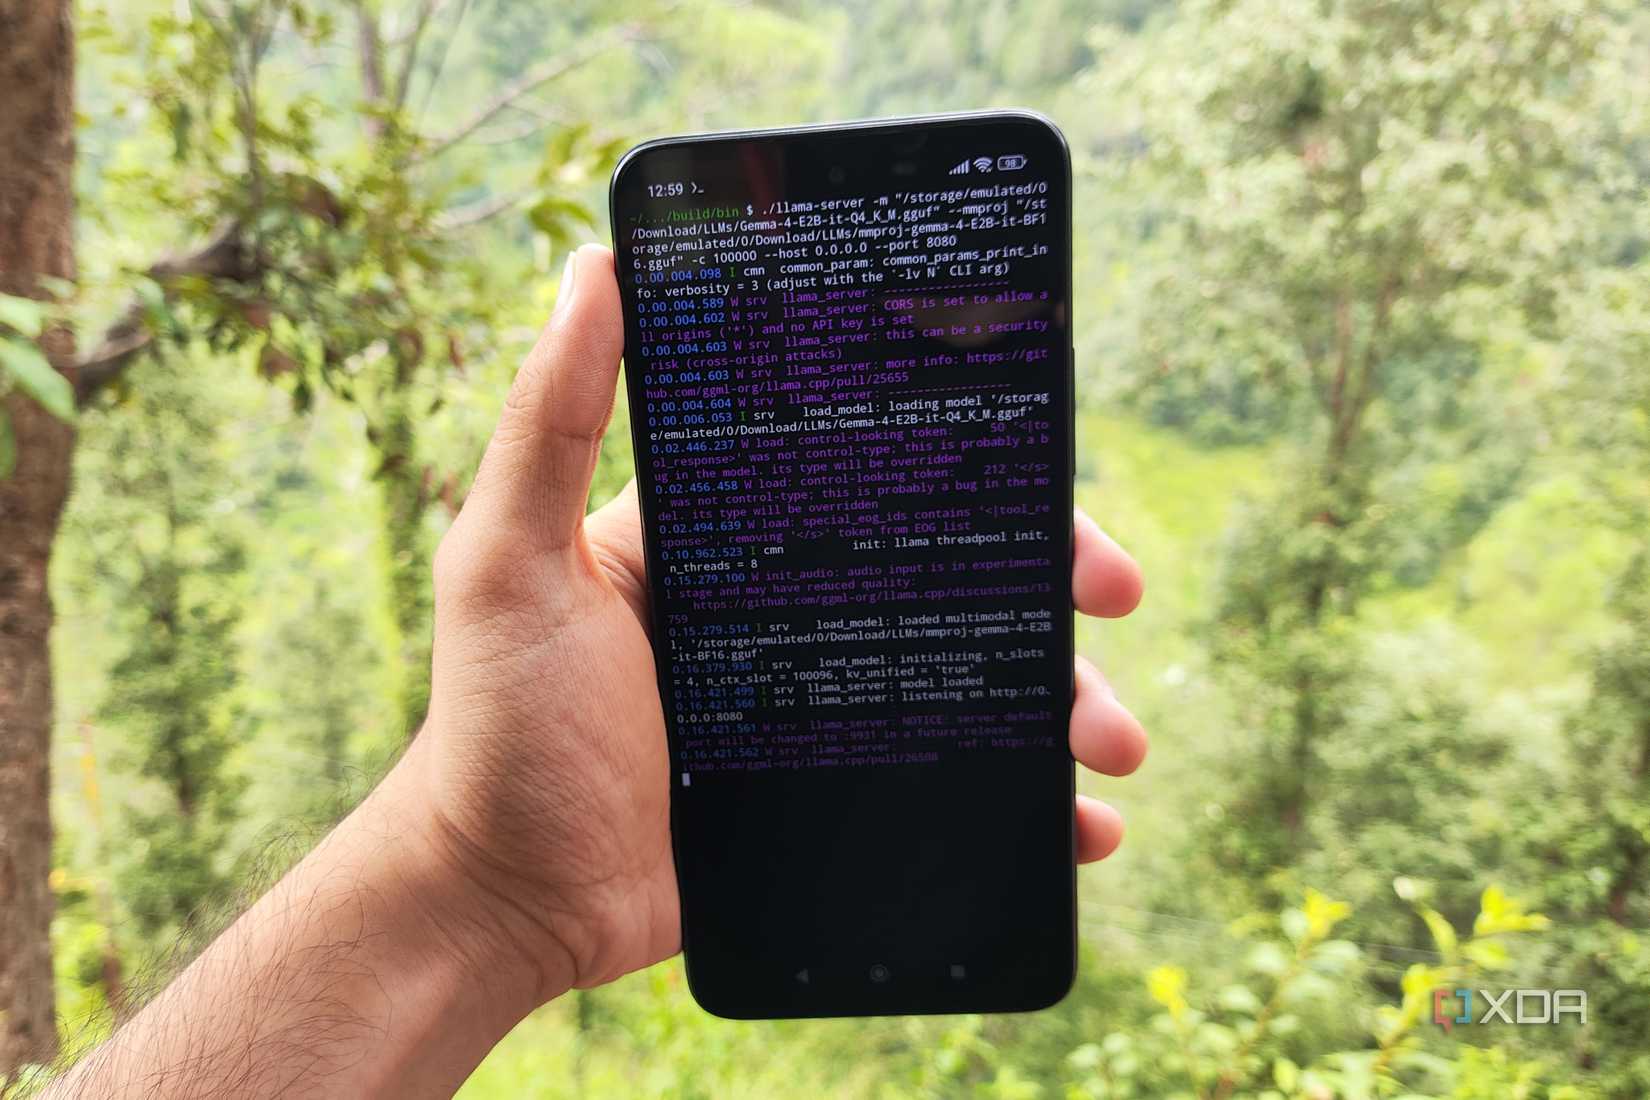
В качестве рабочей языковой модели была выбрана Gemma 4 E2B в конфигурации Q4_M_K. После предоставления Termux доступа к хранилищу телефона файлы формата gguf и mmproj были перенесены в память устройства. Для запуска использовалась команда с указанием путей к весам модели и mmproj-файлу, а также параметров контекста -c 100000, хоста и порта 8080.
Выбор Gemma 4 E2B обусловлен ее архитектурными особенностями. Технология Per-Layer Embeddings позволяет каждому слою декодирования использовать собственный вектор встраивания для любого токена, обеспечивая высокую скорость поиска без ущерба для вычислительного потенциала. Благодаря этому компактная модель демонстрирует качество рассуждений, сопоставимое с более крупными аналогами, сохраняя при этом скромные системные требования обычного решения на 2.3B.
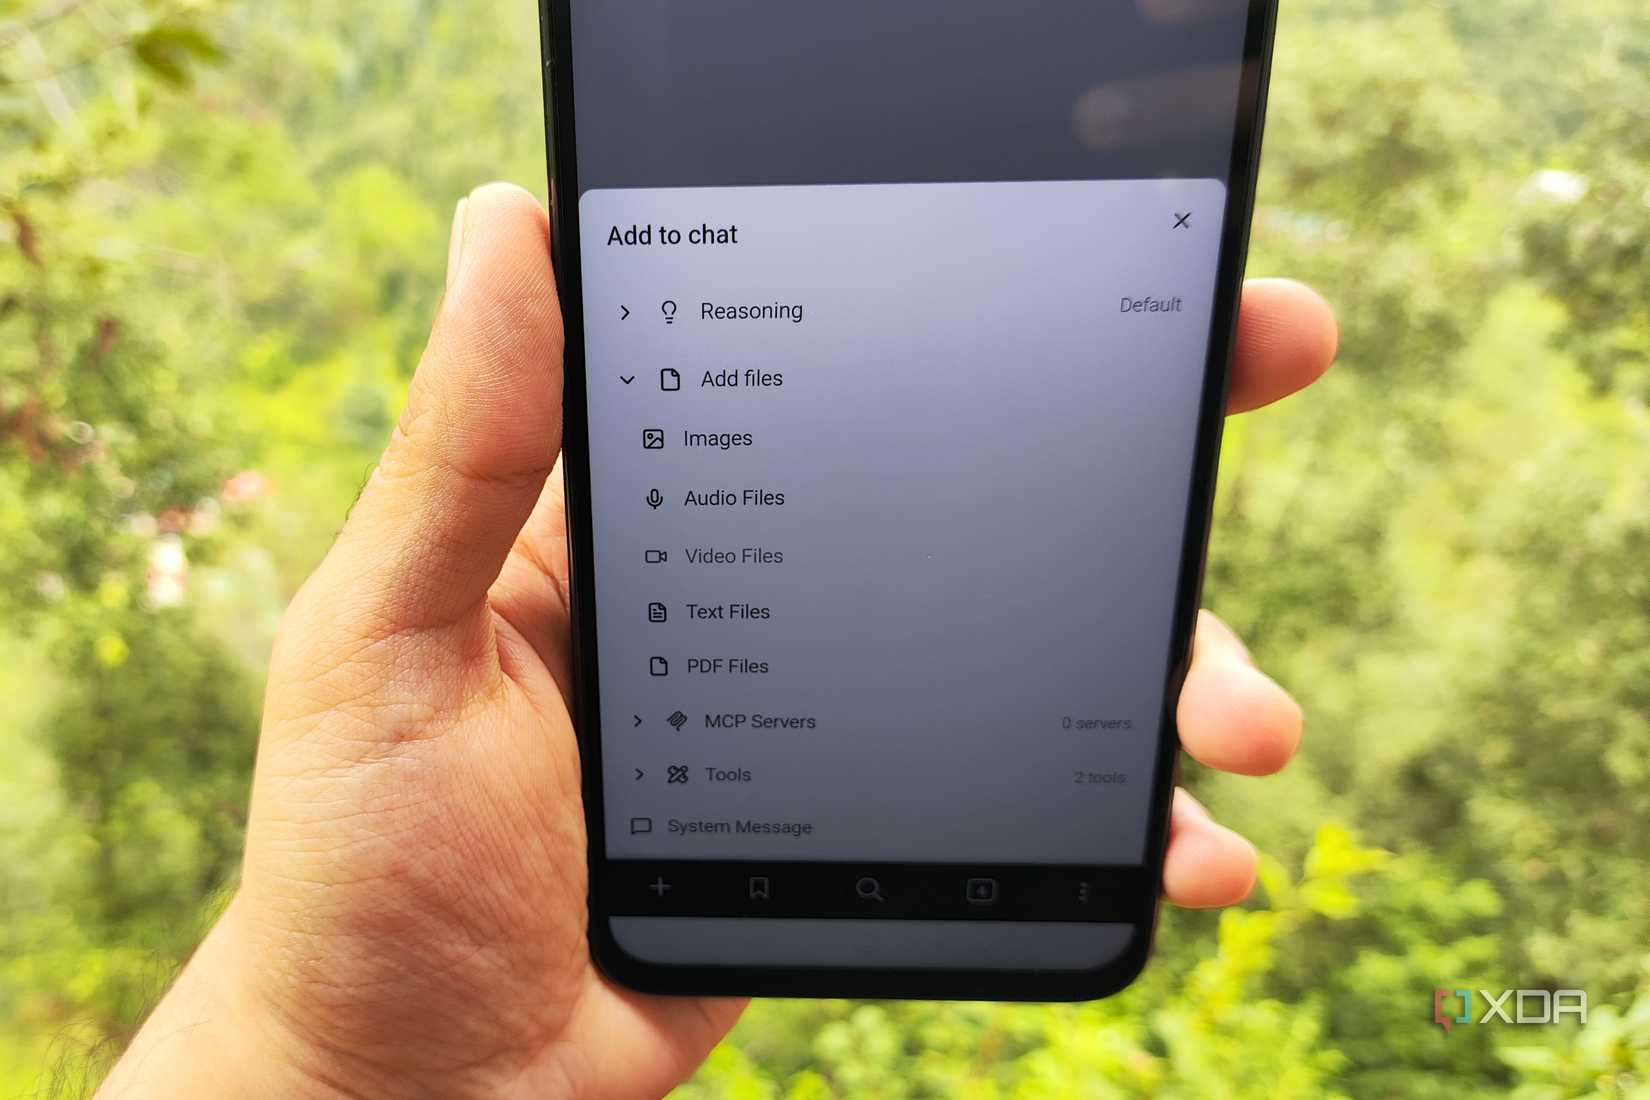
Кроме того, Gemma 4 E2B поддерживает обработку визуальных данных. Это позволяет делать снимки на камеру телефона, загружать их в веб-интерфейс llama.cpp и использовать изображения в качестве контекста для запросов. На старом смартфоне модель выдает в среднем 5-6 токенов в секунду, чего вполне хватает для базовой продуктивности вдали от домашней лаборатории.
Практическое применение и ограничения мобильного ИИ
Подобная мобильная конфигурация на базе llama.cpp находит применение для решения рутинных задач в поездках. С ее помощью можно генерировать быстрые отчеты оптического распознавания текста по личным документам, суммировать объемные PDF-файлы, заметки и электронные книги, а также проверять черновики электронных писем при необходимости срочно ответить с телефона.
Тем не менее, такая система не способна полностью заменить полноценные серверные узлы домашней лаборатории. Для сложных задач программирования или написания кода гораздо эффективнее использовать более мощные модели вроде Qwen3.6-35B-A3B. Мобильная установка на базе смартфона не поможет в создании сложных алгоритмов или автоматизации через Terraform, однако для анализа документов, OCR-запросов и генерации идей ресурсов старого телефона оказывается более чем достаточно.
Альтернативные приложения и тестирование производительности
До принятия окончательного решения об использовании связки с Termux рассматривались и другие готовые приложения с графическим интерфейсом, такие как MLC Chat, AnythingLLM Mobile и PocketPal AI. Однако для минимизации нагрузки на аппаратные ресурсы бюджетного смартфона потребовался инструмент с экстремально малым потреблением системных ресурсов.
Особенности архитектуры и визуальные возможности
Интересной особенностью выбранной модели является ее способность работать в паре с родственным вариантом E4B. Несмотря на скромный размер, производительность такой системы позволяет задействовать камеру смартфона для захвата изображений, загрузки их через веб-интерфейс и мгновенного анализа.
Сравнение с десктопными и серверными решениями
Несмотря на удобство мобильного запуска, для ресурсоемких сценариев автор по-прежнему предпочитает локальные настольные системы и серверы домашней лаборатории. Например, модели класса Qwen3.6-35B-A3B на старых видеокартах архитектуры Pascal за счет тонкой настройки и флага —n-cpu-moe способны выдавать скорость генерации свыше 24 токенов в секунду, что недостижимо для мобильного процессора.
Дополнительные технические детали эксперимента
В процессе первоначального знакомства с миром локальных LLM автор статьи также успешно запускал модели вроде Qwen3.6-35B-A3B и Gemma-4-26B-A4B на устаревших видеокартах архитектуры Pascal, заменив ими облачные аналоги для своего стека свободного программного обеспечения (FOSS). Осознав, что сетевые хранилища (NAS) тоже способны справляться с определенными ИИ-задачами, энтузиаст продолжил эксперименты с домашними устройствами, включая свой старый смартфон Poco M6 Pro, обычно используемый для запуска простых контейнеризированных сервисов в дороге.
Нюансы компиляции llama.cpp
Прежде чем остановить свой выбор на связке с Termux, автор рассматривал и другие популярные приложения с графическим интерфейсом — например, MLC Chat, AnythingLLM Mobile и PocketPal AI. Однако целью было достижение экстремально малого потребления ресурсов на маломощном телефоне, чтобы избежать избыточной нагрузки на систему.
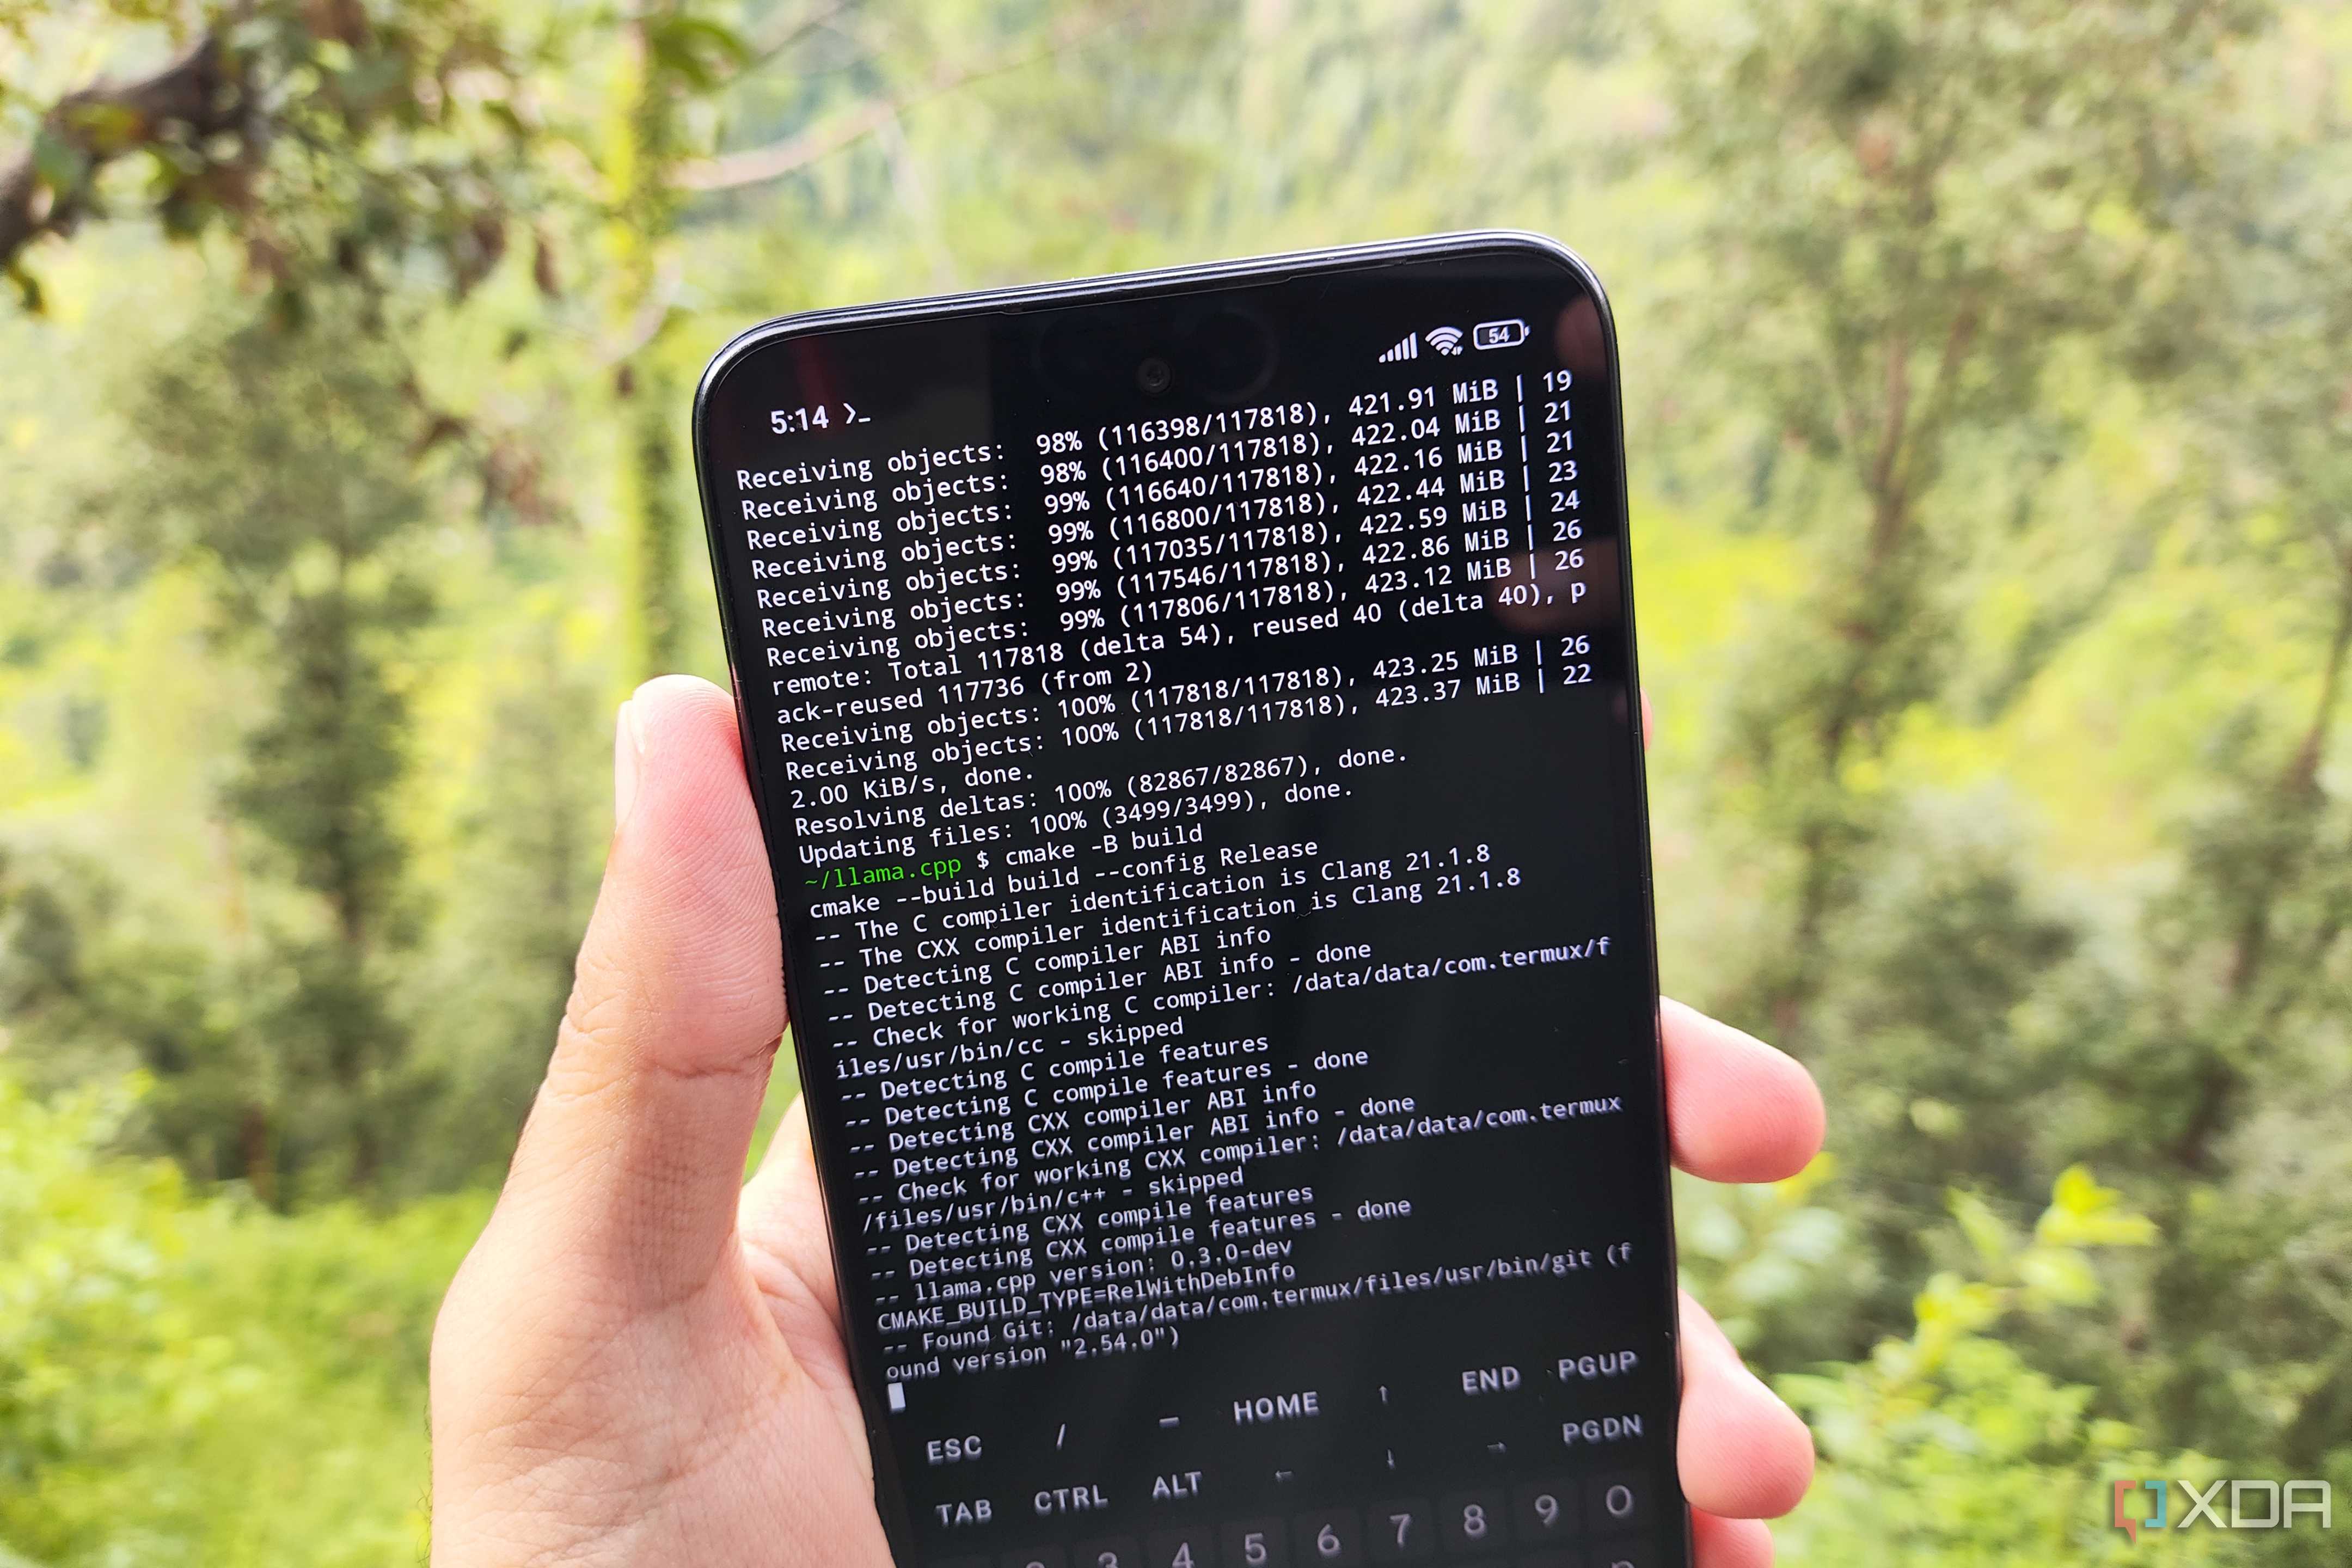
Сам процесс сборки движка состоял из следующих шагов:
- Клонирование репозитория через команду git clone https://github.com/ggml-org/llama.cpp.
- Переход в созданную директорию с помощью cd llama.cpp.
- Первоначальная попытка сборки стандартными командами cmake -B build и cmake —build build —config Release заняла слишком много времени, из-за чего процесс пришлось отменить.
- Успешная компиляция была завершена за 45 минут благодаря использованию официальной рекомендации с параллельным запуском восьми потоков: cmake —build build —config Release -j 8.
Детали запуска и специфические команды
Для инициализации языковой модели через серверную часть использовалась следующая конкретная команда:
./llama-server -m “/storage/emulated/0/Download/LLMs/Gemma-4-E2B-it-Q4_M_K.gguf” -mmproj “/storage/emulated/0/Download/LLMs/mmproj-gemma-4-E4B-it-BF16.gguf” -c 100000 —host 0.0.0.0 —port 8080
Стоит отметить, что модель Gemma 4 E2B демонстрирует наилучшие результаты в связке со своим родственным вариантом E4B среди решений подкатегории до 7B (а в некоторых случаях даже до 9B параметров). Благодаря упомянутой архитектуре Per-Layer Embeddings, обеспечивающей независимый вектор встраивания для каждого токена на каждом слое декодирования, достигается высокая скорость поиска без потерь в вычислительной мощности.
Сравнение производительности и ограничения
Хотя мобильный сервер выдает стабильные 5–6 токенов в секунду даже на фоне работающих фоновых контейнеров продуктивности, для серьезных задач он не предназначен. В частности, упомянутая десктопная модель Qwen3.6-35B-A3B при использовании специального флага —n-cpu-moe способна развивать скорость свыше 24 токенов в секунду на старом «железе», легко справляясь со сложным кодированием и автоматизацией через Terraform, с чем смартфон справиться уже не сможет.