Компания AMD поделилась результатами тестов производительности новых чипов Gorgon Halo в сфере генеративного искусственного интеллекта. Публикация бенчмарков состоялась в преддверии ожидаемого на этой неделе анонса устройств RTX Spark от Nvidia, который должен пройти после намеченного на среду, 7 октября, мероприятия Microsoft. Новые процессоры AMD выступают прямым конкурентом систем на базе RTX Spark, а также более крупных чипов Apple серий M. Информация о производительности появилась всего через несколько дней после выхода первых устройств на базе Gorgon Halo, стоимость некоторых из которых превышает 7099 долларов.
Поскольку независимых тестов производительности RTX Spark пока нет за исключением сомнительных утечек в Geekbench, компания AMD в качестве ориентира использовала не решения конкурента, а сравнение старшей модели Ryzen AI Max+ Pro 495 с процессором Intel Core Ultra X9 388H. Хотя эти чипы относятся к разным классам устройств, сравнение проводилось между флагманскими решениями обоих производителей. Для оценки возможностей генеративного ИИ AMD применила инструмент ComfyUI, усреднив показатели нескольких запусков различных моделей.
Результаты тестов и сравнение с конкурентами
Для тестов AMD использовала топовую конфигурацию Ryzen AI Max+ Pro 495 со 192 ГБ памяти и сопоставила ее с Intel Core Ultra X9 388H в системе с 64 ГБ оперативной памяти, притом что архитектура Panther Lake поддерживает до 128 ГБ. Преимущество по производительности составило от 1.1x до 32.2x, хотя предельное значение является явным отклонением. Компания не предоставила данных по играм и общим приложениям, однако серьезных изменений по сравнению с чипами прошлого поколения Strix Halo не ожидается, так как Gorgon Halo представляет собой преимущественно их обновление.
Главным соперником Gorgon Halo выступает именно платформа RTX Spark, а также процессоры Apple. Назвав категорию таких систем «агентными ПК» (agentic PCs), AMD в ходе пресс-брифинга сначала заявила о поставках «десятков миллионов» ИИ-ПК, но затем уточнила показатель до «более полумиллиона» агентных ПК. Вероятно, речь идет суммарно об устройствах линейки Strix и Gorgon Halo. Основное противостояние между Gorgon Halo и RTX Spark строится вокруг объема памяти. Устройства на базе RTX Spark поддерживают до 128 ГБ унифицированной памяти, аналогично чипу GB10 в системе DGX Spark, в то время как AMD в Gorgon Halo увеличила этот показатель до 192 ГБ. Больший объем памяти позволяет запускать локально более крупные модели, пусть и с более низким уровнем производительности.
Особенности работы с большими языковыми моделями
В тестах модели GLM 5.3 Flash с 320 миллиардами параметров (где для каждого токена активируется 18 миллиардов) AMD зафиксировала пиковую скорость обработки на уровне 20 токенов в секунду с использованием формата смешанной квантизации UD-IQ4_XS от Unsloth. Для контекста, в тестах DGX Spark при работе с GPT-OSS 120B и 4-битной квантизацией фиксировалось 64 токена в секунду, а у чипа предыдущего поколения Ryzen AI Max+ 395 — 56 токенов в секунду. Модель GPT-OSS 120B использует смесь экспертов с 120 миллиардами общих параметров, из которых активны около 5 миллиардов на токен.
Кроме того, AMD продемонстрировала показатели многомодальной MoE-модели Qwen 3.8 Flash Next, которая имеет 125 миллиардов основных параметров, 51 миллиард параметров эмбеддингов и около 4 миллиардов параметров для предсказания нескольких токенов (MTP), при этом активны 5 миллиардов параметров на токен. Сообщается, что с динамической 4-битной квантизацией Unsloth и MTP процессор Ryzen AI Max+ Pro 495 достигает до 42 токенов в секунду. Тем не менее, производительность снижается при увеличении длины контекста, что может создать трудности при работе с крупными моделями.
Линейка Gorgon Halo является развитием архитектуры Strix Halo с увеличением объема унифицированной памяти до 192 ГБ и повышением тактовых частот буста модели 495 на 100 МГц при сохранении прежнего количества ядер и микроархитектуры. Тесты устройств с Ryzen AI Max+ 395 показали, что решение AMD уступало DGX Spark по времени до первого токена и скорости генерации во всех трех протестированных моделях. Наличие большего объема памяти дает возможность запускать массивные модели, но не гарантирует ускорение их работы. Первые устройства на базе Gorgon Halo уже поступили в продажу, включая мини-ПК Minisforum MS-S1 Max-P495, цена на которые в максимальной конфигурации составляет около 7000 долларов.
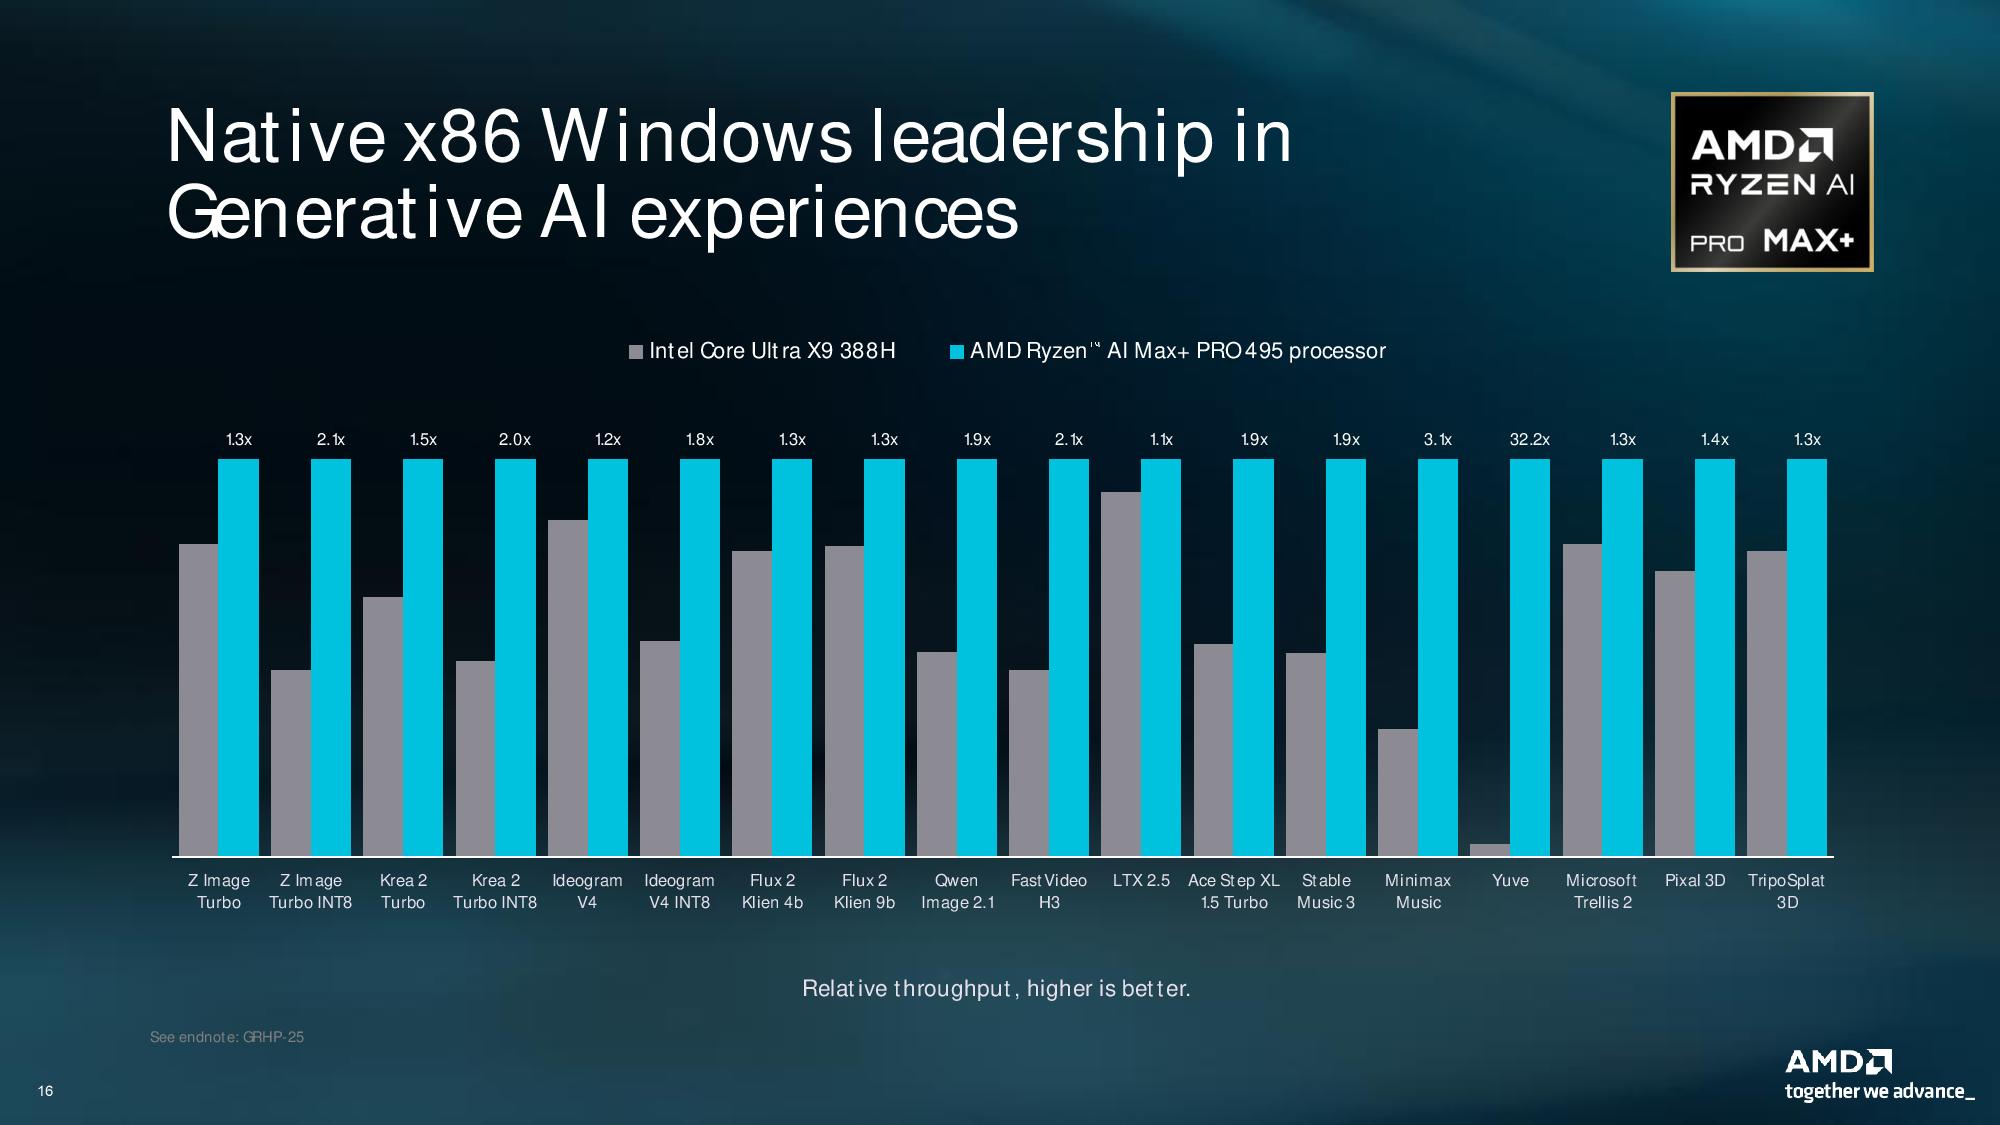
Сравнение производительности генеративного ИИ в тестах AMD строилось на измерении общего объема обработанного потока (throughput) с помощью ComfyUI. Разрыв в результатах между Ryzen AI Max+ Pro 495 и решением от Intel варьировался от 1.1x до 32.2x, однако максимальный показатель оказался аномальным выбросом. Поиск модели Yuve на платформе Hugging Face не дал результатов, из-за чего эксперты предполагают либо проблемы с оптимизацией, либо слишком большой размер модели для запуска на системе с архитектурой Panther Lake.
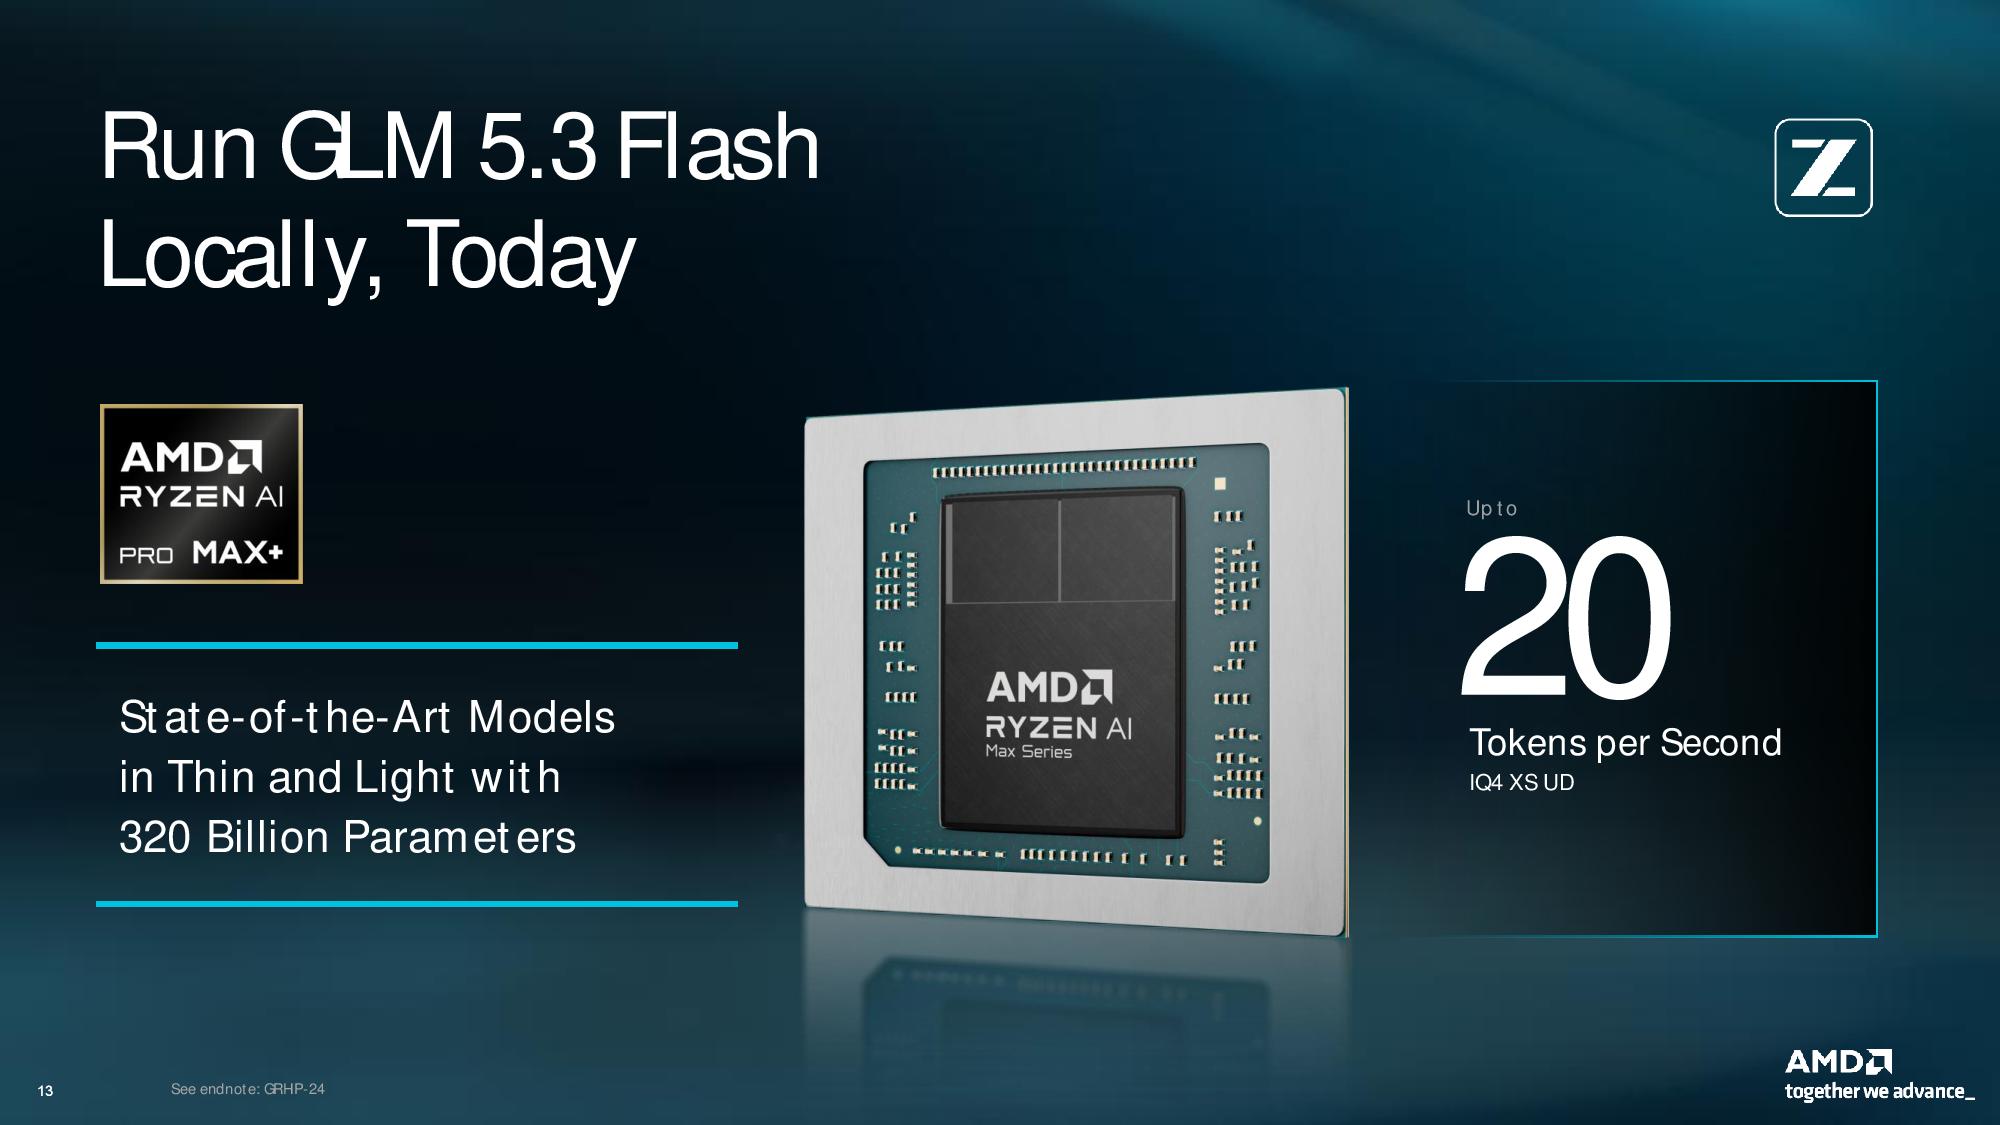
Что касается технических спецификаций протестированных языковых моделей, GLM 5.3 Flash обладает 320 миллиардами общих параметров, но на обработку каждого токена выделяется лишь 18 миллиардов активных параметров. Модель Qwen 3.8 Flash Next использует 125 миллиардов основных параметров, 51 миллиард параметров эмбеддингов и около 4 миллиардов параметров для предсказания нескольких токенов (MTP), причем в процессе участвует 5 миллиардов активных параметров на один токен.
Представители технологической сферы отмечают, что характеристика «до» (up to) играет определяющую роль в заявленных скоростях генерации. По мере увеличения длины контекста — то есть в реальных сценариях длительной локальной работы с моделями, а не при «холодном» старте — показатели производительности неизбежно падают. В случае с GLM 5.3 Flash скорость в 20 токенов в секунду может легко опуститься до неприемлемых значений при росте контекста.