Многие энтузиасты, начинающие осваивать локальный запуск ИИ-моделей, совершают типичную ошибку: они ориентируются исключительно на размер весов модели, полагая, что если файл помещается в видеопамять (VRAM), то работа будет стабильной. Однако практика показывает, что использование RTX 4070 Ti Super требует более глубокого анализа технических характеристик. Игнорирование определенных параметров приводит к тому, что генерация замедляется, модель начинает использовать системную оперативную память (RAM) или вовсе отказывается работать. Чтобы избежать лишних скачиваний и разочарований, стоит обращать внимание на четыре ключевых показателя.
KV-кеш как скрытая нагрузка на видеопамять
KV-кеш представляет собой оперативную память модели, в которой сохраняется история текущего диалога. В отличие от статических весов, объем этого кеша увеличивается пропорционально длине контекста. На видеокарте с 16 ГБ памяти модель с 14 млрд параметров в квантовании Q4 может оставлять около 7 ГБ свободного пространства, что кажется достаточным. Однако при увеличении окна контекста до 32 000 токенов несколько гигабайт памяти могут уйти под нужды кеша. Если модель использует полномасштабное многоголовое внимание, расход может оказаться еще выше. В итоге, при подаче длинного документа происходит «перелив» данных в системную RAM и резкое падение скорости генерации. По возможности стоит проверять, поддерживает ли используемая среда выполнения квантование кеша: снижение точности до Q8 позволяет примерно вдвое уменьшить занимаемый объем.
Тонкости квантования и расширения в именах файлов
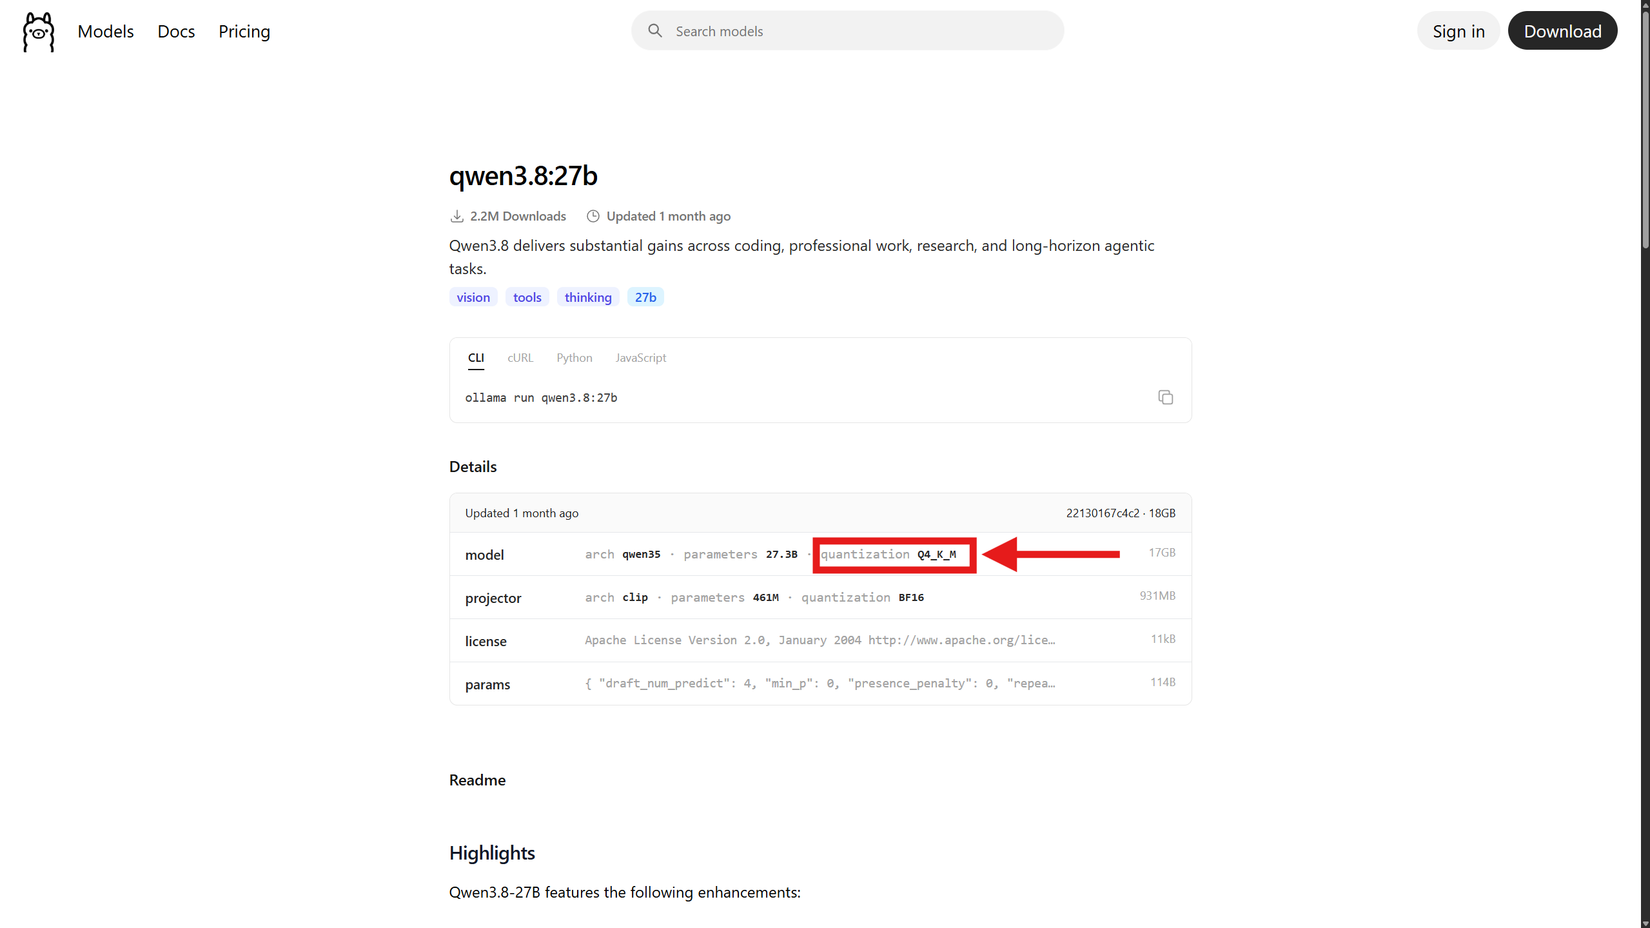
Термин «квантованная версия» часто является слишком общим. Обозначения вроде Q4_K_M, Q4_0 и IQ4_XS указывают на 4-битные модели, но они существенно различаются по количеству бит на вес, размеру и уровню потери перплексии. Разница между Q4 и Q8 может удвоить нагрузку на VRAM, что для видеокарты с 16 ГБ станет критическим фактором: 24-миллиардная модель в формате Q4_K_M может работать с запасом, тогда как версия Q8_0 просто не поместится. Важно обращать внимание на суффиксы: например, K-кванты сохраняют высокую точность для слоев, наиболее чувствительных к ней, сжимая остальные, что делает Q4_K_M более предпочтительным вариантом, чем стандартный Q4_0.
Активные параметры против общего количества
Путаница с числом параметров встречается часто. Например, модель Gemma 4 E4B не является 4-миллиардной в привычном смысле. Буква «E» означает «эффективные» параметры, и в данном случае их около 4,5 млрд при общем количестве около 8 млрд с учетом эмбеддингов слоев. Еще сложнее ситуация с моделями типа Mixture-of-Experts (MoE). У Qwen 30B-A3B каждый токен проходит через 3 млрд активных параметров, что обеспечивает высокую скорость генерации, но при этом все 30 млрд весов должны быть загружены в память. На 16 ГБ видеопамяти такая модель в квантовании Q4 может занимать 16–18 ГБ еще до учета кеша, поэтому она не будет полностью умещаться в VRAM, даже если по скорости работы кажется «легкой» моделью.
Реальный контекст обучения против маркетинговых заявлений
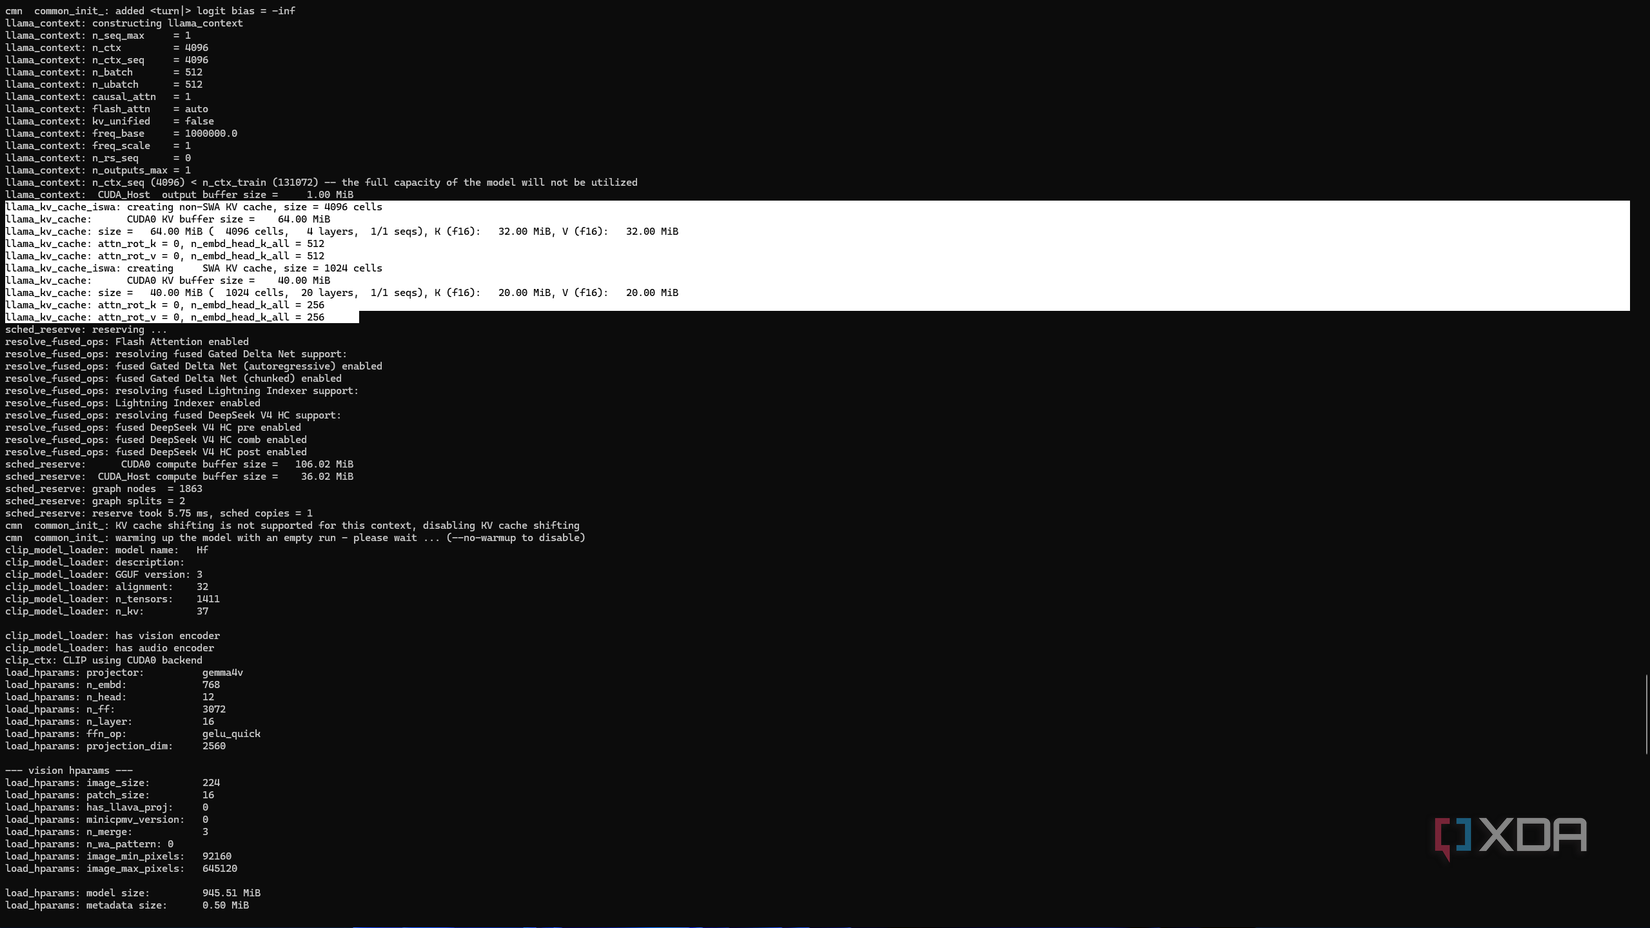
Не стоит буквально воспринимать заявленную длину контекста, например, 128 000 токенов. Между «поддержкой» контекста и «обучением на этом объеме» есть большая разница. Многие длинные окна достигаются путем масштабирования позиционных эмбеддингов после этапа предварительного обучения или с помощью технологий типа YaRN, хотя исходно модель обучалась на гораздо меньших данных. Проблема в том, что при превышении нативного порога модель не выдает ошибок, а просто начинает постепенно терять точность и «галлюцинировать». Нет смысла тратить VRAM на 128 000 токенов кеша, если модель становится ненадежной уже на отметке 32 000. Внимательный анализ этих четырех факторов позволяет заранее оценить требования модели и сделать использование локального ИИ комфортным.
Почему важно проверять возможности исполнения модели
Опыт работы с локальными моделями показывает, что разработчики или поставщики часто декларируют цифры, которые вводят в заблуждение пользователей, привыкших к облачным решениям. Когда вы скачиваете новую модель — будь то релиз от Alibaba или Google — стоит помнить, что даже после успешной загрузки вы можете столкнуться с «непослушным» поведением ПО, если заранее не проанализировали спецификации. Проблема заключается в том, что большинство гайдов в сети фокусируются на первичной установке, игнорируя нюансы, которые проявляются только в процессе реального использования.
Особенности архитектуры внимания и KV-кеша
Важно понимать, что KV-кеш — это не просто «дополнительная память», это постоянно растущий счет за использование VRAM. Помимо упомянутого объема контекста, критически важную роль играет тип механизма внимания. Если модель использует «полное многоголовое внимание» (full multi-head attention), а не более эффективный метод «группировки запросов» (grouped query attention), расход памяти может возрастать драматически. Когда вы загружаете модель и вставляете в нее длинный документ, падение скорости генерации не всегда происходит мгновенно — оно часто наступает именно в момент переполнения VRAM (VRAM spillover), когда данные начинают вытесняться в оперативную память. Учет этого фактора критически важен для тех, кто работает на видеокартах с фиксированным объемом памяти, где каждый гигабайт на счету.
Нюансы именования квантованных моделей
Путаница в форматах квантования — это бич современной локальной генерации ИИ. Пользователи часто видят «4-битные» версии и считают их идентичными, однако обозначения вроде Q4_K_M, Q4_0 и IQ4_XS скрывают под собой разные уровни «бит на вес» (bits per weight) и, как следствие, разную степень потери качества (perplexity loss). Суффикс — это не просто украшение, это паспорт модели. K-кванты разработаны специально для того, чтобы сохранять высокую точность в слоях, чувствительных к ошибкам, и агрессивно сжимать менее значимые части. Именно поэтому выбор правильного файла — это не вопрос того, «влезет или нет», а вопрос обеспечения того, чтобы модель вообще была способна адекватно рассуждать.
Эффективные параметры и MoE-модели
Для моделей семейства Mixture-of-Experts (MoE) проблема распределения памяти стоит острее, чем для плотных моделей. Хотя, например, 30B-модель с 3 миллиардами активных параметров (30B-A3B) генерирует текст со скоростью компактной модели, видеопамять она занимает как полноценная 30-миллиардная модель. При работе с 16 ГБ VRAM вы почти гарантированно столкнетесь с тем, что модель будет работать частично на видеокарте, а частично с использованием ресурсов процессора (CPU offloading). Несмотря на то что MoE-модели лучше переносят работу с CPU, чем их плотные аналоги, стоит всегда помнить об «активных параметрах» как о маркетинговом инструменте, который не отражает реальных физических потребностей модели в VRAM.
Риски работы за пределами «нативного» контекста
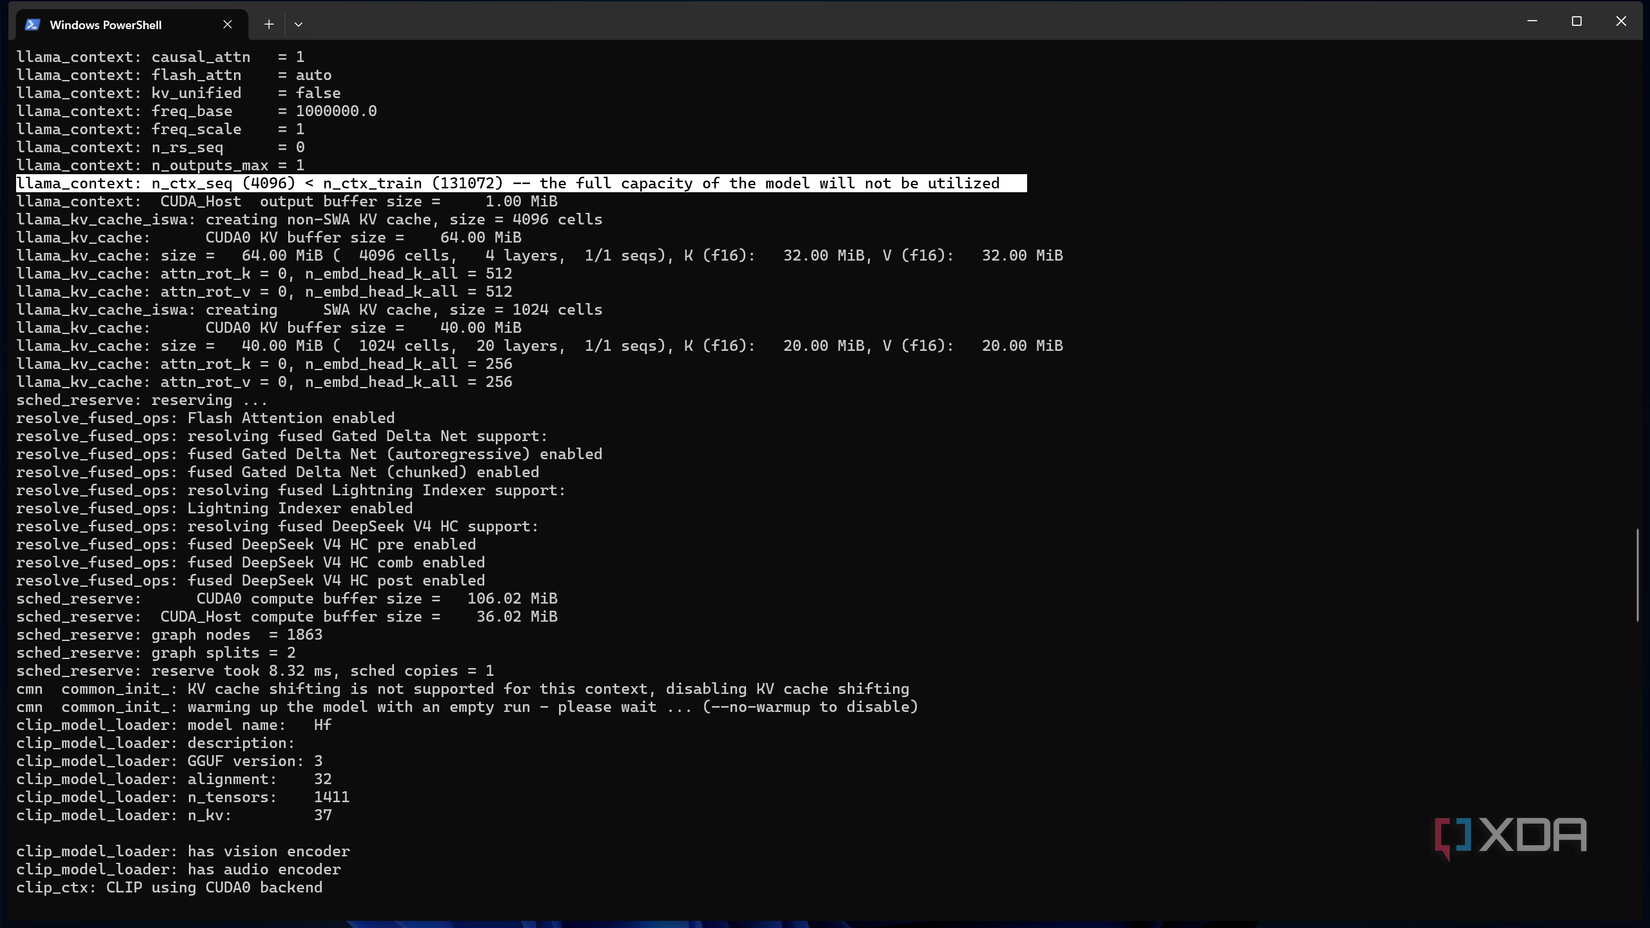
Особое внимание стоит уделить вопросу контекстного окна. В индустрии распространена практика, когда заявленные 128К контекста достигаются не в процессе обучения, а путем математических манипуляций (например, YaRN или масштабирование позиционных эмбеддингов). Самое неприятное в этом процессе то, что модель становится «тихим предателем»: она не сообщит об ошибке и не выдаст исключение, когда вы выйдете за пределы нативного окна. Она просто продолжит генерировать текст, который будет звучать убедительно, но станет постепенно терять способность корректно находить информацию в предоставленном документе. Понимание того, была ли модель обучена на заявленном контексте или «растянута» до него, помогает не расходовать драгоценную VRAM на пустые надежды, если предел надежности модели лежит гораздо ниже маркетинговых значений.