

Помимо опасений относительно возможного исчезновения человечества или формирования финансового «пузыря», одной из главных дискуссионных тем вокруг генеративного искусственного интеллекта остается методика обучения моделей. Технологические гиганты, такие как Microsoft и OpenAI, публично настаивают, что использование материалов, защищенных авторским правом, подпадает под концепцию «добросовестного использования» (fair use). Однако внутренние документы компаний, ставшие достоянием общественности, рисуют иную картину.
Критика практики обучения нейросетей
Согласно судебным документам, опубликованным в четверг, Брент Хехт, директор по прикладным наукам Microsoft, выразил мнение, что мировое сообщество в будущем может расценить создание больших языковых моделей как кражу в беспрецедентных масштабах. В материалах дела Хехт прямо охарактеризовал текущие методы обучения ИИ на огромных массивах данных из открытого интернета как, возможно, «крупнейшую кражу труда в человеческой истории».
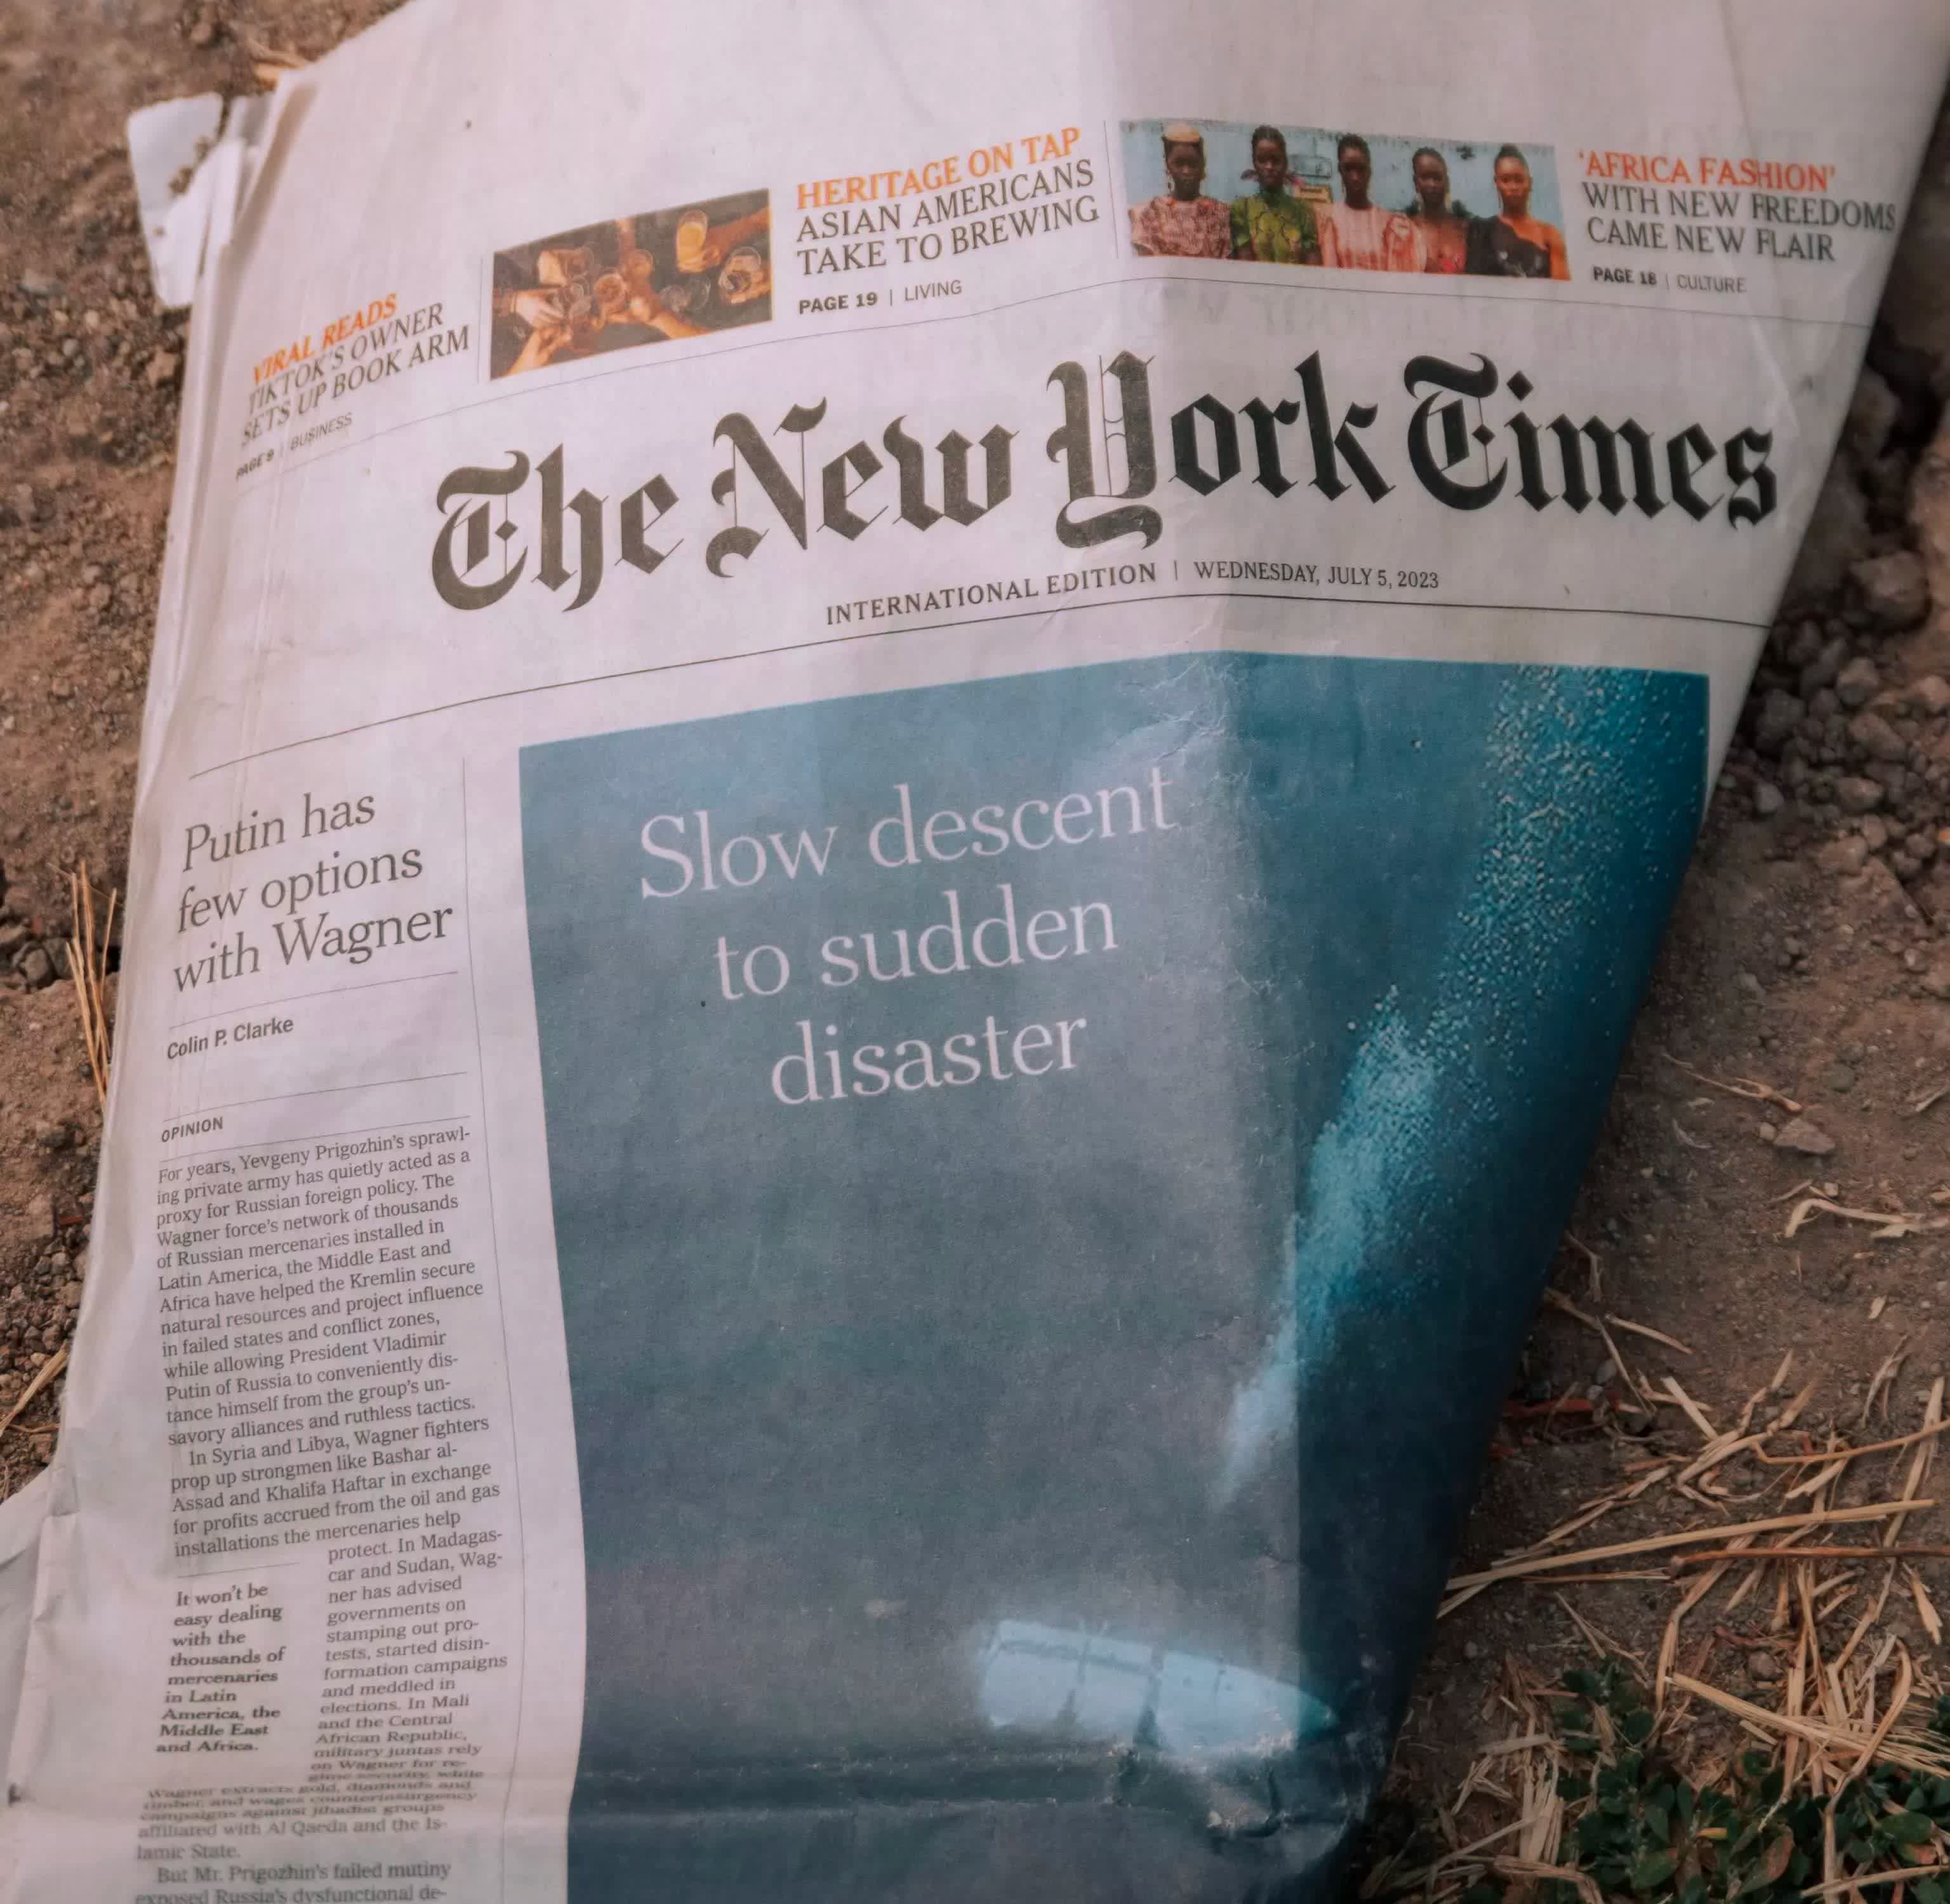
Данные высказывания противоречат официальной позиции защиты Microsoft и OpenAI в продолжающемся судебном процессе, инициированном рядом новостных изданий в конце 2023 года. В частности, иск The New York Times базируется на обвинениях в неправомерном использовании интеллектуальной собственности. Ответчики утверждают, что процесс обучения ИИ на статьях аналогичен чтению книг студентом, а выходные данные моделей достаточно трансформируют исходный материал.
Аргументы против концепции добросовестного использования
В ходе недавних слушаний выяснилось, что признания внутри компаний ставят под сомнение аргументы о трансформативном характере ИИ. В судебном материале приводятся комментарии Грега Брокмана из OpenAI, который признал, что ChatGPT способен предсказывать и дословно завершать предложения из статей The New York Times. Брент Хехт, в свою очередь, заявил, что для победы в текущем судебном разбирательстве компаниям-ответчикам придется «полностью высмеять саму идею добросовестного использования».
Ранее OpenAI уже признавала, что обучение современных моделей без доступа к защищенным авторским правом материалам технически невозможно. Схожую позицию в прошлом году озвучил бывший топ-менеджер Meta Ник Клегг, отметив, что при строгом соблюдении авторского права развитие ИИ практически остановилось бы.
Масштабы сбора данных и последствия для бизнеса
Тем временем индустрия продолжает использовать пользовательские данные, статьи и другие массивы информации для дообучения систем. Широкий общественный резонанс вызвали действия Meta по тренировке ИИ на поведении сотрудников. В Microsoft сервис GitHub Copilot обучается на коде пользователей по умолчанию, если они не активируют отказ от этого процесса. Платформа Twitch также начала позволять стримерам ограничивать использование их контента только после того, как годами тренировала на нем свои алгоритмы. Кроме того, разработчики ИИ массово закупают и сканируют миллионы книг для расширения обучающих выборок.
Отдельный блок иска The New York Times посвящен влиянию генеративного ИИ на бизнес-модель новостных изданий. Использование поисковыми системами ИИ-генераций, которые кратко излагают суть статей, лишает пользователей мотивации переходить на сайты первоисточников. В представленных суду документах один из руководителей OpenAI, участвовавший в разработке ChatGPT, согласился с тем, что издатели действительно сталкиваются с экзистенциальной угрозой из-за технологий искусственного интеллекта.








