Спустя менее двух недель после того, как компания Google опубликовала подробную карту головного мозга и центральной нервной системы взрослой плодовой мушки, энтузиасты начали активно применять эту структуру для самых разных задач. Ранее нейросетевую модель уже пытались использовать для внутридневной биржевой торговли и обучения параллельной парковке. Теперь один из поклонников карточного рогалика Balatro заявил, что обучил эту модель алгоритму игры, достигнув 20-процентного показателя побед.
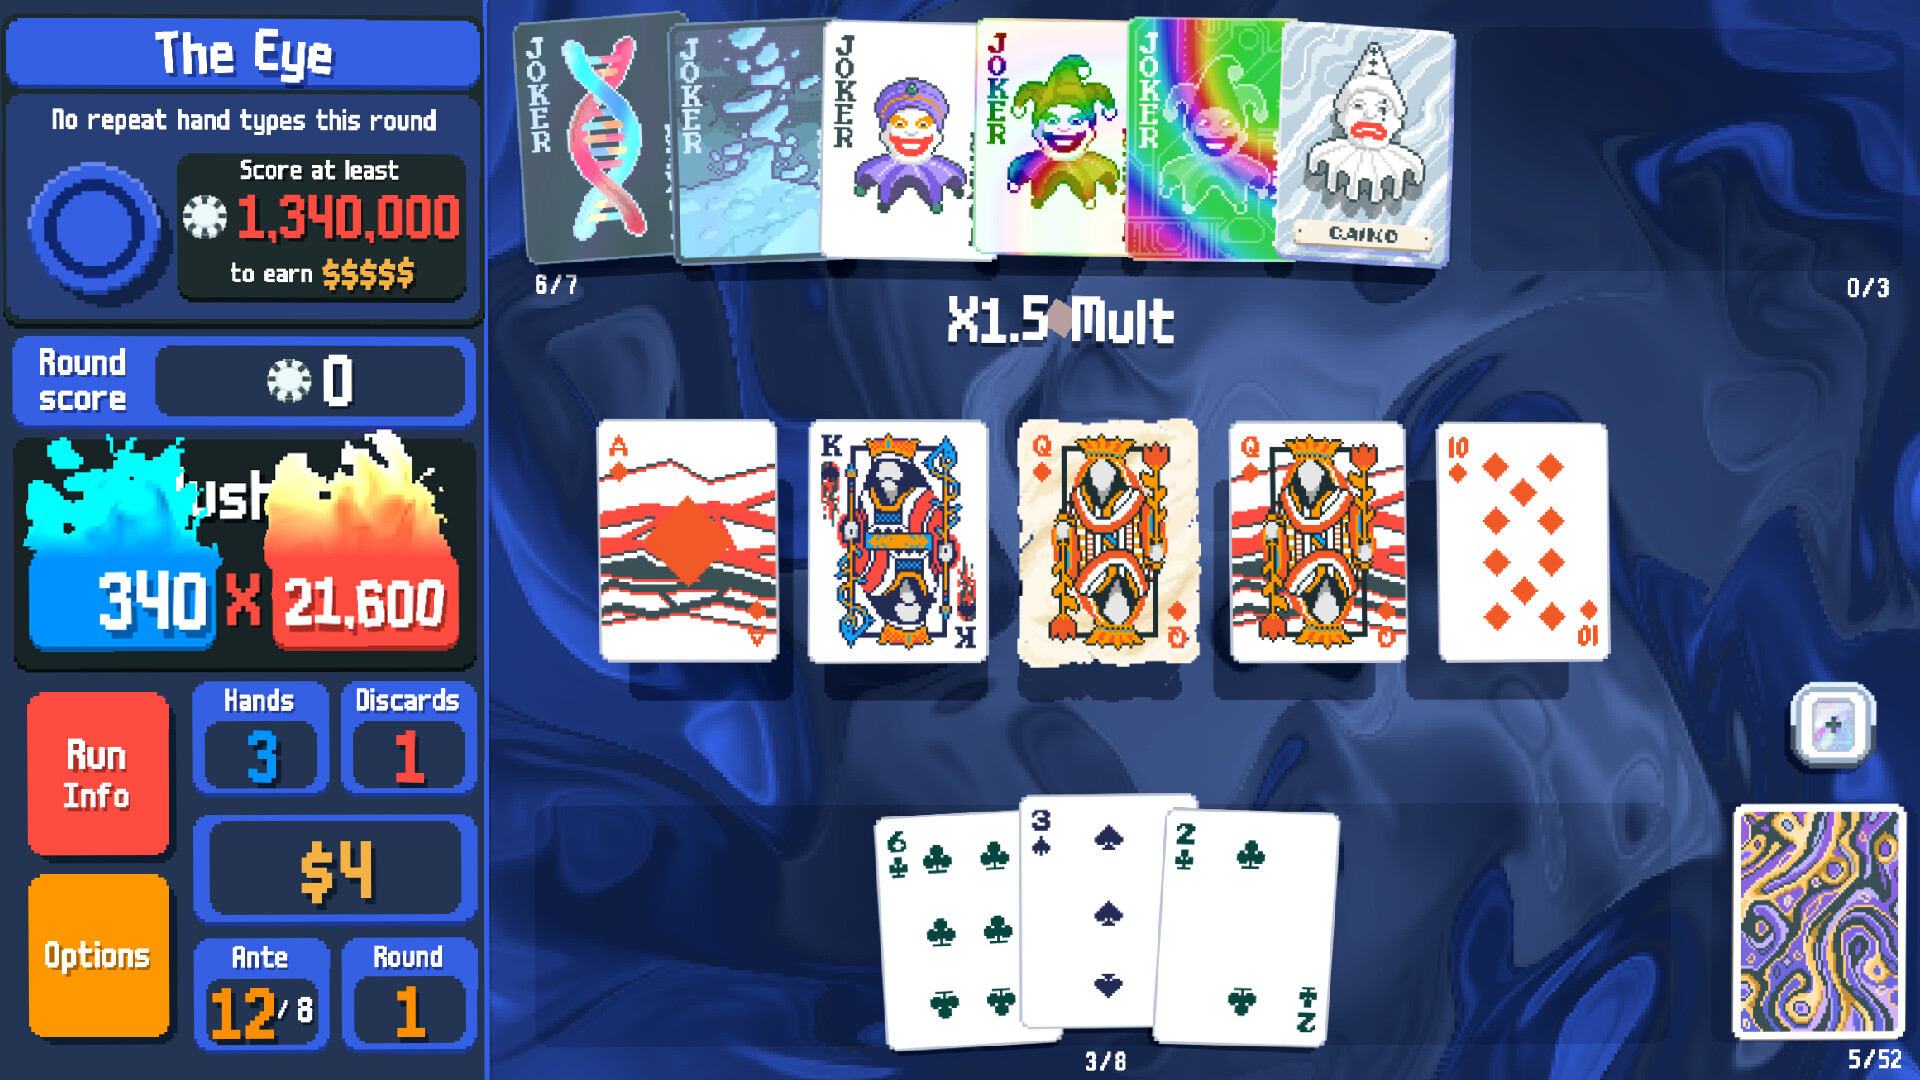
Особенности обучения модели на основе данных Google
Пользователь Reddit под ником ActualAerie1011 опубликовал видео, на котором запечатлен процесс игры, ускоренный для наглядности. Согласно ролику, нейросеть тестировалась на начальном уровне сложности (White Stake) с использованием стандартной колоды Red Deck. В ходе тренировки применялся специальный алгоритм, который автор проекта разработал для поиска полезных игровых сидов. Поскольку в Balatro используется процедурная генерация, подобные алгоритмы помогают находить уникальные комбинации, потенциально ведущие к высоким результатам.
Процесс обучения строится на методе подкрепления: модель и тренировочный алгоритм разыгрывают один и тот же сид, после чего результаты сравниваются. На основе этих данных система получает «поощрение» или «наказание» за принятые решения. В настоящий момент модель способна побеждать в 20% случаев на случайных сидах. Автор утверждает, что ИИ не обладает информацией о сиде за пределами того, что отображается на экране. Разработчик продолжает процесс тренировки, пообещав, что в будущем «плодовая мушка вернется, став сильнее и умнее».
Технические вызовы при автоматизации Balatro
Хотя проект вызвал интерес, некоторые пользователи сети выразили скепсис. Автор не предоставил подробностей реализации, ссылок на репозитории или перечня использованных open-source инструментов. На текущий момент достижения ActualAerie1011 заметно уступают результатам других разработок: ранее модель OpenAI GPT-6 «Astra» уже успешно проходила Balatro на максимальной сложности Gold Stake с колодой Black Deck.
Обучение ИИ для игры в Balatro сопряжено с серьезными трудностями, несмотря на кажущуюся простоту правил. Хотя понимание механик покерных комбинаций и подсчета очков не является критической проблемой, сложность заключается во взаимодействии карт-джокеров, порядке их активации, способностях боссов и специфических временных или постоянных эффектах. Эти факторы создают высокую планку стабильности, которую сложно преодолеть даже человеку. Впрочем, подобные эксперименты не являются для игрового сообщества чем-то новым: проекты вроде BalatroBot и BalatroLLM доступны уже около года, и редакция ожидает дополнительных комментариев от создателя нынешнего «интеллекта плодовой мушки» для прояснения деталей архитектуры проекта.
Трудности автоматизации и контекст разработки
Несмотря на достигнутый результат, стоит учитывать, что текущие успехи нейросети, основанной на коннектоме плодовой мушки, пока ограничены базовыми настройками игры. Важно понимать, что для тренировки такого «мозга» требуется одновременная работа самого аппарата (коннектома в связке с моделью) и управляющего алгоритма. Подобный тандем делает проект ActualAerie1011 первым в своем роде, использующим именно биологическую структуру мозга мухи для решения игровых задач такого типа.
Критически настроенные пользователи отмечают отсутствие технической прозрачности: автор проекта до сих пор не опубликовал открытый репозиторий или ссылки на сторонние инструменты, которые могли быть использованы в процессе обучения. В экспертном сообществе подчеркивают, что без доступа к коду сложно оценить реальный вклад нейроструктуры мушки в принятие решений по сравнению с классическими алгоритмами поиска сидов.
Сложность Balatro для ИИ обусловлена не только покером, но и глубокой вариативностью игровых систем:
- Математика джокеров: бесконечное множество комбинаций карт-джокеров, влияющих на множители очков, требует от модели сложного стратегического планирования на много ходов вперед.
- Динамические ограничения: способности боссов могут накладывать штрафы на использование определенных мастей или рук, что требует гибкой адаптации стратегии в реальном времени.
- Временные эффекты: необходимость учитывать кратковременные бонусы против постоянных перков делает процесс обучения ИИ крайне трудоемким процессом с высоким порогом вхождения.
В отличие от более ранних проектов, таких как BalatroBot или BalatroLLM, которые развивались на протяжении последнего года, эксперимент с «мозгом мухи» — это попытка интегрировать принципиально иную архитектуру в устоявшуюся нишу игрового ИИ. Редакция Hardio продолжает следить за развитием событий и ожидает ответа от разработчика, чтобы прояснить, как именно удалось адаптировать биологическую модель под столь специфические игровые условия.