Многие пользователи сталкиваются с ограничениями при попытке запуска современных локальных моделей искусственного интеллекта на домашнем оборудовании. Старый игровой ПК, оснащенный процессором Ryzen 5 3600, 32 ГБ оперативной памяти стандарта DDR4 и видеокартой RTX 2070 Super, долгое время справлялся лишь с базовыми задачами. Однако переход на RTX 4070 Ti Super кардинально изменил ситуацию, превратив этот компьютер в полноценную рабочую станцию для локального ИИ-инференса.
Ограничения 8 ГБ видеопамяти в локальных нейросетях
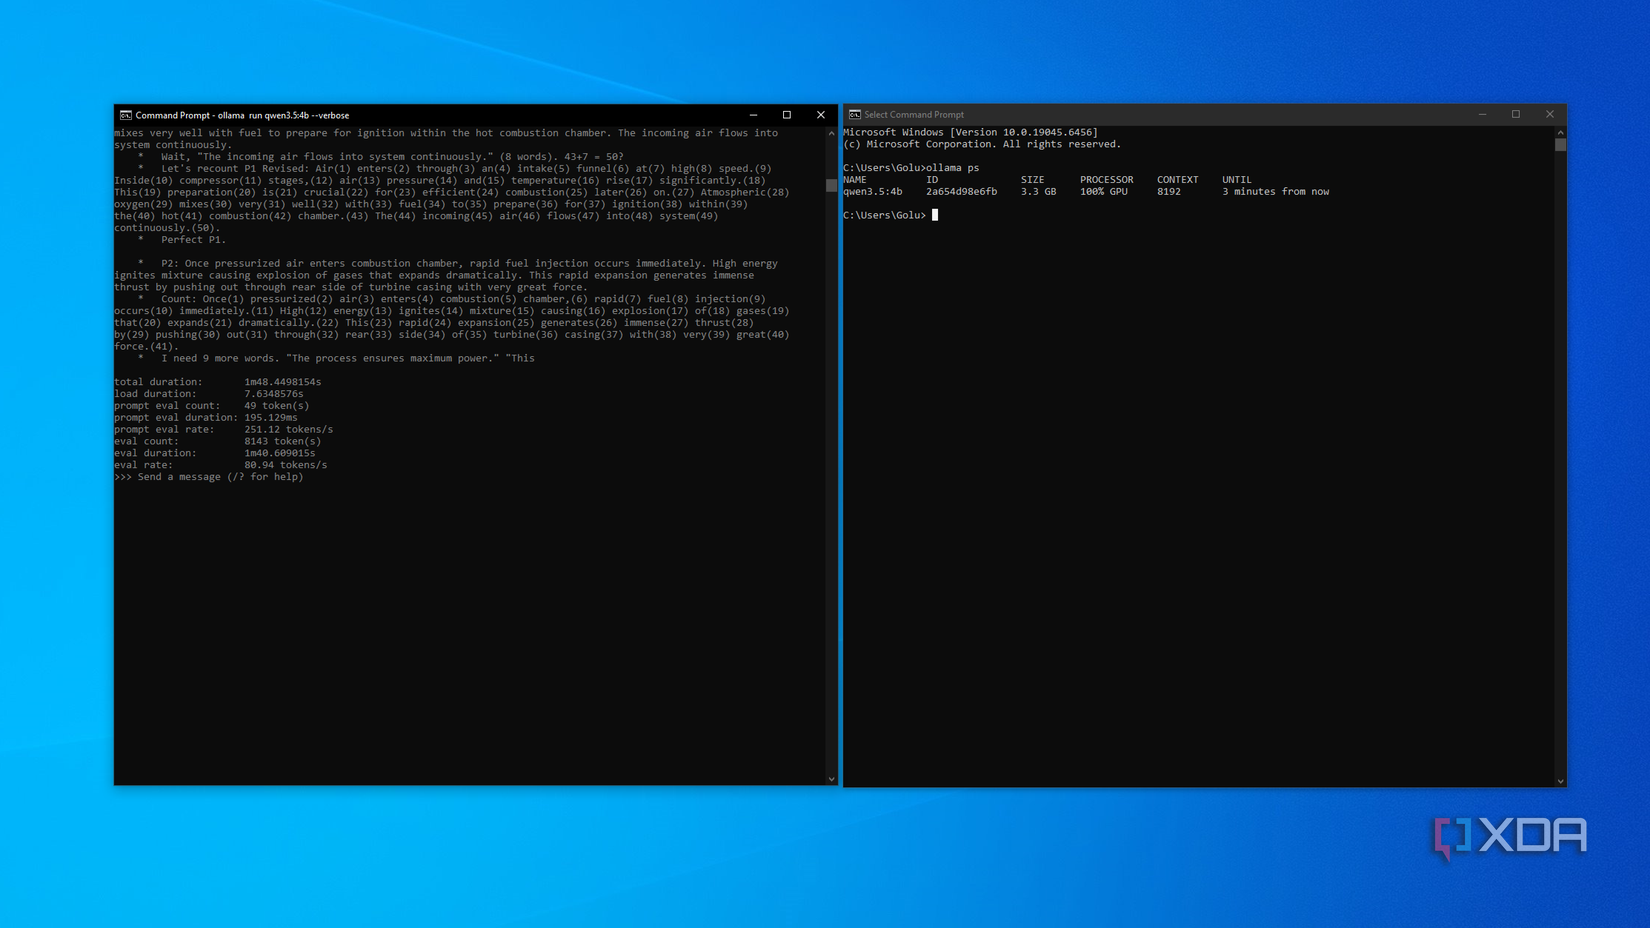
До проведения апгрейда видеокарта с 8 ГБ памяти стандарта GDDR6 была главным сдерживающим фактором. На ней удавалось запускать лишь компактные модели. Например, Qwen 3.5 4B при квантовании Q4_K_M занимала около 3,3 ГБ видеопамяти и генерировала до 80,94 токена в секунду при контексте 8K. Модель Gemma 4 E4B при аналогичных настройках показывала 80,60 токена в секунду, занимая 3,2 ГБ.
Проблемы возникали при переходе на более крупные модели. Gemma 4 12B в квантовании Q4_K_M требует от 7,1 до 7,5 ГБ весов до учета кэша KV и буфера вычислений. В результате модель выходила за пределы видеопамяти и начинала использовать системную оперативную память, из-за чего скорость обработки запросов падала до неприемлемых значений. О запуске более тяжелых нейросетей, таких как Ministral 3 14B или GPT-OSS-20B, на прежнем железе не могло быть и речи. При этом центральный процессор оставался не при делах: производительность упиралась именно в дефицит VRAM.
Преимущества перехода на 16 ГБ видеопамяти
Установка RTX 4070 Ti Super с 16 ГБ памяти GDDR6X и пропускной способностью 672 ГБ/с позволила запускать модели, которые ранее требовали выгрузки данных в RAM. Теперь тяжелые веса полностью помещаются в видеопамяти, что значительно ускоряет работу. Для запуска нейросетей часто используется инструмент Ollama, тогда как llama.cpp остается оптимальным выбором для оценки предельных возможностей моделей.
Производительность в современных задачах
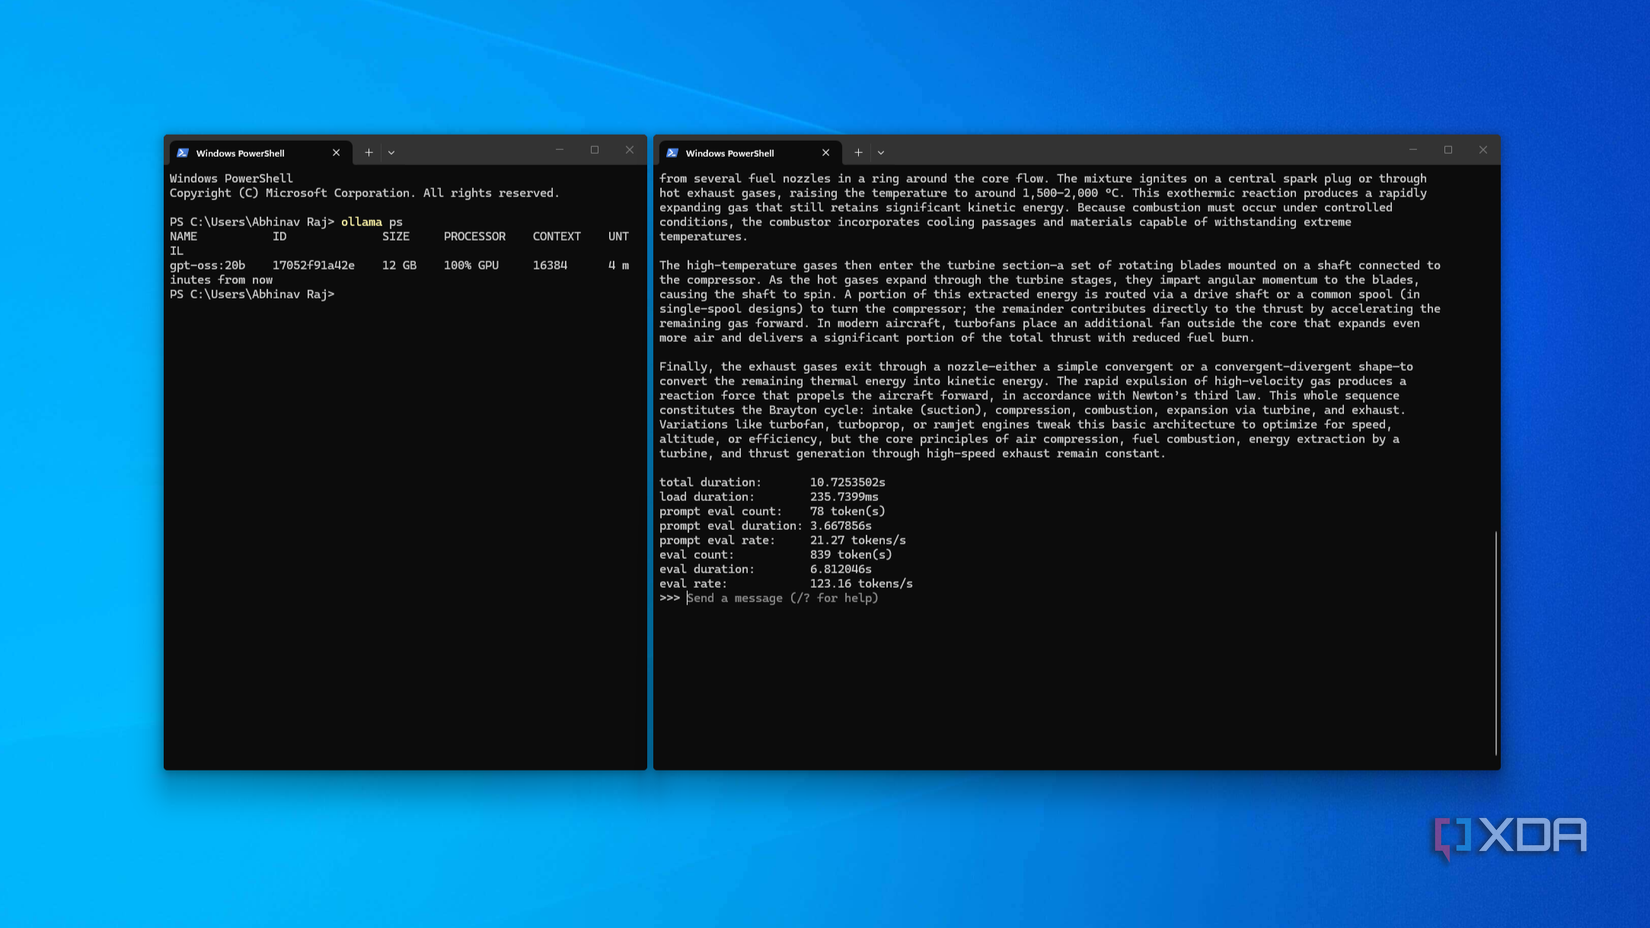
Модель GPT-OSS-20B в формате MXFP4 занимает около 12 ГБ памяти и выдает 123 токена в секунду при контексте 16K. Модель Gemma 4 12B с квантованием Q4_K_M требует 7,66 ГБ (8,4 ГБ с кэшем при контексте 32K), оставляя достаточно места для обработки мультимодальных данных — изображений и аудио. В таком режиме скорость генерации составляет около 63 токенов в секунду, что является комфортным показателем для повседневных задач.
Влияние объема памяти на качество работы ИИ
Увеличение VRAM позволило изменить сам подход к использованию локальных нейросетей. Благодаря расширенному контекстному окну пользователь может загружать в модель документы объемом до 40–50 страниц, не опасаясь галлюцинаций или потери нити повествования. Также улучшилось качество написания программного кода: задачи, требующие нескольких итераций на модели Qwen 3.5 4B, теперь решаются с первой или второй попытки при использовании GPT-OSS-20B.
Более того, модели меньшего размера, например Gemma 4 E4B, получили возможность использовать весь контекст 128K без необходимости тщательного контроля за состоянием кэша. Хотя на рынке уже появляются модели вроде Qwen 3.8 27B или Devstral Small 2, требующие 24 ГБ VRAM и более, для многих сценариев 16 ГБ памяти достаточно, чтобы сделать из возрастного ПК эффективный инструмент для работы с искусственным интеллектом.
Особенности аппаратной конфигурации и роль процессора
Важно отметить, что в процессе апгрейда видеокарта стала единственным измененным компонентом системы. Несмотря на почтенный возраст сборки, пользователь принципиально отказался от замены процессора, материнской платы или перехода на оперативную память DDR5 (особенно учитывая текущую нестабильность на рынке DRAM). Как показала практика, Ryzen 5 3600 в данных задачах остается практически незадействованным — его роль сводится лишь к передаче запроса на GPU. После того как веса модели и кэш оказываются загруженными в видеопамять, остальная платформа практически перестает влиять на итоговую скорость генерации, что подтверждает отсутствие необходимости в тотальном обновлении ПК для нужд локального ИИ.
Особенности работы с моделями и инструментами
Выбор инструментов для запуска моделей также играет свою роль в повседневной эксплуатации. Автор предпочитает использовать Ollama из-за удобства, однако подчеркивает, что для точного измерения «потолка» возможностей нейросети в качестве среды исполнения все еще остается эталонным llama.cpp. При этом переход на 16 ГБ видеопамяти позволил избавиться от утомительных математических расчетов перед загрузкой каждой новой модели — теперь практически любой интересующий алгоритм гарантированно помещается в доступный объем VRAM с запасом для настройки контекста под конкретную задачу.
Качественные изменения в сложных задачах
Помимо очевидного прироста скорости, объем видеопамяти фундаментально изменил сценарии использования ПК. В отличие от 4-миллиардных моделей, которые часто требовали «подсказок» и перепроверки результатов, более крупные нейросети позволяют делегировать компьютеру задачи, ранее доступные только облачным сервисам. Возможность скармливать модели документацию объемом в 40–50 страниц напрямую в контекст позволяет избавиться от галлюцинаций, которые неизбежно возникали при попытке анализа крупных массивов данных на младших моделях. Это превратило локальный ИИ из «игрушки» для простых вопросов в реальный инструмент для глубокой работы с текстами и кодом.
Более того, запас по памяти позволяет гибко комбинировать инструменты: пока одна модель, например, Gemma 4 E4B, удерживает всю 128К-контекстную нить диалога на протяжении целого вечера, у пользователя остается возможность при необходимости оперативно дозагрузить более мощные модели для решения специфических подзадач. Таким образом, хотя 16 ГБ VRAM уже не являются пределом в мире «флагманских» моделей, требующих 24 ГБ и более (как в случае с новинками уровня Qwen 3.8 27B или Devstral Small 2), для комфортной и эффективной работы с подавляющим большинством актуальных задач этого объема оказывается вполне достаточно.