При запуске локальных моделей машинного обучения через Ollama или аналогичные инструменты на базе llama.cpp пользователи часто сталкиваются с нехваткой оперативной памяти. Проблема заключается в том, что система резервирует объем памяти для контекстного окна (KV-кэша) исходя из максимально допустимых значений, а не из реальных потребностей текущего диалога. В результате значительная часть ресурсов, измеряемая гигабайтами, простаивает без дела.
Почему Ollama резервирует лишнюю память
Длина контекста — это предельная емкость, в которую входят системные инструкции, история переписки, входящий запрос и ответ нейросети. Даже если вы настроили модель на поддержку 32 тысяч токенов, а в обычном общении используете всего три тысячи, Ollama при загрузке подготовит систему к работе с максимальным лимитом. Большая часть этого объема отводится под KV-кэш, который хранит вычисления по уже обработанным токенам, чтобы не пересчитывать их при каждом новом сообщении.
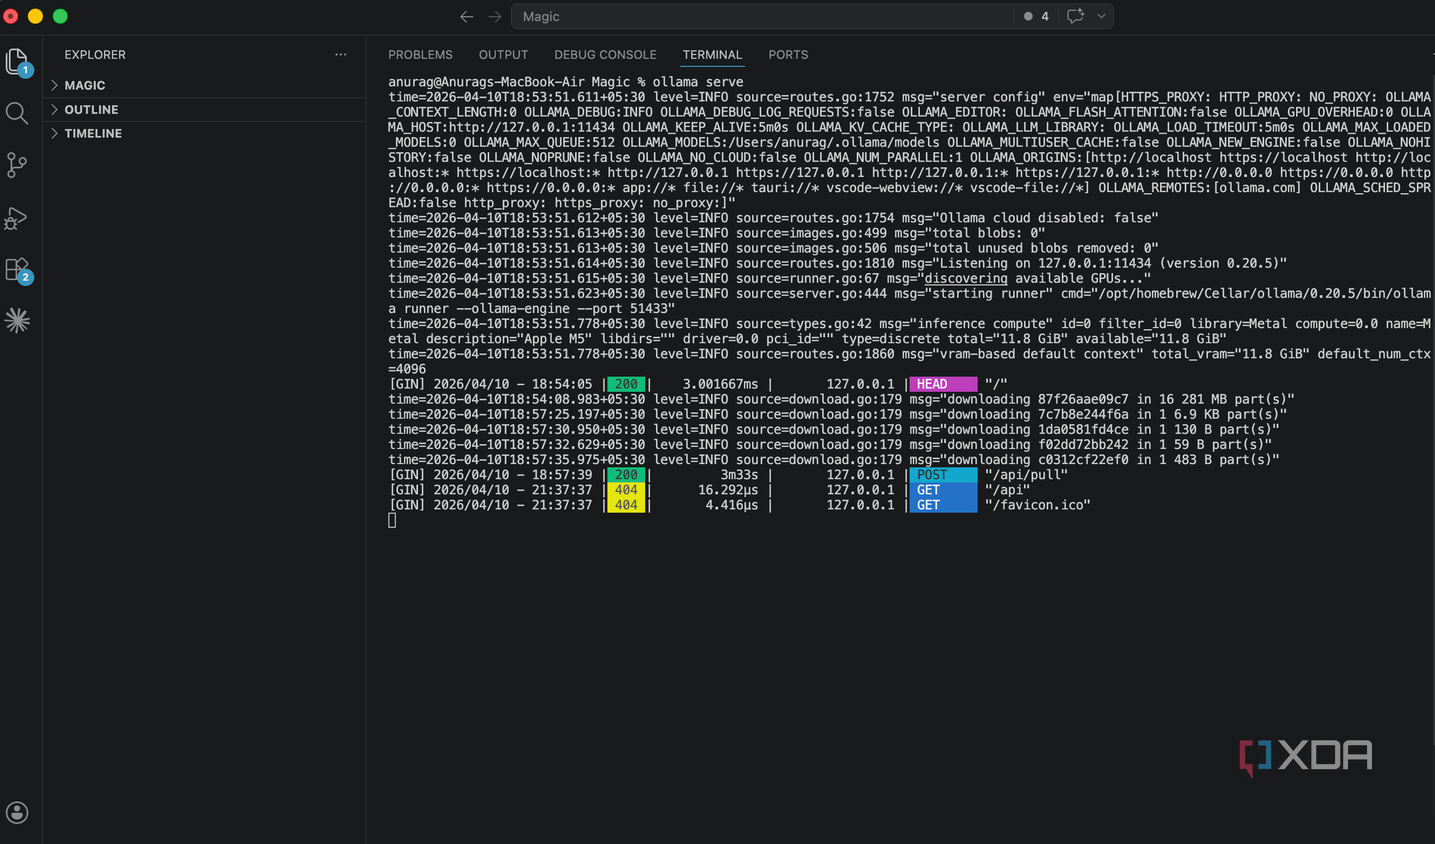
Эта особенность критична для систем с ограниченным объемом памяти, включая Apple Silicon, где память общая для системы и GPU. В конфигурациях с дискретными видеокартами резервирование памяти под контекст часто занимает видеопамять (VRAM), вытесняя части модели в более медленные области. Примечательно, что стандартные настройки Ollama зависят от объема VRAM: 4K токенов для систем с объемом менее 24 ГБ, 32K для диапазона от 24 до 48 ГБ и 256K для систем мощнее 48 ГБ.
Оптимизация размера контекстного окна
Чтобы освободить ресурсы, необходимо привести настройки контекста в соответствие с реальными задачами. API Ollama позволяет отслеживать количество токенов в запросах (prompt_eval_count) и ответах (eval_count). Анализ этих данных за несколько сессий поможет подобрать более точное значение, чем стандартные максимумы модели. Для большинства стандартных задач можно попробовать установить лимит в 8 тысяч токенов — этого обычно достаточно для длинных диалогов и уточняющих вопросов.
Изменить параметры контекста можно несколькими способами:
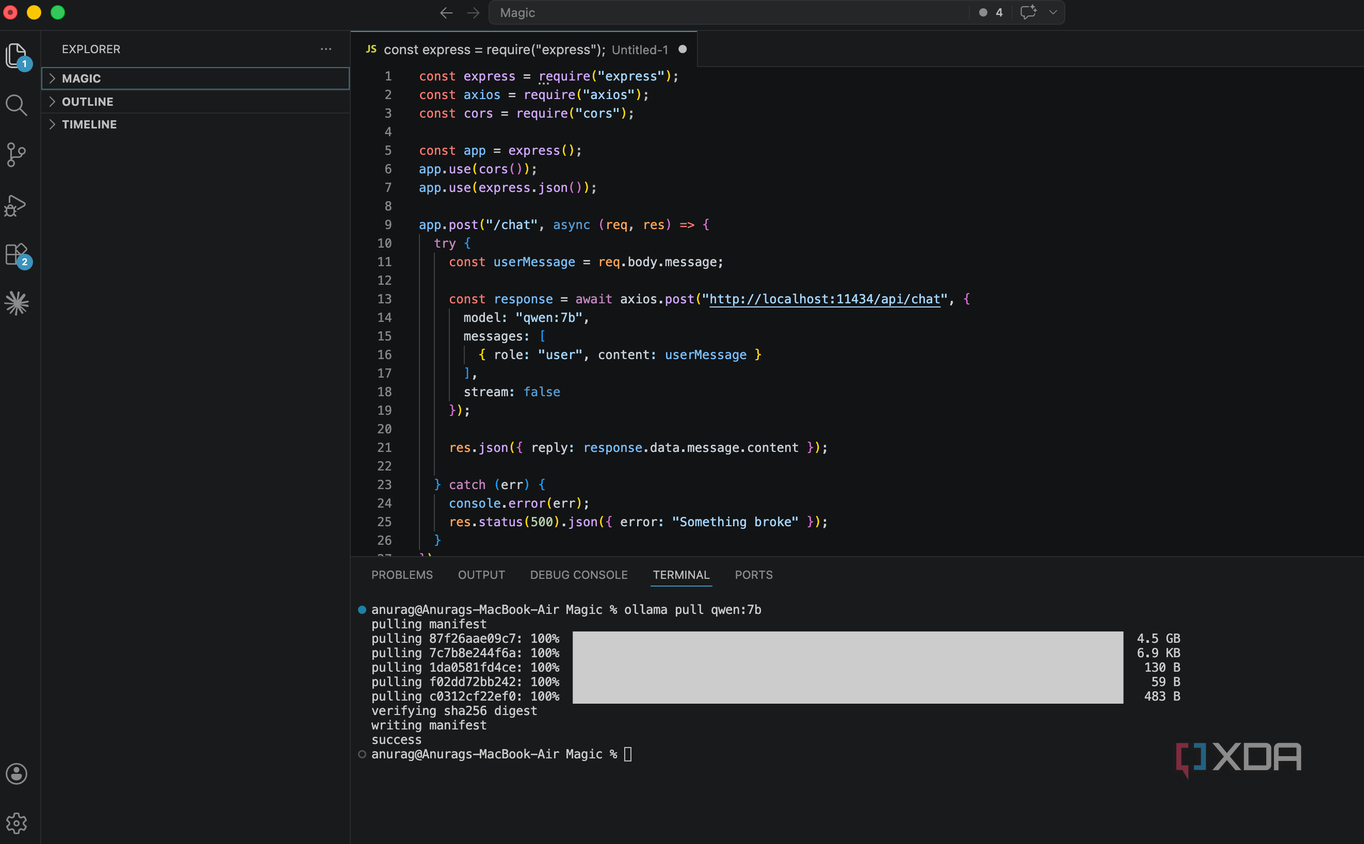
- Использовать слайдер в интерфейсе приложения.
- Ввести команду /set parameter num_ctx 8192 в терминальной сессии.
- Добавить строку PARAMETER num_ctx 8192 в Modelfile для постоянной настройки конкретной модели.
Важно помнить, что модели с функциями рассуждения (reasoning models) требуют дополнительного бюджета памяти, так как они генерируют скрытые «токены размышления» перед выдачей итогового ответа.
Квантование кэша и управление параллельными запросами
Помимо настройки окна контекста, можно уменьшить объем занимаемой памяти с помощью квантования кэша (cache quantization). Опция Q8 (8-битное представление) снижает затраты на хранение кэша примерно вдвое при незначительном влиянии на качество ответов. Более агрессивный режим Q4 сокращает размер кэша до одной четверти, однако в длинных диалогах это может привести к снижению точности, поэтому рекомендуется предварительно протестировать результаты на знакомых вопросах.
Также стоит проверить количество параллельных запросов, которые Ollama может обрабатывать одновременно. По умолчанию установлено значение один, но если вы ранее увеличивали его для работы в многопользовательском режиме или для различных приложений, это может создавать необоснованную нагрузку на оперативную память. Если использование локального сервера ограничено личными задачами, возврат к одному параллельному потоку поможет оптимизировать потребление ресурсов.
Если настройки Ollama не дают желаемого результата, существуют альтернативные варианты запуска моделей, такие как LM Studio, Docker Model Runner или BaseRT, которые также обеспечивают эффективную работу с локальными LLM.
Технические аспекты распределения памяти: почему размер модели — это еще не всё
Важно понимать фундаментальное различие между весом модели и нагрузкой на систему при её выполнении. Загруженный файл модели (например, 5-гигабайтная Q4-версия) отражает лишь объем квантованных весов. Однако Ollama для работы необходимы также вычислительные буферы и, что самое важное, KV-кэш. Следовательно, даже если вы оптимизируете размер весов модели, вы все равно можете терять гигабайты ОЗУ из-за избыточных настроек контекста.
На системах с архитектурой Apple Silicon это особенно ощутимо, так как зарезервированная под кэш память изымается из единого пула, который делят между собой macOS и все запущенные приложения. На компьютерах с дискретными графическими адаптерами ситуация схожа: если VRAM переполняется из-за раздутого KV-кэша, система вынуждена «сбрасывать» части модели в более медленную оперативную память, что неизбежно ведет к замедлению генерации текста, даже если вы используете мощную видеокарту.
Практический подход к определению реального контекста
При выборе оптимального окна контекста не стоит ориентироваться только на «рекламные» характеристики модели. Вместо этого проанализируйте свои типичные диалоги. Убедитесь, что в выборку для анализа попадают ваши самые длинные переписки, чтобы не допустить ошибки «выжившего», когда вы настраиваете систему под короткие запросы, а при возникновении сложной задачи модель внезапно упирается в лимит.
При тестировании уменьшенного окна контекста (например, тех же 8К) обязательно проведите проверку с использованием информации из предыдущих сообщений диалога. Если включена функция автоматической обрезки (truncation), Ollama будет удалять старые сообщения, чтобы уложиться в лимит. Важно следить за тем, чтобы при этом система сохраняла системные промпты и самое последнее сообщение, иначе модель может потерять «нити» разговора или базовые инструкции по поведению.
Тонкая настройка: квантование кэша и параллельные задачи
Квантование кэша — это эффективный метод экономии, позволяющий сохранить прежний лимит токенов при меньшем потреблении ресурсов. Хотя экономия здесь касается исключительно кэша, а не всей модели целиком, это отличный способ высвободить несколько гигабайт. При выборе между уровнями точности стоит руководствоваться следующей логикой:
- Q8 (8-бит): Оптимальный выбор для большинства пользователей. Снижает потребление памяти кэшем примерно в два раза. Эффект на итоговое качество генерации практически незаметен, поэтому его можно смело использовать в качестве настройки по умолчанию.
- Q4 (4-бит): Обеспечивает снижение объема кэша до одной четверти от исходного. Однако из-за потери точности вычислений это может привести к деградации ответов, особенно в глубоких и длинных логических цепочках. Перед внедрением этой настройки рекомендуется провести A/B-тестирование на наборе контрольных вопросов, чтобы убедиться в отсутствии критических ошибок.
Отдельного внимания заслуживает конфигурация параллельных запросов. Если вы используете Ollama исключительно для персональных целей — отправляя один вопрос и дожидаясь ответа, — нет никаких оснований резервировать ресурсы для нескольких одновременных генераций. Каждый дополнительный слот параллельной обработки — это умножение нагрузки на KV-кэш. Если вы ранее меняли эти настройки, например, для интеграции с внешними API или локальными серверами, обслуживающими несколько приложений одновременно, стоит пересмотреть их и вернуть к значению «1», если потребность в многопоточности отпала. Это освободит значительный объем памяти для работы самой нейросети и операционной системы.