Многие пользователи привыкли устранять неполадки через создание скриншотов с текстом ошибки и их последующую отправку в чат-боты. Этот метод имеет существенные недостатки: риск утечки конфиденциальных данных (паролей, токенов, внутренних IP-адресов), медлительность процесса и неполноту контекста, так как длинные сообщения об ошибках часто обрезаются. Чтобы решить эту проблему, была создана локальная система анализа вывода терминала.
Интеграция локальной модели с терминалом
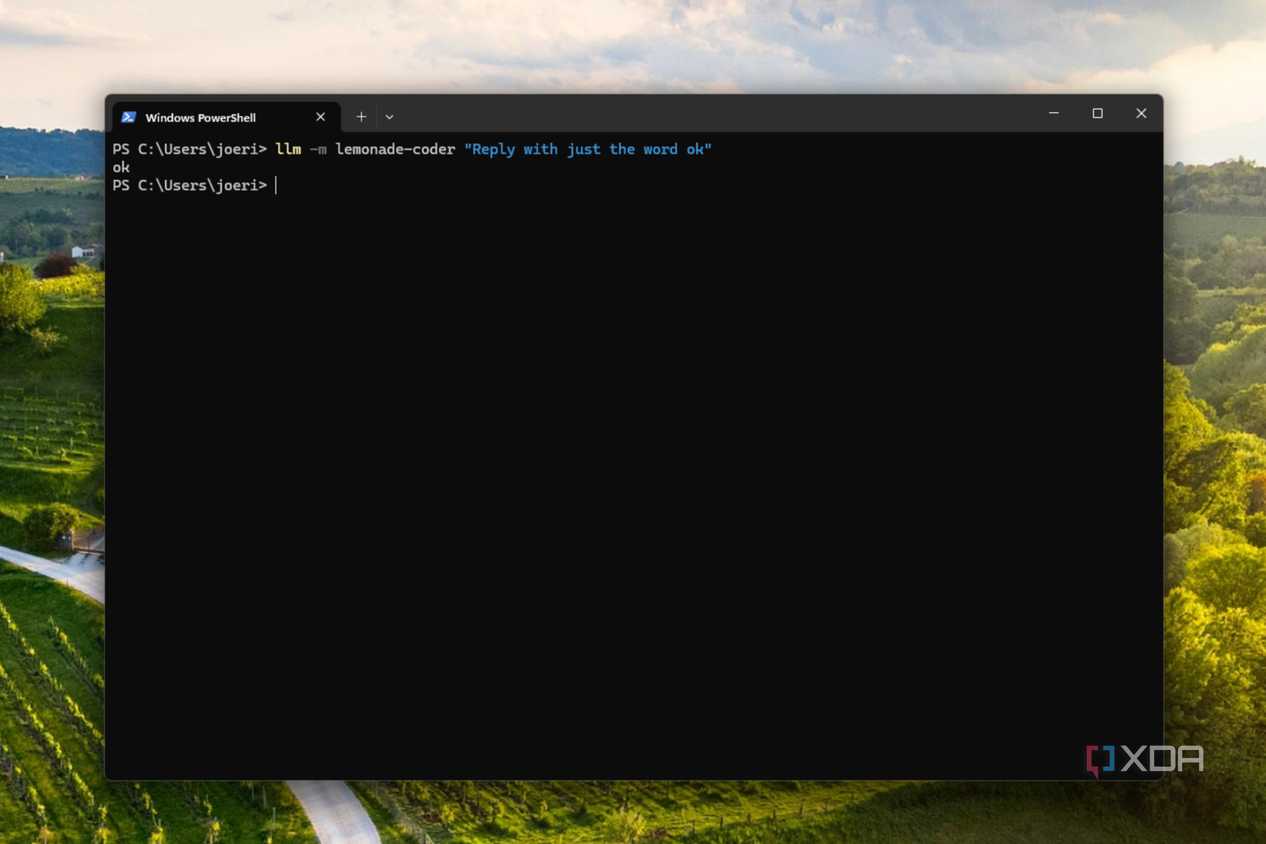
Основой решения стал инструмент командной строки llm от Саймона Уиллисона, который поддерживает работу с любыми моделями и OpenAI-совместимыми API. В качестве вычислительной базы используется сервер Lemonade, развернутый в контейнере Proxmox LXC. Он отдает API на порту 13305, что позволяет локально запустить модель Qwen3-Coder-30B-A3B-Instruct с квантованием Q4_K_M через бэкенд Vulkan на llama.cpp. Такая связка обеспечивает низкую задержку и работу с контекстом до 32К токенов.
Для настройки интеграции требуются два файла конфигурации в папке llm. Файл extra-openai-models.yaml указывает параметры подключения к локальному серверу, а второй файл — шаблон explain — содержит системный промпт. В нем заданы строгие правила: модель должна кратко описать причину ошибки, привести цитату из вывода и предложить решение не более чем в 120 словах, исключая любые деструктивные команды.
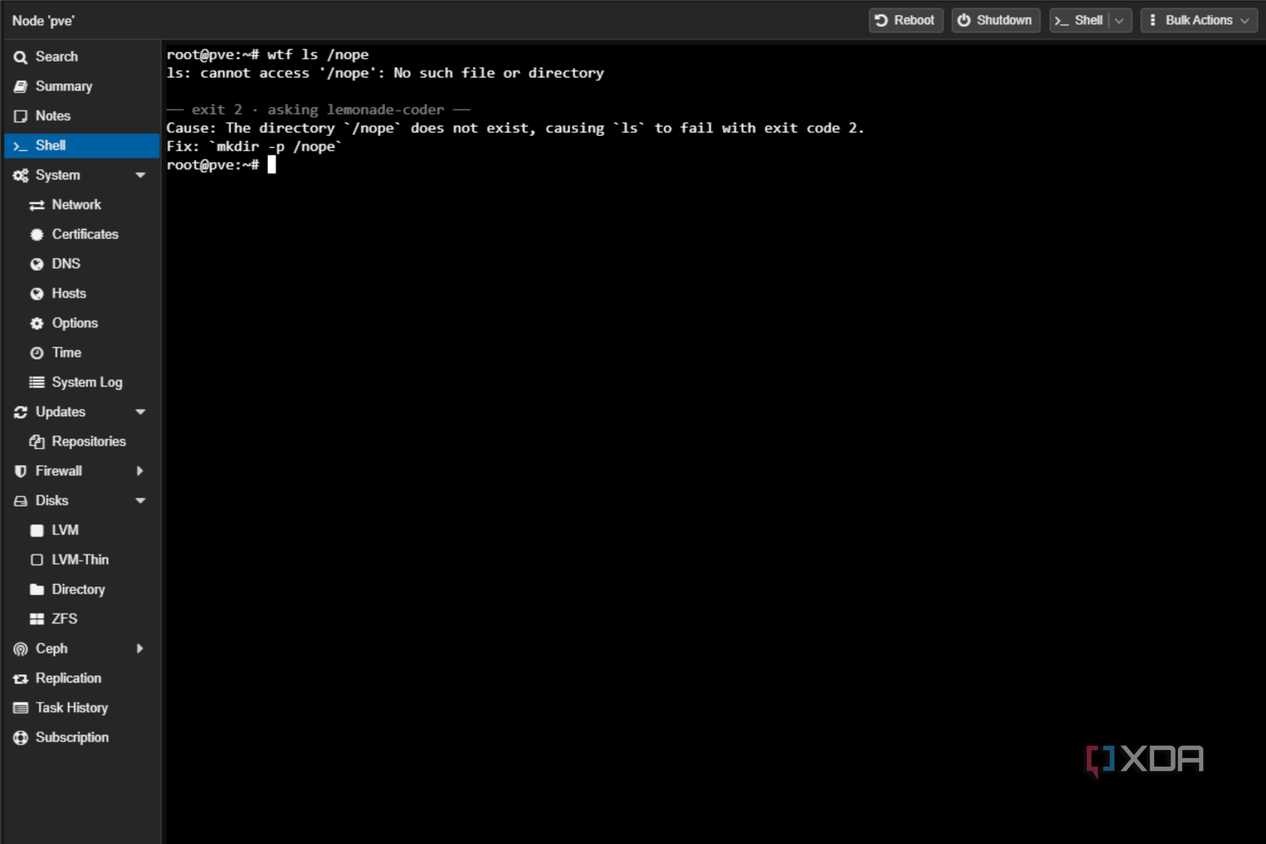
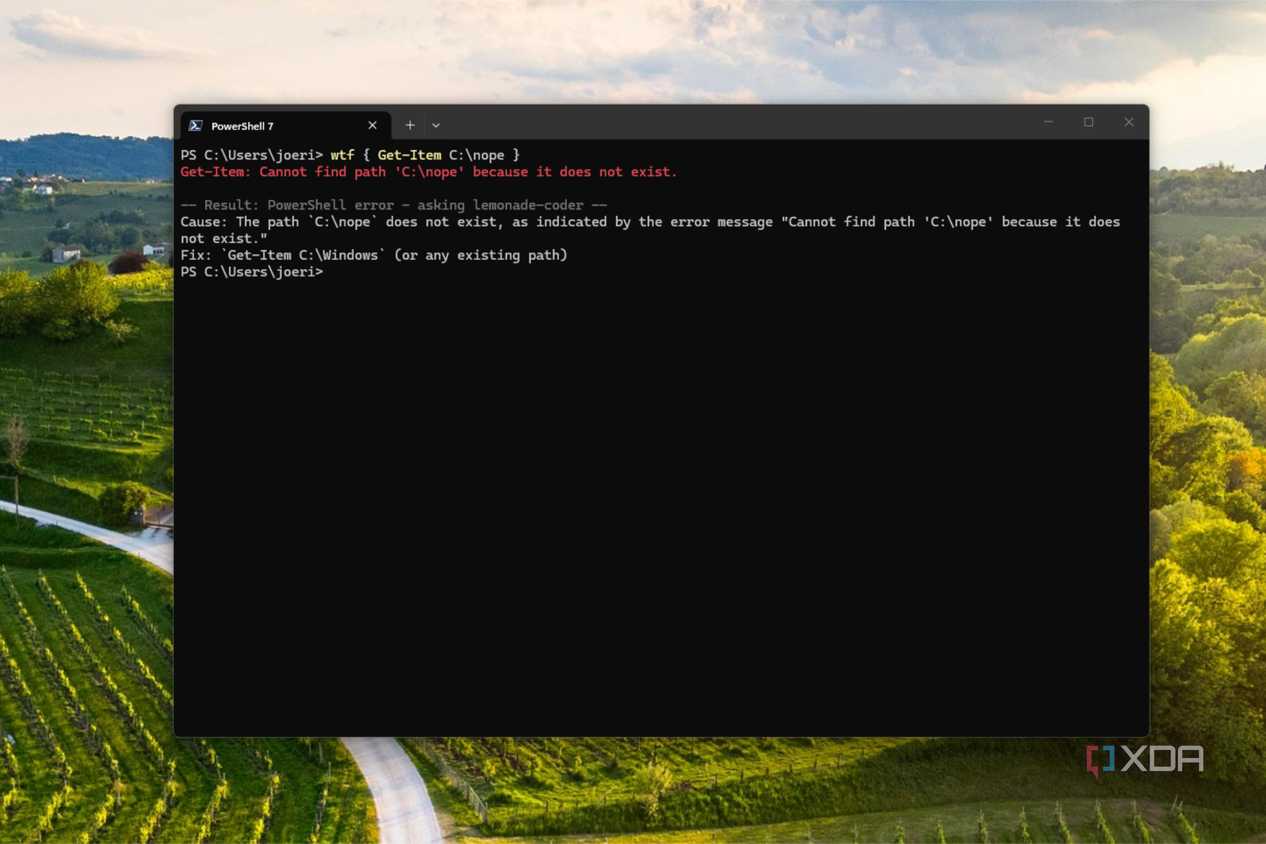
Функция «wtf» для анализа ошибок
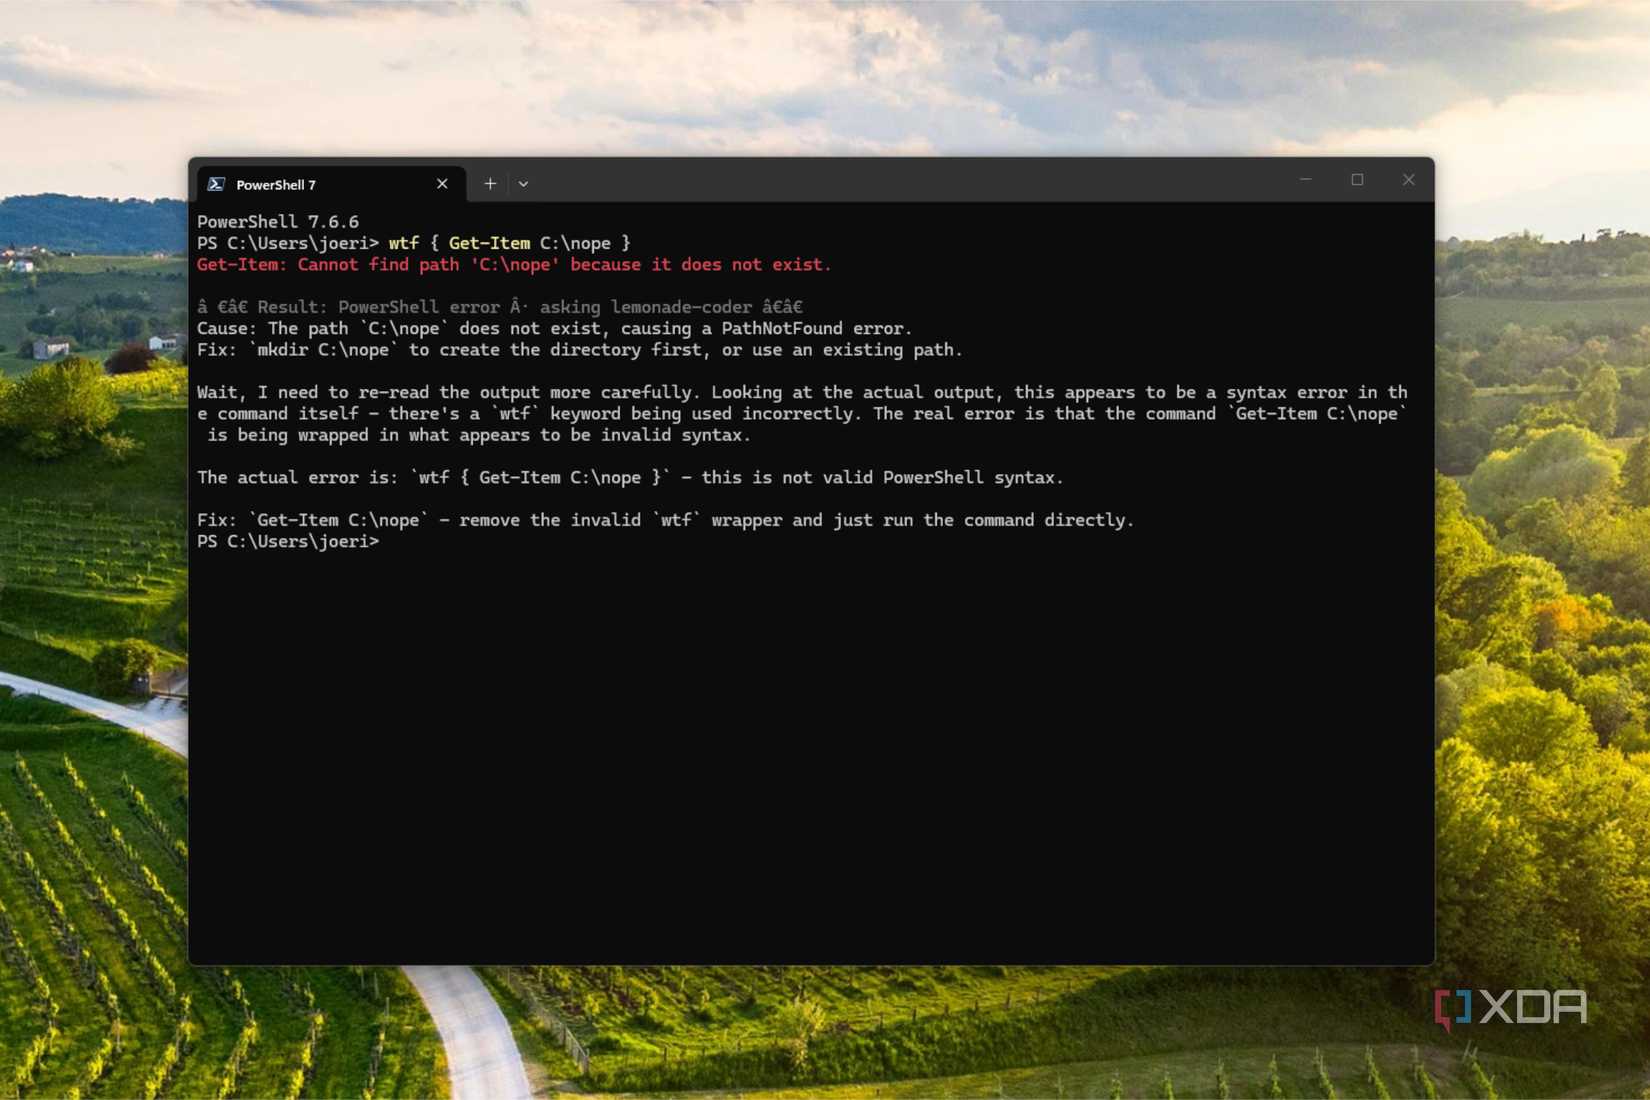
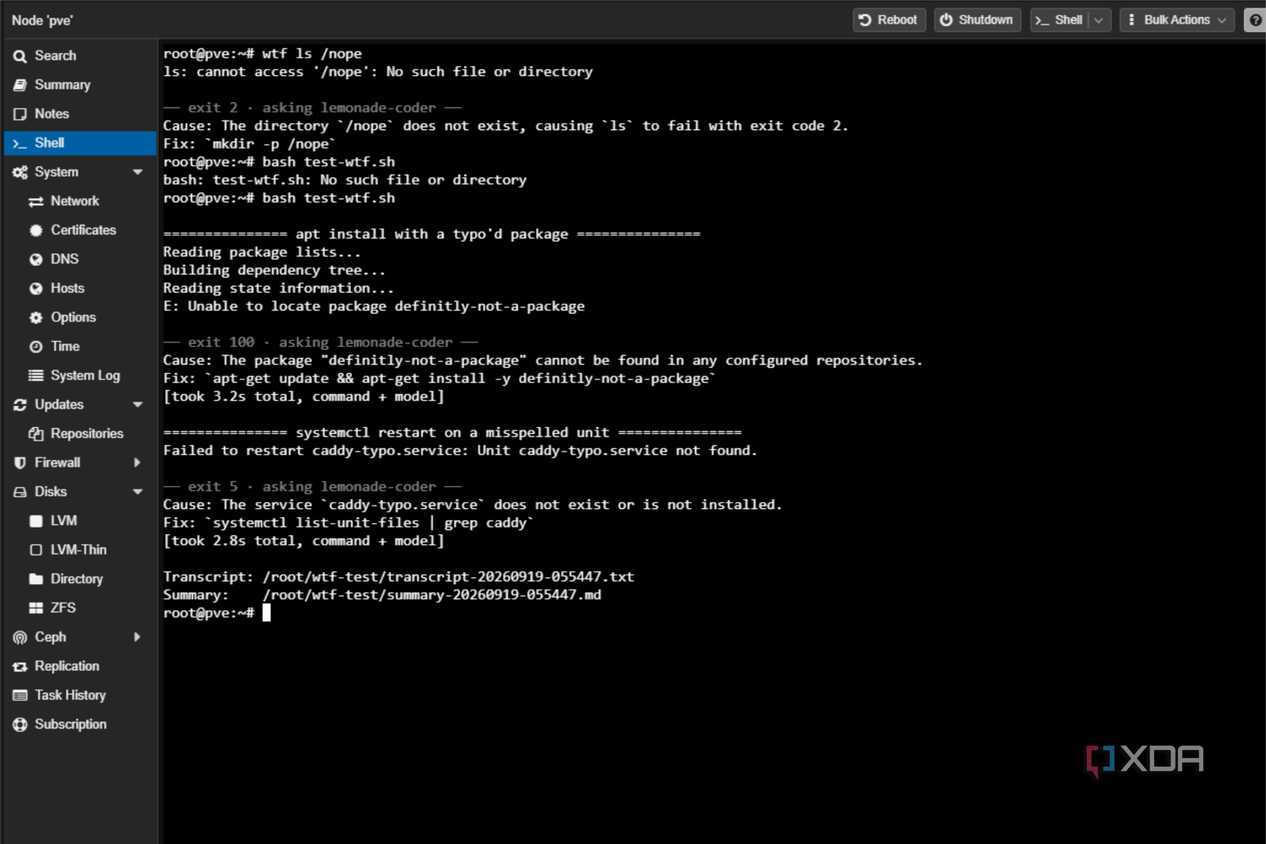
Для автоматизации процесса была написана функция wtf, которая перехватывает вывод команд. Если команда выполняется успешно, ничего не происходит. В случае ошибки wtf захватывает последние 150 строк вывода, добавляет данные об операционной системе, оболочке, текущей рабочей директории и коде завершения, после чего маскирует потенциально секретные данные (токены, учетные данные, JWT-ключи) и передает информацию модели.
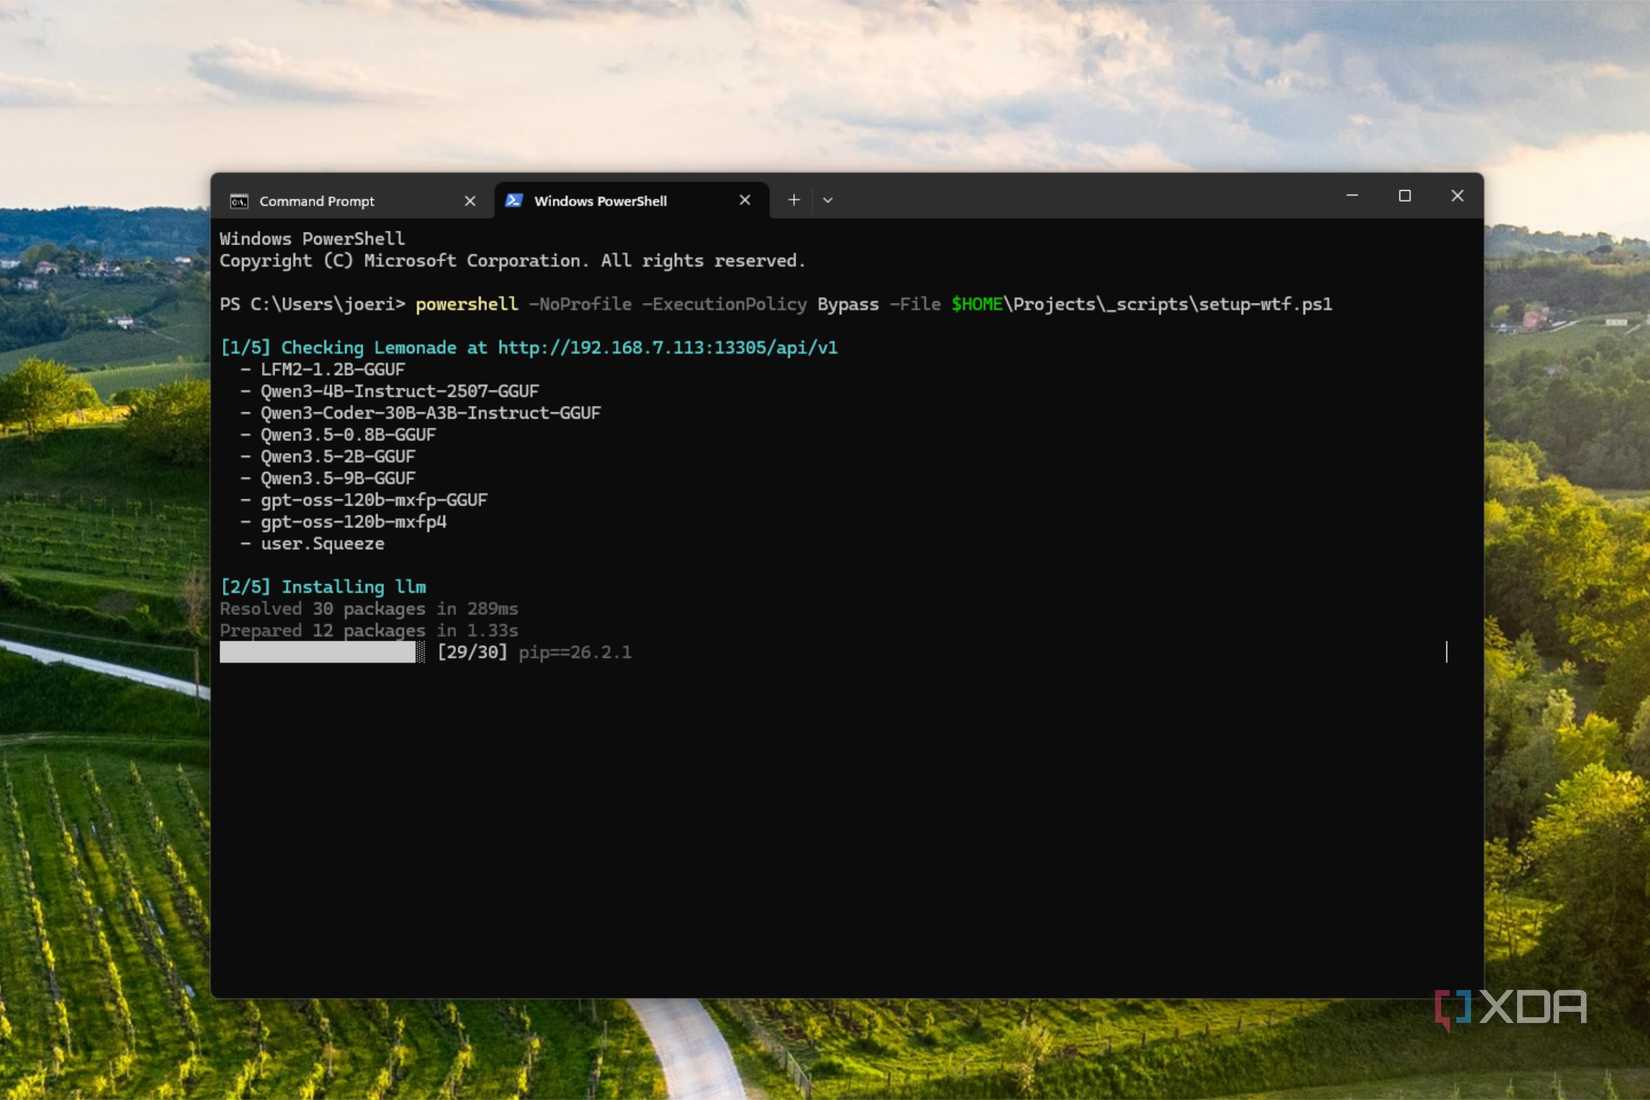
В PowerShell эта команда применяется двумя способами: либо через обертку для выполнения (wtf { команда }), либо путем вызова wtf без аргументов для анализа последней ошибки в сессии. Важно отметить, что модель не выполняет команды, а лишь предлагает их, что минимизирует риски случайного удаления данных или повреждения системы.
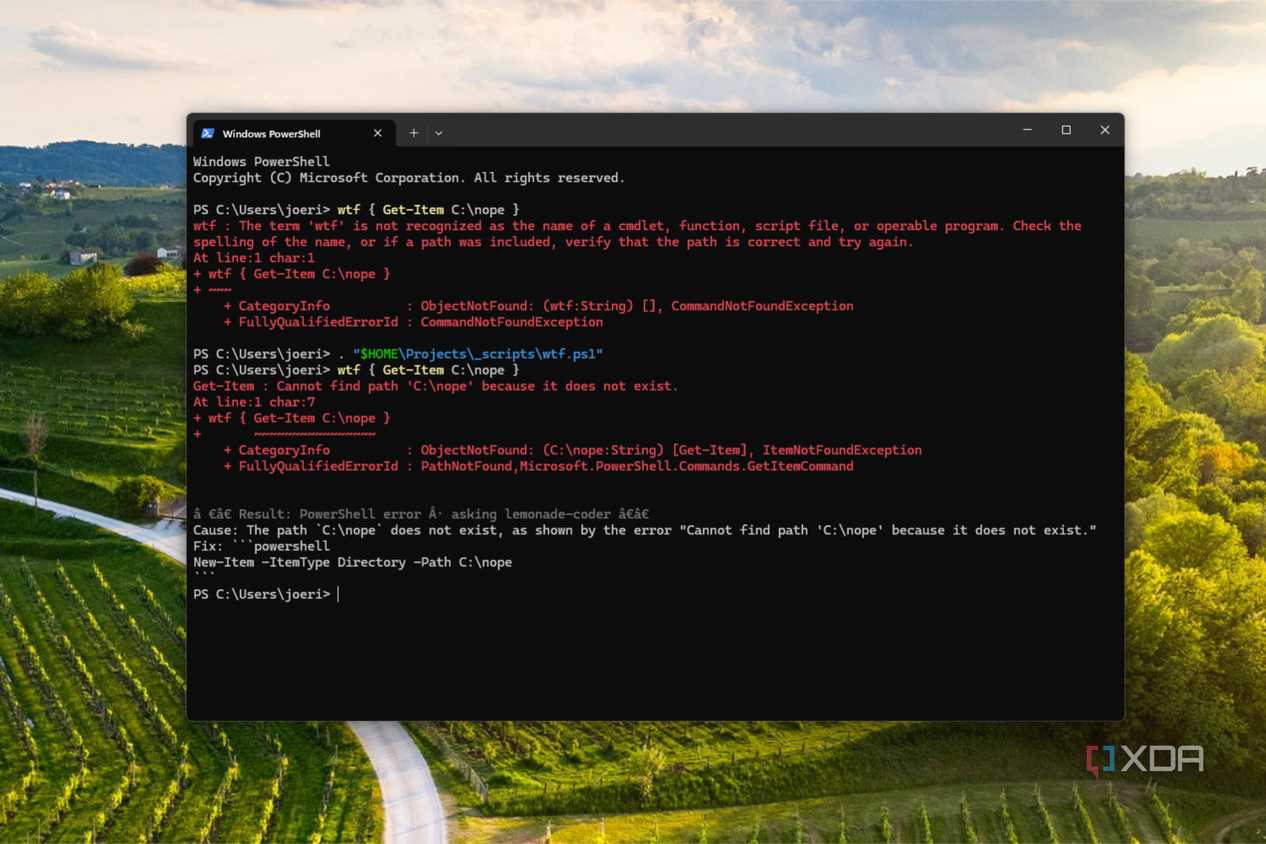
Практическая эффективность и ограничения
Тестирование показало, что ответы от модели поступают в течение 3–6 секунд, что значительно быстрее ручного копирования скриншотов. Система отлично справляется с диагностикой, например, выявлением ошибок несоответствия типов в Rust или опечаток в именах пакетов. Однако качество предложенных решений варьируется: в случаях с отсутствующими путями модель может предлагать нерелевантные действия, такие как подавление ошибки вместо исправления причины.
Существуют и технические нюансы: некоторые нативные программы (например, git или winget) не передают ошибки в стандартный поток $Error, поэтому их нужно запускать через обертку wtf заранее. Кроме того, текст, проходящий через логи, теряет визуальное форматирование и цвета. Несмотря на это, основной смысл анализа — быстрое обнаружение проблемы — выполняется успешно. Использование локальной модели позволяет избежать отправки данных в облако, сохраняя всю информацию внутри частной сети, что делает этот подход оптимальным для системных администраторов и разработчиков.
Почему скриншоты — это узкое место
Проблема «скриншотного цикла» заключается в том, что пользователь работает медленнее, чем сама нейросеть. Процесс захвата экрана, кадрирования, переключения между окнами, вставки текста и написания пояснений (о том, какая используется ОС, какая оболочка и какова была цель команды) приводит к потере нити рассуждений.
Более того, скриншоты всегда несут потери данных: длинные сообщения об ошибках неизбежно обрезаются. В результате модель лишается доступа к такой критически важной информации, как код завершения или директория, из которой запускалась команда. Получая лишь «половину истории», ИИ нередко выдает уверенный ответ на неверно поставленный вопрос. Также автор отмечает, что даже при использовании облачных решений возникает риск передачи в терминальном выводе таких данных, как строки подключения с паролями, bearer-токены в curl-запросах или внутренние IP-адреса, что делает изоляцию данных внутри локальной сети критически важной.
Техническая реализация и настройка
Серверная часть решения базируется на Lemonade Server, работающем внутри LXC-контейнера на узле Proxmox. Использование 30-миллиардной модели Qwen3-Coder-30B-A3B-Instruct оправдано тем, что она достаточно быстра и хорошо ориентируется в ошибках командной оболочки. Хотя она может уступать передовым («frontier») моделям при анализе тяжелых kernel panic, её ресурсов вполне хватает для повседневных задач вроде исправления опечаток в названиях пакетов или диагностики проблем с запуском сервисов.
Настройка клиента через утилиту `llm` от Саймона Уиллисона предельно проста. Установка в Windows выполняется одной командой: `uv tool install llm`. Конфигурация модели в файле `extra-openai-models.yaml` выглядит следующим образом:
«`yaml
— model_id: lemonade-coder
model_name: Qwen3-Coder-30B-A3B-Instruct
api_base: «http://lemonade.ip.goes.here:13305/api/v1»
«`
Интеграция с оболочкой реализована через функцию с ироничным названием `wtf`. Изначально планировалось назвать её `ex`, но выяснилось, что это имя уже занято стандартным построчным редактором vi, присутствующим в большинстве Linux-систем.
Особенности работы функции wtf и безопасность
Важным принципом работы `wtf` является отказ от повторного выполнения команд. Автор подчеркивает, что такие действия, как `apt transaction` или `pct destroy`, не должны запускаться в цикле повторно из соображений безопасности.
Механизм маскирования данных перед отправкой запроса работает по принципу «ремня и подтяжек» (belt and braces): он ищет токены после знака равенства, учетные данные в URL, длинные шестнадцатеричные строки, JWT и заголовки с bearer-токенами. Это дает возможность при необходимости перенаправить запросы `wtf` на другие эндпоинты без страха скомпрометировать конфиденциальную информацию.
Анализ результатов и «галлюцинаций»
Тестирование показало любопытные различия в скорости: Linux-ответы приходят быстрее, чем Windows-запросы, что объясняется особенностями запуска клиента, а не скоростью работы самой модели.
Интересен подход ИИ к решению проблем. В случае ошибки отсутствующего пути (`ls /nope`), модель в трех разных запусках предлагала три разных «решения»: создание папки, повторный запуск команды или подавление ошибки через `-ErrorAction SilentlyContinue`. Это наглядно демонстрирует, что модель не «понимает» логику того, что было введено пользователем, а лишь подбирает «форму» ответа, похожую на исправление. Однако в ситуациях с ошибками в файлах systemd, модель вместо слепого исправления предлагает полезные команды для диагностики, например, `systemctl list-unit-files | grep caddy`, что позволяет найти правильное имя юнита. Именно эта исследовательская функция — идентификация проблемы для поиска — делает инструмент незаменимым помощником, позволяя не вчитываться в «стену текста», а быстро проверить предложенное решение.