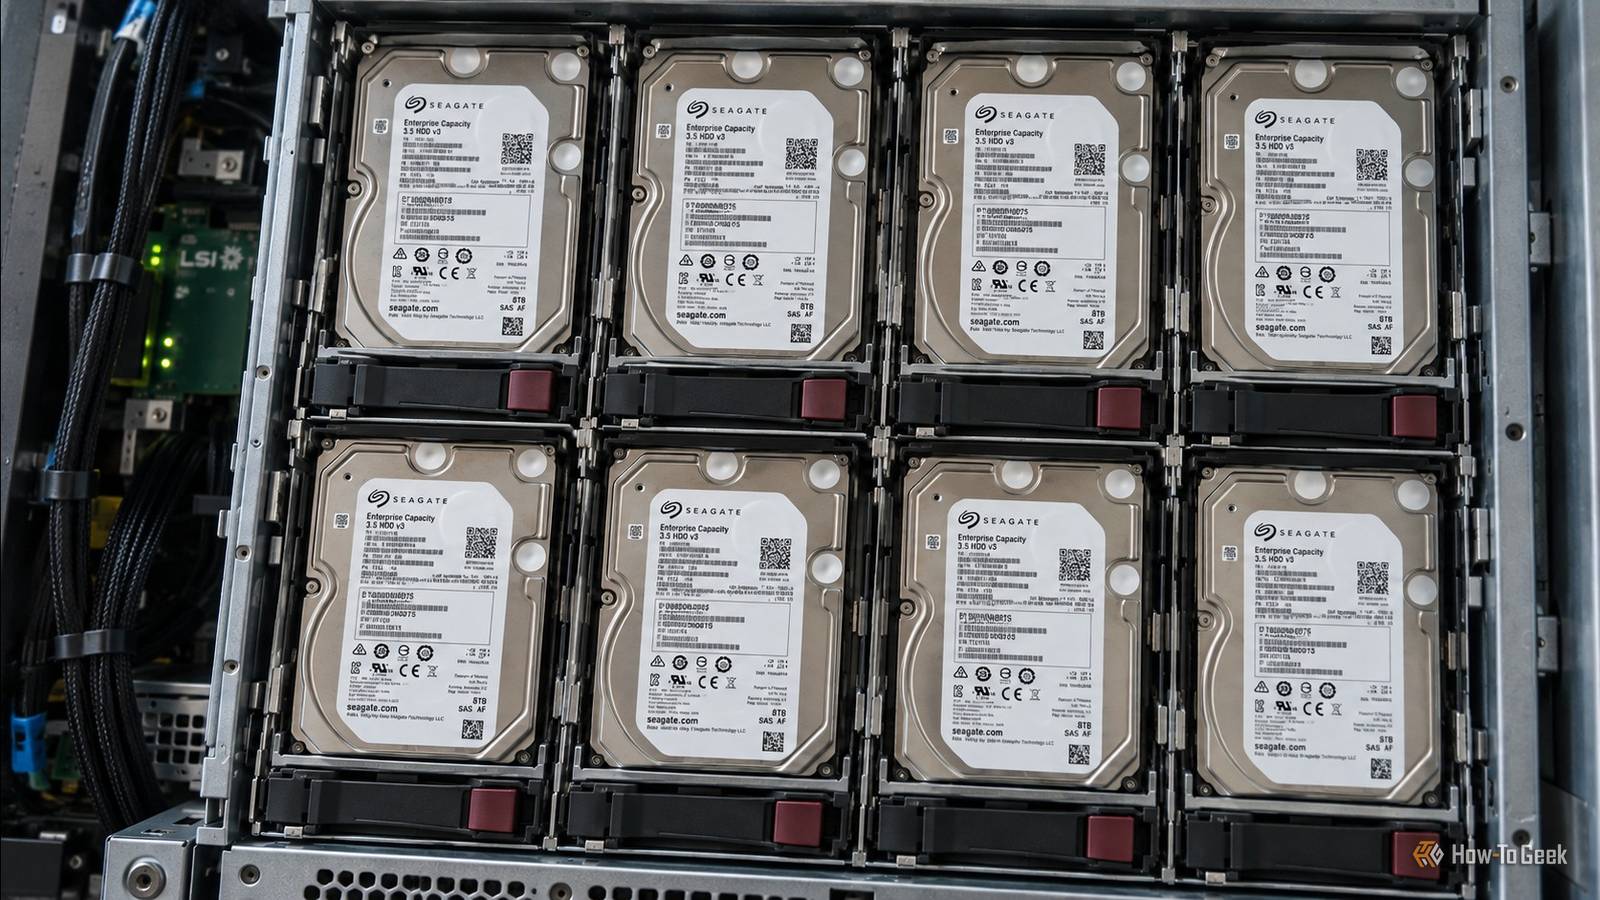
Приобретение подержанного корпоративного оборудования для домашнего сервера выглядит заманчиво благодаря низкой цене по сравнению с новыми дисками. Однако, как показывает практика, переход от выгодной покупки к работающему хранилищу данных часто оказывается сложнее, чем ожидается. Примером служит недавняя закупка восьми жестких дисков Seagate SAS объемом 2 ТБ и одного NVMe-накопителя HGST Ultrastar DC SN200.
Особенности настройки дисков после RAID-систем
Одной из главных проблем при запуске серверных HDD стали настройки секторов. Выяснилось, что два из восьми приобретенных дисков Seagate ранее использовались в составе аппаратного RAID-массива. Они были отформатированы с нестандартным размером сектора — 520 или 528 байт, тогда как стандартные HBA-контроллеры ожидают привычные 512 байт. В серверной среде контроллеры используют дополнительные байты для хранения метаданных или контрольных сумм, но при подключении таких дисков к обычному HBA-адаптеру в домашней системе они не распознавались корректно.
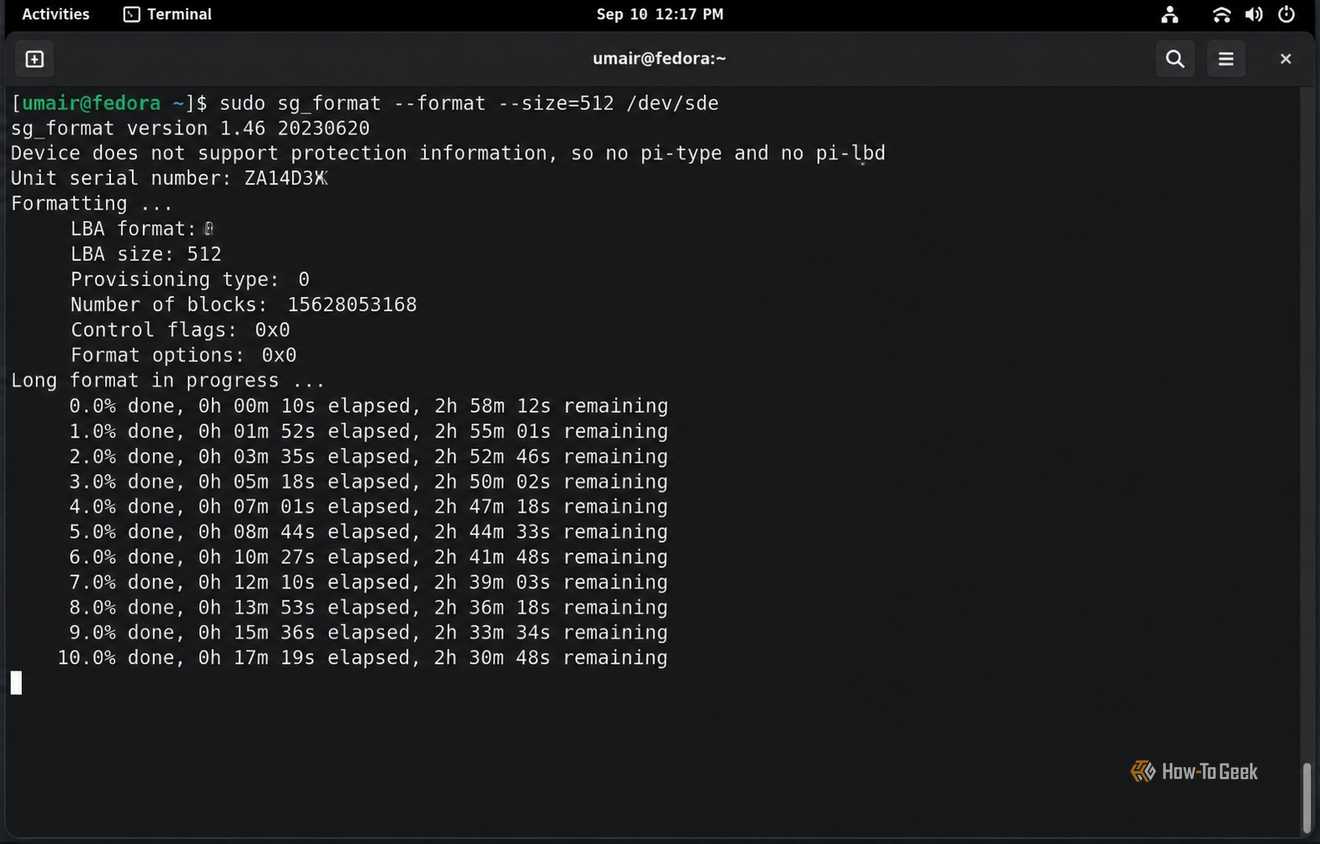
Решением стала процедура низкоуровневого форматирования с помощью утилиты sg_format из пакета sg3_utils. Этот процесс требует значительного времени: в зависимости от модели диска форматирование занимает от 2,5 до 3 часов на каждый терабайт. Для крупных накопителей такая процедура превращает простую задачу по подготовке оборудования в работу, растягивающуюся на целый день.
Сложности с подержанными NVMe-накопителями
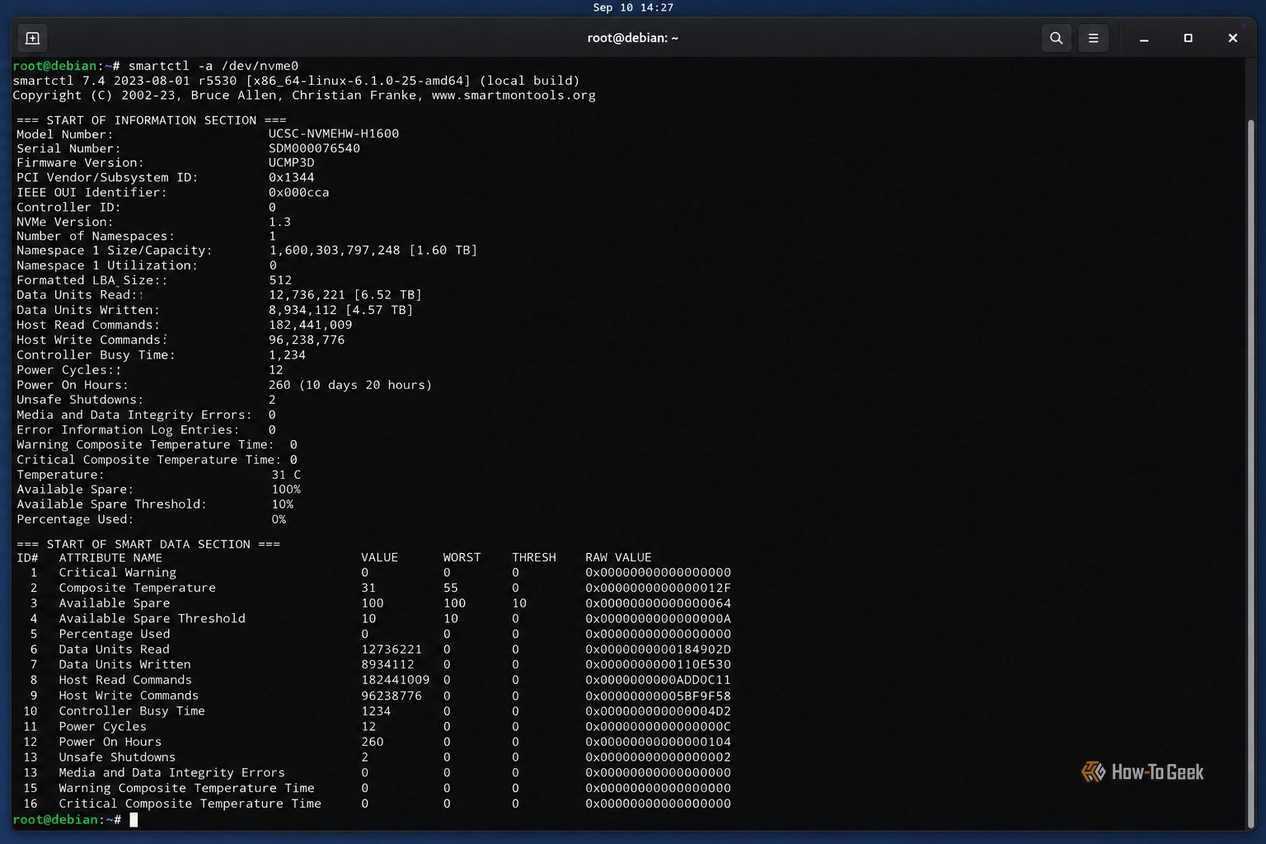
Опыт с NVMe-накопителем Western Digital Ultrastar SN200 оказался еще более неоднозначным. Хотя продавец утверждал, что устройство проработало менее 12 дней, реальная эксплуатация в системе на базе Debian выявила ряд трудностей. Диск определялся как устройство производства Cisco с кастомной прошивкой, что значительно усложнило его настройку. Для приведения накопителя в рабочее состояние потребовались специфические инструменты от производителя, обновление прошивки и работа с драйверами.
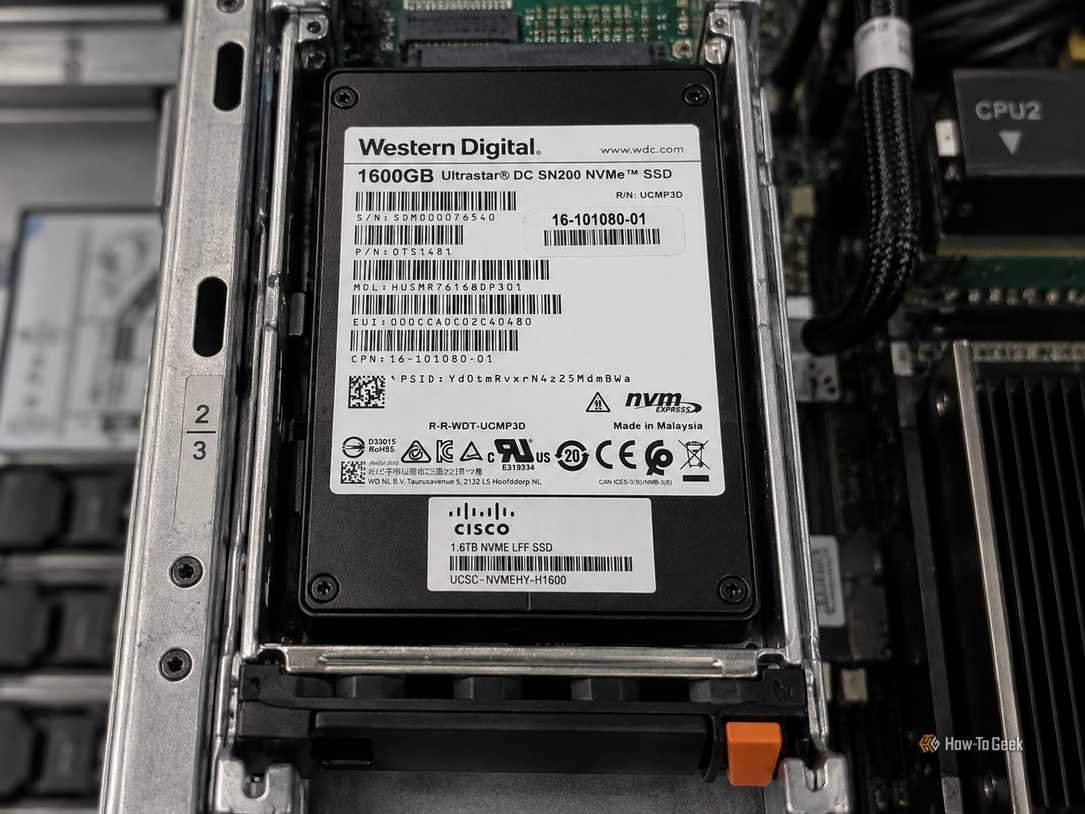
Даже после настройки проблема не была полностью решена: при многократных перезагрузках диск периодически переходил в диагностический режим, делая данные недоступными. Это сделало его непригодным для кэширования, под которое он планировался. Данный случай наглядно демонстрирует, что низкий показатель наработки в часах не гарантирует стабильную работу серверного NVMe-накопителя, так как его история и программные ограничения могут быть скрыты.
Важность тщательного тестирования оборудования
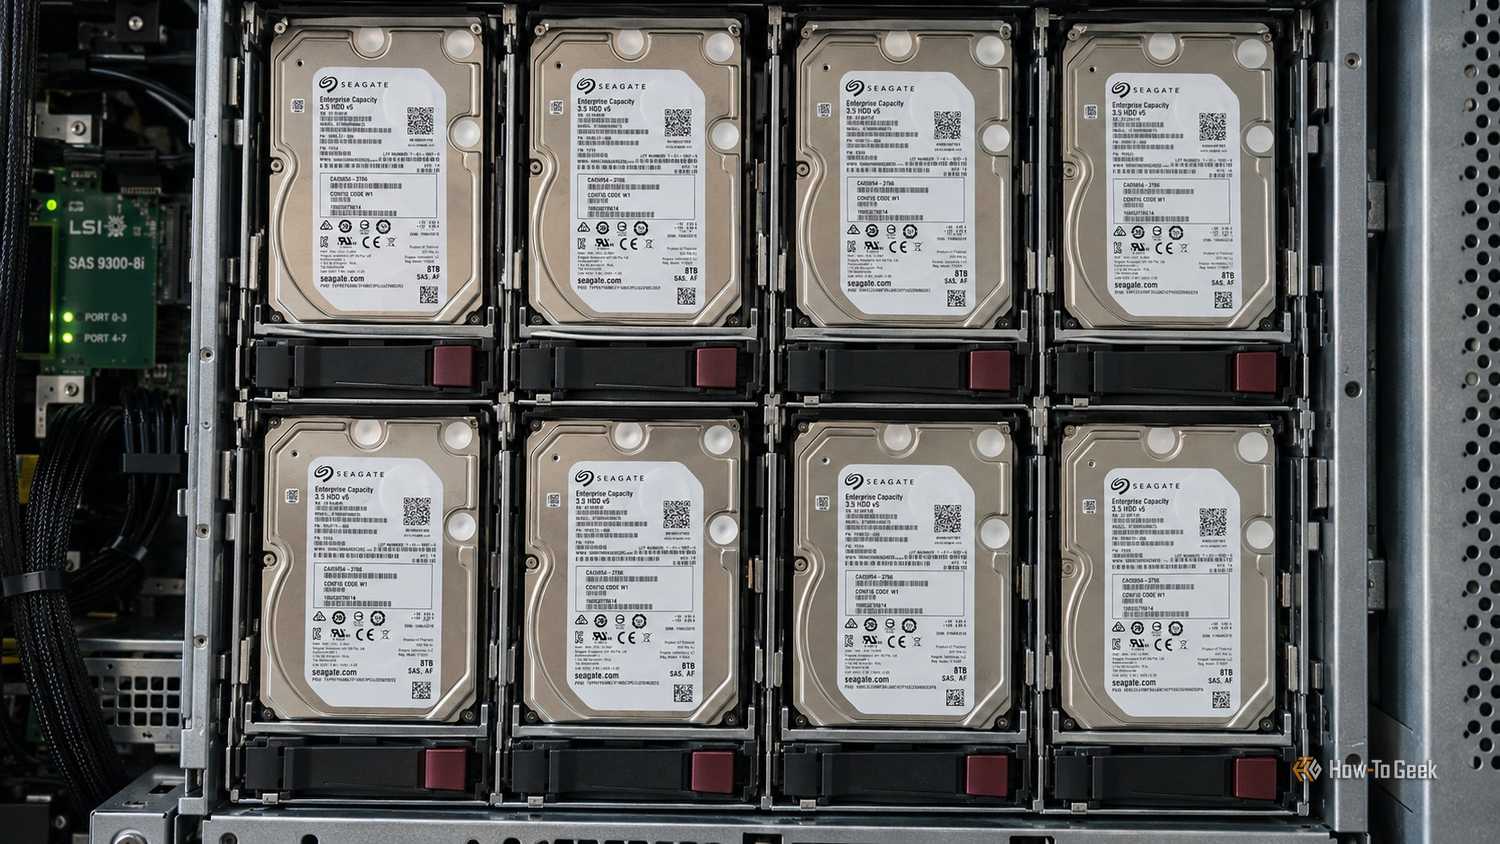
Главный урок при покупке подержанного серверного «железа» заключается в том, что затраты на этом не заканчиваются. Время, потраченное на полноценную проверку, является частью цены покупки. В обязательный список мероприятий входит:
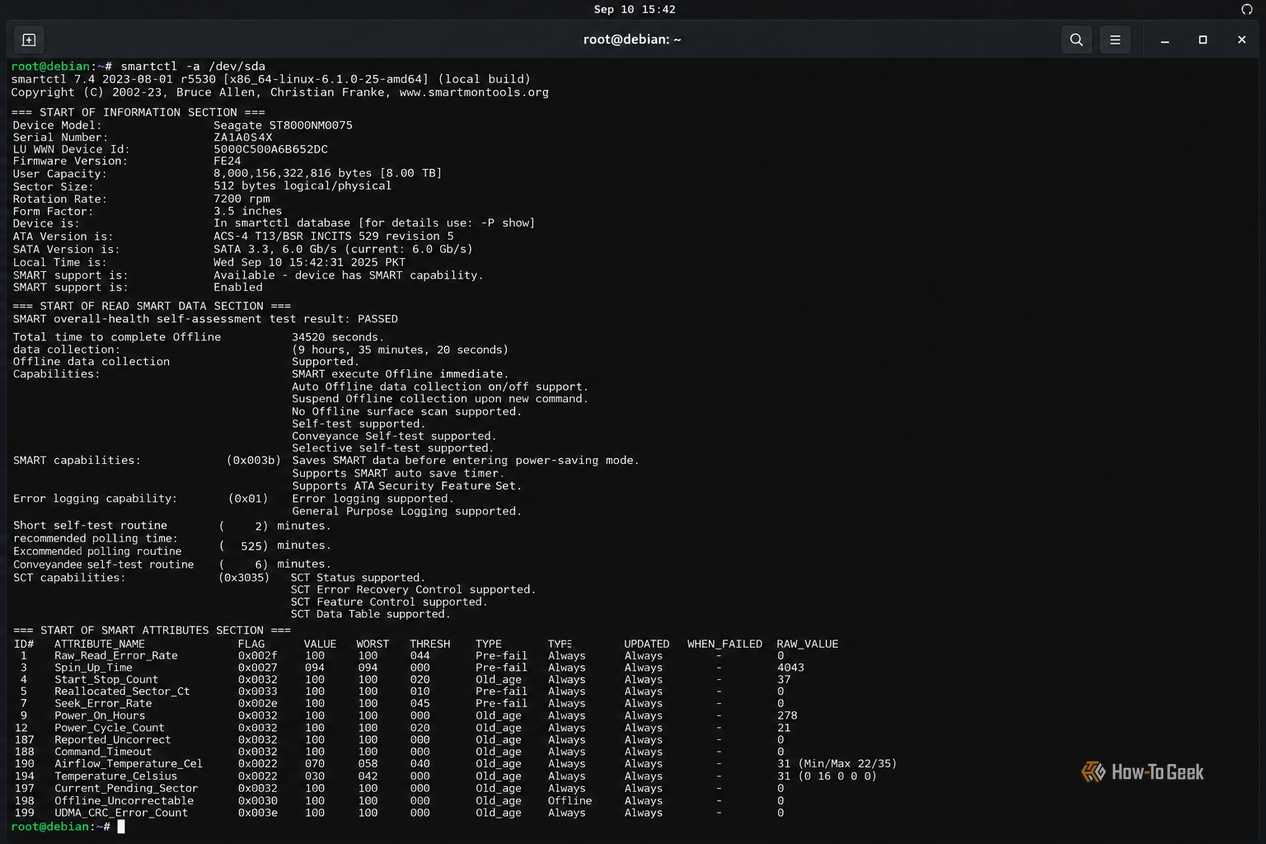
- анализ SMART-данных;
- проверка версии прошивки;
- выполнение полных циклов записи и чтения;
- мониторинг температуры;
- контроль задержек при длительных нагрузках.
Индивидуальное тестирование каждого диска перед объединением в массив критически важно, особенно при создании пулов ZFS. Выход из строя одного диска в массиве требует процесса «ресильверинга» (восстановления данных), который создает высокую нагрузку на остальные накопители. Если все они являются подержанными, отказ одного устройства может спровоцировать «эффект домино» и привести к потере данных, поэтому наличие резервных копий остается обязательным вне зависимости от надежности оборудования.
Несмотря на технические сложности, покупка бывших в употреблении корпоративных HDD остается оправданным шагом для домашнего использования. После тщательной проверки купленная партия дисков проявила себя хорошо, показав минимальный износ. Основной риск заключается в покупке «кота в мешке» с неизвестной историей, ответственность за проверку которой полностью ложится на плечи покупателя.
Почему «железо» из ЦОД требует особого подхода
Покупка подержанных корпоративных накопителей — это классическая сделка, где начальная экономия быстро превращается в инженерную задачу. Если цена за терабайт выглядит подозрительно низкой, стоит помнить: вы приобретаете не просто устройство хранения, а компонент, который был частью сложной экосистемы с собственными правилами обработки данных.
Специфика секторов и низкоуровневая подготовка
Когда вы извлекаете диск из профессиональной системы хранения, он часто «несет на себе» её специфические настройки. Использование секторов по 520 или 528 байт вместо стандартных 512-байтовых — это не баг, а фича enterprise-решений. Дополнительные байты позволяют RAID-контроллерам хранить метаданные или контрольные суммы, обеспечивая целостность данных на аппаратном уровне. Однако для стандартного HBA-адаптера или прямого подключения (JBOD) такая разметка становится непреодолимым препятствием: диск просто не «видит» файловая система, или же он работает некорректно.
Важно понимать, что `sg_format` — это не просто «быстрое форматирование», которое мы привыкли видеть в Windows или Linux. Это низкоуровневая операция, которая фактически переразмечает физические области диска. Учитывая скорость процесса (до 3 часов на терабайт), подготовка пула из нескольких крупных HDD может растянуться на весь день. Это время, которое вы инвестируете в то, чтобы заставить промышленное оборудование «общаться» на языке потребительских операционных систем.
Теневая сторона корпоративных NVMe
Опыт с накопителями серии Ultrastar SN200 от Western Digital наглядно показывает, что малый показатель наработки в часах (Power-on hours) может быть обманчивым индикатором. В случае с Enterprise NVMe, даже если диск почти не включали, вы можете столкнуться с глубокой программной несовместимостью. Проблема с «брендированием» Cisco — распространенное явление: крупные компании заказывают партии накопителей с кастомной прошивкой, которая может включать специфические ограничения или требования к хост-адаптерам.
Когда устройство постоянно сбрасывается в «диагностический режим» после перезагрузок, никакие манипуляции с драйверами не спасут ситуацию. Это ключевое отличие от HDD: если жесткий диск либо крутится, либо нет, то корпоративный SSD — это сложное микропроцессорное устройство. Проблемы с прошивкой (firmware) могут проявляться непредсказуемо, делая диск непригодным для кэширования или других интенсивных задач, требующих высокой доступности данных.
Тестирование как страховой полис
Покупая «б/у», вы берете на себя роль отдела контроля качества. Для ZFS-пулов это особенно критично: ресильверинг — процедура тяжелая и стрессовая для всех участников массива. Если вы восстанавливаете данные на старый диск, чьи SMART-показатели выглядят приемлемо, но реальный ресурс изношен, вы рискуете вызвать «каскадный отказ». В этот момент ни ZFS с её контрольными суммами, ни аппаратная избыточность не защитят вас от потери данных, если второе устройство выйдет из строя под нагрузкой.
Поэтому проверка — это не только чтение SMART. Это создание условий, приближенных к реальной эксплуатации:
- Полное заполнение диска данными для выявления «битых» секторов (bad blocks), скрытых от контроллера.
- Проверка задержек (latency) под sustained-нагрузкой, чтобы убедиться, что диск не начинает «тормозить» при длительной записи.
- Мониторинг теплового режима, так как подержанные диски могут иметь деградировавшие термоинтерфейсы.
В итоге, покупка подержанного оборудования — это всегда лотерея с неизвестной историей эксплуатации. Вы не просто покупаете товар с дисконтом, вы покупаете обязанность провести его полную диагностику. В случае удачи вы получаете надежные накопители по цене ниже рыночной, но в случае с проблемными накопителями (вроде того же SN200) единственным выходом остается возврат, и важно заранее уточнять условия возврата с продавцом, так как многие серверные комплектующие продаются «как есть».