Масштабирование RISC-V в архитектуре Nvidia
Технология RISC-V существует уже давно, однако ее масштабный прорыв в потребительский сегмент, такой как ноутбуки, серверы или смартфоны, пока остается лишь ожиданием, в то время как рынок видит в основном лишь отладочные платы от компаний вроде SiFive. Тем не менее ситуация изменилась: по оценке Nvidia, в 2024 году компания поставила более миллиарда ядер RISC-V. Важно уточнить, что они не используются в качестве основных шейдерных ядер, а интегрированы в комплекс вспомогательных процессоров управления, выполняющих широкий спектр задач вокруг графической обработки. В зависимости от конкретной модели GPU, один чип может содержать от 10 до 40 таких ядер. Для пользователей они недоступны для программирования, а сами критически важные блоки защищены криптографической проверкой — любые попытки вмешательства приводят к отказу GPU при загрузке прошивки. Примечательно, что одно из таких ядер с 2018 года выполняет значительную часть работы, которую ранее брал на себя графический драйвер.
Наследие архитектуры Falcon
В течение десятилетия до перехода на RISC-V компания Nvidia использовала собственные проприетарные микроконтроллеры Falcon (FAst Logic CONtroller). Впервые они появились примерно в 2005 году в поколении G98, заменив ядра Tensilica Xtensa, отвечавшие за видеодекодирование VP2. Falcon представлял собой конвейерную конструкцию с переменной длиной инструкций, оптимизированную под малую площадь кристалла и высокую задержку памяти, а не под максимальную производительность. По мере усложнения видеокарт Nvidia лишь наращивала количество этих ядер: к 2016 году они присутствовали более чем в 15 различных узлах на одном чипе, а общий объем поставок за десятилетие составил около трех миллиардов единиц. Они отвечали за кодирование и декодирование видео, управление питанием, работу системы безопасности и другие функции. Поскольку встроенная загрузочная ROM-память проверяла подписанную прошивку перед выполнением, эти ядра стали фундаментальной частью архитектуры, что создало проблемы для пользователей Linux: начиная с сентября 2014 года, Nvidia ограничила возможности работы с прошивками для GPU архитектуры Maxwell и более новых, что не позволяло изменять тактовые частоты, оставляя их на базовых значениях.
Переход к RISC-V: причины и критерии выбора
Спустя десять лет стало очевидно, что архитектура Falcon перестала справляться с задачами. Франс Систерманс, вице-президент по разработке аппаратного обеспечения Nvidia, в 2024 году пояснил, что одной из главных причин отказа от Falcon стало отсутствие 64-битного адресного пространства, так как Falcon был 32-битным ядром. Кроме того, у него не было кэша данных и возможности запуска полноценной операционной системы.
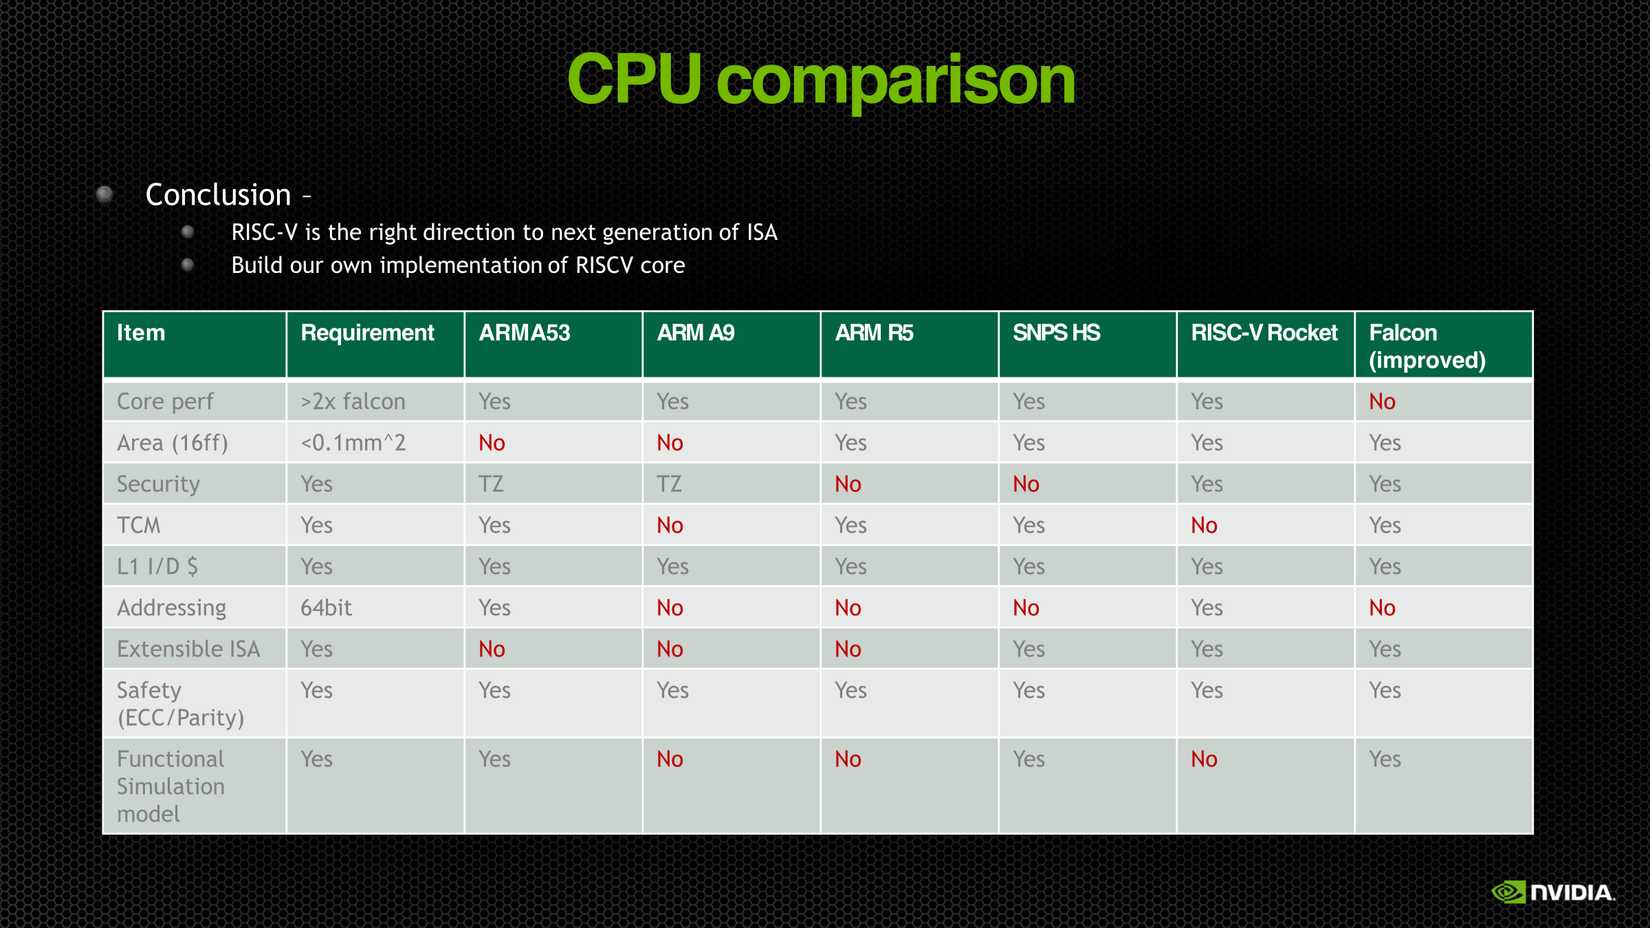
В 2016 году Nvidia начала оценку альтернатив: покупку лицензии или создание собственного решения. В качестве претендентов рассматривались семейства Arm (A и R), Synopsys ARC, MIPS и Cadence. Внутренний отчет Nvidia о сравнении этих технологий продемонстрировал серьезные недостатки конкурентных решений:
* Arm Cortex-A53 не подошел по площади кристалла (не удалось вписаться в 0,1 мм² на техпроцессе 16 нм) и отсутствию расширяемой архитектуры набора команд (ISA).
* Arm Cortex-A9 и Cortex-R5 не прошли проверку по нескольким причинам, включая требование 64-битной адресации.
* Synopsys ARC HS не соответствовал стандартам безопасности и адресации.
* Улучшенная версия Falcon также не смогла достичь целевых показателей производительности и объема адресного пространства.
Nvidia также протестировала ядро Rocket от Berkeley, однако оно не подошло из-за требований к тесно связанной памяти (TCM) и отсутствия функциональной модели симуляции. Именно архитектура набора команд RISC-V выделила её на фоне остальных. В результате Nvidia создала ядро, которое превзошло Falcon по производительности в три раза, занимая лишь в два раза больше площади кристалла.
Сегодня Систерманс, основываясь на своей «неофициальной оценке», утверждает, что любой чип Nvidia содержит RISC-V процессоры, количество которых варьируется от 10 до 30, а иногда и до 40 единиц на один кристалл.
Архитектура микроконтроллеров Nvidia и роль RISC-V
Оценку в один миллиард ядер в год автор называет консервативной, отмечая, что реальное значение, вероятно, находится в диапазоне от одного до двух миллиардов единиц. Изменение этого числа обусловлено тем, что количество ядер масштабируется в зависимости от размера графического процессора: контекстный переключатель GPC (GPCCS) создается для каждого кластера обработки графики, а полноценный чип Ada Lovelace AD102 включает 12 таких GPC. Если добавить к этому видеодвижки — по три блока NVENC и NVDEC, а также другие необходимые компоненты — общее количество быстро достигает 30 или 40 единиц.
Эти данные можно обнаружить в открытых модулях ядра Nvidia, в частности в заголовочном файле rmlsfm.h. В нем содержится список всех микроконтроллеров, известных драйверу, состоящий из 32 различных записей. Первые 12 позиций занимают блоки Falcon, а из оставшихся 20 записей 14 являются ядрами RISC-V. Среди них числятся GSP_RISCV, PMU_RISCV, NVDEC_RISCV и другие. Примечательно, что регистровые заголовки в открытых модулях ядра Nvidia уже охватывают архитектуру Rubin, следующую за Blackwell: файлы dev_riscv_pri.h существуют для rubin/gr100 и rubin/gr102.
Основные проекты ядер
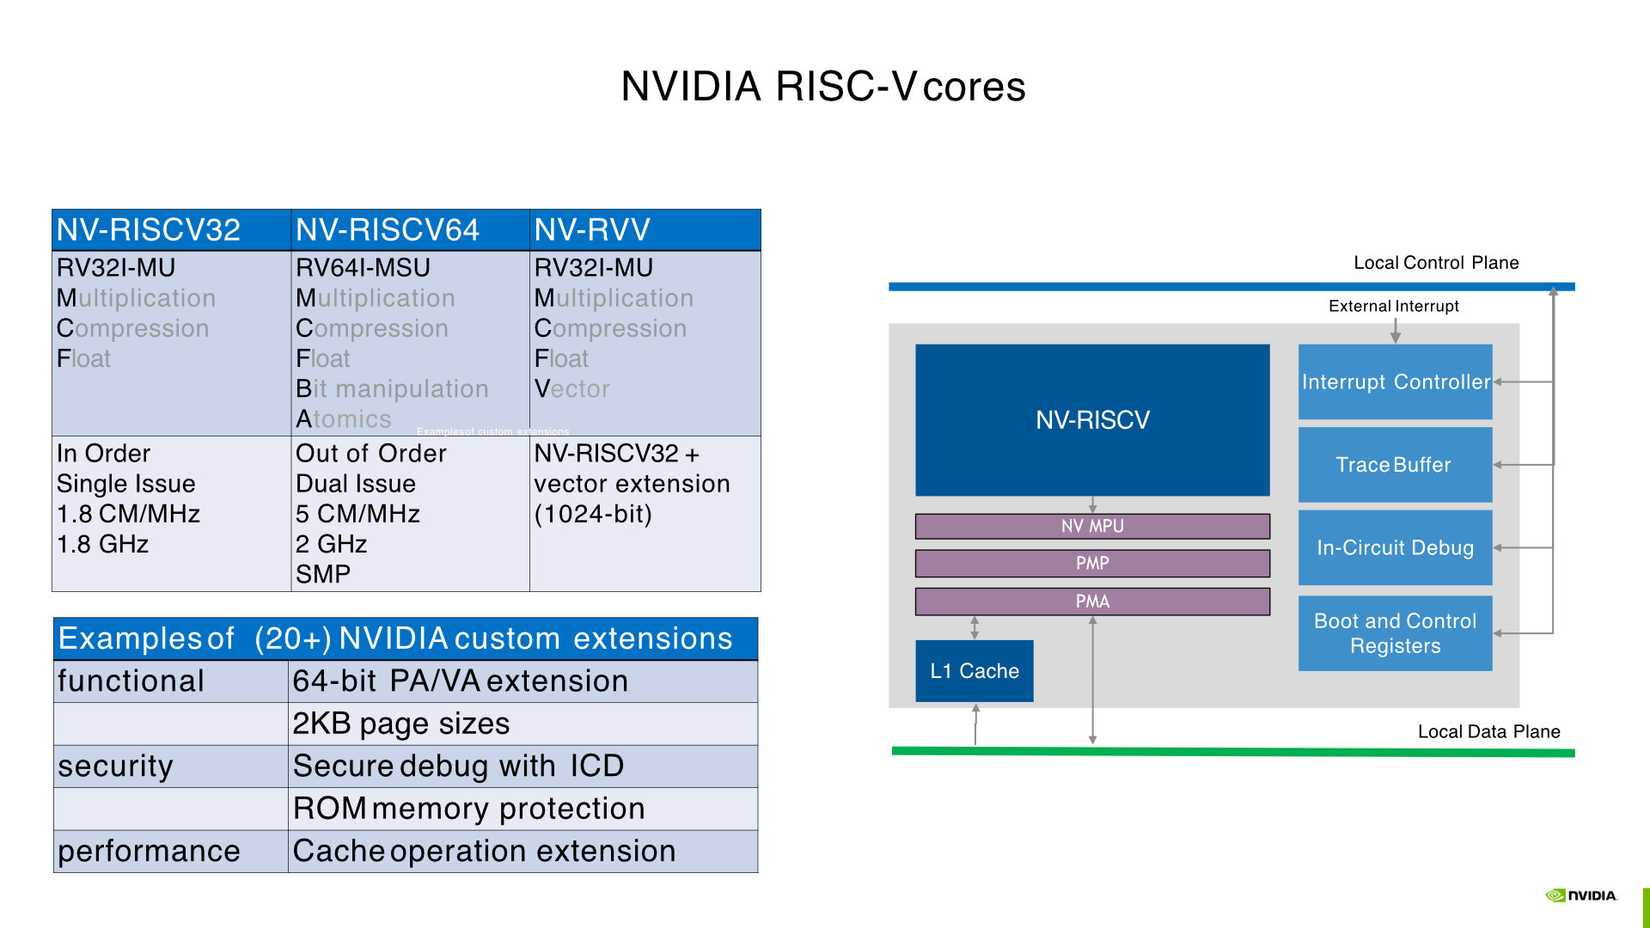
Nvidia использует три основных дизайна ядер собственной разработки:
- NV-RISCV32: ядро RV32I-MU с порядковым исполнением команд.
- NV-RISCV64: более мощное ядро с внеочередным исполнением на базе RV64I-MSU, поддерживающее манипуляции с битами, атомарные операции и симметричную многопроцессорную обработку.
- NV-RVV: 32-битное ядро с присоединенным 1024-битным векторным блоком, входящее в состав ускорителя глубокого обучения (Deep Learning Accelerator).
Каждое ядро интегрировано в многоразовую подсистему под названием «Peregrine», которая добавляет к ядру NV-RISCV кэш, плотно связанную память (TCM), DMA-движок и набор криптографических блоков. Nvidia также разработала более 20 собственных расширений, включая 64-битную физическую и виртуальную адресацию, поддержку страниц размером 2 КБ, безопасную отладку, защиту ROM и инструкции для операций с кэшем. Хотя эти решения узкоспециализированы, они полностью отвечают задачам Nvidia.
GPU System Processor как центральный узел
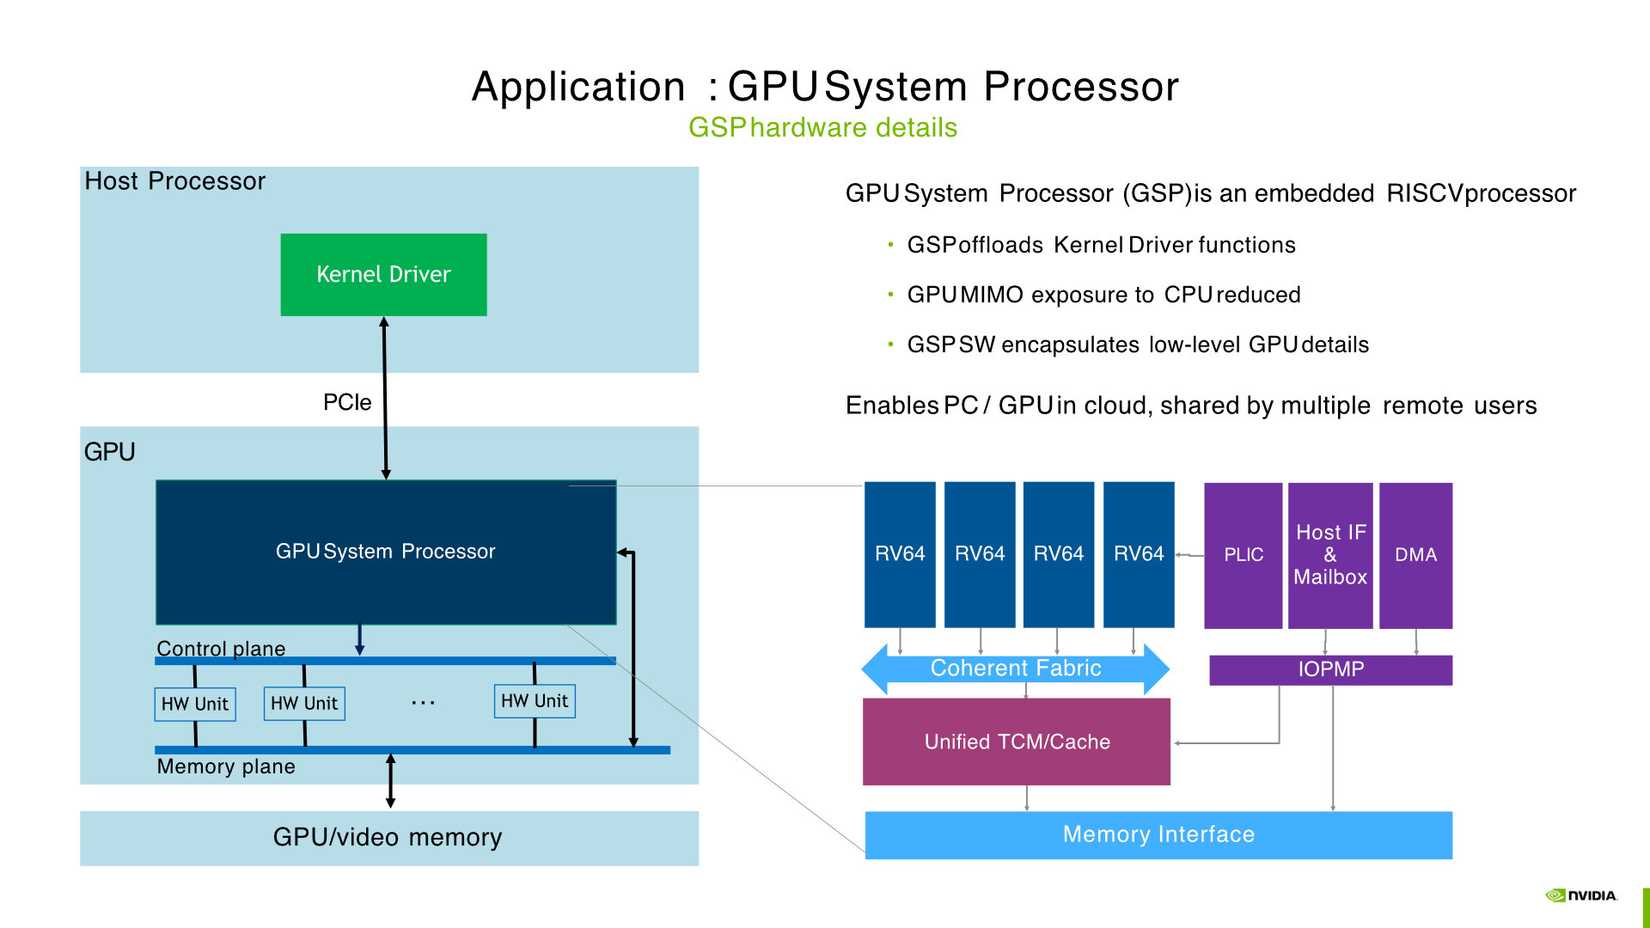
Наиболее важным компонентом является GPU System Processor (GSP). Это не единичное ядро, а комплекс из четырех ядер RV64, работающих под управлением контроллера прерываний платформенного уровня. Система также включает IOPMP для изоляции памяти, DMA-движок, хост-интерфейс с почтовым ящиком, унифицированную плотно связанную память с кэшем и когерентную фабрику, охватывающую весь графический процессор. GSP расположен в верхней части чипа, и через него проходит практически весь трафик.
Начиная с архитектуры Turing, менеджер ресурсов разделен на две части: CPU-RM (работает на центральном процессоре) и GSP-RM (работает на RISC-V ядрах графического процессора). Они обмениваются данными через очередь сообщений RPC. Хостовый драйвер ядра передает высокоуровневые команды GSP, который берет на себя инициализацию, управление питанием и тактовыми частотами. Фактически, большая часть драйвера GPU лишь позволяет компьютеру отправлять команды второму «компьютеру», находящемуся внутри видеокарты.
Анализ прошивки и вопросы безопасности
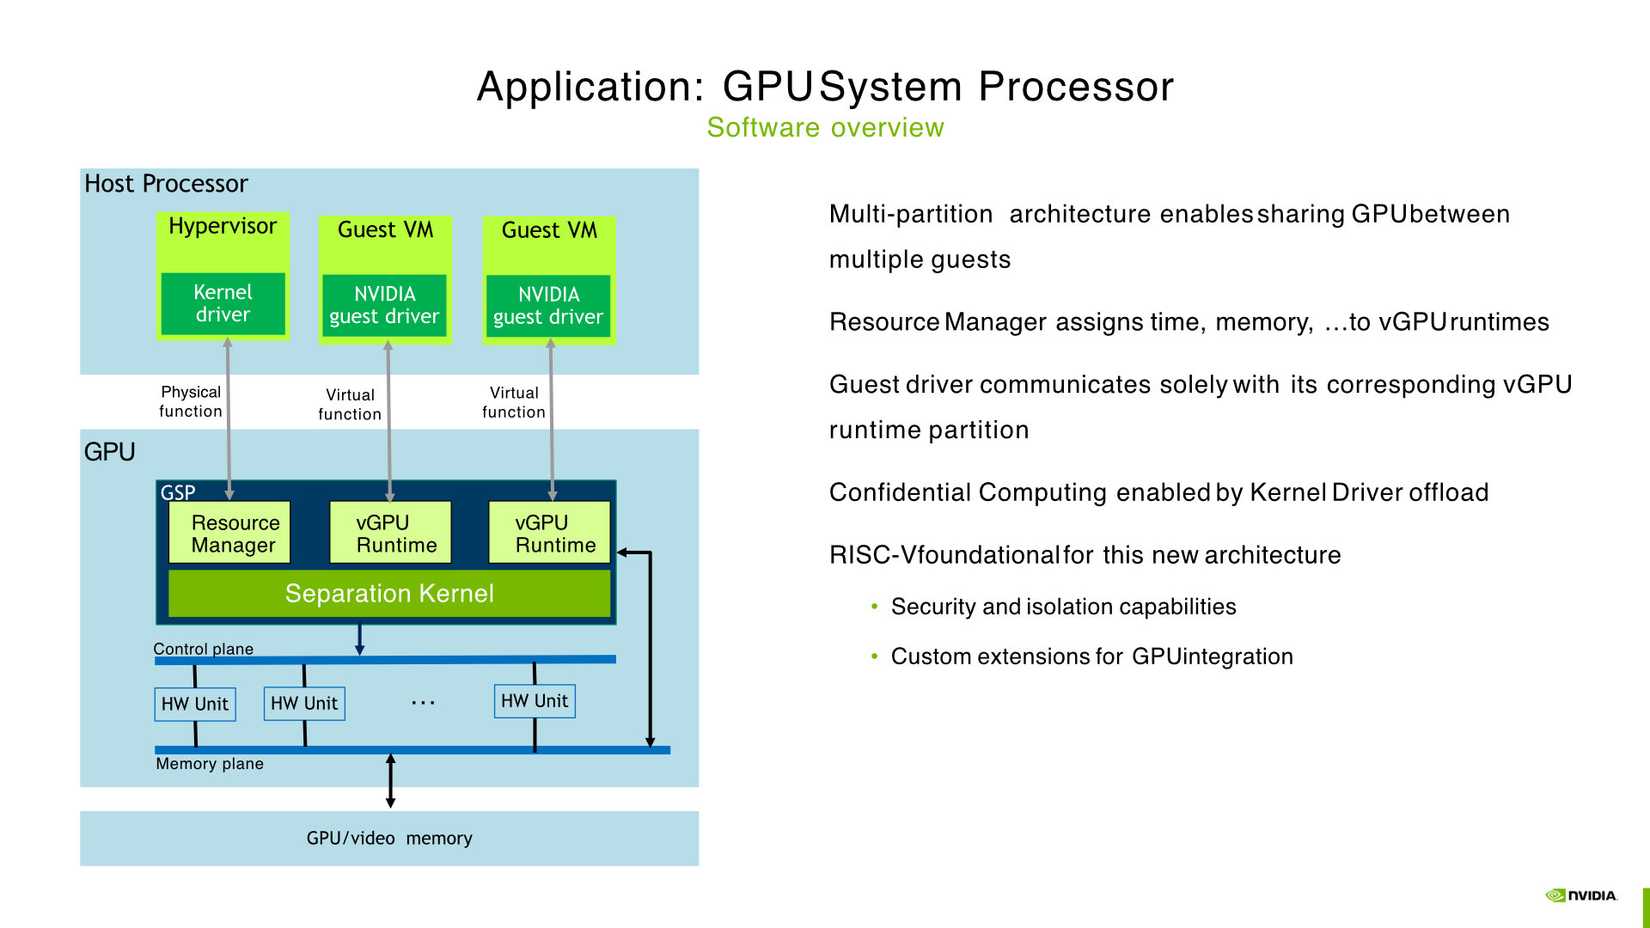
Анализ файла прошивки nvidia/ga102/gsp/gsp-535.113.01.bin объемом 36,3 МБ показал наличие четырех отдельных 4-килобайтных секций RSA-подписей для семейств Ampere GA10x, Ada AD10x, Hopper GH100 и варианта H100 для конфиденциальных вычислений. Сам файл представляет собой ELF64, ориентированный на EM_RISCV. В прошивке обнаружены ссылки на libos-v3.1.0, а также тесты с упоминанием partitions[partitionOwner].pmp[…] и PmpEntryFree. LibOS — это микроядро Nvidia, использующее PMP (стандартный механизм физической защиты памяти RISC-V) для изоляции разделов. Проверка файла nvidia/tu102/gsp/gsp-535.113.01.bin подтвердила идентичность строк, что доказывает использование RISC-V в GSP еще со времен Turing.
Такой подход обеспечивает доступ к внутренним компонентам оборудования с низкой задержкой и значительно сокращает поверхность коммуникации через MMIO с хостом. Благодаря работе GSP в режиме разделенного ядра, один физический GPU может быть распределен между гостевыми виртуальными машинами без участия гипервизора. Хотя программное обеспечение Nvidia vGPU ориентировано на корпоративный сектор, возможность разделения ресурсов, обеспечиваемая GSP, позволяет пользователям активировать vGPU и на потребительских картах.
Использование открытого стандарта для закрытых целей
Несмотря на то что RISC-V является открытой архитектурой (ISA), графические процессоры Nvidia остаются полностью закрытыми. Четыре блока RSA-подписей выполняют критическую роль: GSP не выполнит образ, если подпись не подтверждена для конкретного семейства GPU. Цепочка загрузки настроена так, что механизм безопасности проверяет подлинность прошивки до ее запуска. Выбор RISC-V был продиктован, в том числе, удобством реализации механизмов изоляции и защиты памяти, которые упростили создание такой «заблокированной» системы. Для разработчиков открытого драйвера Nouveau такая ситуация закономерно создает серьезные трудности.
Эволюция прошивок и архитектурные различия в GPU NVIDIA и AMD
Значительная часть логики управления, которая ранее была открытой, перешла в непрозрачный бинарный формат без стабильного ABI и с множеством недокументированных вызовов. Как следствие, образы прошивок для Linux-систем с картами Nvidia стали объемными и перегруженными. С другой стороны, именно это отчасти сделало открытый драйвер nouveau довольно качественным, поскольку теперь Nvidia предоставляет подписанную GSP-прошивку, которую ядро Nouveau может загружать. Благодаря этому открытые драйверы получили возможность управлять тактовыми частотами GPU Nvidia и запускать их на полной скорости — эта функция была недоступна пользователям Linux со времен выхода архитектуры Maxwell в 2014 году. Передача большего объема контроля процессору RISC-V позволила открытому драйверу выполнять с GPU гораздо больше задач.
Nova, наследник Nouveau на языке Rust, имеет явную поддержку GSP и включает определения, такие как «PeregrineCoreSelect», предназначенное для выбора ядра при загрузке системы. Мы проделали долгий путь по сравнению с ситуацией десятилетней давности, даже если это произошло ценой отказа от полностью открытого драйвера GPU.
Подход AMD: фрагментация и отсутствие информации
Компания AMD выбрала противоположный путь. Nvidia не единственная в своем стремлении комплектовать GPU десятками микроконтроллеров; AMD делает то же самое. Разница заключается в том, что AMD использует набор разрозненных архитектур без общей системы команд, объединяющей их. Согласно данным публичного реверс-инжиниринга, ни одна из них не базируется на RISC-V, однако информация от AMD по этому направлению полностью отсутствует.
Платформа безопасности (Platform Security Processor) в современных картах, по всей видимости, использует Arm Cortex-A5 с технологией TrustZone, а блок управления системой (System Management Unit) реализован на базе Tensilica Xtensa, хотя в более ранних поколениях использовались LatticeMico32. Командные процессоры — PFP, ME и MEC — на картах AMD, отвечающие за выполнение задач из очередей GPU, работают под управлением системы, которую в компании называют «F32». Мы знаем об этом только благодаря тому, что группа fail0verflow написала для нее дизассемблер.
Эта система максимально далека от архитектуры общего назначения — по сути, это то, от чего Nvidia решила отказаться еще в 2016 году. Даже регистры F32 специально спроектированы для процессора, который является исключительно фронтендом для GPU:
- Регистр r0 жестко привязан к нулю;
- r1 при чтении извлекает данные (dwords) из очереди команд GPU;
- r2 хранит заголовок текущего пакета команд;
- Инструкция btab используется для поиска типов пакетов в таблице переходов, хранящейся в прошивке.
При этом AMD не избегает RISC-V: компания является участником RISC-V International с 2020 года. Ее процессор MicroBlaze V, представленный в Vivado 2024.1, является полноценным ядром RV32I, которое AMD продает клиентам FPGA как замену собственной проприетарной архитектуре MicroBlaze. Обе компании перешли на RISC-V внутри своих продуктов, но Nvidia сделала это «невидимым» образом во внутренних компонентах, которые нельзя приобрести отдельно. Собственный GSP-блог Nvidia представляет собой стандартный ELF-файл, который легко анализировать, тогда как прошивки AMD для RDNA 3, RDNA 4, PSP, SMU, дисплеев и видео при анализе не дали никаких архитектурных подсказок или даже строк, связанных с компилятором.
Почему разработки Nvidia на базе RISC-V оставались в тени
Систерманс (Sijstermans) пояснил, что разработки Nvidia на базе RISC-V не были широко известны по простой причине: «Большинство людей, когда думают о RISC-V, не думают об Nvidia, или, если думают об Nvidia, не думают о RISC-V. Это потому, что большинство наших проектов выполняются внутри компании, наше программное обеспечение разрабатывается внутри компании и не ориентировано на клиентов».
Однако ситуация меняется. В 2025 году на саммите RISC-V в Шанхае было объявлено, что Nvidia портирует CUDA для работы на процессорах RISC-V. Это означает, что CPU на базе RISC-V сможет управлять GPU Nvidia как основной процессор приложений, подобно тому, как это происходит с x86 и Arm. Точные сроки не назывались, и реализация зависит от появления RISC-V процессоров серверного класса, которых пока практически не существует, но Nvidia явно видит ценность в этой платформе и инвестирует в нее.
Когда порт CUDA для RISC-V станет доступен, это воспримут как приход RISC-V в сегмент серьезных вычислений. Однако на самом деле это случилось еще десять лет назад. Ядра RISC-V все это время находились в GPU Nvidia, тихо обеспечивая вывод изображения и регулируя скорость вращения вентиляторов, а причина, по которой никто этого не замечал, проста: у Nvidia никогда не было причин рассказывать об этом публично.
История Falcon: архитектура, ставшая пределом
До того как RISC-V занял центральное место в экосистеме Nvidia, компания на протяжении десяти лет полагалась на микроконтроллер Falcon (аббревиатура от FAst Logic CONtroller). Впервые представленные около 2005 года в поколении G98, эти контроллеры заменили ядра Tensilica Xtensa, которые ранее Nvidia использовала для видеодекодирования VP2. Falcon представлял собой проприетарную архитектуру с поддержкой набора инструкций переменной длины. Он был специально спроектирован для работы в условиях жестких ограничений по площади кристалла и высокой латентности памяти, жертвуя ради этого «сырой» производительностью. По мере того как графические чипы усложнялись, Nvidia лишь наращивала количество этих контроллеров: к 2016 году их можно было встретить в более чем 15 различных функциональных узлах одного GPU, а общий объем поставок за десятилетие, по оценкам Nvidia, достиг трех миллиардов штук.

Почему Nvidia выбрала RISC-V: «брутальный» разбор конкурентов
В 2016 году, осознав, что Falcon достиг своего архитектурного потолка, Nvidia провела масштабное исследование, оценивая возможность лицензирования сторонних ядер или разработки собственного решения. На столе лежали варианты от Arm (семейства A и R), Synopsys ARC, MIPS и Cadence. Внутренний отчет Nvidia, который компания позднее опубликовала, оказался весьма «брутальным» по отношению к своим поставщикам:
- Arm Cortex-A53: провалился из-за требований к площади кристалла (ядро должно было занимать менее 0,1 мм² на техпроцессе 16 нм, чего добиться не удалось) и отсутствия расширяемой ISA.
- Arm Cortex-A9 и Cortex-R5: не прошли отбор по ряду причин, включая критическую потребность в 64-битной адресации.
- Synopsys ARC HS: не удовлетворил требованиям по безопасности и возможностям адресации.
- Собственный Falcon (в случае модернизации): не мог достичь целевых показателей производительности и масштабирования адресного пространства.
Интересно, что Nvidia также тестировала Rocket — референсное ядро от Калифорнийского университета в Беркли, но оно не подошло из-за проблем с тесно связанной памятью (TCM) и отсутствия полноценной функциональной модели симуляции. Архитектура RISC-V, напротив, позволила создать ядро, которое превзошло Falcon по производительности в три раза, увеличив площадь кристалла всего вдвое.
RISC-V как инструмент изоляции
Важно отметить, что выбор открытого стандарта RISC-V ни в коем случае не означал стремления Nvidia к «открытости» своих GPU. Напротив, в компании прямо признавали, что выбор пал на RISC-V отчасти из-за того, что его архитектурные особенности — в частности, возможности изоляции и механизмы защиты памяти — значительно упростили реализацию жесткой аппаратной блокировки. В прошивках GSP (GPU System Processor) используется стандартный механизм Physical Memory Protection (PMP), который позволяет Nvidia безопасно разделять GPU на виртуальные машины без необходимости вовлечения гипервизора в процесс исполнения команд. Это не только повышает безопасность, но и создает барьер для модификаций со стороны конечных пользователей, так как цепочка загрузки требует криптографической проверки подписей RSA для каждой версии прошивки.
Будущее: CUDA на RISC-V
Развитие этого направления продолжится: в 2025 году на саммите RISC-V в Шанхае было официально объявлено, что Nvidia ведет работу по портированию своей платформы CUDA для запуска на процессорах архитектуры RISC-V. Это позволит использовать RISC-V CPU в качестве основного процессора приложений для управления мощными графическими ускорителями Nvidia, аналогично тому, как сегодня это реализовано в системах на базе x86 и Arm. Хотя конкретные сроки выхода этой реализации не назывались, очевидно, что Nvidia делает ставку на дальнейшую интеграцию RISC-V в сегмент высокопроизводительных вычислений (HPC).