Компания WhiteFiber вывела на коммерческий рынок решение WhiteFiber Continuum, превратив двухплощадочный суперкластер графических процессоров, впервые представленный в июле под именем Project Redwood, в готовый к развертыванию корпоративный продукт. Разработка позиционируется как самое производительное решение для межсетевого взаимодействия дата-центров и первая доступная на рынке распределенная архитектура GPU-суперкластера. Система объединяет территориально разделенные центры обработки данных в единый логический кластер для преодоления пропускной способности и задержек при развертывании инфраструктуры искусственного интеллекта.
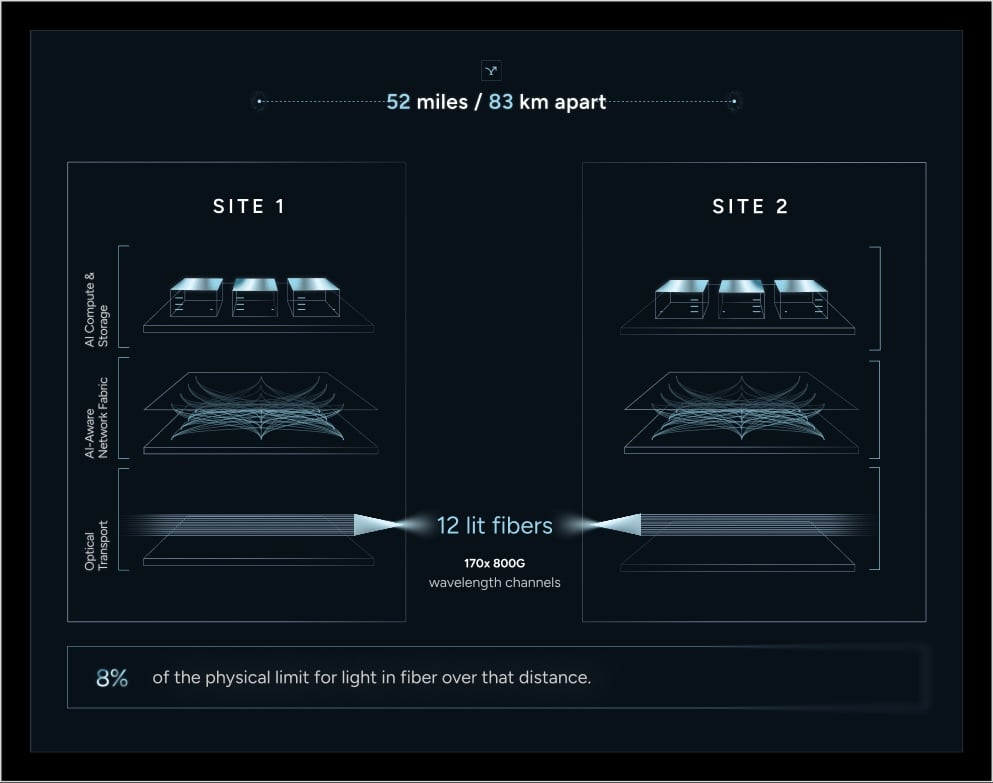
Continuum функционирует на базе двух сертифицированных по стандарту HITRUST объектов компании QTS, расположенных на расстоянии 83 километров друг от друга. Площадки соединены 12 темными волокнами Zayo, при этом за сетевую инфраструктуру отвечает DriveNets AI Fabric, а за хранение данных и память — WEKA NeuralMesh. Совокупная пропускная способность архитектуры оценивается в 136 Тбит/с. Согласно данным компании, эта емкость распределена на 170 каналов с длиной волны по 800G, а гарантированная задержка в оба конца составляет 0,9 миллисекунды, что находится в пределах 8% от физического лимита распространения света в оптоволокне на такую дистанцию.
В июле в рамках научно-исследовательских испытаний на части спектра фиксировался показатель 111,2 Тбит/с. Представители компании отмечают, что отметка в 136 Тбит/с достигается после подключения дополнительных длин волн, а для подтверждения заявленных коммерческих спецификаций в настоящее время проводятся тесты полного оптического спектра. На используемые технические решения уже поданы патентные заявки. По словам генерального директора WhiteFiber Сэма Табара, Continuum решает многолетнюю отраслевую проблему, когда географическая дистанция ограничивает возможности кластера, позволяя ИИ-вычислениям работать масштабируемо и без сбоев при неполадках на одной из площадок.
Инфраструктура связи и общая система хранения
Для объединения объектов используется Ethernet-платформа DriveNets AI Fabric, которая применялась и в летних тестах. Вице-президент по продуктам и выходу на рынок ИИ-инфраструктуры в DriveNets Йосси Кикозашвили подчеркнул, что сетевая ткань на базе Ethernet обеспечивает максимальную эффективность при передаче данных, оптимизирует использование графических процессоров и энергоэффективность. На продуктовой странице WhiteFiber указано, что оба дата-центра обрабатывают живой трафик одновременно, а через межсайтовую линию передаются исключительно градиенты моделей. Это позволяет выполнять единую задачу на всем кластере или разделять ее на независимые рабочие нагрузки с динамическим перераспределением при изменении спроса.
Уровнем памяти и хранения данных управляет платформа WEKA NeuralMesh, обеспечивающая единую высокопроизводительную основу для обеих площадок. Соучредитель и генеральный директор WEKA Лиран Звибель отметил, что суперкластер эффективен настолько, насколько унифицированы его данные, а NeuralMesh стирает физические границы между удаленными друг от друга графическими процессорами.
Энергетическая агрегация и контроль юрисдикции данных
Архитектура позволяет телекоммуникационным и метрополитенским объектам со свободными мощностями и оптоволоконными ресурсами участвовать в работе общего логического GPU-суперкластера. Такой подход превращает неиспользуемые активы в полезную емкость для инференса на последней миле и агентских задач. Предприятия могут объединять графические процессоры с разных площадок, обходя ограничения по питанию и пространству в пределах одного кампуса.
Для регулируемых отраслей Continuum сохраняет конфиденциальные нагрузки в рамках исходной юрисдикции, одновременно распределяя вычисления и обеспечивая отказоустойчивость. Отсутствие единой точки отказа гарантирует продолжение тренировки моделей при выходе из строя одного из центров. В дальнейшем компания планирует подключать к кластеру новые площадки, а 14 октября организует технический разбор архитектуры совместно со специалистами DriveNets и WEKA.