Obsidian привлекает пользователей как универсальное решение: приложение позиционируется не только как инструмент для заметок, но и как полноценная система управления задачами и базами данных. Возможность хранить всю информацию в обычных текстовых файлах, которые легко переносятся между программами, делает платформу популярным выбором. Однако стремление настроить Obsidian под любые нужды часто приводит к тому, что на поддержание порядка в системе уходит больше времени, чем на саму работу. Один из пользователей нашел способ оптимизировать свой процесс, последовательно исключая лишние функции, пока не оставил одну ключевую роль для приложения.
Оптимизация рабочего процесса и борьба с избыточностью
Долгое время автор пытался использовать Obsidian для всего подряд: ведения баз данных, построения ментальных карт, создания диаграмм, хранения знаний и общей организации файлов. Это создавало иллюзию высокой продуктивности, пока не становилось очевидно, что целые дни уходят на настройку запросов, фильтров и расстановку вики-ссылок. Подобная ловушка типична для пользователей приложений типа PKM (Personal Knowledge Management). В попытках бесконечно совершенствовать «хранилище» (vault) пользователи часто тратят часы на конфигурацию, практически не занимаясь самим написанием заметок.
Превращение Obsidian в структурированный файловый архив
Вместо того чтобы усложнять систему, автор делегировал большинство задач другим инструментам. Теперь процесс написания происходит в любых удобных текстовых редакторах — от Notepad и черновиков email до заметок в Slack. Если текущая среда не позволяет сохранить текст как файл в нужном формате, автор передает содержимое чат-ботам или ИИ-агентам. Благодаря доступу к файловой системе, нейросеть создает заметку с нужными параметрами, добавляет фронтметер (метаданные), сканирует архив и расставляет необходимые вики-ссылки для связи с уже существующими материалами.
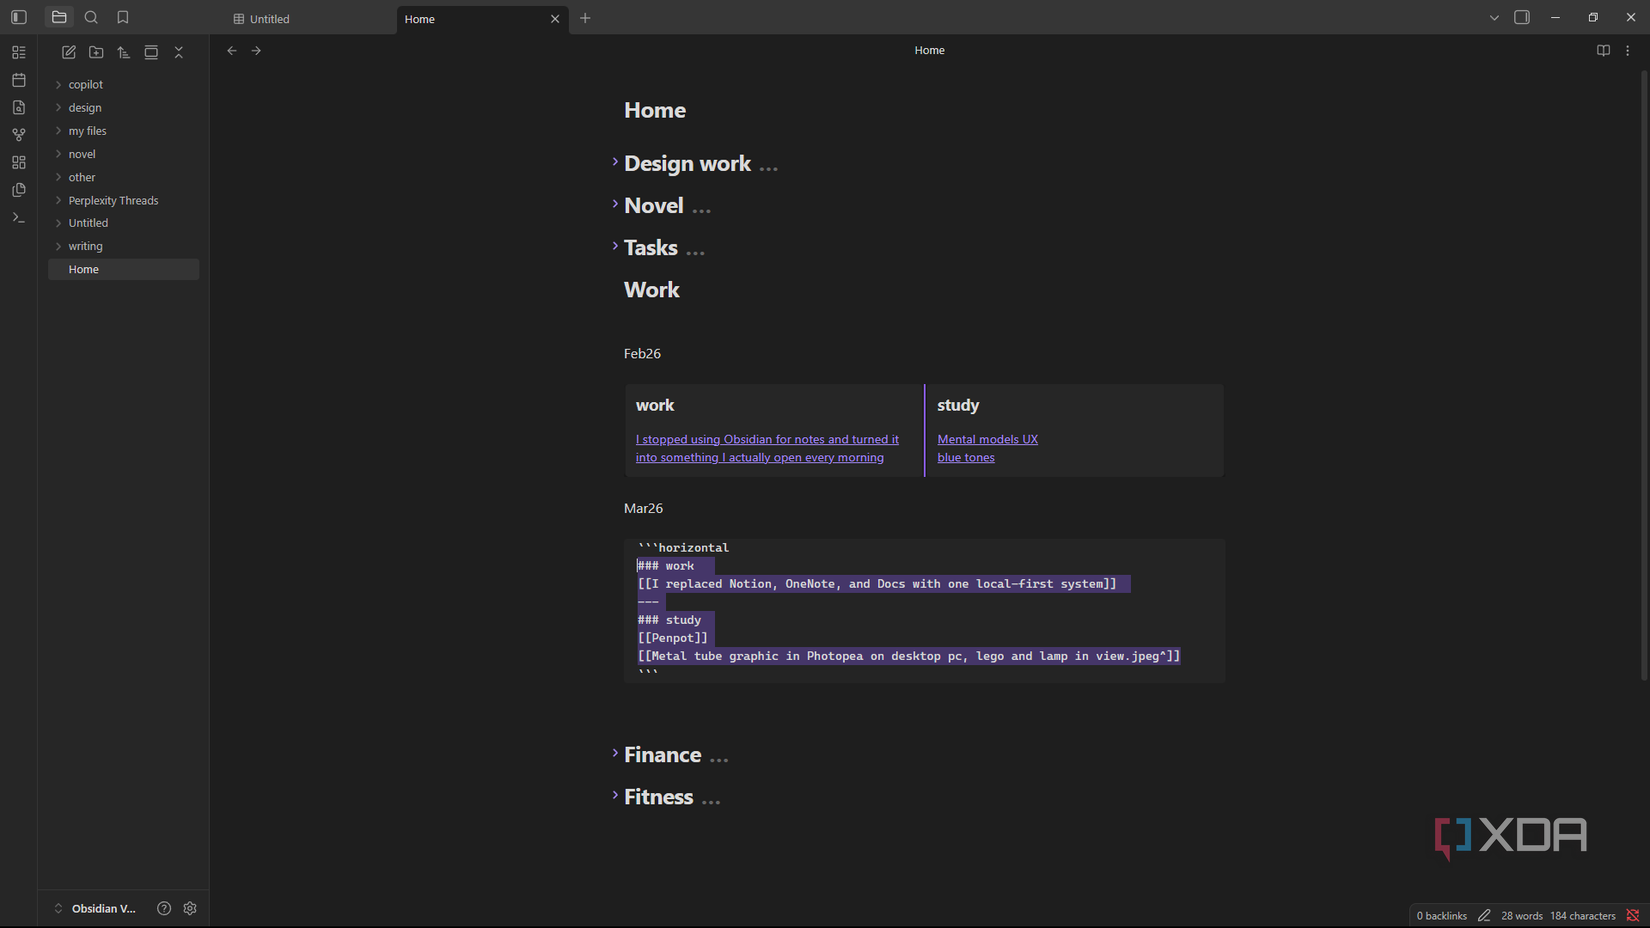
В этой схеме Obsidian стал выполнять функцию «картотеки». Это позволяет поддерживать порядок в архиве, не тратя время на ручную сортировку. Файлы автоматически распределяются по папкам, а автор открывает само приложение лишь для поиска информации или внесения минимальных правок в форматирование. По словам автора, такой подход позволяет использовать Obsidian максимально эффективно, перестав беспокоиться о хаосе в заметках.
Использование ИИ для автоматизации базы данных
Переход к модели хранения данных принес неожиданную пользу при работе с плагином Obsidian Bases, который выполняет функции, схожие с базами данных Notion. Ранее для корректной работы Bases требовалось вручную добавлять и настраивать метаданные, что было утомительно. Теперь эту задачу решают ИИ-агенты, которые на естественном языке заполняют все необходимые свойства. Это позволяет легко создавать фильтры и правила для выборок, не переживая, что какая-то заметка будет пропущена или неверно проиндексирована.
Аналогичная ситуация произошла с визуализацией связей в Graph view. Раньше пользователю приходилось тратить много времени на добавление ссылок, чтобы график не превращался в хаотичное нагромождение точек. Теперь ссылки проставляются автоматически в процессе создания заметки, благодаря чему карта связей формируется сама собой.
Баланс между автоматизацией и личным мышлением
Автор подчеркивает, что автоматизации подлежит только рутинная работа по администрированию архива. Если пользователю важно, чтобы граф связей отражал глубокие личные выводы и неочевидные закономерности, ручная работа остается необходимой. В текущей конфигурации основная мыслительная деятельность происходит в чат-ботах, административные задачи выполняет ИИ, а Obsidian выступает в качестве упорядоченного архива. Такой подход позволил не просто хранить данные, но и эффективно обращаться к ним в любое время.
Проблема бесконечной настройки
Сложности, с которыми столкнулся автор, — это не просто частный случай, а системная проблема, характерная для сообщества пользователей Obsidian. Форумы и сообщества, такие как подфорум Obsidian на Reddit, буквально переполнены жалобами пользователей, которые попадают в классическую ловушку: бесконечные попытки сконфигурировать «идеальное хранилище» поглощают всё свободное время, оставляя лишь крохи ресурсов на саму работу с текстом. На другом конце спектра находятся энтузиасты, делящиеся невероятно сложными и многоуровневыми системами, которые при ближайшем рассмотрении оказываются слишком громоздкими для повседневного использования.
Для автора этот процесс превратился в «Ouroboros» (змею, кусающую собственный хвост): он тратил больше времени на «присмотр» за своим хранилищем, чем на непосредственное использование его содержимого. Постоянное лавирование между навигацией в запутанной структуре папок и поиском новых плагинов, которые могли бы решить проблемы, созданные предыдущими настройками, привело к осознанию того, что большинство из этих решений в конечном итоге не приносят реальной пользы.
Механика взаимодействия с ИИ-агентами
В текущей стратегии автора важную роль играют инструменты Claude Code и Antigravity, которые выступают основными «двигателями» его системы. Процесс превращения хаотичных заметок в структурированный архив выглядит следующим образом:
- Подготовка метаданных: ИИ не просто создает файл, он наполняет его фронтметером (frontmatter). Это происходит либо на основе прямого запроса пользователя, либо через обращение к специально созданному файлу формата .md, в котором прописаны все организационные конвенции пользователя.
- Интеграция контента: ИИ проводит сканирование уже существующего хранилища, чтобы найти подходящие вики-ссылки. Таким образом, новая заметка «вплетается» в общую сеть знаний в тот самый момент, когда она создается.
- Очистка текста: Хотя автор предпочитает не делегировать ИИ процесс написания «мыслей», он активно использует его возможности для приведения в порядок дезорганизованного или несвязного текста, что позволяет сэкономить время, которое раньше уходило на ручное форматирование.
Важно отметить, что даже при полной автоматизации автор сохраняет папку для «случайных» или «сырых» заметок, которые пока не прошли проверку ИИ, что позволяет избежать излишнего давления правил на этапе наброска идей.
Почему это работает лучше, чем ручная работа
Главное преимущество такого подхода заключается в предсказуемости. Раньше, чтобы граф связей в Obsidian выглядел как «карта головы», а не как хаотичное скопление «застрявших точек», пользователю приходилось постоянно возвращаться к старым заметкам и вручную проставлять связи. Теперь же, когда ссылки проставляются ИИ в момент создания контента, граф «строится сам собой», пока пользователь занят другими делами.
То же самое касается плагина Bases. Он опирается исключительно на фронтметер, системные поля и метаданные файлов, полностью игнорируя текст внутри самой заметки. Если данные не заполнены корректно, плагин становится бесполезным. Делегирование этой рутины ИИ-агентам позволило автору полностью исключить этап утомительного заполнения свойств вручную. Теперь настройка фильтров и правил для отображения данных стала вопросом секунд: автор просто задает нужные критерии, будучи уверенным, что ИИ уже подготовил всю «почву» для их корректной работы.
В итоге, превращение Obsidian в своего рода «склад» или хранилище файлов (filing cabinet) стало для автора самым продуктивным решением за последние годы. Это позволяет использовать приложение именно как инструмент для хранения и быстрого доступа к информации, освобождая когнитивный ресурс для реального мышления, которое теперь происходит «на стороне» — в чат-ботах и при взаимодействии с ИИ-стеком.