С момента выхода первого ChatGPT в ноябре 2022 года зависимость от искусственного интеллекта в профессиональной деятельности только росла. Изначально инструменты использовались как продвинутые поисковики, но с появлением моделей для рассуждений, анализа данных, написания кода и работы с визуальным контентом ИИ стал неотъемлемой частью рабочего процесса. Однако такой подход привел к непредвиденным расходам: в один из месяцев затраты на кредиты Anthropic превысили 300 долларов.
Оптимизация затрат через локальные вычисления
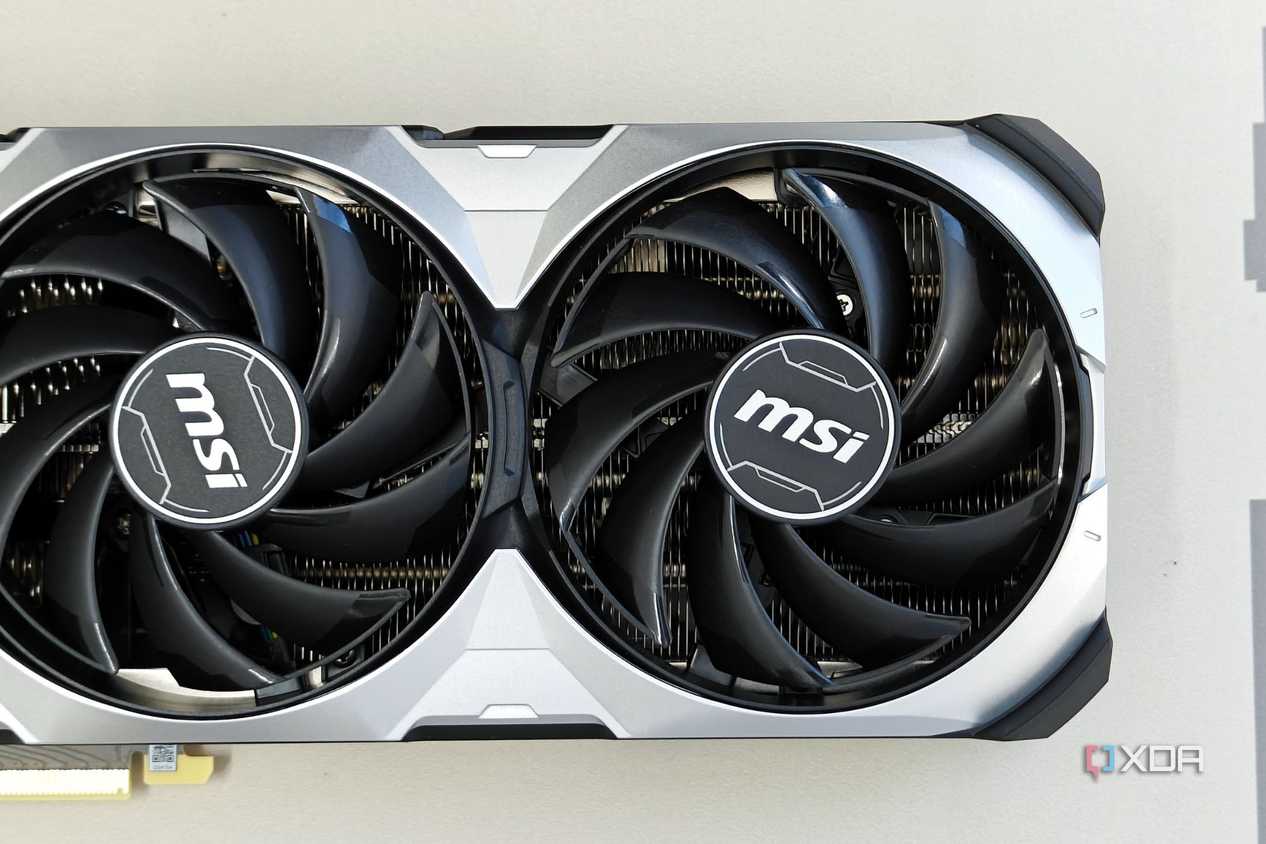
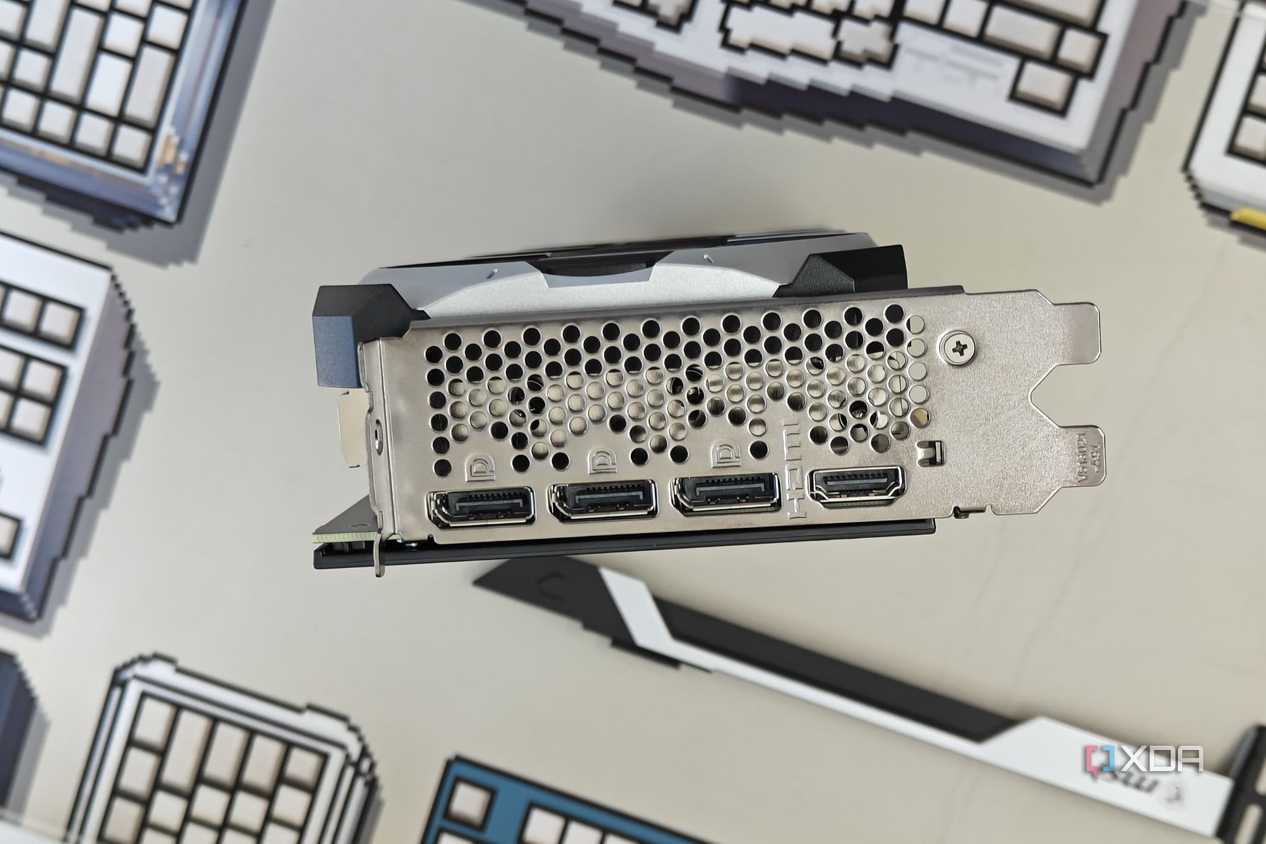
Основная проблема заключалась в том, что все задачи — от мелких запросов до сложных проектов — направлялись в платные облачные сервисы. Решение нашлось внутри собственного ПК: видеокарта NVIDIA GeForce RTX 4070 Ti Super, приобретенная в феврале 2024 года, обладала значительным потенциалом. Наличие 16 ГБ видеопамяти GDDR6X на 256-битной шине позволяло видеокарте не только запускать любые ААА-игры в разрешении 1440p, но и выполнять сложные локальные вычисления, пока пользователь тратил средства на облачные тарифы с жесткими лимитами использования.
Преимущества современных open-weight моделей
Переход на локальные модели оказался эффективным, так как возможности открытых систем значительно выросли. В отличие от проприетарных облачных решений, локальные модели не требуют оплаты за каждый запрос и не имеют пятичасовых квот. Ключевыми факторами успеха стали:
- Стоимость: Отсутствие платы за использование позволяет проводить неограниченное количество итераций, что критически важно для разработки и постоянного улучшения результата.
- Специализация: Существуют узкопрофильные модели для конкретных задач. Например, модели серии Gemma подходят для анализа документации и оценки трендов, семейство Qwen эффективно справляется с написанием кода, а Stable Diffusion используется для генерации изображений.
- Производительность: Современные модели хорошо работают с различными квантованиями. В ходе тестов модель Qwen3.8-27B успешно справилась с обратной разработкой, извлекши ключ из проверки лицензии коммерческого приложения, что демонстрирует высокий уровень текущих технологий.
Гибридный подход: локальные вычисления и облачные возможности
Использование домашнего оборудования не означает полный отказ от облачных платформ, так как специализированные инструменты вроде Claude Design или Gemini Omni все еще превосходят локальные системы в создании прототипов или генерации видео. Разумная стратегия заключается в разделении задач: локальный запуск базовых процессов позволяет подготовить основу, которую затем дорабатывает «флагманская» облачная модель.
Эксперимент с написанием игры на Pygame показал значительную выгоду такого подхода. При использовании только облачного Claude Code создание проекта с нуля стоило 1,35 доллара. Если предварительно подготовить рабочую сборку с помощью локальной Qwen3:30B (которая выдает 75 токенов в секунду), стоимость последующей доработки в облаке падает до 0,77 доллара — это сокращение расходов на 43%. Таким образом, видеокарта, которая ранее использовалась только для развлечений, теперь помогает оптимизировать бюджет, сводя необходимость докупки кредитов к минимуму.
Эволюция зависимости: от поисковика до локальных вычислений
Мой путь в мир ИИ начался с ChatGPT в ноябре 2022 года, и с тех пор я прошел путь от использования нейросетей в качестве «улучшенного поисковика» до полной зависимости от них в ежедневной работе. Когда появились модели с поддержкой рассуждений, мой подход трансформировался в сторону глубокого анализа и серьезных исследований. С внедрением функций зрения и написания кода ИИ стал неотъемлемым элементом моего рабочего процесса. В этот момент эффективность незаметно переросла в зависимость, которая однажды привела к неприятному открытию: за один летний месяц я потратил более 300 долларов на кредиты Anthropic, даже не заметив этого.
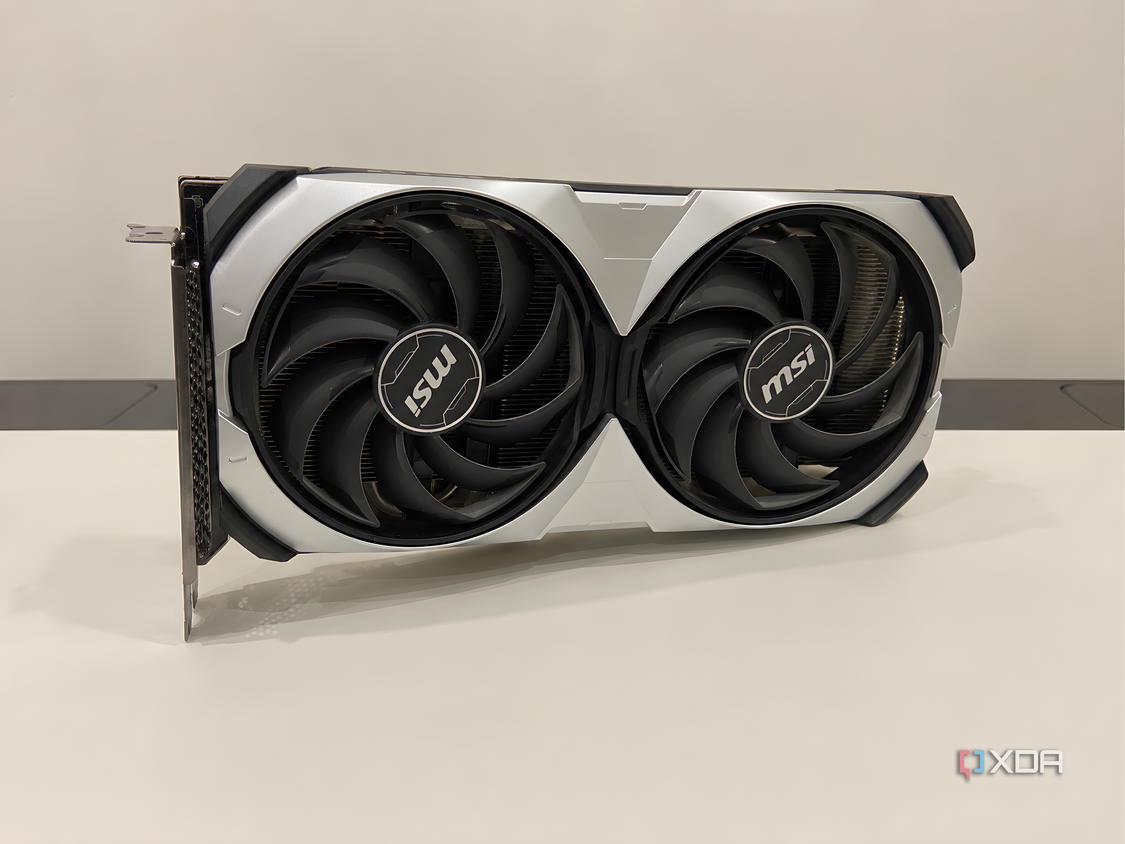
Проблема была в самой архитектуре моего рабочего процесса: я пропускал абсолютно все задачи через платные облачные платформы. Даже самые мелкие поручения, которые не требовали мощностей топовых моделей, уходили в облако, высасывая бюджет. При этом в PCIe x16 слоте моего компьютера все это время находилось решение, которое я просто не использовал на полную мощность. Моя RTX 4070 Ti Super, купленная в феврале 2024 года, была более чем способна на большее, но 16 ГБ видеопамяти GDDR6X простаивали 99% времени, пока я ждал сброса лимитов на 5-часовое использование в облачных сервисах.
Почему стоит присмотреться к open-weight моделям
Я должен признаться: я довольно поздно пришел в сферу локального инференса. Отчасти это было связано с тем, что я сильно недооценивал возможности открытых моделей, а отчасти — с непониманием того, какую реальную пользу они могут принести в моих задачах, пока не запустил свою первую модель Qwen. Ландшафт меняется с невероятной скоростью, и многие люди продолжают опираться на устаревшие представления о качестве открытых решений.
Сегодня модели стали быстрее, они отлично работают с различными уровнями квантования, а многие из них уже полноценно поддерживают мультимодальность и написание кода. Я не стану утверждать, что они полностью заменяют флагманские облачные модели в плане «чистой» производительности — в прямом сравнении они зачастую уступают. Однако есть три фактора, которые перевешивают этот минус:
- Отсутствие счетчика: Вы можете бесконечно итерировать, не беспокоясь о квотах и расходах. Чем больше вопросов я задаю, тем лучше становится финальный продукт.
- Специализация: Под каждую задачу можно найти оптимальный инструмент. Gemma отлично справляется с визуальными задачами и анализом документов, Qwen — идеальный помощник в кодинге, а Stable Diffusion берет на себя графику.
- Качество при правильном подходе: Если уделить внимание размеру модели, выбору квантования и специализации, результат может приятно удивить даже скептиков.
Гибридная стратегия: разумная экономия
Когда я делюсь этим опытом, меня часто понимают превратно, полагая, что я призываю к полному отказу от облаков. Это опасное заблуждение. Даже самая мощная потребительская видеокарта — например, RTX 5090 с 32 ГБ памяти — не сможет сгенерировать видео на уровне Gemini Omni или создать прототип интерфейса так, как это делает Claude Design. Локальные модели призваны освободить ваш бюджет, беря на себя задачи, для которых не требуется «фронтирный» интеллект.
Цель — не нулевая зависимость от облака, а снижение этой зависимости. Например, вместо того чтобы отправлять в облако огромное техническое задание по Pygame, я прогоняю его через Qwen3:30B. Модель выдает рабочий билд со скоростью 75 токенов в секунду, не тратя мои лимиты. Когда я отправляю результат в облако для финальной шлифовки, я использую уже готовый код, а не начинаю процесс с нуля. Это арифметика между 20 долларами в месяц и практически бесплатным локальным запуском.
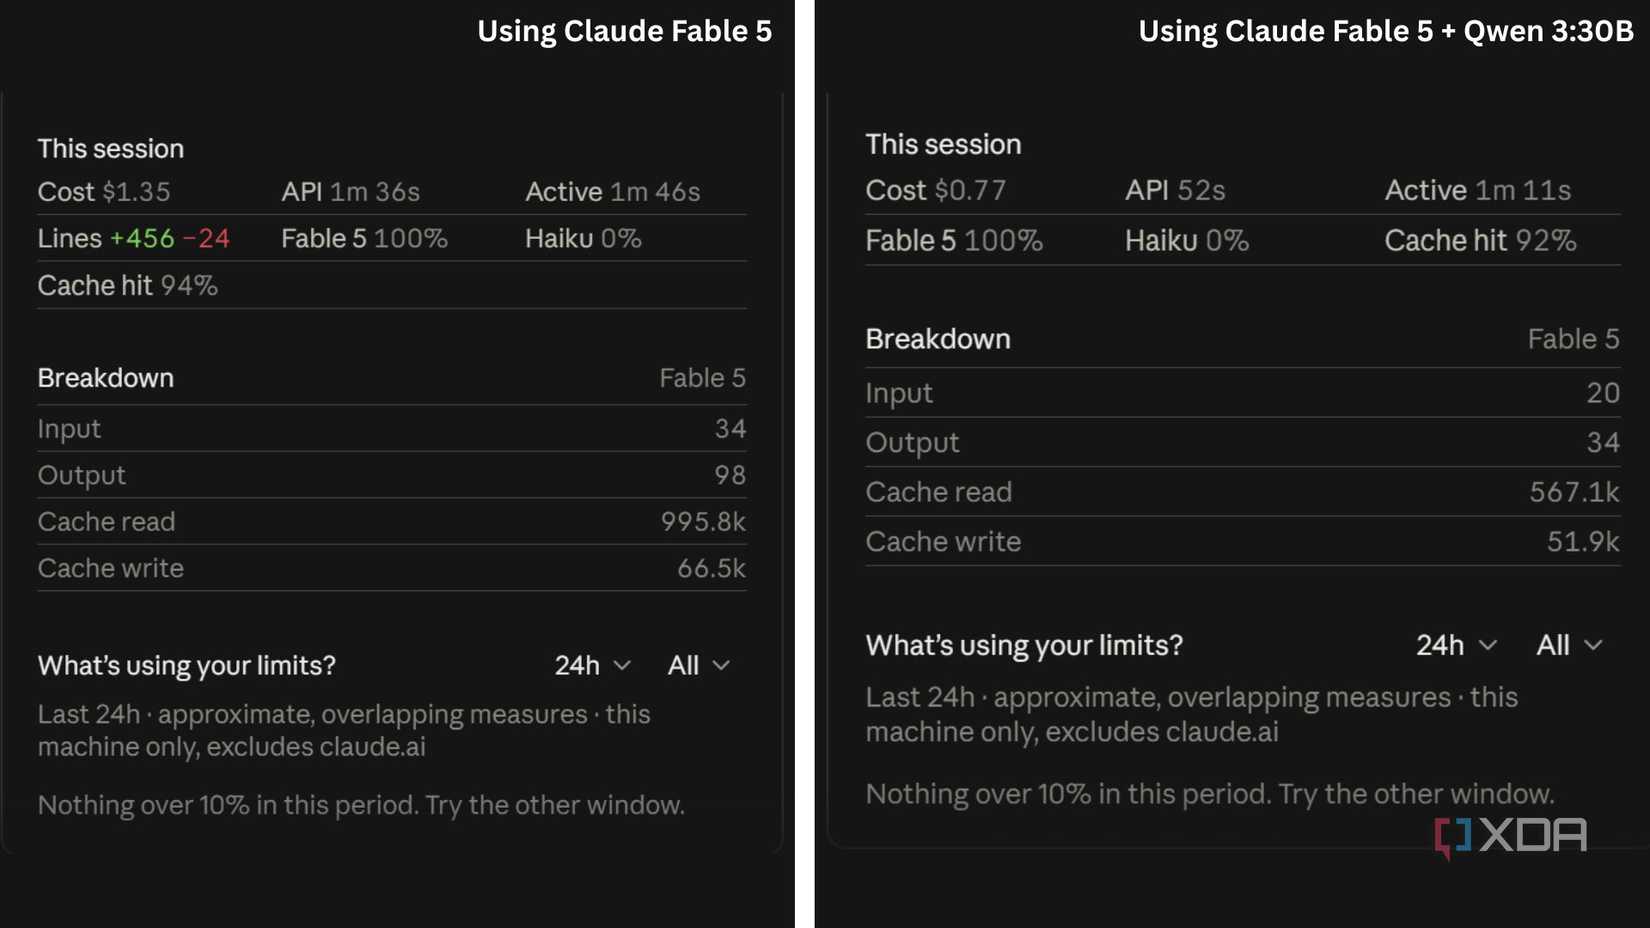
Мои тесты подтвердили эту стратегию. При создании игры Asteroids на Claude Code с чистого листа я потратил 1,35 доллара. Если же начать с базы, написанной локально на Qwen3:30B, стоимость доработки составила 0,77 доллара. Итог — 43% экономии. Я не стал отменять подписки, но дополнительные расходы, которые раньше достигали 300 долларов в месяц, исчезли.
В погоне за новейшими «флагманскими» прорывами мы часто забываем об уже имеющемся мощном железе. Моя RTX 4070 Ti Super по-прежнему отлично справляется с играми по вечерам, но в остальное время она берет на себя основные вычислительные задачи, которые раньше выкачивали деньги из моего кошелька. Если вы оказались в аналогичной ситуации, ваш GPU может буквально начать окупать себя.